AI4S 2026|THEMol 数据集:分子的扭转、Hessian 矩阵与能量
今天介绍的是发表在 《AI Science》 上的 THEMol:Torsion, Hessian, and Energy of Molecules 工作。随着机器学习势函数快速发展,高质量、大规模量子化学数据已成为分子建模的重要基础。THEMol 聚焦有机分子的分子内势能面,覆盖 12 种常见元素和最多 50 个重原子的分子体系,累计包含约 30 亿次 DFT 计算。数据集系统划分为 Hessian、HessianRelax、TorsionScan、TorsionScanRelax 和 MBIS 五个子集,提供大规模扭转扫描、几何弛豫轨迹、Hessian 矩阵及电子密度衍生性质。该工作为传统分子力场和机器学习势函数的训练、预训练与泛化研究提供了重要的数据基础。
获取详情及资源:
- 📄 论文: https://doi.org/10.1088/3050-287X/ae9e52
- 📊 数据: https://huggingface.co/datasets/ByteDanceSeed/THEMol
- 💻 代码: https://github.com/ByteDanceSeed/THEMol
0 摘要
该研究提出了 THEMol(Torsion, Hessian, Energy of Molecules,分子扭转、Hessian 与能量)数据集,这是一个面向闭壳层有机分子的大规模开源量子力学性质数据集,覆盖重原子数最多达 50 个的分子。THEMol 包含多个大规模子集:其中 Hessian 子集包含超过 300 万个经几何弛豫后的分子构型及其 Hessian 矩阵;TorsionScan 子集包含近 1 亿个约束弛豫构型,并提供相应的能量和力;此外,几何弛豫轨迹子集 HessianRelax 和 TorsionScanRelax 合计包含约 30 亿次密度泛函理论(DFT)计算。
该数据集对化学空间进行了广泛采样,涵盖 12 种重要元素以及多种分子结构类型,可服务于药物发现、电解质、离子液体等多个研究领域。通过 TorsionScan 和 TorsionScanRelax 子集,THEMol 还提供了较为全面的构象空间采样,包括系统性的环内扭转扫描与非环扭转扫描。
此外,数据集中还包含一个规模庞大的 Hessian 矩阵库,这些矩阵均基于弛豫后的分子构型计算,可用于表征势能面的关键二阶导数信息。同时,数据集还提供了基于电子密度计算得到的原子多极矩,其计算采用最小基组迭代 Stockholder 分区方法(minimal basis iterative stockholder partition,MBIS)。
整体而言,THEMol 被划分为 Hessian、TorsionScan、HessianRelax、TorsionScanRelax 和 MBIS 五个相互独立的子集,涵盖优化后的分子几何结构、几何弛豫轨迹以及由此得到的多种分子性质。如此大规模且具有高度化学多样性的数据,有望显著推动高精度、高可迁移性分子势能模型的开发。
1 引言
高质量的有机分子势能面(potential energy surface,PES)量子力学(quantum mechanical,QM)数据,是参数化分子力学势函数和机器学习(machine learning,ML)势函数的基础。大规模 QM 数据集的发展为现代力场构建奠定了重要基础。早期代表性数据集 QM9 推动了小型有机分子的量子化学数据研究;随后,PubChemQC 系列将这一规模扩展至 2.21 亿个 PM6 优化构型和 8600 万个密度泛函理论(density functional theory,DFT)电子结构。近年来,QCML 数据集进一步将规模扩展至 3350 万次 DFT 计算和 147 亿次半经验计算。
与此同时,ANI 和 AIMNet 系列数据集推动了可迁移神经网络势函数的发展。ANI-1 首次构建了包含 2000 万个非平衡构象的数据集,并展示了首个能够以接近力场计算成本实现 DFT 精度的神经网络势函数。ANI-1x 在此基础上扩展了多样化构象的 DFT 性质数据。值得注意的是,该数据集还包含采用**最小基组迭代 Stockholder 分区(minimal basis iterative stockholder,MBIS)**方法计算得到的原子电荷、原子体积和多极矩。MBIS 能够从分子的连续电子密度中严格提取这些性质,从而为开发精度更高的经典力场和 ML 力场提供支持。随后,ANI-1ccx 通过迁移学习实现了接近耦合簇方法的精度,而 ANI-2x 则进一步将化学空间扩展至包含硫和卤素在内的 7 种元素。近期,ANI-1xBB 又进一步构建了面向小型有机分子的反应性势函数。与此同时,AIMNet 系列展示了稳定的多任务预测能力,并最终通过 AIMNet2-NSE 和 AIMNet2-rxn 推进至更通用的化学反应建模。
近年来,一系列新数据集进一步拓展了化学空间覆盖范围,并针对特定物理化学问题进行了专门设计。Open Molecules 2025(OMol25)包含超过 1 亿次 DFT 计算,对多种分子体系进行了广泛覆盖;Open Polymers 2026(OPoly26)则进一步面向聚合物材料。QCell 提供了覆盖多样化生物分子片段的系统性量子力学数据。针对药物研究,SPICE、GEOM、QMugs 以及 QCArchive 中公开的 OpenFF 数据集主要服务于药物样分子的力场参数化。对于反应化学,Transition-1x 提供了用于构建反应性 ML 势函数的专门数据,而 HORM 则提供了用于优化反应性势函数的大规模分子 Hessian 数据库。针对非共价相互作用,DES370K 提供了高精度二聚体相互作用能,BFDb 覆盖了大量生物分子片段,而 NCI Atlas 则系统整理了氢键体系。对于生物分子体系,AIMDChig 利用从头算分子动力学探索蛋白质的构象空间。在 Hessian 数据方面,Hessian QM9 和 VIBFREQ1295 提供了振动频率相关的基准数据。
为满足力场训练中尚未充分解决的数据需求,该研究构建并开放了一个历时近 4 年积累的大规模 DFT 数据集。该数据集以有机分子为核心,覆盖 12 种重要元素,包括 H、B、C、N、O、F、Si、P、S、Cl、Br 和 I,并包含最多具有 50 个重原子的分子。除 MBIS 子集外,所有 DFT 数据均采用 B3LYP-D3(BJ)/DZVP 理论水平计算,该计算设置专门选择为与 Open Force Field Initiative 生成的类似数据集保持兼容。已有研究表明,这一理论水平能够在计算效率与精度之间取得较好平衡,适合用于探索分子内势能面。
该数据集具有三个主要优势。首先,其对化学空间进行了广泛而系统的采样,覆盖与药物发现、电解质、离子液体等领域相关的多样化化学结构。此前基于 Torsion, Hessian, Energy of Molecules(THEMol)部分数据的比较分析表明,ByteFF Torsion Dataset——即当前 TorsionScan 子集的一部分——在目标力场参数化场景下,相比 SPICE 和 GEOM 具有更广泛、更全面的化学空间覆盖。此外,该数据集还通过质子化状态枚举进一步扩大化学空间采样范围,从而系统探索更加丰富的带电分子状态。
其次,该数据集同时采用无约束几何弛豫和扭转扫描对分子内势能面进行系统探索,从而能够近乎穷尽地搜索势能面上的局部极小值。
第三,该数据集包含大量在弛豫后分子构型上计算得到的 Hessian 矩阵,提供势能面的关键二阶导数信息,可用于更加精确的力场开发。
为了最大限度满足不同力场开发需求,THEMol 被系统划分为五个独立子集:Hessian、HessianRelax、TorsionScan、TorsionScanRelax 和 MBIS。总体而言,这一综合性数据资源不仅为训练高保真力场提供了大规模基础,也可用于多种依赖有机分子势能面和电子密度信息的研究任务。尤其是,THEMol 聚焦于单分子分子内势能面的大规模 Hessian 与扭转扫描数据,可与广泛使用的 OMol25 数据集形成互补;后者的有机单分子构象数据部分主要来自对已有社区数据集的重新计算。
2 方法
2.1 分子片段整理
整理后的数据主要来源于公开可访问的分子数据库 UniChem。此外,还纳入了若干广泛使用的力场训练数据集、已发表配体发现研究中整理的化合物,以及部分内部专有化合物集合,以增强数据集的实际应用价值。
首先,根据多种理化描述符对分子进行筛选,包括芳香环数量、极性表面积、定量类药性评分(quantitative estimate of drug-likeness,QED)、元素类型以及杂化类型等。完成筛选后,采用内部开发的图扩展算法,将分子切分为原子数少于 70 的片段。该算法旨在尽可能保留局部化学环境。简而言之,算法会遍历分子中的每个化学键、键角以及非环扭转角,保留相关原子及其共轭邻接原子,裁剪其余部分,并对被切断的化学键进行封端处理。
为降低该片段化算法可能带来的采样偏差,并进一步扩大化学空间覆盖范围,还从 UniChem 中额外采样了大量具有片段特征的分子,并使其绕过上述片段化流程。随后,采用 Epik 6.5 对预测
经过初步整理后,最终获得约 400 万个经过质子化状态扩展的片段样分子,对应质子化状态枚举前约 250 万个唯一片段,并覆盖多种分子净电荷状态。这些分子随后被用于下一阶段的数据生成流程。
2.2 构象生成
首先使用 RDKit 根据 SMILES 字符串生成初始三维构象,随后在指定 QM 理论水平下,采用 geomeTRIC 优化器进行几何优化。几何优化使用 geomeTRIC 文档中定义的 Gaussian 风格收敛判据。产生的完整优化轨迹被保存并组成 HessianRelax 数据集;优化后的弛豫构象进一步用于 Hessian 矩阵计算,从而组成 Hessian 数据集。
为保证结构完整性,对每个构象进行检查,以确认在几何弛豫过程中未发生化学键断裂或新键形成。该键一致性检查采用 ByteFF GitHub 仓库中公开的 byte-mol 实现。此外,还通过 Hessian 矩阵的特征值验证驻点性质:除对应平移和转动的 6 个近零模外,其余所有 Hessian 特征值均须为正值,从而确认获得的结构是真正的局部极小值。
随后,从弛豫构象中选择唯一扭转角用于扭转扫描。由于拓扑约束不同,非环扭转角和环内扭转角采用不同的扫描策略。
对于非环扭转角,以优化后构象为参考,以
对于环内扭转角,则采用逐帧顺序扫描方式。当相对构象能超过
扫描得到的所有几何结构均进一步接受键一致性检查。最终,完整优化轨迹组成 TorsionScanRelax 子集,而完成约束优化后的最终构型则组成 TorsionScan 子集。
2.3 量子化学计算与质量筛选
除 MBIS 子集外,所有计算均采用 B3LYP-D3(BJ)/DZVP 理论水平。该理论水平能够在有机分子分子内势能面计算的成本与精度之间取得实用平衡,同时与 OpenFF Sage 小分子力场参数化流程使用的参考数据保持一致。
需要强调的是,这一理论水平主要面向传统力场训练,以及针对分子内相互作用的机器学习力场(MLFF)预训练,而并非追求与 OMol25 等更高理论水平数据集相同的精度。对 B3LYP-D3(BJ)/DZVP、B3LYP-D3(BJ)/def2-QZVPD 和
对于 MBIS 子集,大多数分子均在 B3LYP-D3(BJ) 优化构型基础上,采用 PBE0/def2-TZVPD 进行计算。选择 PBE0 泛函,是因为已有研究表明其在电子密度预测方面具有较高稳健性,因此对于分子偶极矩等基于电子密度导出的性质同样具有良好表现。
对于含碘分子,则使用 DZVP 基组替代 def2-TZVPD。其原因在于,def2-TZVPD 对碘采用有效芯势(effective core potential,ECP),以参数化势替代部分芯层电子,而 MBIS 分区方法本质上要求完整的全电子密度,才能严格提取原子电荷和多极矩;DZVP 能够满足这一要求。
严格的数据清洗与验证是确保大规模量子力学数据集可靠性的关键。因此,该研究在遵循现有实践的基础上,例如去除开壳层分子和要求几何优化收敛,建立了一套系统性的质量控制流程,并针对扭转扫描数据增加了专门的一致性检查。具体包括:
- 自旋状态筛选: 去除全部开壳层分子,将数据集严格限制为闭壳层体系。
- 去重: 在每个子集中移除重复数据。使用
mapped_isomeric_smiles字符串作为主要去重键。该字段由 THEMol GitHub 仓库中的 mapped-SMILES 工具生成,基于带原子映射编号的规范异构 SMILES,从而保留分子图与存储坐标顺序之间的对应关系。对于 TorsionScan 和 TorsionScanRelax 子集,还会将torsion_indices加入去重键,以正确区分不同的扭转扫描曲线。 - 几何收敛筛选: 在 HessianRelax 和 TorsionScanRelax 子集中,删除几何优化未收敛的数据。当最大原子力范数超过
,约等于 时,该构型会被标记并移除。对于 TorsionScanRelax 子集,由于参与扭转约束的 4 个原子会因几何约束产生人为力,因此使用第五大原子力范数代替绝对最大值进行判断。 - 扭转一致性检查: 对 TorsionScan 和 TorsionScanRelax 子集中的二面角进行严格检查。首先,如果最终约束角度与初始目标角度之间的偏差超过
,则整条轨迹被舍弃。其次,对标注的扭转原子索引进行正确性验证。如果某组扭转索引对应的实际采样约束角变化范围小于 ,则相应数据被舍弃。
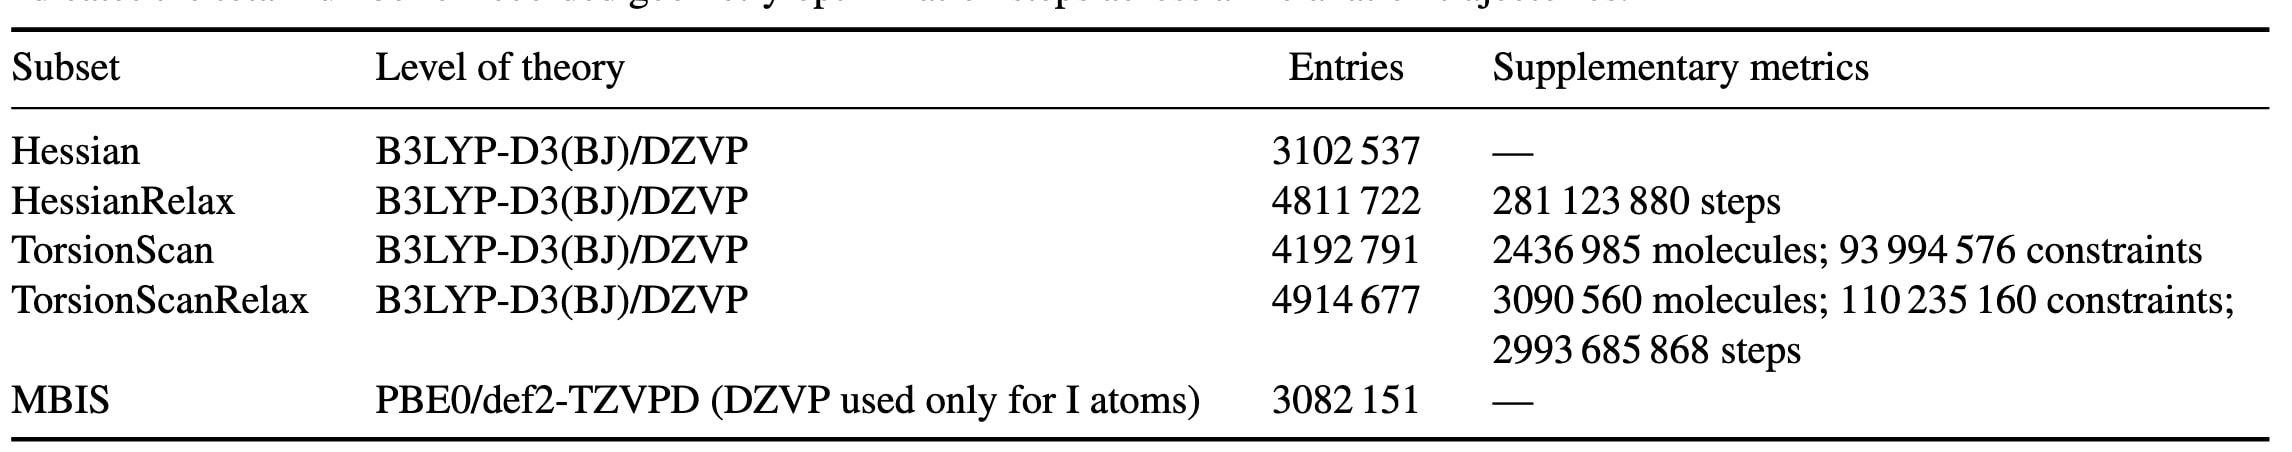
表1|THEMol 数据集各子集概览 该表汇总了各子集所采用的理论计算水平、数据条目总数及补充计算指标。其中,Entry 表示由全局唯一标识符(universally unique identifier,UUID)定义的唯一数据条目。对于 Hessian、HessianRelax 和 MBIS 子集,每个 Entry 对应一个唯一分子;对于 TorsionScan 和 TorsionScanRelax 子集,每个 Entry 则对应一个分子与特定扭转原子索引的唯一组合。此外,Molecules 表示唯一分子图的数量,Constraints 表示扭转角约束的总数。对于 HessianRelax 和 TorsionScanRelax 子集,Steps 表示所有几何弛豫轨迹中记录的几何优化步数总和。
3 结果
3.1 数据格式
THEMol 包含五个子集:Hessian、HessianRelax、TorsionScan、TorsionScanRelax 和 MBIS。数据采用逗号分隔值文件(CSV)与层次化数据格式第五版(Hierarchical Data Format 5,HDF5)相结合的混合格式进行发布。
每条数据均通过一个全局唯一标识符(universally unique identifier,UUID)进行唯一标识。对于 Hessian、HessianRelax 和 MBIS 子集,UUID 根据分子本身确定性生成;对于 TorsionScan 和 TorsionScanRelax 子集,则根据分子和扭转角原子索引共同确定性生成。
CSV 文件主要提供元数据,包括 UUID、带原子映射的非异构与异构 SMILES,以及对应 HDF5 文件路径。对于特定子集,CSV 中还会记录额外元数据,例如几何弛豫步数或扭转原子索引。
为保持一致性,各子集中的物理量均采用分子模拟和量子化学数据集中常用的单位。坐标单位为埃(
HDF5 文件以 UUID 作为每条数据的根组,按照层级结构存储详细的 QM 性质和几何数据。所有子集共享的属性包括带原子映射的 SMILES 和原子序数。
Hessian 子集包含优化后的原子坐标,以及对应的
3.2 数据集组成与结构统计
为展示 THEMol 所覆盖的广泛化学与结构多样性,该部分进一步分析数据集的组成特征和计算统计信息。表 1 汇总了各子集的数据规模和计算细节。
图 1a 展示了 Hessian、TorsionScan 和 MBIS 三个主要子集在分子层面的元素分布。碳元素自然是最常见的元素,几乎出现在所有分子中,并占全部非氢原子的 70% 以上。氮和氧等重要有机元素同样具有极高的数据覆盖量。
除这些基础元素外,THEMol 还通过大量采样较重和相对少见的原子种类,实现了较高的化学多样性。硫和卤素均得到充分覆盖。例如,仅 Hessian 子集中就有超过 60 万个分子含有硫元素。即使对于该数据集范围内最重且最少见的元素碘(I),三个子集中仍包含超过 2.5 万个唯一分子结构。如此大规模地覆盖基础元素和较重主族元素,有助于训练得到的模型更加稳健地泛化至复杂有机化学空间。更详细的分子层面和原子层面元素分布见附录。
图 1 还展示了另外三类重要的结构和计算分布。图 1b 给出了以非氢重原子总数衡量的分子尺寸分布。由于不同子集之间的尺寸分布高度一致,因此以 Hessian 子集作为代表。结果表明,数据集中的大多数分子包含 8–25 个重原子。
图 1c 比较了 HessianRelax 和 TorsionScanRelax 子集中完成几何弛豫所需步数的分布。TorsionScanRelax 中的轨迹通常以显著更少的优化步数完成收敛。这一现象符合预期,因为扭转扫描的初始构型是通过在已经优化的几何结构中旋转某一个特定二面角获得的。
图 1d 比较了环内扭转扫描和非环扭转扫描最终成功收敛的几何构型数,即有效约束构型数。由于环状体系具有固有的结构刚性,会在物理上阻止二面角完成完整的
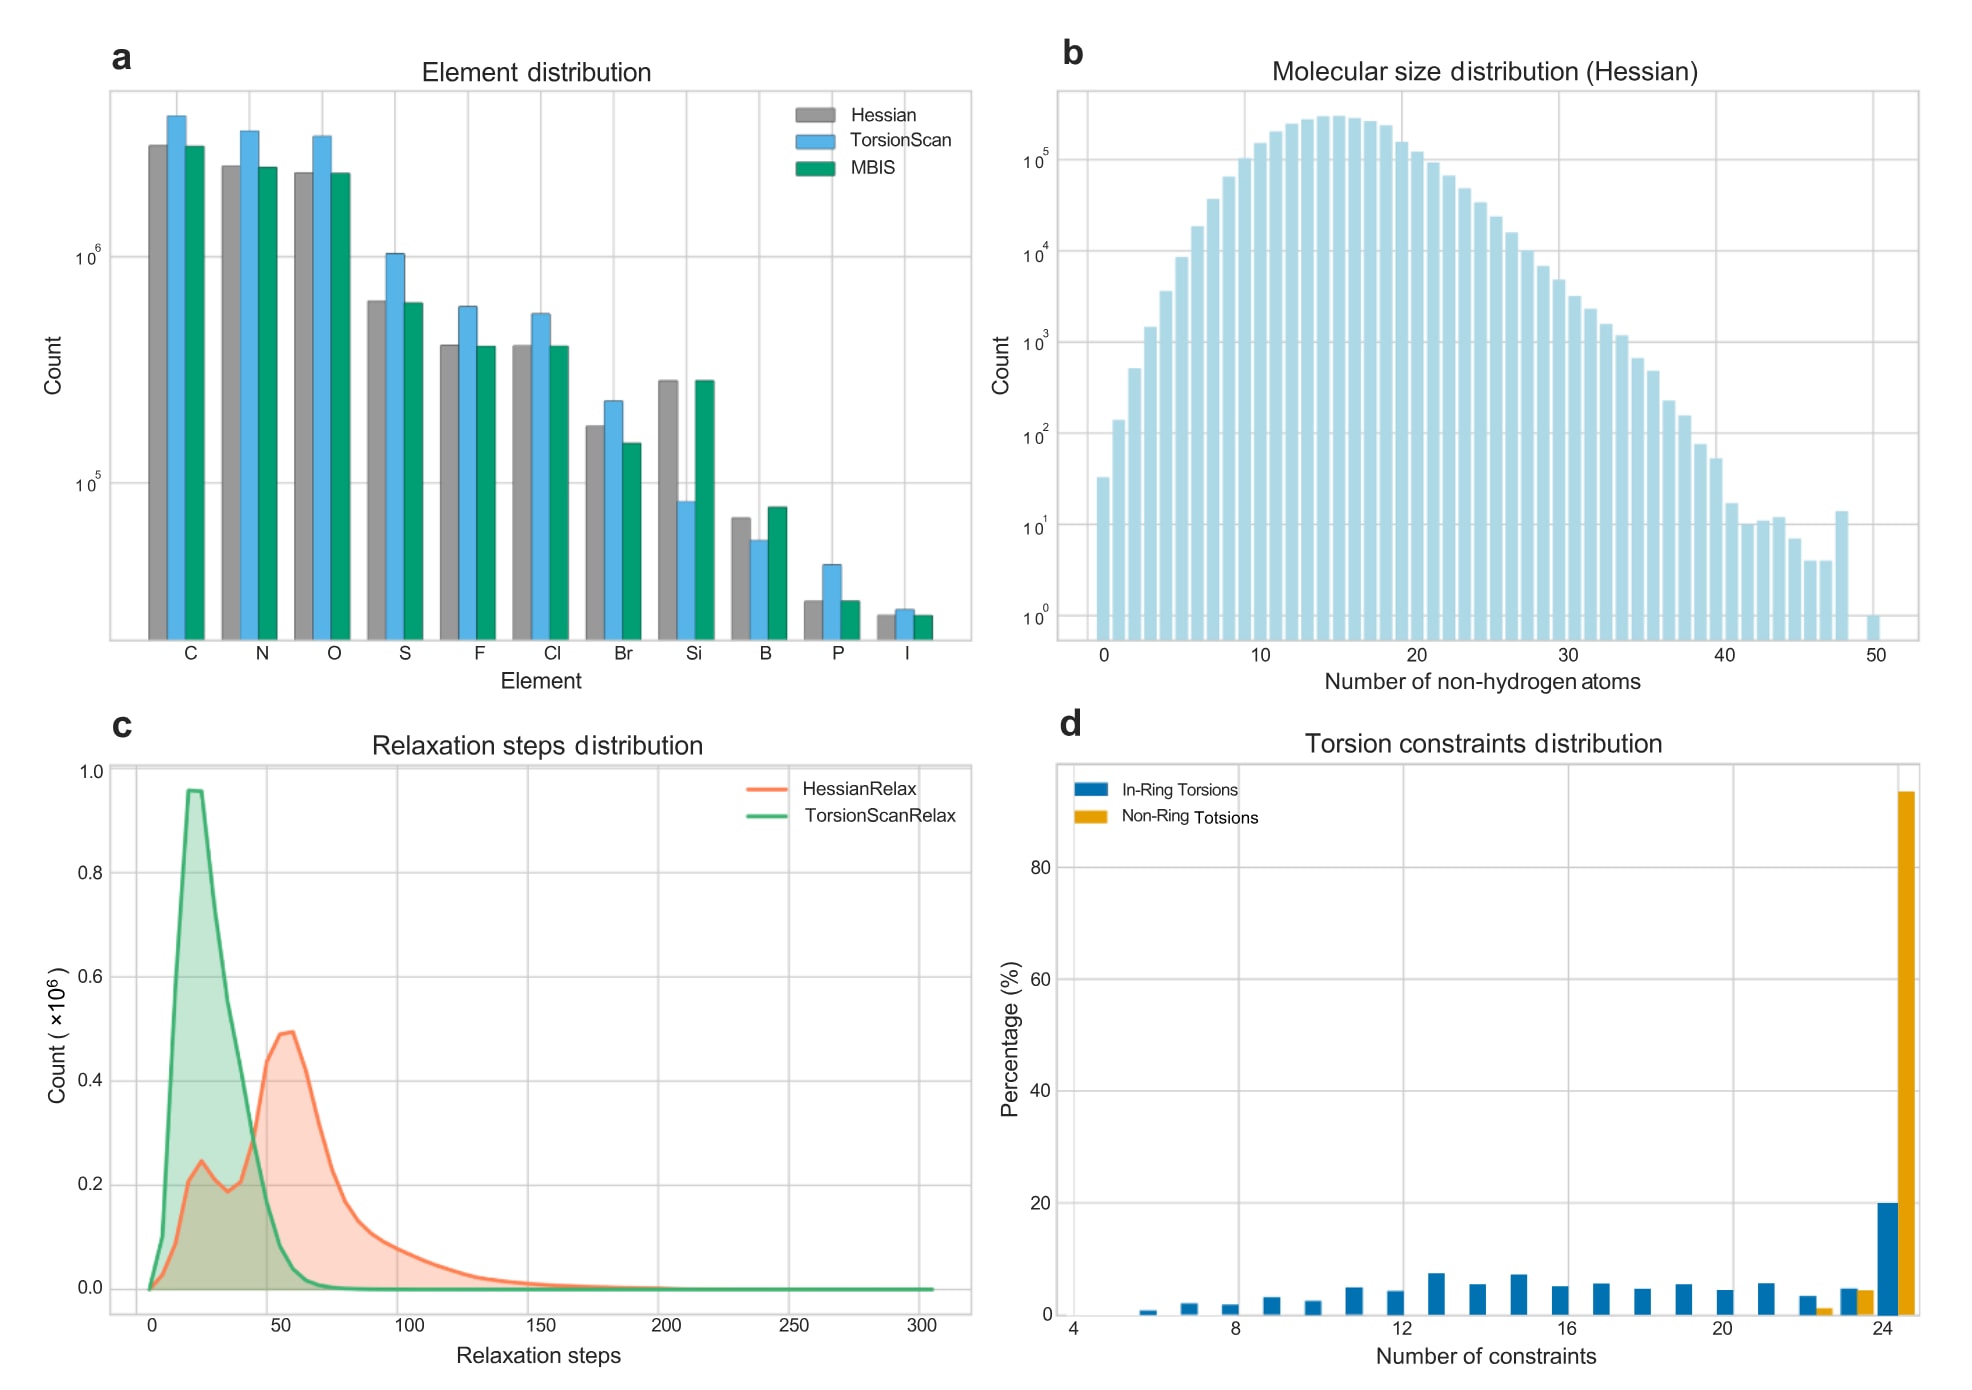
图1|数据集中的关键分布 a,选定子集在分子层面的元素计数分布,不包括氢元素;b,以 Hessian 子集为代表,按照非氢原子数量统计的分子尺寸分布;c,HessianRelax 和 TorsionScanRelax 子集中几何弛豫步数的分布;d,TorsionScan 子集中环内与非环扭转扫描过程中有效约束构型所占比例的分布。
4 讨论与结论
该研究提出了 THEMol,这是一个面向药物样分子的综合性开源 QM 性质数据集。
同时,作者指出了若干已知局限,以帮助研究者合理使用该数据集。
首先,THEMol 数据是在近 4 年内持续积累完成的,在不同阶段使用了两种电子结构计算引擎:早期采用运行于 CPU 的 Q-Chem,后期则在 GPU4PySCF 成熟后转而使用 GPU4PySCF。不同计算引擎及默认设置之间存在细微的方法学差异,因此在少数边界情况下可能产生小幅不一致。若需要对 HessianRelax 轨迹进行定量分析,建议排除轨迹早期的高能构型,因为对于能量显著高于优化结构的初始构型,其相对能量可能对不同实现和参数设置之间的细微差异更加敏感。
第二,目前的数据采样中,仅包含极少量具有超过 4 个成键邻居的超价配位环境。因此,某些结构基元,例如八面体磷配位环境——如名义上的
第三,数据处理过程中依赖 RDKit 根据三维坐标生成异构 SMILES,用于去重和后处理。在少数具有复杂立体化学或近简并构象的情况下,自动立体化学指派可能出现错误。当精确的立体化学标签十分关键时,建议直接根据所提供的三维坐标重新计算 CIP 构型,以进行额外验证。
第四,该数据集采用 B3LYP 泛函配合通用的 D3(BJ) 色散校正参数。部分研究者可能倾向于采用专门针对 DZVP 基组优化的其他参数组合,这可能导致轻微的数值差异。对于大多数应用而言,这种差异预计不会造成实质性影响,但如果要求达到亚
第五,对于含碘分子,由于碘原子核附近的电子密度高度尖锐,可能给 MBIS 分区带来困难。这可能偶尔降低电子密度衍生性质的精度,或导致计算难以收敛。因此,在将 MBIS 子集用于重卤素体系时,建议进行常规的合理性检查。
展望未来,THEMol 仍可从多个方向进一步提升其应用价值和覆盖范围。总体而言,该数据集提供了大规模、多样化且系统组织的 QM 数据,可用于训练传统分子力学势函数以及机器学习势函数。
对于 ML 势函数,THEMol 可作为一个聚焦分子内势能面的预训练语料库,随后再进一步使用同时包含分子间相互作用的更广泛高保真数据集进行预训练或微调。
THEMol 有望成为计算化学以及更广泛 AI for Science 领域的重要基础资源,并推动面向多样化有机分子及应用场景的高精度、高稳健性和高可迁移性模型开发。