Chem. Sci. 2026|DrugLLM:基于领域专用大语言模型的少样本分子性质优化
今天介绍的是一项面向少样本分子优化的大语言模型工作——DrugLLM。该研究针对传统生成模型高度依赖大规模标注数据的问题,提出官能团分词(FGT)和下一步修改预测(NMP)策略,使模型能够从少量分子修改示例中学习结构–性质关系,并据此优化新的分子。DrugLLM 在 Log P、溶解度、合成可及性、TPSA 及多种生物活性任务中均表现出较强的少样本泛化能力,并在零样本组合性质优化中优于多种通用和生物医学大语言模型。进一步地,该方法以伊伐布雷定为起点优化 HCN2 抑制剂,获得两个活性更强的候选分子,并通过膜片钳实验完成验证,展示了大语言模型用于真实药物分子优化的应用潜力。
获取详情及资源:
0 摘要
大语言模型(large language models,LLMs)凭借少样本学习和推理能力推动了机器学习的发展,并在自然语言处理和计算机视觉等领域取得了显著成果。然而,当应用于生物学和化学领域时,现有 LLM 仍存在明显局限,尤其难以准确捕捉分子结构与药物化学性质之间复杂而细微的关系。这一问题限制了少样本学习在药物发现中用于小分子生成与优化的应用。
该研究提出 DrugLLM,一种专门面向分子优化任务设计的大语言模型。DrugLLM 引入官能团分词(Functional Group Tokenization,FGT)策略,以更适合 LLM 学习的方式对分子进行分词,相比 SMILES 可实现超过
在多项计算实验中,DrugLLM 在少样本分子生成任务中取得了当前先进水平的性能,并超过包括 GPT-4 在内的主流 LLM。进一步将 DrugLLM 应用于 HCN2 抑制剂优化后,获得了两个具有生物活性的化合物,并通过湿实验成功验证。上述结果表明,DrugLLM 在加速分子优化和推动人工智能驱动的药物发现方面具有较强潜力。
1 引言
大语言模型(large language models,LLMs)通过利用极少量样本弥合不同任务之间的理解差距,从根本上改变了机器学习范式。这类模型在自然语言处理、软件生成等多个领域展现出卓越的泛化、生成和推理能力。然而,当其应用于化学和分子科学时,即语义信息并非编码于语法,而是蕴含在三维构象和电子结构之中,即使是当前最先进的 LLM 也表现出其固有局限。
这一差距在分子优化任务中尤为突出。分子优化是药物发现中的关键阶段,需要对候选分子进行反复迭代改造,以满足复杂的药代动力学和药效动力学要求。传统计算方法,如密度泛函理论(density functional theory,DFT)和分子动力学(molecular dynamics,MD),能够提供具有物理基础的分析结果,但其计算成本高昂,而且往往难以与真实药物开发场景完全匹配。另一方面,包括深度生成模型(deep generative models,DGM)在内的数据驱动方法虽然具有加速分子优化的潜力,但通常需要数以万计的带标签分子,而对于大多数目标性质而言,此类数据仍十分稀缺。例如,基于梯度的 DGM 优化通常需要超过
该研究提出,大语言模型可能通过一种尚未得到充分重视的推理同构性(reasoning isomorphism)解决这一问题。过去,SMILES/SELFIES 等分子线性表示主要被视为保证生成有效性的语法形式,而该研究进一步揭示了其作为“认知流形”(cognitive manifolds)的潜力。近期理论研究表明,基于 Transformer 的 LLM 可以通过上下文学习实现隐式的元梯度下降。这一机制与药物化学家理解“结构扰动—性质变化”之间关系的过程高度相似,即能够将不同结构修改及其性质变化内化为可组合的推理单元。基于这一思想,该研究将分子优化重新表述为一个序列到序列任务,并设计由**问题定义、示例和解决方案**三部分组成的提示形式,进而提出 DrugLLM,使模型能够将跨任务通用的优化逻辑与特定靶点或性质相关的优化策略进行解耦。
DrugLLM 首先引入**官能团分词(Functional Group Tokenization,FGT)策略,将分子表示为具有明确化学语义的亚结构单元,例如使用**[COOH]** 表示羧基。与传统表示相比,该方法可将序列长度缩短
DrugLLM 在 24 项分子优化任务上进行了评估,其中包括水–辛醇分配系数(Log P)、溶解度、合成可及性和拓扑极性表面积(topological polar surface area,TPSA)等理化性质,以及针对不同靶点的 20 项生物活性优化任务。广泛的计算实验表明,在少样本性质优化成功率方面,DrugLLM 优于现有生成算法。该模型仅需要 8 个上下文示例,即可达到与使用 34,000 个带标签化合物训练的图神经网络(GNN)相当的优化性能,相当于将所需训练数据量降低约 4,000 倍。
值得注意的是,在 HCN 通道抑制剂发现任务中,DrugLLM 鉴定出两个传统虚拟筛选方法未能发现的新型分子骨架,其
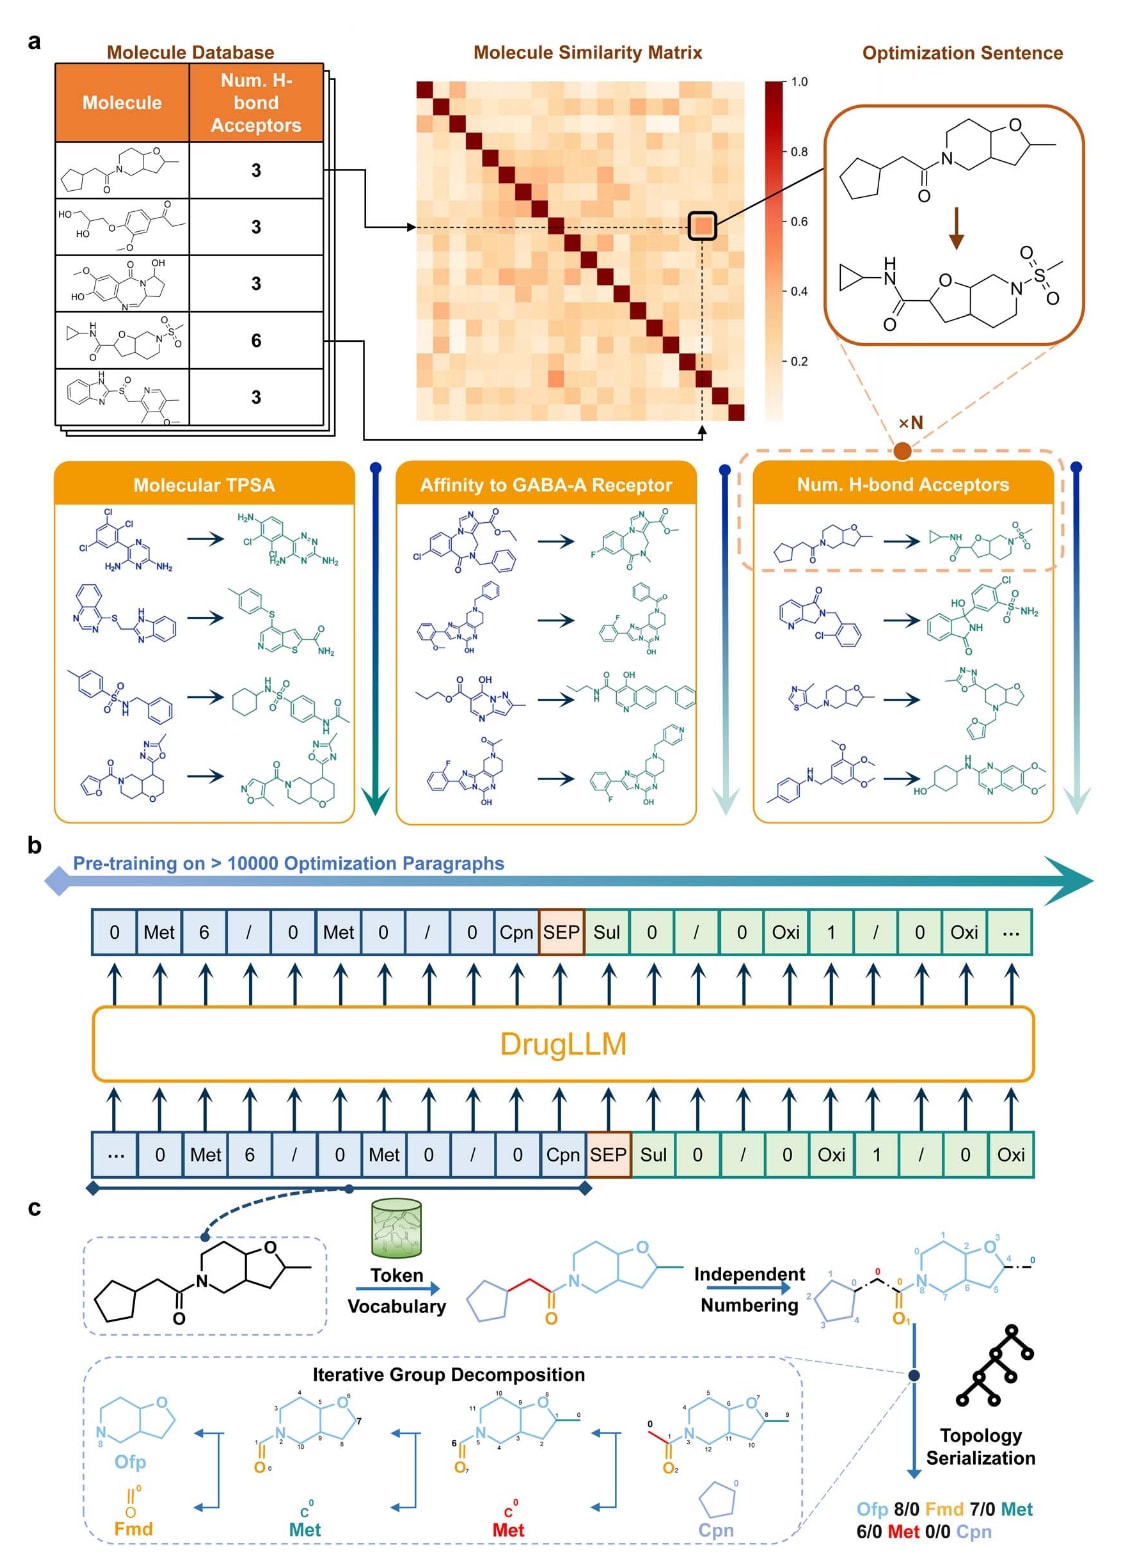
图1|DrugLLM 框架示意图。 a,少样本分子优化数据集的构建。b,DrugLLM 的训练框架。DrugLLM 基于分子修改过程进行训练,每个段落对应一种独立属性。每个段落均为自包含结构,并包含多个特征,不同段落分别对应不同属性。c,所提出的官能团分词(Functional Group Tokenization,FGT)方法的编码流程。
2 结果
2.1 DrugLLM 框架
该工作的核心目标是训练一种能够捕捉小分子结构–活性关系(structure–activity relationship,SAR)的大语言模型。SMILES 是一种广泛使用的化学语言,以线性字符串形式描述分子结构。然而,有时两个结构几乎相同的分子,其规范 SMILES 字符串却可能存在显著差异,从而增加语言模型学习的难度。为此,该研究提出面向 LLM 的**官能团分词(Functional Group Tokenization,FGT)**方法。如图 1 所示,FGT 使用唯一的字符串标识符表示不同的结构基团,并通过斜杠两侧的数字位置信息记录这些基团之间的连接关系。FGT 将结构基团视为独立整体,使模型能够以更高层级理解分子字符串,同时减少 token 数量。
更重要的是,FGT 能够降低由细微结构修改所引起的 SMILES 表示差异(图 S1)。这是因为 FGT 首先将分子拆分为不同的功能片段,再按照规范化的“核心到外围”顺序进行排列,从而形成唯一且无歧义的表示形式,更好地反映分子之间的结构相似性。这种方式简化了分子组装逻辑,也降低了模型识别分子结构的难度。
FGT 的构建过程首先将分子划分为相互连接的结构片段,随后利用预定义字典将这些片段映射为唯一标识符,并进一步生成 FGT 字符串。基于结构基团的分词方式以及对基团连接关系的记录,使 FGT 能够高效编码分子结构。统计结果显示,在 ZINC 数据集上,FGT 的平均序列长度为
为验证 FGT 的实际可用性,在多个数据集上进行了大规模往返重构分析,即 SMILES
与常用的分子片段化方法相比,FGT 在词表效率和分子覆盖率方面同样表现出明显优势。FGT 仅使用 4,796 个 token,即可实现接近完整的分子覆盖率(
FGT 的设计理念与 RECAP、BRICS 等逆合成方法存在本质区别。RECAP 和 BRICS 更强调合成可行性,但其极度稀疏的词表和有限的覆盖能力容易造成“数据稀疏”瓶颈,不利于生成式 LLM 的训练。相比之下,FGT 是一种以分子表示为核心的方法,将官能团视为“推理基本单元”(reasoning primitives)。这种表示方式使 DrugLLM 可以重点学习结构扰动与性质变化之间的逻辑关系,而无需处理 SMILES 中较长距离的原子级依赖。FGT 的紧凑词表还能够保证每个 token 在预训练过程中获得足够的出现频率,从而为基于上下文的 SAR 推理提供稳定且具有可解释性的表示空间,而这一点是基于反应或纯原子级表示的方法难以实现的。
此外,还评估了 FGT 在复杂结构类型中的可扩展性,例如大环分子。在 Macformer 数据集(5,551 个大环分子)和 Macrocycle-DB(50,653 个大环分子)上的实验表明,FGT 词表规模呈现次线性增长趋势(图 S5)。具体而言,当大环分子数量超过 50,000 个时,FGT 词表仍仅包含 5,799 个 token,规模保持在较易管理的范围内。这种效率来源于化学空间中的结构冗余,即不同大环分子通常共享重复出现的骨架结构。
除分子表示之外,如何设计训练范式也是利用 LLM 进行分子生成和优化的另一项关键挑战。现有分子生成策略包括分子图–文本翻译、分子编码–解码等。然而,由于这些训练目标中涉及的 SAR 数据,例如分子性质数据通常较为有限,生成模型很难真正捕捉分子结构与生物学性质之间的基本关系。
为此,DrugLLM 采用下一步修改预测(Next Modification Prediction,NMP)作为整体学习框架,即模型根据当前分子预测下一步应如何修改,从而得到新的分子。在训练过程中,该范式通过\自回归修改预测(RMP)目标实现:每一次分子修改均基于 FGT 表示逐 token 生成,同时关注此前已经生成的 token 以及跨上下文的模式(图 1)。
具体而言,每一次分子修改都表示为一系列 token,多个连续的修改过程被组织成一个“句子”。针对同一种分子性质的多个句子进一步组成一个“段落”,并在段落开头使用自然语言描述所需要优化的性质。例如,如果前三个句子描述的是增加氢键受体数量,那么该段落后续所有句子也都会围绕这一性质展开优化。通过这种方式,每个段落中的信息均高度集中,使 DrugLLM 可以根据前文上下文,以自回归方式生成后续每一个 token。
同时,各个段落彼此独立,并覆盖不同的分子性质,因此 DrugLLM 能够通过**上下文学习(in-context learning)**实现分子优化,即以少样本方式根据给定示例推断新的优化策略。
然而,目前适用于 DrugLLM 训练的相关数据集较为有限。为此,该研究收集了 ZINC 数据库和 ChEMBL 平台中的表格化分子数据,并将其转换为对应的分子修改句子和段落。最终共构建超过 2,400 万个修改段落和 1.8 亿个分子的训练数据集(表 S1),覆盖超过 10,000 种不同的分子性质或生物活性,包括氢键受体数量、对 GABAA 受体的亲和力等。数据集按照
考虑到机器学习模型的少样本学习能力来源于训练过程中接触足够丰富的任务类型,大量且多样化的优化段落有助于 DrugLLM 学习分子设计过程中具有共性的内在规律,从而获得少样本分子优化能力。
DrugLLM 基于 Transformer 架构构建。首先利用 FGT 生成官能团 token,随后结合字节对编码(byte pair encoding,BPE)进一步建立紧凑且高效的词表。DrugLLM 是一个从头训练的大规模模型,其训练目标是生成完整的分子修改段落。从机器学习角度看,每个段落都提供了一组描述少样本分子优化过程的上下文信息。经过大规模训练后,DrugLLM 无需进一步微调,即可直接执行少样本分子优化任务。
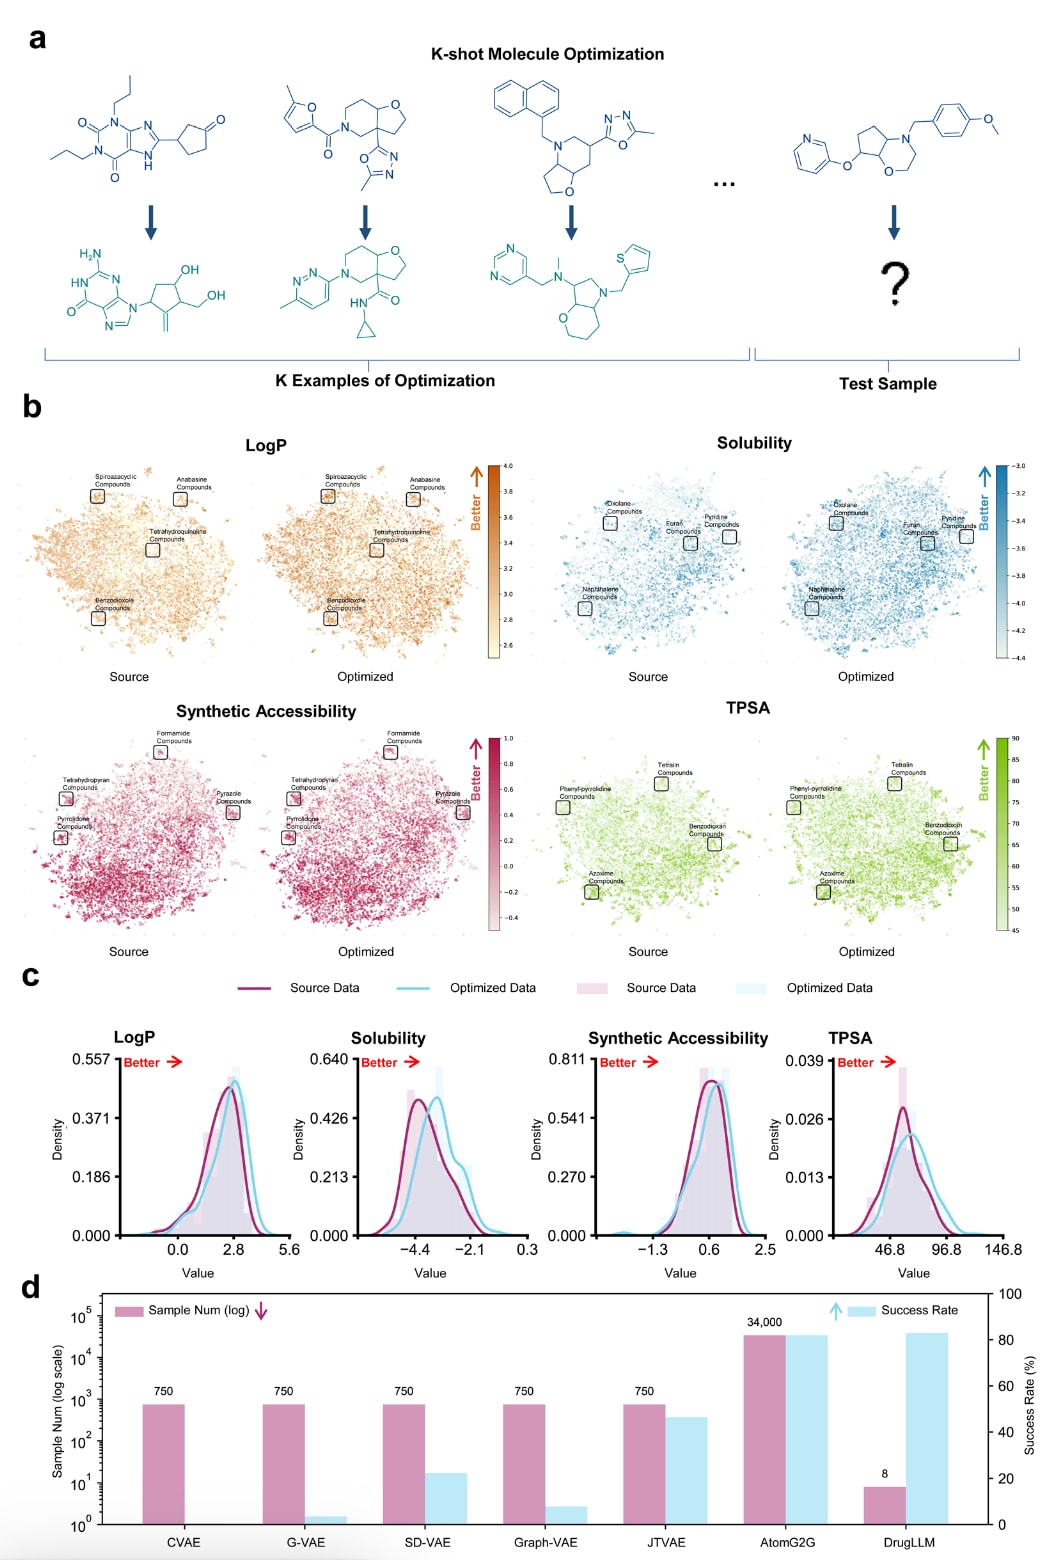
图2|少样本分子优化中的分布比较。 a,DrugLLM 的测试设置。b,源分子空间与生成分子空间的 UMAP 可视化,展示 15,000 个分子在优化前后的分布情况。c,源分子数据集和生成分子数据集中 Log P、溶解度、合成可及性和拓扑极性表面积(TPSA)的核密度估计(Kernel Density Estimation,KDE)分布。d,不同模型所需样本数量与优化成功率的比较,其中成功率定义为生成分子符合预期性质变化趋势的比例。
2.2 面向理化性质的少样本分子优化
为评估 DrugLLM 的少样本分子优化能力,选取训练阶段未使用的若干分子性质,并采用如下评估方案(图 2a)。给定
采用统一流形逼近与投影(Uniform Manifold Approximation and Projection,UMAP)对分子空间进行可视化,以定性评估 DrugLLM 的优化能力(图 2b)。为便于评估,上下文中的性质变化方向统一设置为“提高”,而非同时包含“提高”和“降低”,随后验证 DrugLLM 生成分子的性质变化。结果发现,优化后分子(右侧)与源分子(左侧)在分布上具有较高一致性,表明模型能够保持较好的生成多样性。尽管二者整体分布相似,但生成分子的目标性质值持续高于原始分子,这一点可由更深的颜色体现。进一步通过核密度估计(Kernel Density Estimation,KDE)观察到分布整体向性质改善方向偏移,再次表明 DrugLLM 具有较强的分子优化能力(图 2c)。与 Graph-VAE、JTVAE 和 AtomG2G 相比(图 2d),这些监督学习方法需要高达约 4,000 倍的数据规模,才能达到与 DrugLLM 相近的优化效果。
为定量分析 DrugLLM 的优化能力,进一步将其与多种先进分子生成模型进行比较,包括基于联结树的变分自编码器(junction tree-based variational auto-encoder,JTVAE)、变分联结树神经网络(variational junction tree neural network,VJTNN)以及基于骨架的分子生成模型 MoLeR。与这些主要面向从头分子生成(de novo molecule generation)的通用生成模型不同,DrugLLM 重点解决少样本分子优化问题,即在尽可能保留核心骨架的同时改善特定分子性质。为保证比较公平,采用各方法官方发布的预训练模型,并将其适配至少样本优化任务。此外,还设置了随机优化对照,即基于 JTVAE 潜在空间进行随机采样。
生成分子的质量主要通过优化成功率和分子相似度进行评估。其中,成功率表示生成分子符合给定性质变化趋势,即目标性质按要求升高或降低的比例。为了避免生成模型受到上下文方向偏置的影响,输入上下文中“性质升高”和“性质降低”的示例保持均衡比例。
如图 3 所示,首先评估了针对 Log P 的少样本优化性能。JTVAE、VJTNN 和 MoLeR 三种基线生成模型的优化成功率均约为
对于分子相似度而言,在修改次数更少、即要求生成分子与原分子保持更高相似度的情况下,分子优化通常更加困难。尽管如此,随着生成分子相似度的提高,DrugLLM 仍能保持较高的优化成功率,进一步体现其在少样本分子优化任务中的优势。
此外,采用 FGT 表示的 DrugLLM(DrugLLM-FGT)性能也显著优于使用 SMILES 编码的 DrugLLM(DrugLLM-SMILES),说明 FGT 对大语言模型训练具有明显促进作用。有关 DrugLLM 在不同分子优化任务中的生成质量分析,可参见补充信息中的“分子优化生成质量评估”部分。
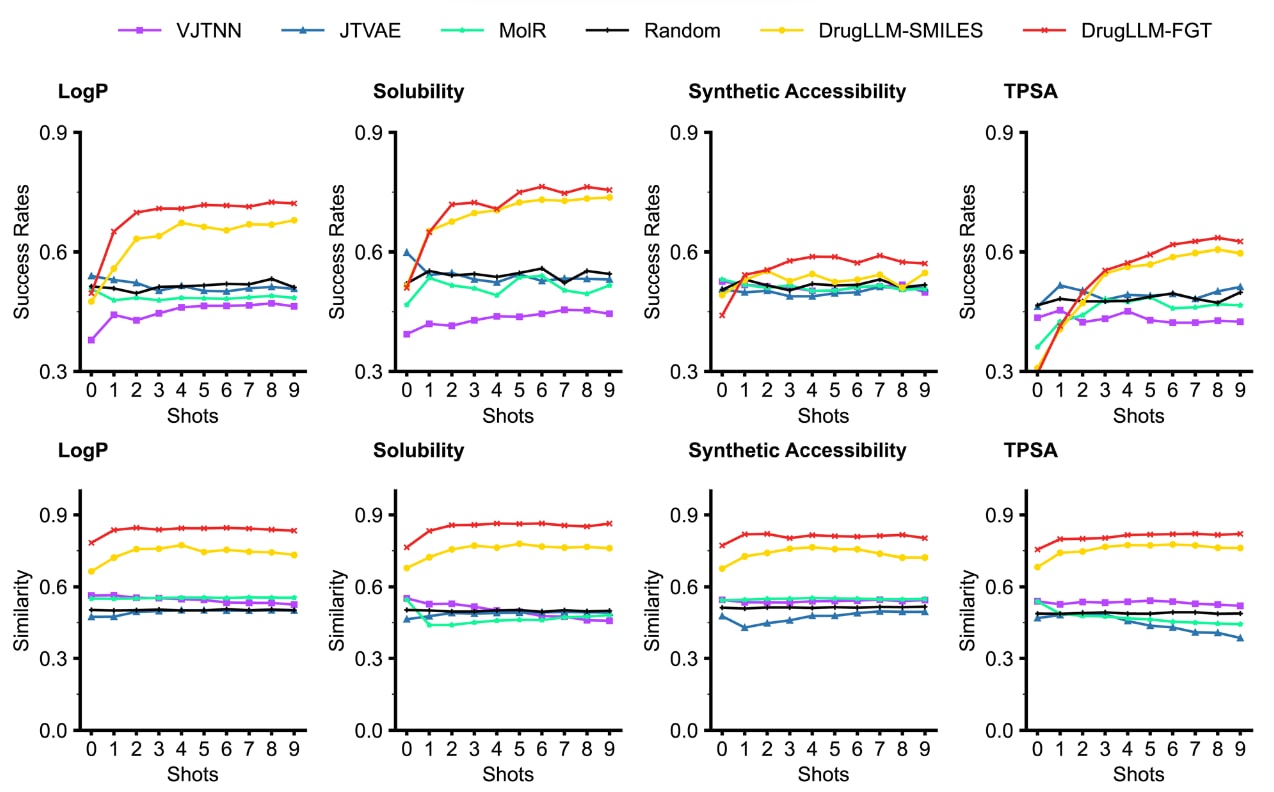
图3|不同生成方法在少样本分子优化任务中的性能。 评估指标包括优化成功率和生成分子的结构相似度,其中成功率定义为生成分子符合预期性质变化趋势的比例。测试涵盖 4 种理化性质,包括 Log P、溶解度、合成可及性以及拓扑极性表面积(TPSA)。
2.3 面向生物活性的少样本分子优化
鉴于 DrugLLM 在理化性质优化中表现出较强的少样本学习能力,进一步评估了其在分子生物活性优化中的有效性。相比理化性质,生物活性受到复杂生命体系机制的影响,因此优化难度更高。DrugLLM 生成的分子通常具有较高新颖性,且未被收录于 ChEMBL 数据库中。与前述理化性质不同,生物活性,例如针对链激酶 A 的
为解决这一问题,采用基于机器学习的可学习性质预测器对生物活性进行近似评估。具体而言,使用 ChemProp 作为预测模型,该模型是一种将分子表示为图结构的消息传递神经网络(message-passing neural network)。这些生物活性预测器的具体训练流程、数据集划分和验证方案详见补充信息。预测器与实验测量值之间均表现出较强相关性,Pearson 相关系数均不低于
对于每种性质,优化方向,即提高或降低,均可以通过自然语言指令明确指定。优化成功率定义为相对于参考分子,生成分子的目标性质变化方向与指定方向一致的比例。测试集在性质提高和性质降低两类任务之间保持均衡。值得注意的是,用于测试的 20 种目标生物活性均未出现在 DrugLLM 的训练集中,因此能够较为客观地评估 DrugLLM 在未见过的生物靶点上的泛化性能。
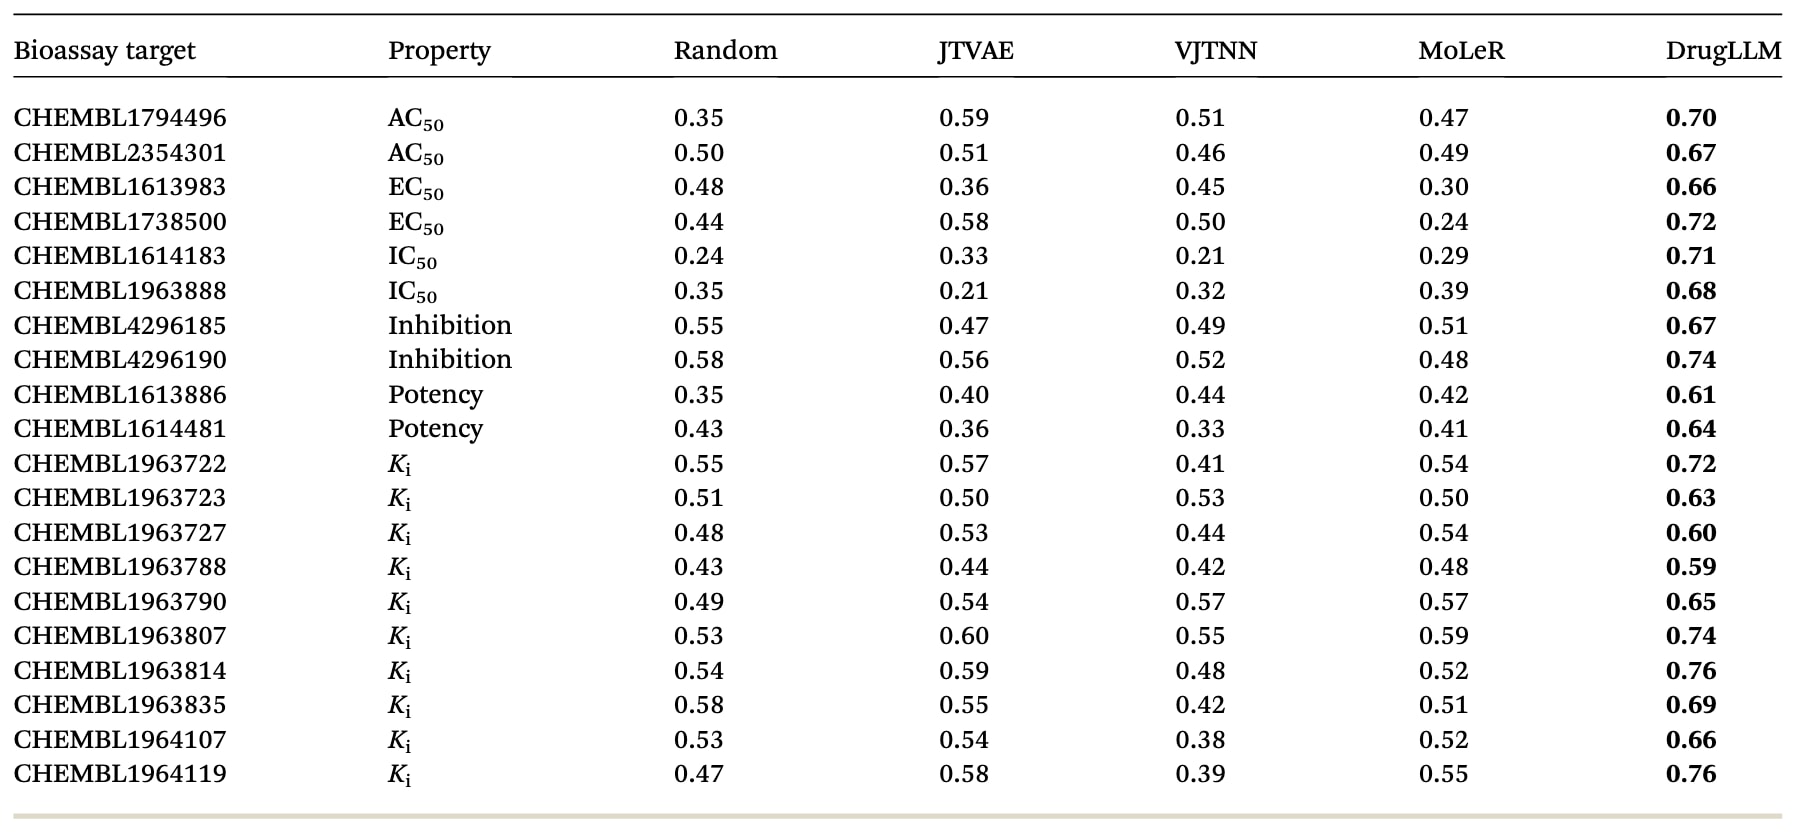
在这些更具挑战性的生物活性优化任务中,3 种基线生成模型均未取得有意义的性能提升(表 1)。所有基线模型的表现均与随机生成模型相近,表明这些分子生成模型仍难以从有限示例中学习潜在的分子修改规律。相比之下,DrugLLM 在大多数测试性质上均显著优于其他基线模型。
其中,在生物测定靶点 CHEMBL1963814 的
总体而言,结果表明,即使面对模型训练阶段从未见过的分子性质,只要提供有限数量的示例,DrugLLM 仍能够从中推断出分子结构修改与性质变化之间的内在规律。
表1|面向不同生物活性的少样本分子优化成功率。 成功定义为生成分子的目标性质按照指定优化方向发生变化。各目标测定任务的详细说明见表 S4。
2.4 零样本分子优化
前述实验表明,DrugLLM 能够有效学习分子修改规律,并生成具有目标性质的新分子。本节进一步探索零样本分子优化(zero-shot molecular optimization),即在未见过特定训练实例组合的情况下,仅根据自然语言指令生成性质得到改善的分子。在这一实验设定下,假设 DrugLLM 在大量单一性质及其组合任务上完成训练后,可以按照组合式零样本学习(compositional zero-shot learning)范式,对训练阶段未见过的性质组合进行泛化优化。
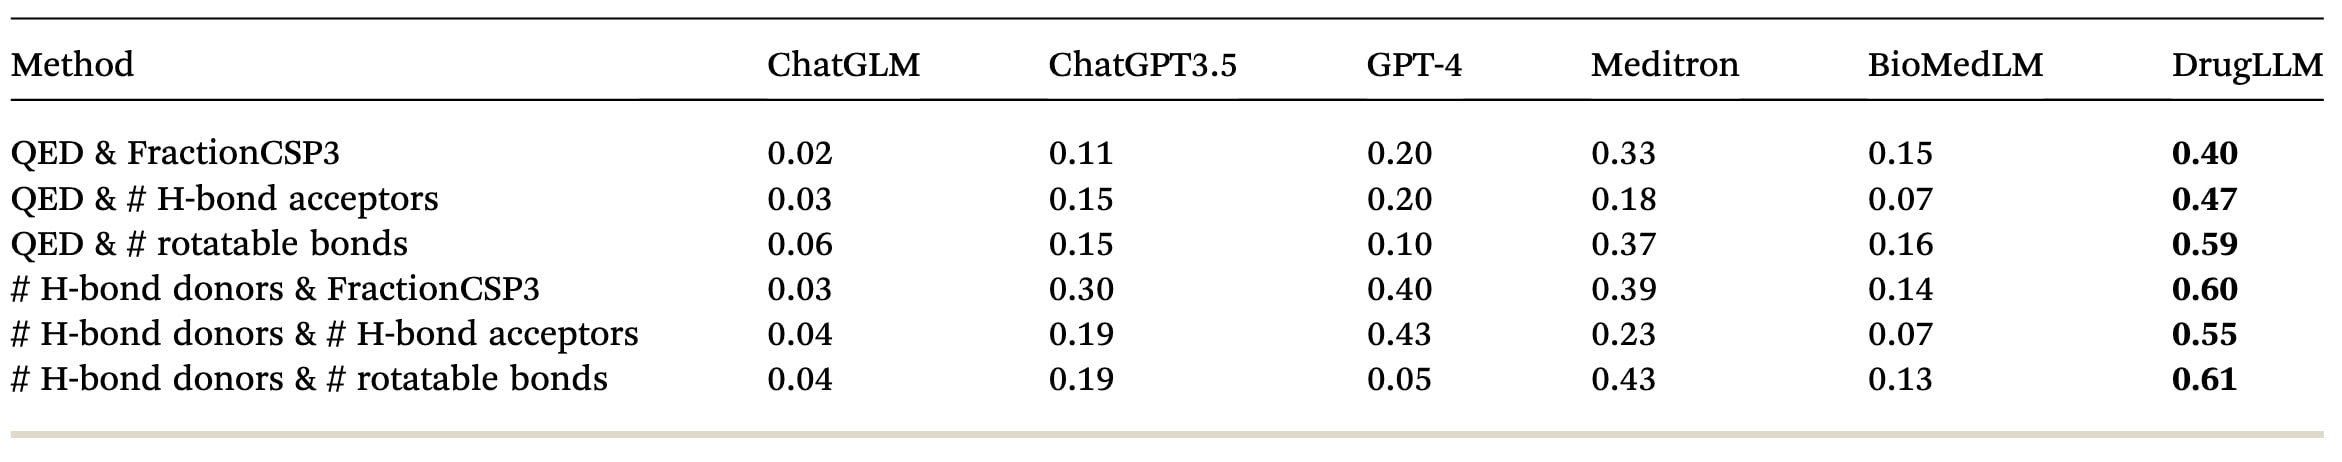
例如,单独优化定量药物相似性评估指标(Quantitative Estimation of Drug-likeness,QED)或 FractionCSP3 的任务均包含在训练集中,但同时优化 QED 和 FractionCSP3 的联合任务并未出现在训练数据中,因此可用于零样本评估。基于这一原则,选取了 6 个未包含在 DrugLLM 训练集中的组合优化任务作为测试任务,并构建了包含 6,000 余条指令的测试集,每个优化任务包含 1,000 条指令。生成分子利用基于 RDKit 库编写的 Python 脚本进行评估。对于这类组合任务,将优化成功率定义为:生成分子中,两种性质均同时按照自然语言指令指定方向实现优化的比例。
零样本分子优化对语言模型而言具有较大挑战,主要体现在两个方面。一方面,从通用语料中学习自然语言语义(指令)与分子性质之间的映射关系本身就非常困难;另一方面,由于湿实验周期长、成本高,能够反映分子结构与性质关系的生物学数据通常较为有限。
为评估 DrugLLM 在上述挑战下的零样本能力,将其与多种当前先进的通用大语言模型和领域专用大语言模型进行了比较。基线模型包括通用 LLM,如 ChatGPT-3.5、GPT-4 和 ChatGLM,以及两种在大规模生物医学语料上预训练的领域专用生物医学语言模型 Meditron 和 BioMedLM。其他通用 LLM,例如 LLaMA,由于无法生成有效的 SMILES 字符串,因此未纳入比较。
结果显示,ChatGLM 在所有零样本分子优化任务中均难以生成符合要求的分子(表 2),其大多数输出只是与输入分子完全相同的重复结构。此外,ChatGPT-3.5、GPT-4、Meditron 和 BioMedLM 虽然能够理解指令,并对部分给定分子进行优化,但总体优化成功率仍然较低。相比之下,DrugLLM 的优化成功率显著高于其他 LLM,表明其在自然语言指令理解和分子优化方面具有更强的能力。
表2|不同方法在零样本分子优化任务中的成功率
2.5 DrugLLM 在新型 HCN2 抑制剂发现中的应用
为验证 DrugLLM 在药物发现中的潜在应用价值,将其用于生成靶向超极化激活环核苷酸门控通道 2(hyperpolarization-activated cyclic nucleotide-gated channel 2,HCN2)的新分子。HCN2 是 HCN 通道家族四个成员(HCN1–4)之一,可被膜电位超极化激活。目前,HCN2 亚型已被认为是治疗慢性疼痛的潜在药物靶点。然而,针对 HCN2 抑制剂的开发研究仍较为有限。伊伐布雷定(ivabradine)是一种已获批用于治疗心绞痛的广谱 HCN 抑制剂,可作为先导结构,用于开发疗效更强、安全性更好的小分子镇痛药。
该研究进一步验证了 DrugLLM 优化伊伐布雷定、提高其对 HCN2 生物活性的能力。首先,将伊伐布雷定优化任务构建为少样本分子优化过程,使 DrugLLM 能够从已有优化示例中学习结构修改规律,并据此改造给定分子。研究从近期文献中收集了经实验验证的 HCN2 抑制剂生物活性数据作为支持示例,并将这些数据整理为 3 对分子,每一对分子的结构变化均对应 HCN2 的
由于 DrugLLM 执行的是分子优化而非从头生成,因此生成分子能够自然保留与输入化合物较高的结构相似性,同时探索多种不同的取代基修改方案。所有候选分子均由 DrugLLM 直接生成,未经过人工结构编辑。随后,模型根据生成概率,即序列概率,对候选分子自动进行排序。
在湿实验验证阶段,化学专家从排名靠前的候选分子中选择了 HCN2-M1 和 HCN2-M2 两个分子。筛选主要依据合成可及性及实际实验操作因素,以确保候选分子能够被可行地合成。由此,候选分子的生成和排序均由模型驱动,而人工专业判断仅用于最终的实验验证候选选择。
随后,分别对 HCN2-M1、HCN2-M2 和伊伐布雷定开展膜片钳实验,实验对象为在 HEK293 细胞中异源表达人 HCN2 亚型的体系。具体实验流程见补充信息中的膜片钳实验部分。体外实验结果显示,HCN2-M1 和 HCN2-M2 的
此外,还分析了 DrugLLM 在生成 HCN2-M1 和 HCN2-M2 时的注意力激活情况(图 4c)。结果发现,DrugLLM 对伊伐布雷定中的甲氧基和苯并氮杂卓基团赋予了较高注意力,而这些结构单元确实被认为是参与 HCN2 相互作用的关键基团。
总体而言,这些结果表明,DrugLLM 生成的候选分子具有更强的 HCN2 抑制活性,并进一步验证了该模型在真实药物发现场景中的有效性。
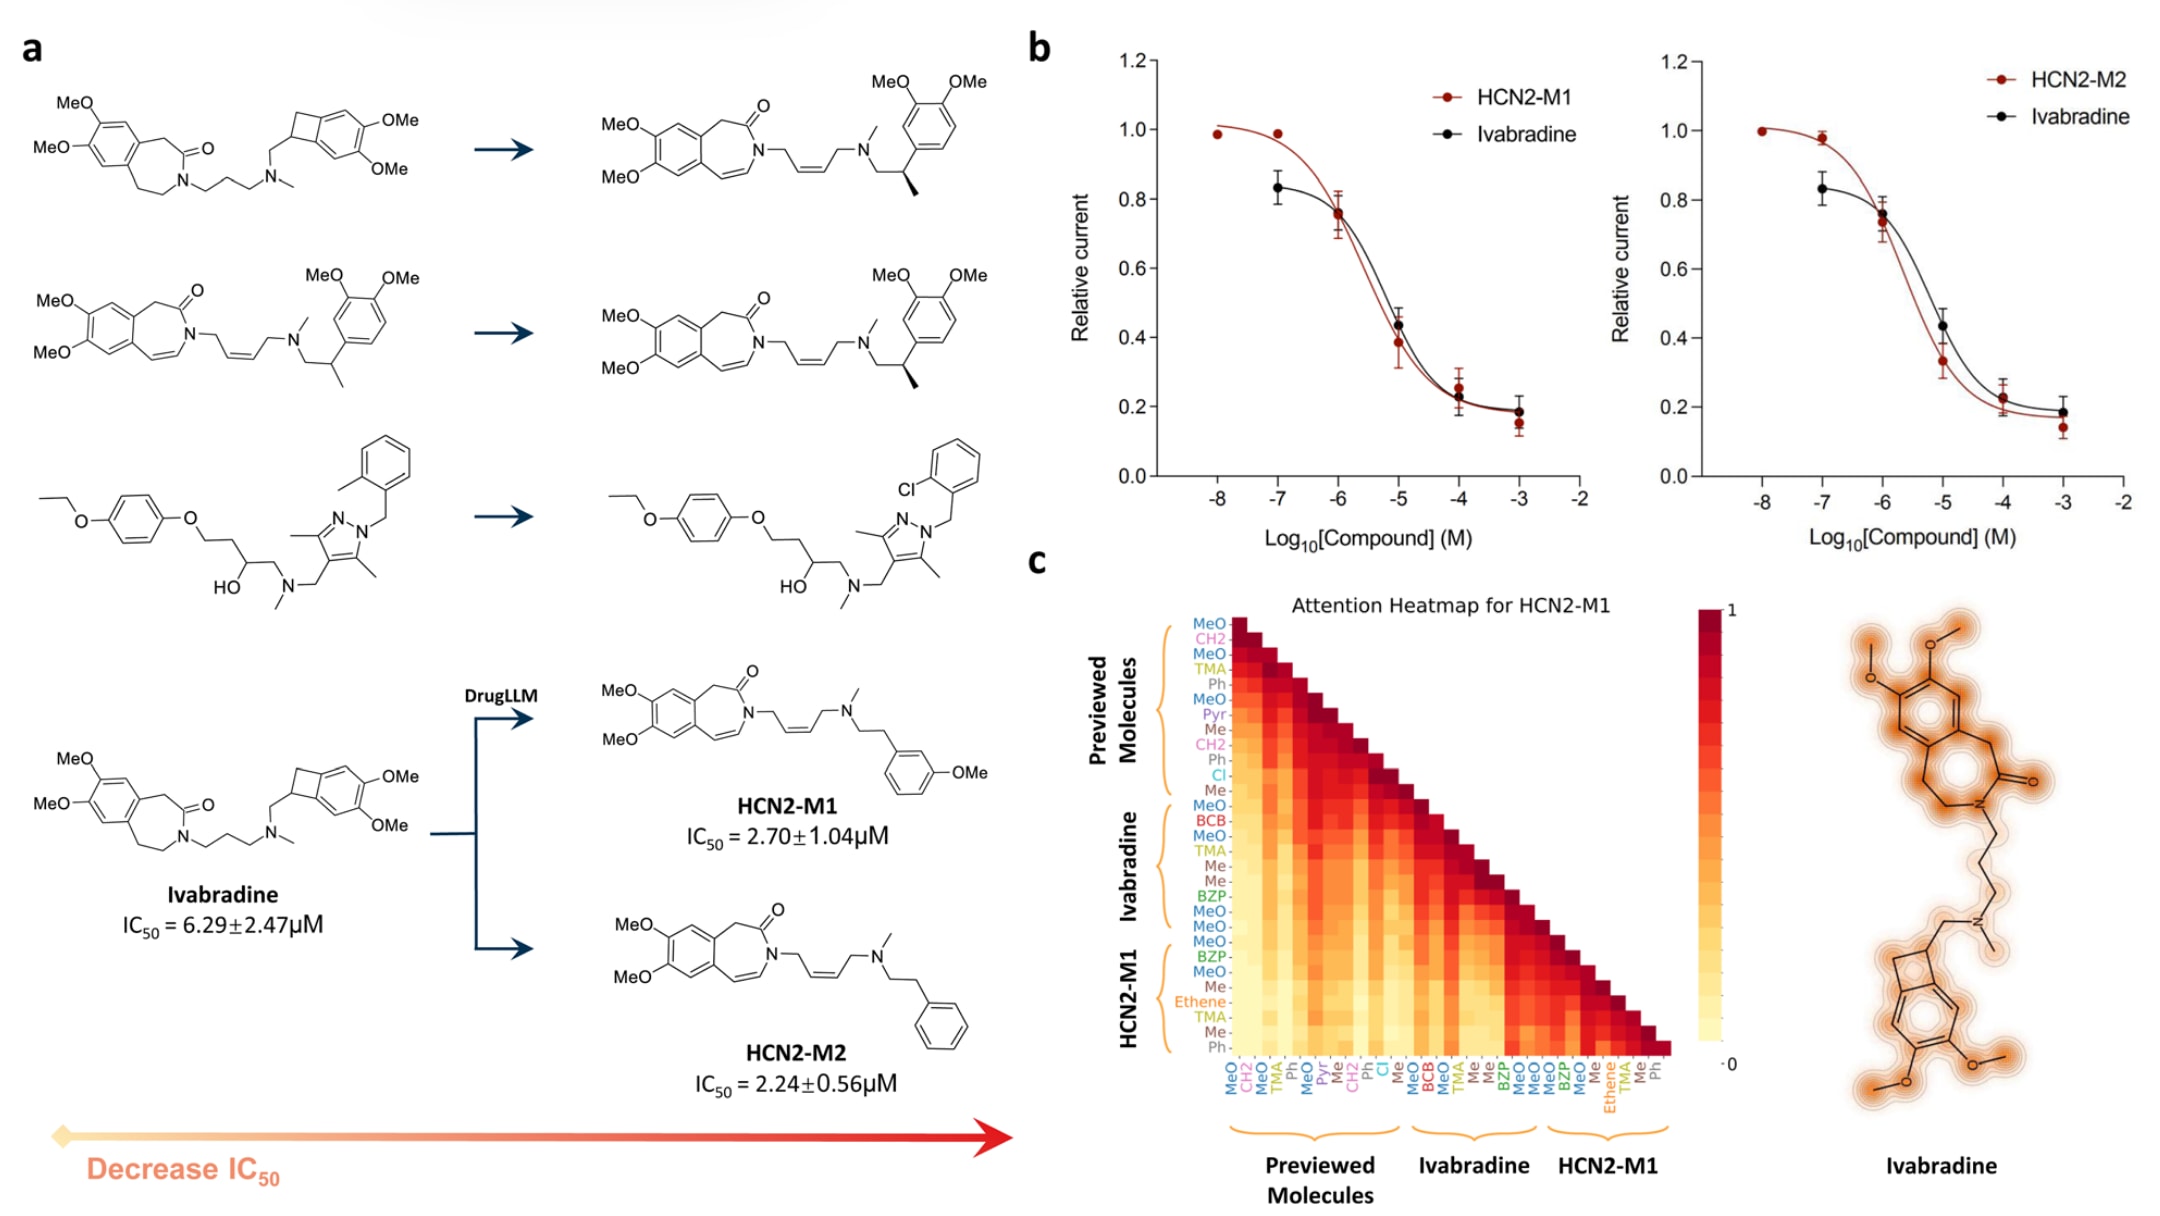
图4|DrugLLM 在 HCN2 抑制剂优化中的应用。 a,DrugLLM 的输入及其生成结果,包括 HCN2-M1 和 HCN2-M2。b,HCN2-M1 和 HCN2-M2 对异源表达于 HEK293 细胞中的人 HCN2 亚型的剂量–反应曲线。实验独立重复 5–8 次,所有数据均以均值 ± s.e.m. 表示。c,DrugLLM 生成 HCN2-M1 时的注意力图。HCN2-M2 的注意力图见图 S2。
3 讨论
该研究提出了一项新的计算任务——少样本分子优化(few-shot molecular optimization)。给定一个目标分子,该任务要求模型根据少量分子修改示例中蕴含的优化规律,生成新的候选分子。尽管计算生物学领域已经提出并研究了多种少样本学习任务,但专门针对这种分子优化问题的研究仍较少。少样本分子优化的难点在于,模型需要从极少量示例中提取抽象的修改规律,并将其应用于新的分子,这实际上要求模型具备刻画复杂“结构–效应–代谢–毒性”关系的能力。针对这一挑战,该研究开发了专门用于少样本分子优化的 DrugLLM。
DrugLLM 是一种基于大规模文本语料训练的大语言模型,其训练数据覆盖广泛的小分子和生物学领域。近年来,ChatGPT-3.5、Alpaca 和 ChatGLM 等通用大语言模型已经在自然语言生成方面展现出较强能力,但这些模型主要面向通用任务,缺乏药物科学所需的专业知识。尽管目前也存在 BioGPT、DrugGPT 等面向生物医学领域的大语言模型,但这些模型主要关注自然语言,即生物医学文本的生成。因此,LLM 如何理解化学和生物学背后的“语言”,尤其是在少样本条件下实现这种理解,仍然是一个尚未充分解决的问题。
该研究首次尝试构建专门用于少样本分子生成和优化的 LLM。基于分子性质和生物活性的表格数据,构建了一个以连续分子修改序列形式组织的大规模文本语料库。DrugLLM 通过自回归方式,根据历史修改过程预测下一个分子。在大量计算实验中,DrugLLM 在超过 24 种分子性质和生物活性的少样本优化任务中均优于其他竞争方法,包括 GPT-4。上述结果表明,该方法能够显著提升少样本分子优化效率,并显示出 DrugLLM 作为药物发现计算工具的应用潜力。
DrugLLM 生成结果的一个重要特征是:尽管模型并未显式施加结构约束,但在优化过程中往往能够保留输入分子的核心骨架。该研究认为,这种涌现行为主要来源于两个方面。首先,FGT 表示按照“由核心向外围”的方式编码分子,其中核心通常对应占主导地位的环系,因此序列表示天然更加重视中心结构。其次,训练数据主要由连续分子修改轨迹构成,相邻分子之间的结构变化通常较小,并主要发生在分子外围。核心优先的表示方式与训练样本中常见的局部修改模式相结合,使模型能够隐式学习“保留核心骨架、优化外围结构”的修改规律,这与药物化学中常见的先导化合物优化过程高度一致。
为进一步解释 DrugLLM 为何能够产生上述涌现行为,该研究强调了 FGT 的设计理念。FGT 本质上是一种以表示为核心的方法,与 RECAP 或 BRICS 等逆合成导向的片段化方法存在明显区别。后者更加关注形式上的合成可行性,但往往会产生极其稀疏的词表,例如超过 500,000 个 token,同时只能覆盖部分药物样化学空间,从而造成不利于 LLM 训练的“数据稀疏”瓶颈。相比之下,FGT 将结构基团视为“推理基本单元”,使用仅包含 4,796 个 token 的紧凑且具有较强表达能力的词表,从而保证每种结构基序在预训练过程中能够被模型充分观察。
FGT 提供了一种位于原子级表示与完整分子表示之间的中间层级序列表示,相比 SMILES 可将序列长度缩短
这种领域专用设计还能够减少生成过程中的“幻觉”,即生成化学上不合理或无效的分子。DrugLLM 在官能团层级进行生成,并使用预定义的结构和语义约束;同时,在少样本优化场景下,分子修改通常围绕已知先导化合物展开,从而进一步保证化学合理性。所有模型输出还会通过 RDKit 进行结构检查和清洗,以过滤无效分子。尽管这些措施仍无法完全消除少量边界情况或复杂结构不一致问题,但整体上能够保证 DrugLLM 生成具有较高质量和化学合理性的分子。
在计算实验中,基于大规模 ChEMBL 生物测定数据,DrugLLM 在 20 个生物学靶点上的优化性能达到当前先进水平,为模型在这些数据集上的表现提供了较为稳健的统计学验证。为进一步评估真实应用能力,还选择两个 HCN2 抑制剂候选分子 HCN2-M1 和 HCN2-M2 进行了湿实验概念验证(proof-of-concept,PoC)。两种候选分子相较于伊伐布雷定均表现出更强的 HCN2 抑制活性。尽管实验验证规模仍然有限,但这些 PoC 结果表明,在真实实验约束下,DrugLLM 能够有效辅助候选分子的选择。
尽管具有上述优势,该研究仍存在若干局限。首先,DrugLLM 当前的零样本分子优化能力仍较为初步。虽然模型能够根据简单指令优化分子,但对于蛋白质结构等复杂约束的处理仍具有较大挑战。其次,目前模型主要处理单一性质或两个性质的简单组合,同时优化更加复杂的多性质目标仍然较为困难。第三,湿实验验证仅涉及两个 HCN2 抑制剂,因此对真实应用性能的评估仍属于初步阶段;关于候选分子的合成路线、作用机制以及临床前开发等内容并未纳入该研究范围。
未来可进一步扩大湿实验验证规模,开发更复杂的多性质联合优化策略,并探索具有潜力的候选分子向临床前开发阶段进一步推进的可行性。