NMI 2026|VITAL:肽–蛋白相互作用的定量化与界面感知预测
多肽–蛋白相互作用是理解多肽生物学功能和推动多肽药物设计的核心,但现有方法往往只能回答“是否结合”,难以进一步解析“在哪里结合、结合多强”。该研究提出 VITAL,一种融合蛋白质语言模型与界面几何信息的双通道深度学习框架,可同时实现 PepPI 预测、结合位点定位和亲和力定量评估。VITAL 在多个基准数据集上取得较优性能,并通过实验验证识别出真实结合肽。更重要的是,该方法提出亲和力强度矩阵(ASM)和结合强度单位(BSU),将 PepPI 分析从二元分类推进到连续定量表征,并进一步用于全蛋白质组靶点发现、药物再利用和脱靶安全性评估。该研究为多肽相互作用研究提供了兼具高通量、可解释性和转化潜力的新型计算平台。
获取详情及资源:
- 📄 论文: https://doi.org/10.1038/s42256-026-01291-z
- 💻 代码: https://github.com/BADDxmu/VITAL
- 🛜 网站: https://www.vital-peppi.online
0 摘要
肽–蛋白相互作用的定量表征一直是计算生物学中的重要挑战,限制了对其作用机制的深入理解以及相关治疗手段的开发。该研究提出 VITAL(Versatile InTerface-Aware global-local co-Learning),一种基于双通道协同学习架构的深度学习框架,将蛋白质语言模型嵌入与具备几何感知能力的编码器相融合,后者用于捕捉相互作用界面上的空间邻近关系。通过这种整合式学习策略,VITAL 可同时实现肽–蛋白相互作用预测、结合界面定位以及定量亲和力估计。
VITAL 主要在三个方面推动了该领域的发展。首先,在多个不同基准数据集上,VITAL 均取得了当前领先的预测精度,最高 AUC 达到 0.87;同时,在实际多肽发现任务中,对部分新预测相互作用进行了实验验证。其次,该方法可实现接近残基分辨率的界面定位,预测精度超过 60%,并据此支持对四类基本结合模式进行系统分类。最后,该研究提出了结合强度单位(binding strength unit),作为一种连续型亲和力指标,与实验测定数据呈显著相关性。
通过将高分辨率结构特征刻画与定量评分统一起来,VITAL 构建了一个可扩展的计算平台,推动肽–蛋白相互作用分析从定性筛选向定量化、结构信息驱动的分析模式转变,从而提升多肽类治疗分子的发现与设计效率。该模型已以开源软件包和交互式 Web 服务器的形式公开,以促进社区应用及后续方法学创新。
1 引言
多肽和小型蛋白质(<50 个氨基酸)正迅速发展为一类重要的治疗分子和生物调控因子,PeptideAtlas 中已收录超过 400 万条相关记录。其中,一部分在进化过程中高度保守,可在不同物种中介导细胞信号传导、免疫防御和代谢稳态。凭借较高的特异性、生物活性和较低的免疫原性,多肽在药物开发中填补了小分子药物与生物大分子药物之间的空白。目前已有 60 余种多肽类药物获批用于治疗糖尿病、心血管疾病、癌症、严重细菌感染(如万古霉素、达托霉素)以及罕见遗传性疾病(如 elamipretide)。其中,以司美格鲁肽为代表的胰高血糖素样肽-1(glucagon-like peptide-1,GLP-1)受体激动剂取得的临床成功,进一步凸显了多肽类药物的治疗潜力。
从机制层面理解多肽功能,关键在于解析肽–蛋白相互作用(peptide–protein interactions,PepPIs),但这一任务受到多种固有生物物理性质和技术因素的制约。多肽通常具有显著的构象异质性,往往只有在与蛋白质结合后才形成较为稳定的结构构象。其结合界面通常较浅、作用短暂,并由多个较弱且分散的相互作用共同维持,因此无论是亲和力定量还是界面定位都较为困难。冷冻电镜和表面等离子体共振等实验技术能够提供有价值的结构和动力学信息,但其通量较低、样品需求较高,限制了在大规模研究中的应用。
计算方法提供了另一条互补路径,但在 PepPI 的定量解析方面同样存在局限。AutoDock Vina 和 Rosetta FlexPepDock 等基于结构的方法通常基于诱导契合假设开展建模,而 AlphaFold3 则提供了一种不同的端到端结构预测流程,并不依赖相同的机制假设。与此同时,CAMP(用于多层级肽–蛋白相互作用预测的深度学习框架)和 DeepPepPI(用于植物肽–蛋白相互作用预测的深度交叉依赖框架)等基于序列的深度学习模型,通过卷积层和自注意力层直接从序列信息预测相互作用。尽管这类方法具有较高通量,但往往缺乏可解释性,难以进一步揭示结合基序或结构机制。
此外,层次化统计力学建模(hierarchical statistical mechanical modelling,HSM)、锚定位点感知高性能深度模型(DeepMHCI)以及滑动窗口相互作用语法(Sliding Window Interaction Grammar,SWING)等专用预测方法,通过引入领域知识,可对主要组织相容性复合体(major histocompatibility complex,MHC)–多肽识别等特定体系进行较为准确的建模。然而,这些模型高度依赖特定蛋白家族的训练数据,因此难以泛化至类型更加多样的 PepPI 体系。
尽管近年来相关方法不断发展,目前仍缺乏一个能够对 PepPI 进行定量化、可解释性表征的统一计算框架,而这正是加速多肽治疗分子理性设计所迫切需要的能力。为弥补这一不足,该研究提出 VITAL(Versatile InTerface-Aware global-local co-Learning),一种将大规模序列预测、精确界面定位与亲和力估计相结合的深度学习框架。通过同时解析结合位点并量化相互作用强度,VITAL 推动多肽发现向数据驱动模式转变,并为基于结构信息的多肽治疗分子开发提供支持。
2 结果
2.1 VITAL:用于肽–蛋白相互作用定量预测的双通道协同学习架构
尽管全局蛋白质上下文已被认为是预测肽–蛋白相互作用(PepPI)的基础信息,但界面残基可能通过动态结合赋予相互作用特异性和稳定性。为同时捕捉这些特征,该研究开发了 VITAL,一种双通道协同学习框架,创新性地融合全局序列上下文与高分辨率结构信息,以提升 PepPI 预测性能(图 1a、b)。
VITAL 通过两个互补通道处理输入的 PepPI 复合物:(1)序列解析通道,利用预训练蛋白质语言模型 Evolutionary Scale Modeling 2(ESM-2)将完整的多肽和蛋白质序列编码为 640 维(640D)特征向量;(2)界面感知解析通道,通过计算几何嵌入(geometry embedding)(图 1c–e)表征结合界面处的空间相互作用模式,并输出一个 726 维的片段间特征(inter-fragment feature)以及亲和力强度矩阵(affinity strength matrix,ASM)。两个通道得到的特征随后进行拼接,并输入多层感知机(multi-layer perceptron,MLP),完成最终的二分类预测。
几何嵌入是 VITAL 框架的核心创新之一,将基于片段的表征学习与显式三维结构约束相结合。首先,通过滑动窗口将多肽和蛋白质序列分别分解为相互重叠的片段。随后,利用 ESM-2(esm2_t30_150M_UR50D)、iFeature 和 SPOT-1D(SPOT-1D-Single)对每个片段进行特征编码,并分别输入具有自注意力机制的 Transformer 编码器进行处理(图 1c)。
为捕捉片段之间的两两关联,对所有多肽片段和蛋白质片段的嵌入向量进行点积运算,构建片段间关系矩阵(inter-fragment relation matrix,IRM)。与此同时,根据 PepPI 复合物的原子坐标计算残基水平的距离矩阵,并在此基础上建立经过几何约束验证的肽–蛋白亲和力二部网络(peptide–protein affinity bipartite network,PABN)(图 1d)。PABN 中的边权重对应每一对片段之间最短的残基距离,随后进一步将该网络编码为二部邻接矩阵(bipartite adjacency matrix,BAM)。
接下来,通过门控学习模块融合语义层面的 IRM 与空间层面的 BAM 片段相互作用信息,得到 ASM。随后,采用三种不同形式的卷积核——水平卷积、垂直卷积和交错卷积——分别显式建模一对多、多对一以及多对多的片段相互作用模式。进一步利用多尺度卷积网络对 ASM 进行解码,提取具有层次性的相互作用模式,并最终输出片段间特征向量(图 1e)。
VITAL 并不仅限于判断多肽与蛋白质是否发生相互作用。ASM 还被设计用于直接定位结合位点并推断结合亲和力,并通过附加模块从多个维度解析 PepPI 的结构与功能特征,相关结果将在后文进一步展开。
具体实现细节和应用流程见方法部分。VITAL 框架及其预训练模型已通过 GitHub 仓库和交互式 Web 服务器公开,以促进该方法在相关研究中的使用与推广。
2.2 VITAL 在多种定性 PepPI 预测任务中的基准测试
2.2.1 VITAL 与当前先进预测方法的性能比较
在模型开发阶段,该研究基于蛋白质结构数据库(Protein Data Bank,PDB)中 9,701 个经实验解析的肽–蛋白相互作用(PepPI)样本,以及等量通过计算生成的负样本,构建了 VITAL_benchmark 数据集。同时,额外留出包含 1,600 个样本的平衡独立测试集 VITAL_test 用于模型评估。所有模型训练和测试均在 PyTorch 1.12.1/Python 3.9 环境下完成,使用 NVIDIA GeForce RTX 3090 GPU 和 CUDA 11.4。
在 VITAL_test 上,VITAL 的准确率(accuracy,ACC)达到 81.00%,受试者工作特征曲线下面积(area under the receiver operating characteristic curve,AUC)为 86.99%,精确率–召回率曲线下面积(area under the precision–recall curve,AUPR)为 83.86%,精确率(precision,PRE)为 78.51%,召回率(recall,REC)为 85.38%,F1 分数为 81.80%。值得注意的是,虽然 VITAL 在训练过程中引入了结构信息,但在实际预测阶段仅依赖序列信息,因此输入仅需多肽序列和蛋白质序列。
为公平比较模型性能,该研究选择三种当前先进的基于序列的预测方法——CAMP、DeepPepPI 和 SWING——并使用 VITAL 的训练集从头重新训练所有模型。在多个测试集上,包括 VITAL_test、CAMP_test、植物特异性的 DeepPepPI_test 以及 MHC–抗原体系的 SWING_test,VITAL 的整体表现均优于或至少与其他模型相当,显示出较稳定的预测准确性和判别能力(图 2a 和补充表 1)。不过,VITAL 在植物特异性数据集和 MHC–抗原数据集上的性能相对有限,表明当模型应用于进化距离较远或高度特化的相互作用类型时,仍存在明显的领域特异性数据壁垒。
当使用 CAMP 的训练集重新训练时,VITAL 在 CAMP_test 上再次取得更优性能,甚至超过 CAMP 本身(补充表 1)。由于 DeepPepPI 和 SWING 数据集缺乏足够的结构信息,无法满足 VITAL 几何嵌入模块的训练需求,因此未能在这两个数据集上重新训练 VITAL。此外,在直接使用各先进模型原始预训练权重进行跨数据集测试时,VITAL 同样保持了具有竞争力的性能(补充表 2)。
为模拟实际应用中阳性相互作用较为稀疏的场景,该研究进一步构建了阳性与阴性样本比例分别为 1:5 和 1:10 的不平衡测试集。同时,在保持训练集总规模不变的情况下,使用相同的 1:5 和 1:10 比例重新训练 VITAL,分别记为 VITAL1:5 和 VITAL1:10。
在这些不平衡测试集上,原始 VITAL 模型,即使用平衡数据训练的模型,仍表现出较强竞争力。在 1:5 和 1:10 测试集中,其 F1 分数分别达到 0.6248 和 0.5192,均为所有比较方法中的最高值;对应的 AUC 分别为 0.8625 和 0.8623,同样高于包括不平衡数据重新训练版本在内的其他方法(补充表 3)。进一步使用不平衡数据重新训练模型并未带来额外的性能提升。这些结果表明,VITAL 对类别不平衡具有较强的鲁棒性。
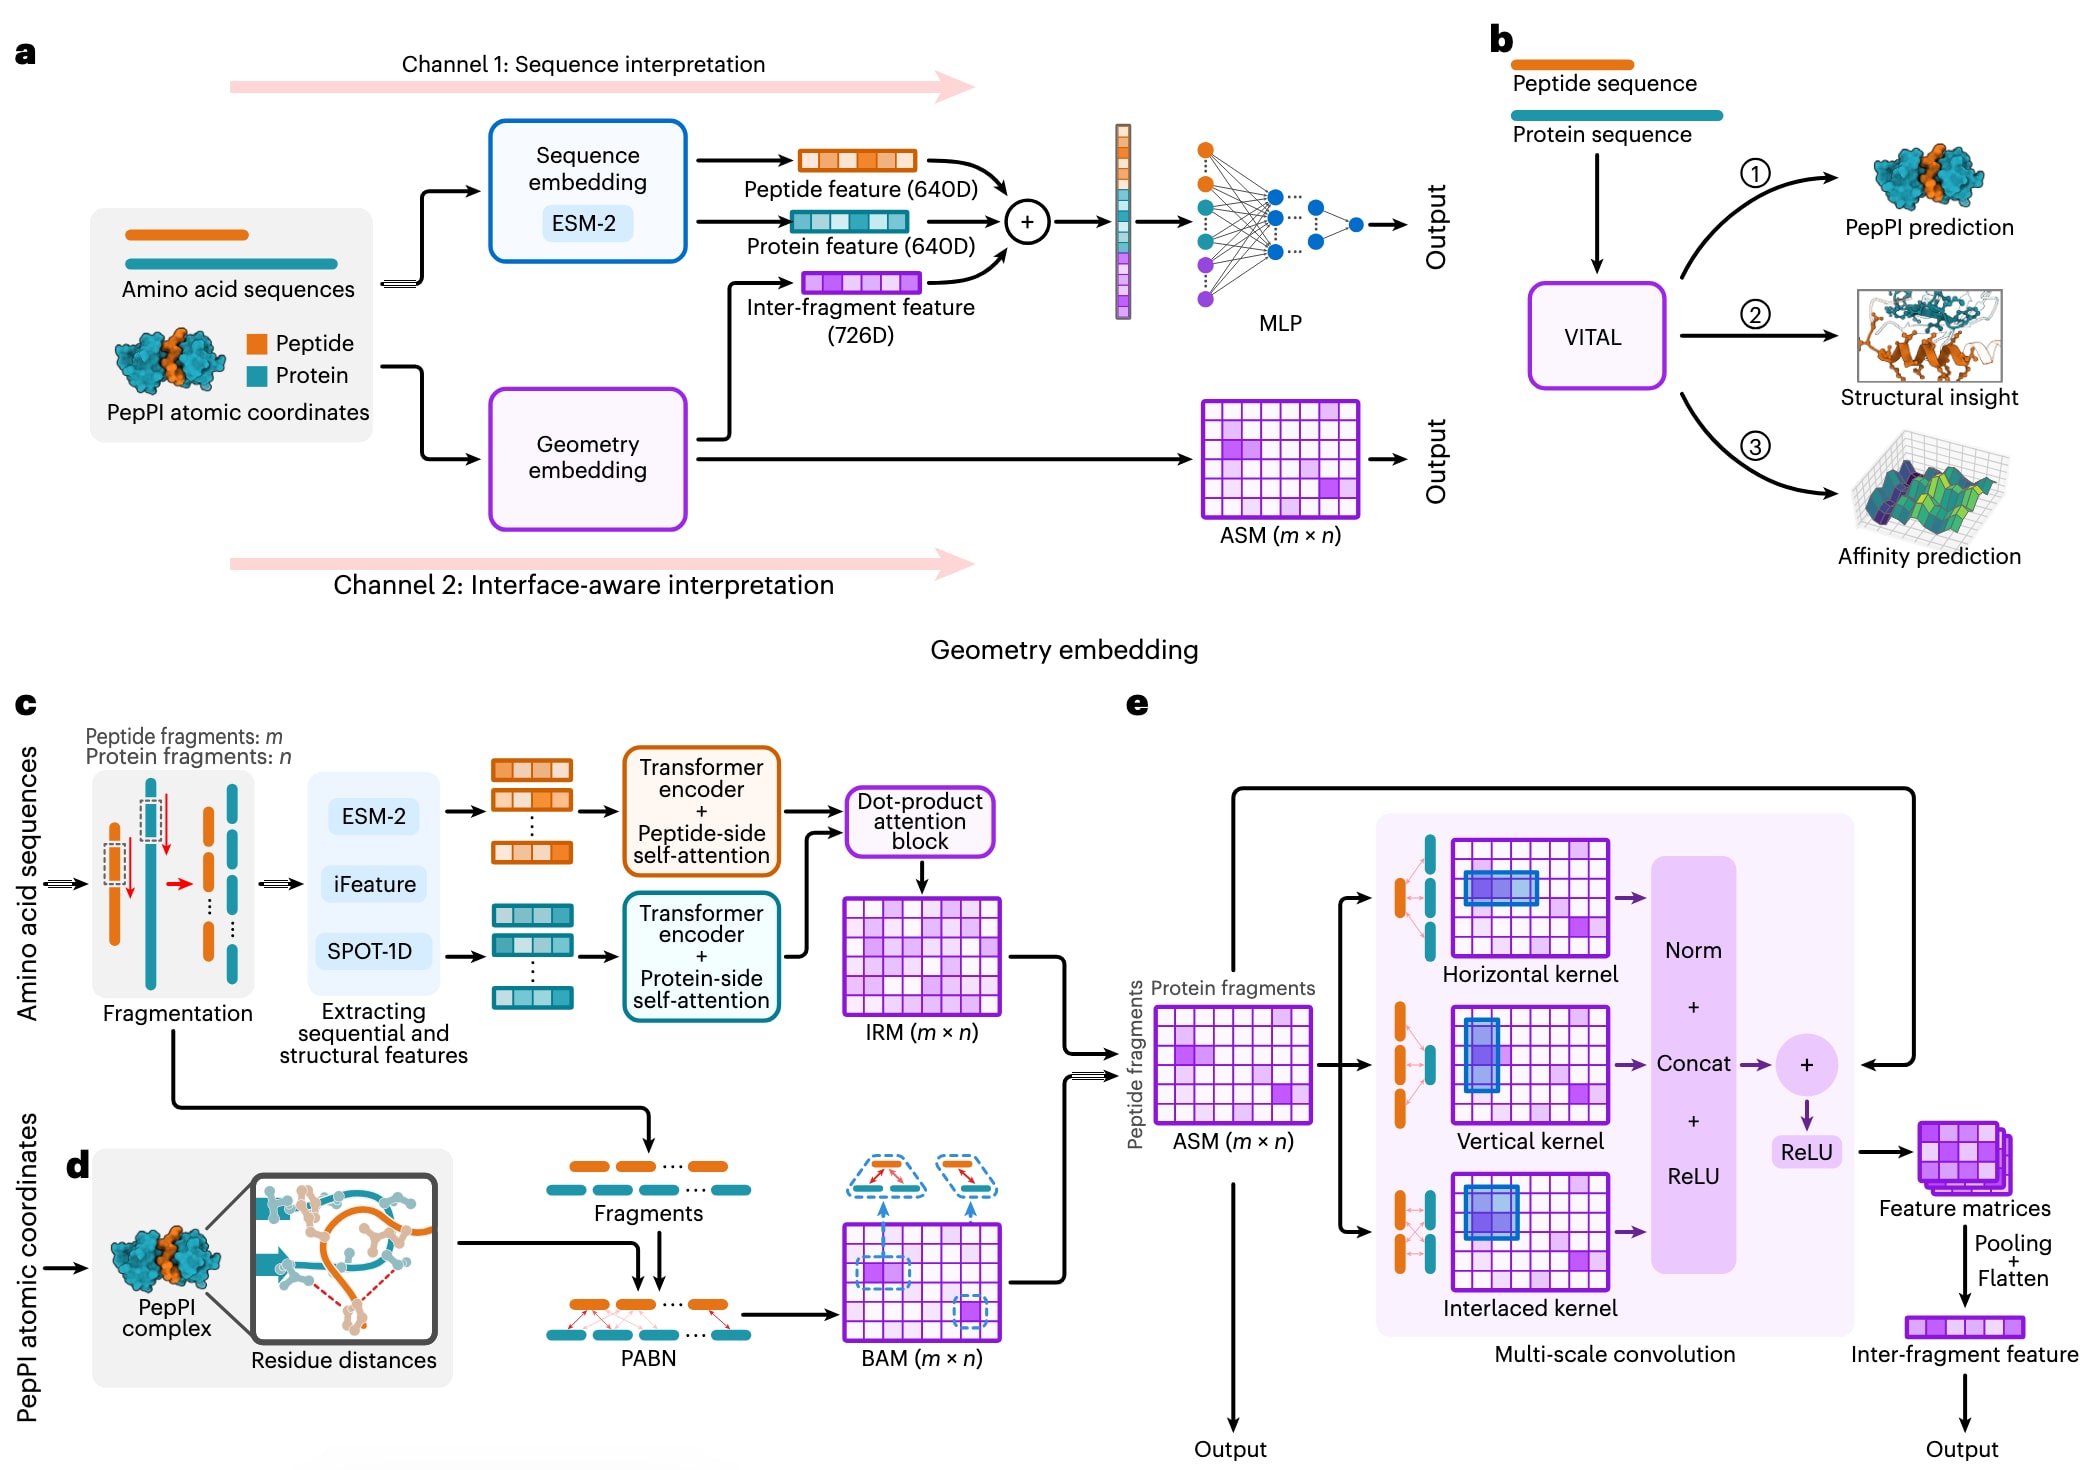
图1|用于肽–蛋白相互作用定量预测的 VITAL 框架。 a,VITAL 架构示意图。模型通过双输入通道处理多肽和蛋白质序列。上:利用 ESM-2(esm2_t30_150M_UR50D)生成序列嵌入,分别得到多肽和蛋白质的 640 维(640D)特征向量;下:通过几何嵌入模块(c–e)对肽–蛋白复合物的结构信息进行编码,生成片段间特征向量和亲和力强度矩阵(ASM)。三个特征向量拼接后输入多层感知机(MLP),用于预测相互作用概率;同时,ASM 可提供残基水平的空间相互作用表征。b,VITAL 的多任务预测能力。仅以多肽和蛋白质序列作为输入,VITAL 即可同时完成相互作用预测、结合位点定位和亲和力估计。c,片段间检测模块(inter-fragment inspector)。采用滑动窗口对多肽和蛋白质序列进行分段,窗口大小为 10,步长为 5。利用 ESM-2、iFeature 和 SPOT-1D(SPOT-1D-Single)对片段特征进行编码,随后经 Transformer 编码器和自注意力机制处理,并通过点积相似度生成片段间关系矩阵(IRM)。d,亲和力监督模块(affinity supervisor)。该模块计算肽–蛋白复合物中的原子间距离,并基于序列片段构建二部亲和力网络。边权重定义为
2.2.2 向蛋白质–蛋白质相互作用预测的迁移能力
为评估 VITAL 在肽–蛋白相互作用(PepPI)之外的泛化能力,该研究将其与基于蛋白质语言模型(protein language model,PLM)的 PLM-interact 进行比较。PLM-interact 是一种当前先进的、基于序列的蛋白质–蛋白质相互作用(protein–protein interaction,PPI)预测方法。比较使用两个 PPI 测试集:VITAL_PPI_test,包含 1,600 个平衡的 PPI 样本,这些样本采用与 PepPI 基准数据集相同的严格标准从 PDB 中筛选获得;以及 PLM-interact_test,直接来源于 PLM-interact 基准数据集,包含来自多个物种的 53,588 个样本。
当 VITAL 仅使用 PepPI 数据进行训练时,其在 PPI 预测任务上的表现接近随机水平:在 VITAL_PPI_test 和 PLM-interact_test 上的 AUC 分别仅为 61.54% 和 60.65%(补充表 4)。这一结果表明,原始 VITAL 模型具有明显的领域特异性,也与 PLM-interact 在 PepPI 测试集上表现有限的现象一致(图 2b)。
在此基础上,该研究进一步构建了两个增强版本——VITAL-3000PPIs 和 VITAL-5000PPIs。两者分别在原始 PepPI 训练集中加入 6,000 和 10,000 个平衡的 PPI 样本,同时保持模型架构不变。在 VITAL_PPI_test 上,这两个增强版本的性能均得到显著提升(图 2c 和补充表 4),AUC 分别达到 97.29% 和 97.71%,相比原始 VITAL 提高超过 35 个百分点,并明显优于专门用于 PPI 预测的 PLM-interact(AUC = 87.04%)。
然而,在独立的 PLM-interact_test 数据集上,这种性能提升较为有限,两种增强版本的 AUC 仍显著低于 PLM-interact 的 96.31%。这一明显的性能差距表明,在当前的数据增强策略下,模型仍然存在较强的领域专门化障碍。
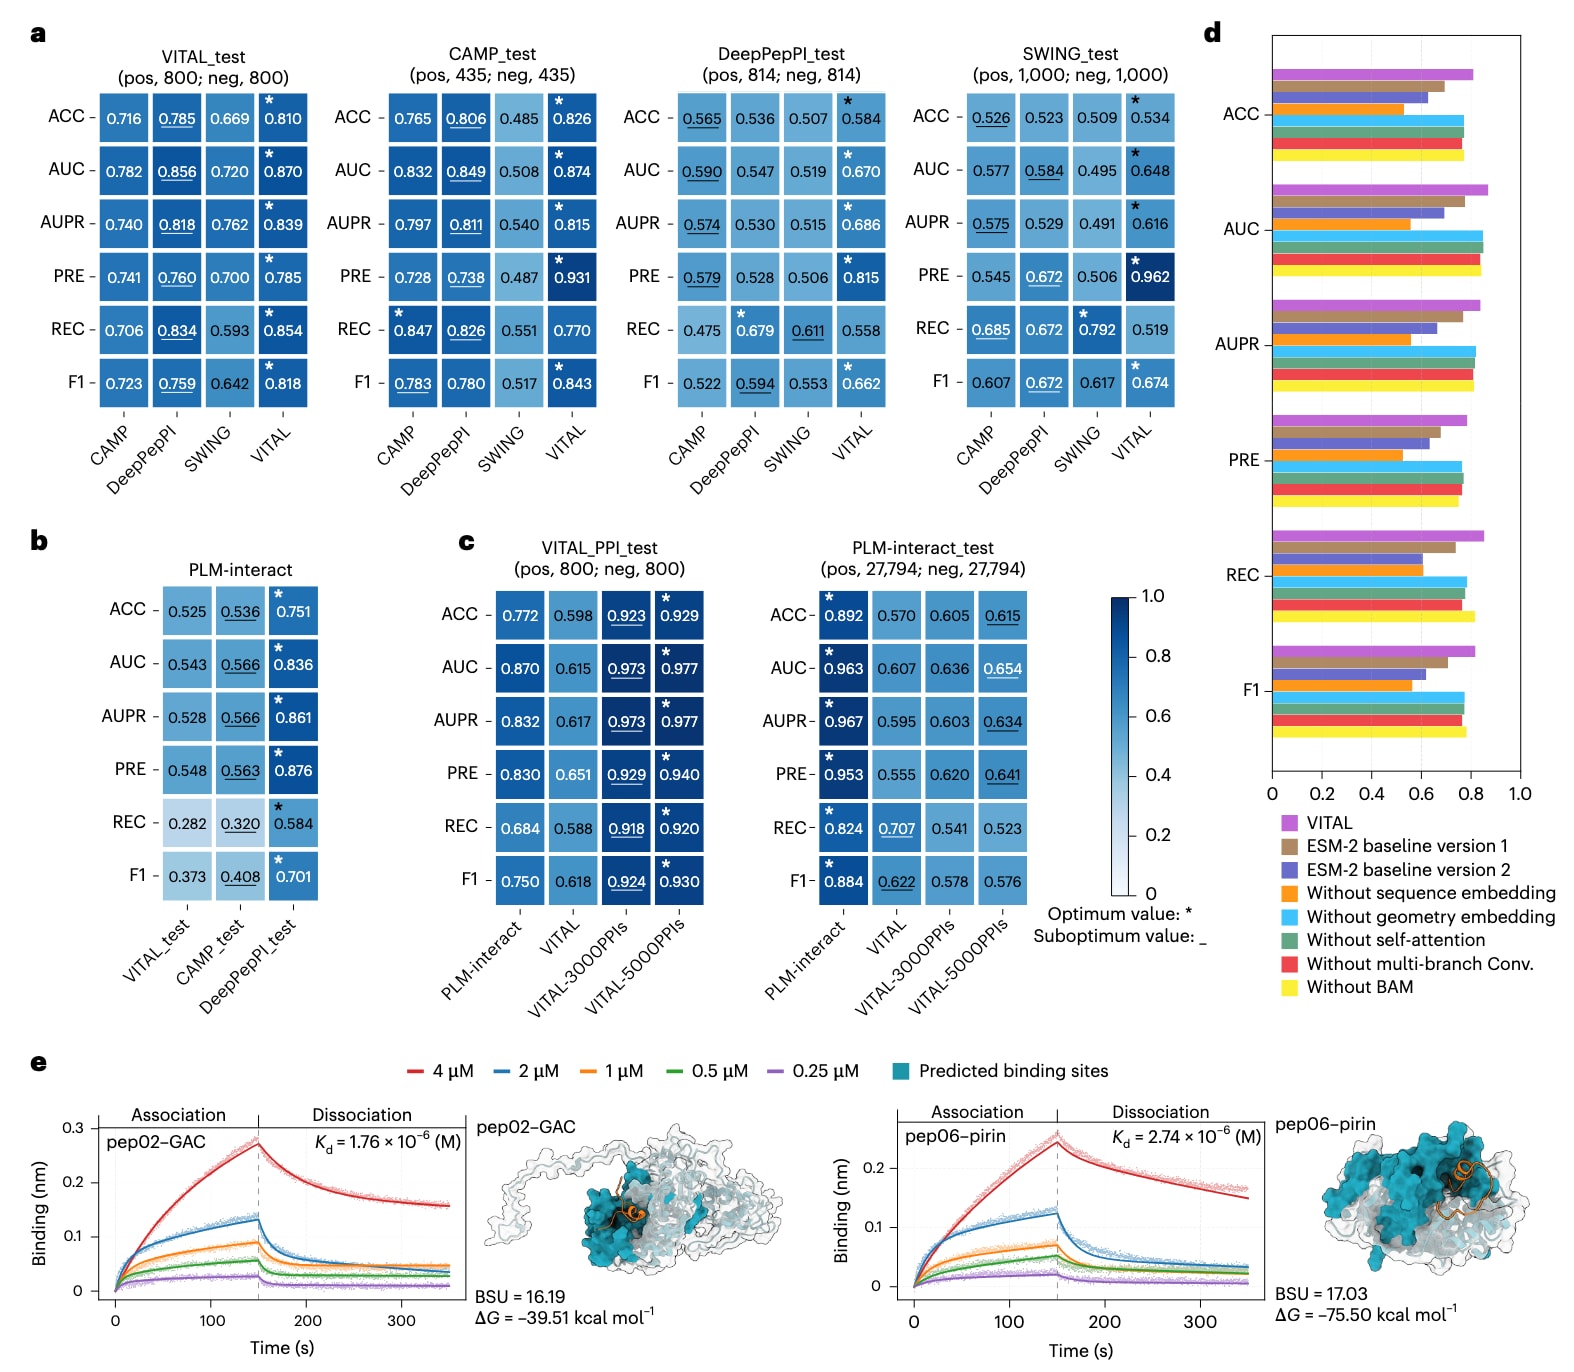
图2|VITAL 框架的基准测试与验证。 a,VITAL 与三种当前先进的 PepPI 预测模型 CAMP、DeepPepPI 和 SWING 在四个独立测试集上的性能比较,包括 VITAL_test(
2.2.3 关键模型决定因素的消融实验
为系统识别影响模型性能的关键因素,该研究开展了一系列全面的逐组件消融实验。结果显示,不同特征对 VITAL 性能的贡献存在明显层级差异:由 ESM-2 获得的序列嵌入贡献了模型的大部分预测能力,使准确率(ACC)提高 28.00%,AUC 提高 31.25%(图 2d 和补充表 5)。这一结果也解释了为什么 CAMP、SWING 和 DeepPepPI 等现有基于序列的方法即使不引入结构信息,仍能获得具有竞争力的预测性能。
相比之下,几何嵌入带来的提升相对有限但较为稳定,使 ACC 提高 3.81%,AUC 提高 2.13%。这表明,尽管结构约束能够提供有价值的正则化作用,但相较于基于序列的表征,其贡献仍处于次要地位。在几何信息处理模块内部,多尺度卷积在捕捉局部片段相互作用方面略优于自注意力机制和二部邻接矩阵(BAM)。
除逐组件消融实验外,该研究还构建了两个 ESM-2 基线模型,以进一步量化几何嵌入模块的贡献(扩展数据图 1)。其中,baseline v1 将多肽和蛋白质序列各自的 ESM-2 嵌入进行拼接;baseline v2 则先拼接多肽和蛋白质的原始序列,再进行 ESM-2 嵌入。两个基线模型均仅依赖序列嵌入,但仍取得了较有竞争力的预测性能,进一步验证了预训练蛋白质语言模型的有效性。
然而,在此基础上加入几何嵌入模块后,即构成 VITAL 与上述基线模型之间的核心差异,所有评价指标均得到明显提升。例如,AUC 提高 9.4%,F1 分数提高 11.1%。这些结果表明,显式引入几何信息能够捕捉仅依赖序列表征难以获得的空间相互作用模式。
2.2.4 VITAL 预测 PepPI 的实验验证
为展示 VITAL 在从头多肽发现中的应用价值,该研究从内部蛋白表达库中选择了 3 个靶蛋白——谷氨酰胺酶 C(glutaminase C,GAC)、pirin 和 c-Src,并利用内部多肽库进行计算筛选,对所有可能的蛋白–多肽组合预测相互作用概率和亲和力。以预测概率
生物层干涉(biolayer interferometry,BLI)实验确认了 9 对预测阳性相互作用中的 4 对,分别为 pep02–GAC、pep06–pirin、pep08–c-Src 和 pep09–c-Src。例如,pep02–GAC 和 pep06–pirin 的平衡解离常数
2.3肽–蛋白结合位点的结构解析
2.3.1 基于 VITAL-DeSite 的残基水平界面定位
VITAL 的核心输出 ASM 能够编码每一对多肽–蛋白质片段之间接近残基分辨率的相互作用潜力(图 3a)。为将 ASM 转化为空间分辨的结合位点,该研究开发了 VITAL-DeSite,一种受地形分析启发的算法,通过连续三个步骤划定相互作用区域(图 3b、c)。该方法可直接从序列出发,为肽–蛋白界面定位提供一种定量化、结构信息驱动的计算方案。
为评估其准确性,该研究将 VITAL-DeSite 应用于 VITAL_benchmark 中 6,309 个具有实验解析结构的 PepPI。以 PDB 实验结构作为真实标准,并将原子距离
除恢复已知结合界面外,VITAL-DeSite 还识别出了一些此前未注释的次级相互作用位点,提示其可能与潜在的变构调控机制有关。一个代表性案例是组蛋白结合蛋白 RBBP4(UniProtKB AC Q09028)。该蛋白可与两条序列差异较大的多肽结合,两条多肽的序列一致性约为 25%,并分别占据 PDB 结构 6BW3 和 6ZRC 中不同的结合位点。针对这两条多肽,VITAL 在 RBBP4 上预测出的前三个潜在结合位点几乎相同,但分别选择了不同的主结合位点,而且均与相应 PDB 结构定义的真实界面准确吻合(图 3d、e)。
进一步将分析扩展至完整的 VITAL_benchmark(
2.4 基于结合强度单位的定量亲和力表征
尽管瞬时 PepPI 也能够调节细胞信号,但持续的生理或治疗效应通常需要形成稳定复合物,而其效力很大程度上取决于相互作用强度。该定量性质在现有工具中往往未得到充分考虑。为此,该研究提出结合强度单位(binding strength unit,BSU),一种由 ASM 推导得到的指标,可在 VITAL-DeSite 确定结合位点后,对位点特异性的结合亲和力进行量化(图 4a)。
该研究首先对 VITAL_benchmark 中全部 9,701 个具有实验结构的 PepPI 计算 BSU,其数值呈连续分布,范围为 11–27,中位数为 21.17(图 4b)。为利用生物物理和实验数据验证 BSU,从中筛选得到一个包含 3,323 个复合物的高质量子集,排除了多链体系、辅因子、非标准残基以及无法完成能量计算的样本。经过能量最小化后,采用 gmx_MMPBSA v1.4.3 计算结合自由能
此外,利用 PDBbind 中 117 个实验半数抑制浓度(
[ \mathrm{pIC}{50}=-\log(\mathrm{IC}_{50}) ]
结果同样显示 BSU 与实验
作为对照,该研究还将 VITAL 与基于蛋白质对语言模型(protein pair language model,PPLM)的 PPLM-Affinity 进行比较。PPLM-Affinity 是一种使用蛋白质–蛋白质复合物训练、用于预测
进一步针对多位点结合体系,该研究分析了 6,199 个具有完整坐标的 PepPI 中所有可检测相互作用位点的亲和力。在其中结合位点数量少于 6 个的 4,007 个复合物中,包括 531 个单一位点体系,分别计算平均 BSU 以及相对于实验界面的空间覆盖率,实验界面仍采用
结果显示,单一位点与多位点复合物的 BSU 数值总体相近,但二者的界面组织方式存在明显差异(图 4e 和补充表 8、9)。单一位点 PepPI 通常具有较高且更加紧凑的界面覆盖率;而在多位点复合物中,随着结合位点数量增加,单个位点的界面覆盖率呈下降趋势,同时片段间距离逐渐增大。晶体结构则主要捕获亲和力最高的结合位点,这与结晶条件下热力学选择作用相一致。
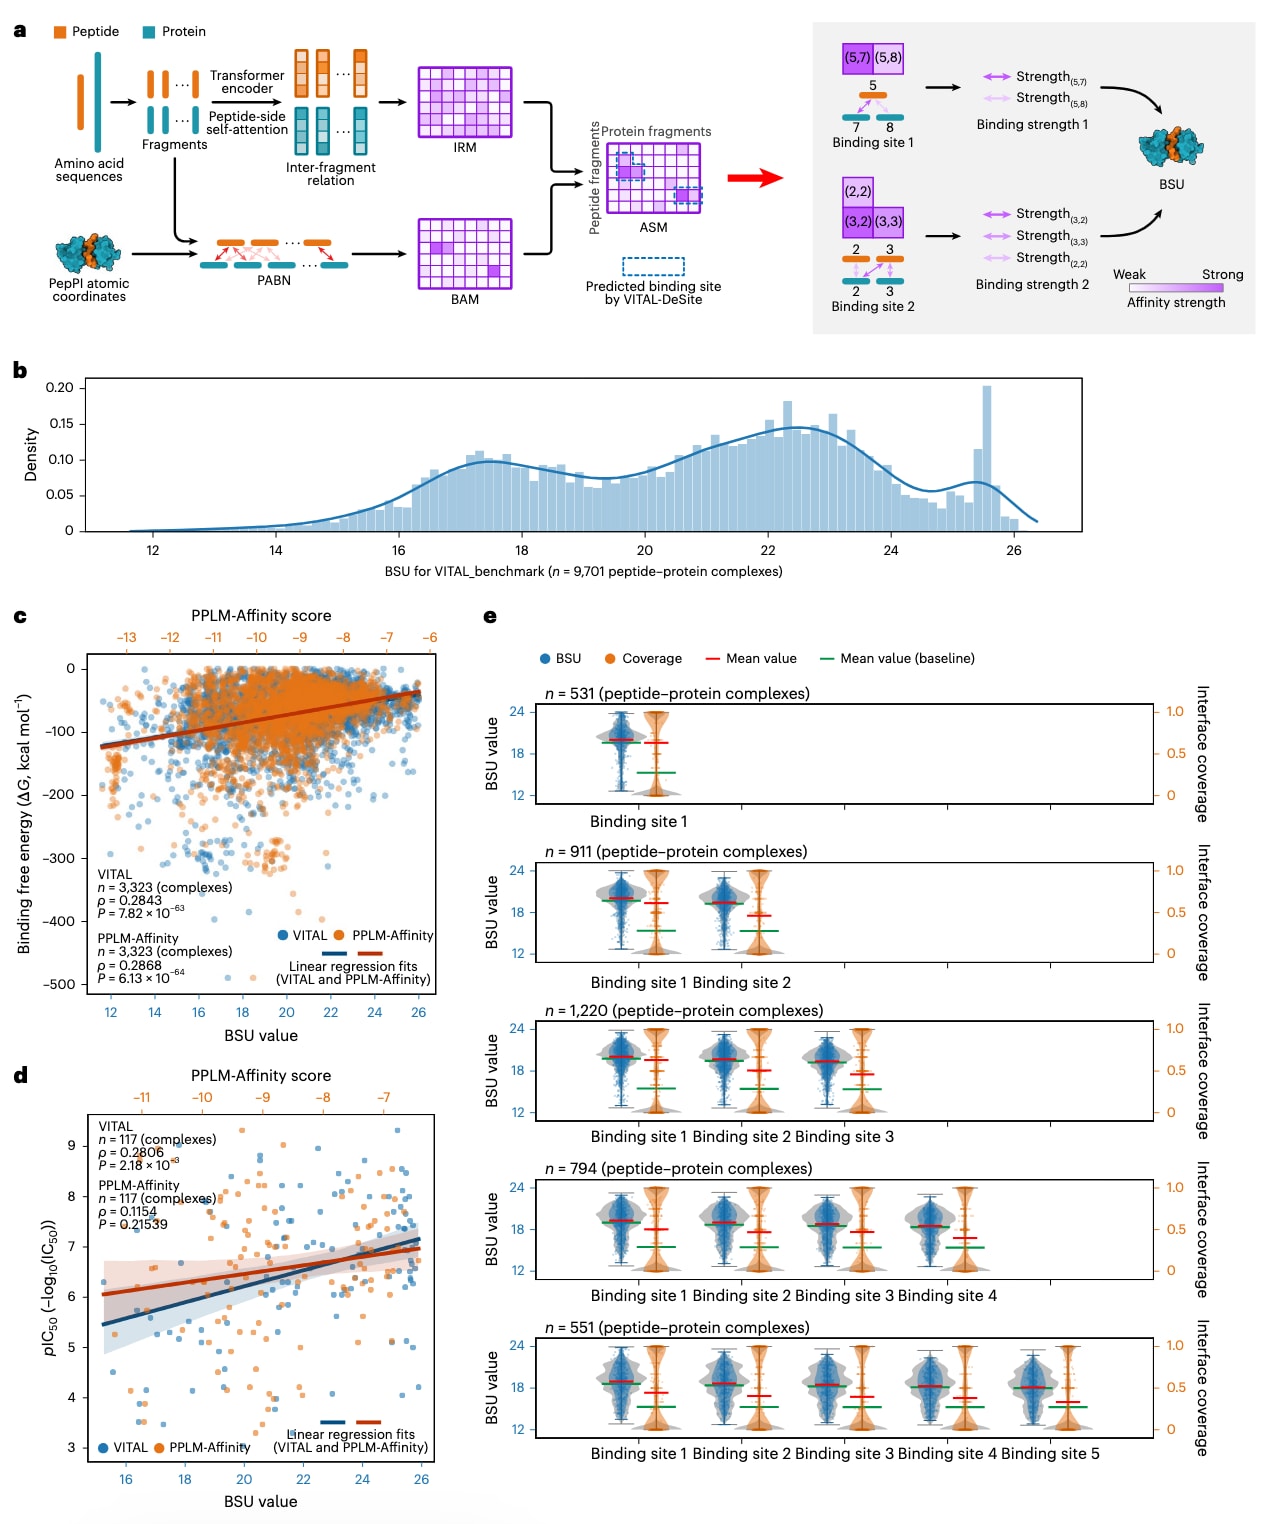
图4|基于亲和力强度映射的 PepPI 定量表征。 a,从亲和力强度矩阵(ASM)出发,利用 VITAL-DeSite 识别结合位点,并根据各结合位点内整合的 ASM 信号计算结合强度单位(BSU)的流程。b,VITAL_benchmark 数据集中 BSU 分数的概率密度分布,共包含 9,701 个 PepPI 复合物。c,VITAL_benchmark 中经过筛选的 3,323 个复合物的 BSU 与计算结合自由能
2.5 通过全蛋白质组靶点发现进行转化验证与治疗拓展
该研究利用 DrugBank 和 Drugs@FDA 中 64 种经美国食品药品监督管理局(FDA)批准的线性多肽药物(<50 个氨基酸)评估 VITAL 的转化应用潜力,其中包括 30 种天然多肽和 34 种修饰多肽。这些药物对应 106 对已知 PepPI,涉及 62 个靶点和 55 条多肽;另有 9 条多肽此前缺乏已注释靶点(补充表 10)。当 VITAL 用于筛选人类蛋白质组时,以 50% 的预测概率为阈值,可成功恢复 84.90%(90/106)的已知多肽–靶点对(图 5a)。
进一步对同一蛋白质组筛选结果采用更严格的阈值,即预测概率 >95%、BSU >23,共得到 5,974 对预测 PepPI。对于此前无已知靶点注释的 9 条多肽,VITAL 共预测出 125 个候选相互作用。例如,alsactide 被预测可靶向 UBE2A 和 YPEL5,这两个蛋白分别与 X 连锁综合征型智力发育障碍 Nascimento 型以及慢性淋巴细胞白血病相关(图 5b)。
为进一步从生物学和临床角度解析这些预测结果,该研究利用 Gephi v0.10.1 和 Cytoscape v3.10.4,将 VITAL 识别的 PepPI 与药理学知识图谱 PharmKG 整合,构建异质网络,并系统关联相互作用与疾病适应证(图 5c)。该网络能够重现已知关系,例如兰瑞肽–SSTR2–神经内分泌肿瘤之间的联系(图 5d);同时还揭示了一些潜在关联。例如,兰瑞肽被预测可结合 PTRH1,而 PTRH1 同样与神经内分泌肿瘤相关;此外,还通过 TFPI2 和 WWOX 与多种肿瘤类型建立潜在联系,提示可能存在药物再利用机会。
最后,VITAL 还用于系统识别奥曲肽的脱靶相互作用。在预测概率 >95%、BSU >23 的条件下,共预测出 125 个潜在人源脱靶蛋白。进一步与 ADReCS-Target 数据库进行交叉比对发现,部分预测脱靶蛋白,例如 CYP3A4、TRPM4、CYP2D6 和 PON1,与房室传导阻滞、胆石症和甲状腺功能异常等已记录不良反应存在关联,表明 VITAL 具有用于前瞻性药物安全性分析的潜力(图 5e)。
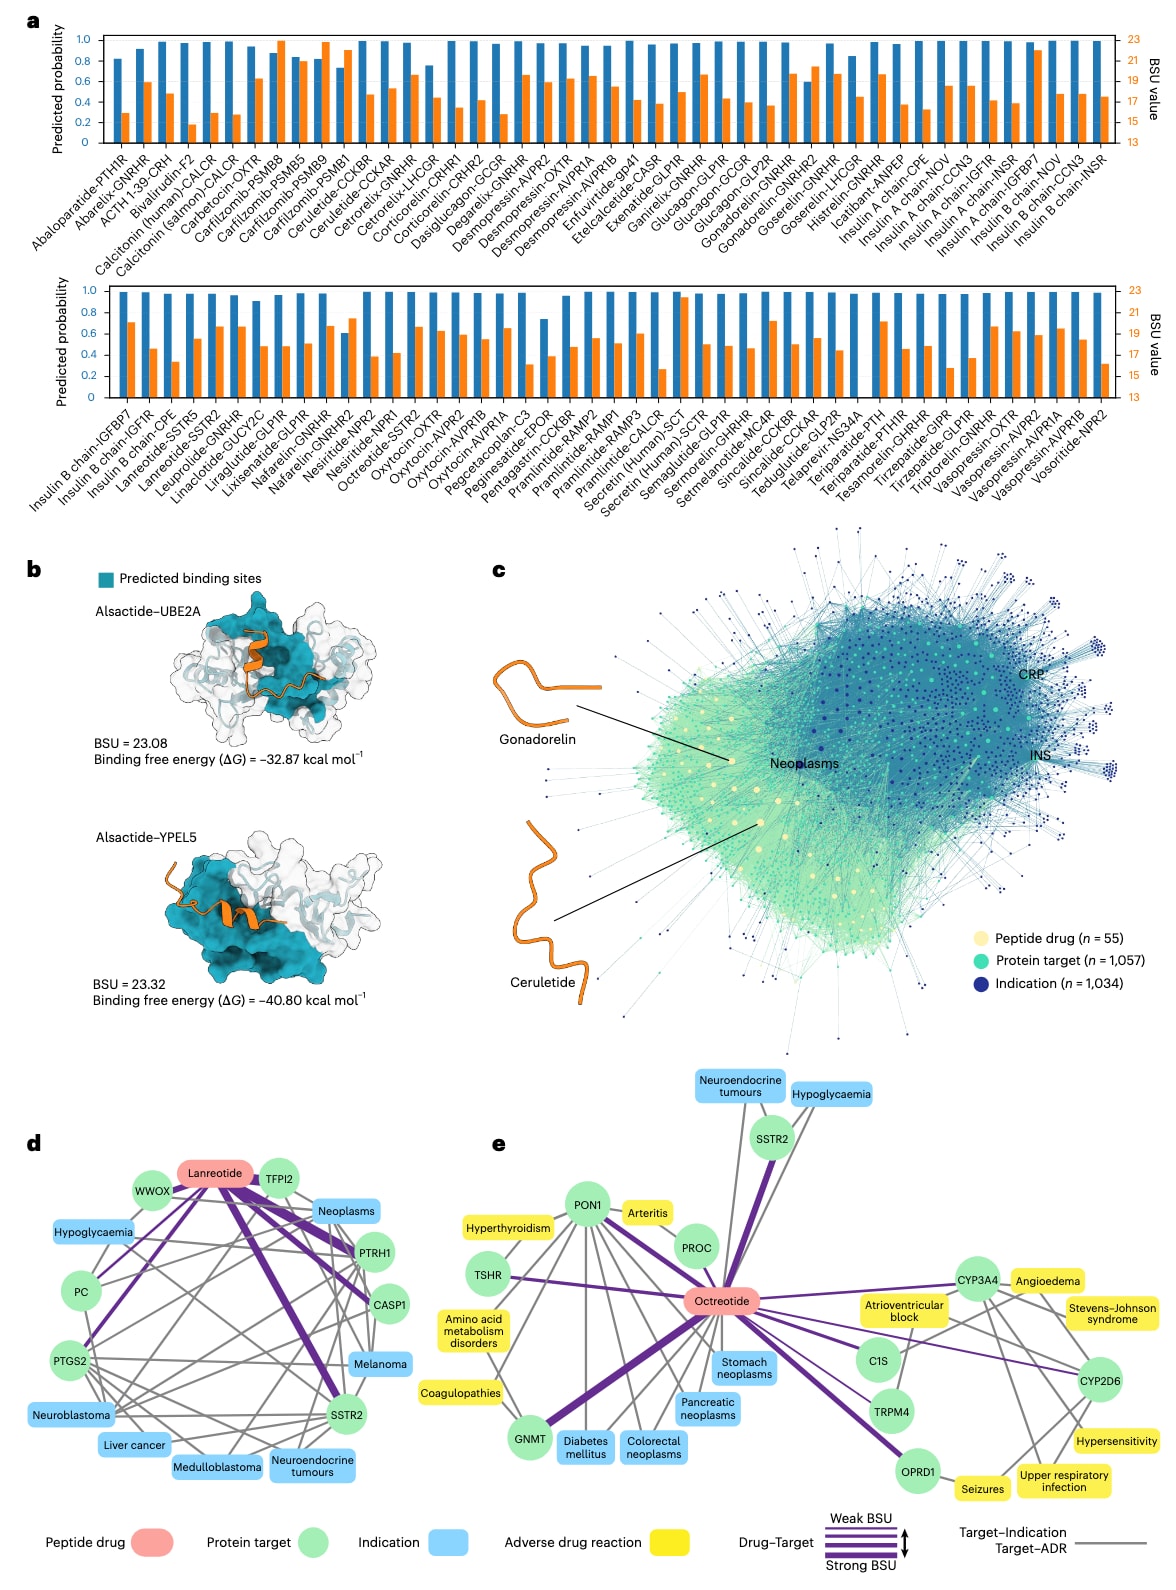
图5|VITAL 在多肽药物发现与安全性评估中的转化应用。 a,对最初 106 对已知 PepPI 中 VITAL 预测概率 >50% 的 90 对相互作用进行分析,这些相互作用均涉及 FDA 批准的多肽药物,并展示 VITAL 预测的相互作用概率和 BSU 值。b,对靶点未知的多肽药物 alsactide 进行全蛋白质组靶点筛选,结果提示 UBE2A 和 YPEL5 可能是其潜在结合蛋白。预测复合物结构由 HADDOCK 生成。c,将高置信度 PepPI 与临床注释信息整合构建药理学网络。该异质网络包含 55 种多肽药物、VITAL 预测的 1,057 个蛋白质靶点以及来自 PharmKG 的 1,034 个疾病适应证,并使用 Gephi 构建。d,从全局药理学网络中提取的兰瑞肽特异性子网络,展示其已知靶点 SSTR2 及相关适应证,并使用 Cytoscape 可视化。e,通过脱靶预测开展前瞻性安全性评估。利用 VITAL 识别奥曲肽的潜在脱靶蛋白,并通过 ADReCS-Target 数据库将这些脱靶蛋白与药物不良反应关联,进一步使用 Cytoscape 构建蛋白质–药物不良反应关联网络。
2.6 框架边界与未来发展方向
尽管 VITAL 在多个方面取得进展,但仍存在若干限制,并为后续研究提供了明确方向。
首先,VITAL 基于单链蛋白质结构进行训练,因此可能无法直接泛化至多亚基复合物。对于这类体系,目前需要先对各亚基进行拆分后再进行预测,这可能影响预测准确性。未来可开发统一的嵌入策略,使简单蛋白质与复杂多亚基蛋白质能够在同一框架下进行表征。
其次,为保证基于距离的标注具有较高可靠性,该研究将基准数据集限制在分辨率
第三,为提高计算效率,ASM 的最大尺寸被限制为 100 个片段,即最多约 505 个氨基酸,因此对于较长序列有时需要截断。扩大 ASM 尺寸可提高界面覆盖率,但同时会增加计算开销和矩阵稀疏性。未来硬件性能提升可能有助于缓解这一权衡。
第四,负训练样本由随机采样的非相互作用多肽–蛋白质对构成,仍可能存在残余偏差。未来引入更加严格且经过实验验证的阴性数据集,有望进一步提升模型鲁棒性。
第五,VITAL 在某些高度特化的蛋白质家族或较为小众的 PepPI 亚群上可能表现下降。针对特定领域数据进行重新训练,或进一步改进模型架构以处理不同类型相互作用的异质性,可能是有效的解决途径。
第六,VITAL 对单残基替换的敏感性仍然有限。通过多尺度学习、引入突变增强训练数据,或利用变异效应数据集进行微调,可进一步提高模型对残基水平变化的敏感性,从而增强其预测单核苷酸多态性功能影响及支持转化应用的能力。
最后,基于 ASM 的结合位点预测和亲和力估计仍有进一步优化空间。例如,可将彼此相邻但被算法划分为多个片段的结合位点合并为功能上连续的相互作用区域,从而提高预测准确性,并为后续实验研究提供更可靠的结构基础。
3 讨论
PepPI 的计算预测长期受到一个关键问题限制,即难以同时对结合界面和结合亲和力进行定量解析,而这两项性质对于理解生物学机制和指导治疗分子设计均至关重要。为解决这一问题,该研究开发了 VITAL,通过双通道架构协同学习全局序列上下文和局部结构表征。除取得较高预测准确性和泛化能力外,VITAL 还可借助具有可解释性的 ASM 以及残基水平界面预测,为多肽–蛋白质结合提供结构信息驱动的解析。
VITAL 的一个重要进展在于能够系统解析肽–蛋白结合界面,从而弥补结构多肽生物学中长期存在的不足。多肽具有显著的构象可塑性,占据独特的化学空间,因此能够形成多样且经常呈瞬时性的结合机制,难以通过简单分类加以描述。传统方法通常仅将 PepPI 粗略划分为表面互补型或“锁钥”型,而 VITAL 则通过片段水平的界面分析建立了定量化的结合模式分类体系。
具体而言,该研究提出两个新的定量描述符——埋藏程度(burial degree,Bdeg)和插入程度(insertion degree,Ideg)(图 6a),并将其应用于 PDB 中 9,618 个具有实验解析结构的 PepPI,排除了长度
Bootstrap 重采样结果表明,VITAL 在不同结合几何模式下均保持稳定的预测性能,不依赖于特定结合模式(补充表 11 和 12)。这些不同的结合几何特征可能对应不同的功能后果,例如信号持续时间或变构调控方式。因此,VITAL 的结构分类超越了传统的二元划分方式,在结合几何特征与多肽功能之间建立了更直接的联系,从而为结构指导的理性设计和假设驱动的多肽发现提供支持。
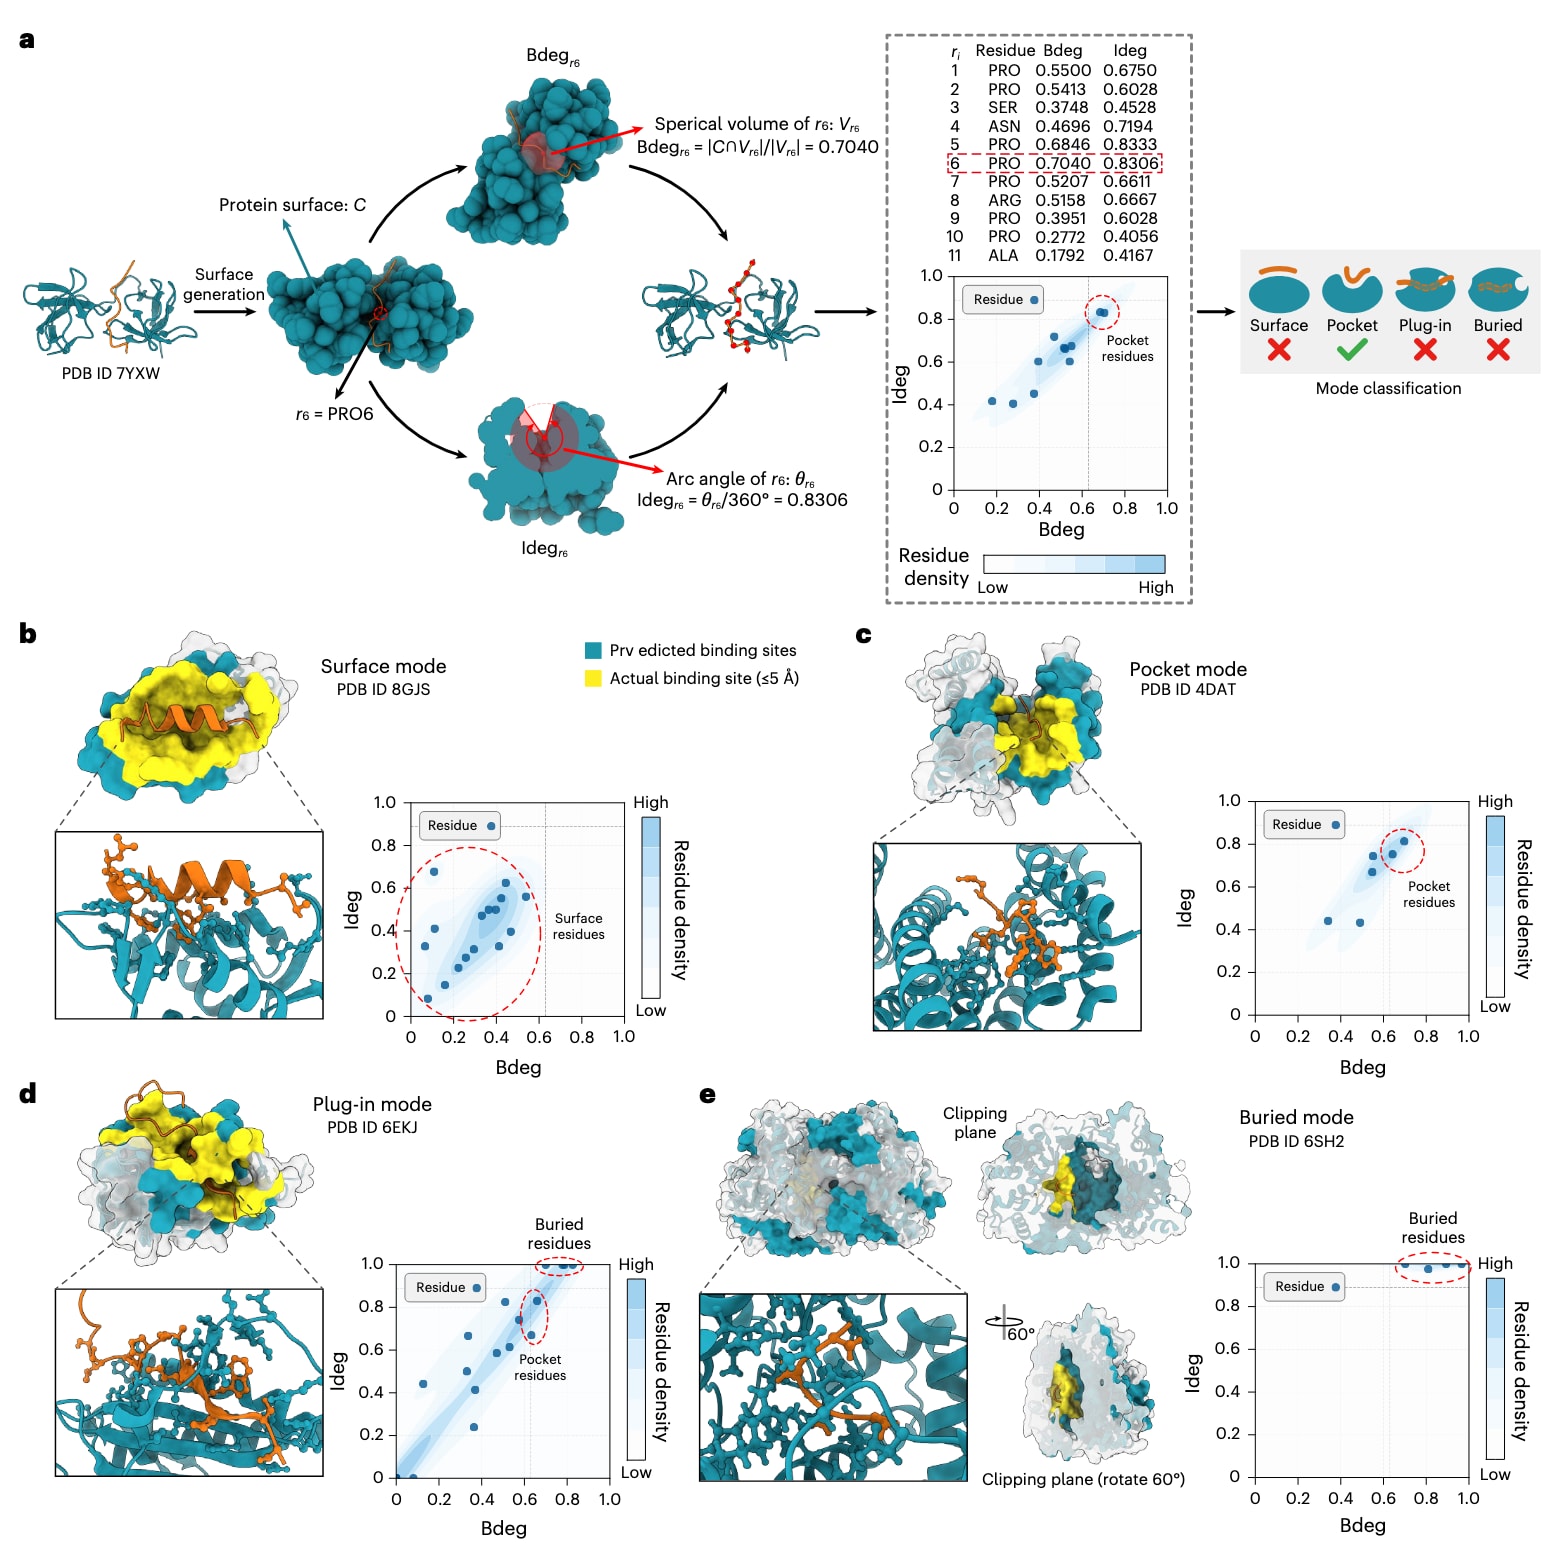
图6|利用定量几何描述符解析肽–蛋白结合模式。 a,以 PDB 结构 7YXW 为例展示结合模式分类流程。根据原子坐标计算每个残基的埋藏程度(Bdeg)和插入程度(Ideg),并在叠加残基密度图的散点图中展示其数值及分布;b–e 采用相同的可视化方式。基于 Bdeg 和 Ideg 可判定残基类型及整体结合模式,该示例对应口袋型结合。b,表面型(surface mode,以 PDB 8GJS 为例)。所有多肽残基均保持溶剂可及状态,未被蛋白质包裹,
更广泛而言,VITAL 推动 PepPI 分析由定性分类转向定量表征。相比现有方法通常仅提供二元预测结果,VITAL 引入了结合强度单位(BSU)这一连续型指标,可依据结合亲和力对不同相互作用进行优先级排序,使 PepPI 研究从判断多肽“是否结合”进一步发展到评估其“结合有多强”,从而提高了相关分析的定量化程度和严谨性。
该框架还具有重要的转化应用价值。通过构建具有功能权重的 PepPI 分子网络,VITAL 可对缺乏注释的多肽开展全蛋白质组范围的靶点识别与功能背景解析,而这是传统二元分类模型难以实现的。进一步结合药理学知识图谱,该网络能够将多肽–靶点相互作用与新的疾病适应证、药物再利用机会及安全性特征关联起来,从而提出传统筛选方法难以获得的潜在治疗假设。
4 结论
综上,VITAL 推动 PepPI 研究由定性预测转向定量化、结构信息驱动的评估模式,可支持高通量从头多肽设计、精准效力评估以及理性优化。通过连接计算预测与结构验证,该研究进一步凸显了多肽药物作为下一代治疗策略的重要发展潜力。