NC 2025 | TAIP:面向域外数据原子间势泛化性能提升的在线测试时自适应方法
今天介绍的是发表在 Nature Communications 上的一项研究工作。该研究提出了 TAIP,即面向机器学习原子间势的在线测试时自适应框架,用来缓解训练数据和实际分子动力学模拟中测试数据之间的分布偏移问题。设计了结合全局结构信息和局部原子环境信息的自监督学习任务,包括噪声强度预测、原子特征恢复和伪力恢复,使模型在训练时学习更稳健的结构表征,并在推理阶段针对每个测试样本进行一次轻量更新,从而让原子间势更适应当前输入结构。实验覆盖 MD17、ISO17、水体系和电解质溶液等数据集,结果显示 TAIP 在不引入额外数据的情况下平均降低约 30% 的能量和力预测误差,并能在基线模型发生模拟崩溃的场景中维持稳定的分子动力学模拟。总体来看,这项工作把测试时自适应引入 MLIP,为提升外推场景下的预测精度和模拟可靠性提供了一种实用思路。
获取详情及资源:
0 摘要
机器学习原子势(MLIPs)能够以接近第一性原理计算精度的水平实现更高效的分子动力学(MD)模拟,已被广泛应用于多个物理科学领域。然而,训练数据与测试数据之间的分布偏移会导致MLIPs在测试数据上的性能下降,甚至可能导致分子动力学模拟崩溃。针对这一问题,提出了一种在线测试时适应原子势(TAIP)框架,用于提升模型在测试数据上的泛化能力。具体而言,设计了一种双层自监督学习方法,通过利用整体结构信息和原子局部环境信息,使模型能够与测试数据分布进行对齐。大量实验结果表明,TAIP能够在无需额外数据的情况下,有效缩小训练数据集与测试数据集之间的领域差距。TAIP在多种基准测试中均提升了测试性能,涵盖从小分子数据集到包含多种元素的复杂周期性分子体系。此外,TAIP还能够实现稳定的分子动力学模拟,而对应的基线模型在相同条件下会出现模拟崩溃。
1 引言
分子动力学(MD)模拟作为一种关键技术,广泛应用于生物学、化学以及材料科学等多个领域。MD模拟通常基于原子间势函数进行,该函数用于描述体系的势能面,并通过计算势能的负梯度获得原子受力。随后,利用牛顿运动定律对原子的动态轨迹进行模拟。在从头算分子动力学模拟中,体系的能量和力通过求解量子力学方程得到精确计算。然而,从头算MD模拟较高的计算成本限制了其在许多实际场景中的应用。通过学习从头算计算结果,开发出了机器学习原子势(MLIPs),能够在保持接近第一性原理计算精度的同时,实现更加高效的分子动力学模拟。
尽管MLIPs已经取得了显著成果,但其实际应用中的关键挑战在于训练数据与测试数据之间存在分布偏移。在利用MLIPs进行分子动力学模拟时,推理阶段所使用的数据是基于模型预测力在模拟过程中持续生成的原子结构,因此训练集需要覆盖广泛的原子结构空间,以保证预测结果的准确性。然而,在相变、催化以及晶体生长等领域,需要探索的构型空间高度复杂。这种复杂性使得采集足够的数据用于模型训练变得困难,同时也容易导致所构建的势函数不够平滑,无法对所有相关结构进行可靠外推。因此,训练数据集与测试数据集之间经常出现分布偏移,进而导致测试性能下降,并产生不符合物理规律的原子结构,最终使MD模拟发生崩溃。尽管主动学习和预训练等策略已经被提出用于缓解这一问题,但这些方法仍然难以探索未知原子结构,并且不可避免地会消耗更多计算资源。因此,亟需一种无需探索额外原子结构即可解决分布偏移问题的方法。
测试时适应作为一种具有潜力的解决方案,通过在测试阶段对模型进行微调来解决分布偏移问题。不同于上述方法,测试时适应无需探索额外的原子结构或引入额外训练数据,而是在仅增加少量计算开销的情况下,根据测试数据的特征对模型进行动态调整。测试时适应已被证明在图像分类、语义分割以及目标检测等多个领域中具有良好的效果。然而,其在原子间势预测任务中的应用仍未被探索。为了在MLIP中成功实现测试时适应,需要设计针对任务特点的专门策略,以充分考虑原子结构数据的特殊性质。针对MLIP特点设计的有效测试时适应方法,有望提升MLIP的预测精度,同时增强由MLIPs驱动的分子动力学模拟的稳定性与可靠性。
用于原子间势的在线测试时适应策略(TAIP)被提出,旨在减轻分布偏移对MLIP应用造成的影响。设计了一种双层自监督学习方案,通过编码器提取全局结构信息和局部结构信息。在训练阶段,编码器通过MLIP任务与自监督学习任务的联合损失函数进行优化。在推理阶段,编码器针对每个测试样本,通过最小化自监督学习损失进行一次更新,随后生成最终的能量和力预测结果。这种推理过程中的微调机制使编码器能够提取更加适应测试数据特征的表示。在MD17、ISO17、水体系以及电解质溶液四个数据集上测试了MLIP的预测精度。与基线模型相比,TAIP在无需使用额外数据的情况下,将预测误差平均降低了30%。此外,利用周期性水体系和电解质溶液数据集评估TAIP对MD模拟稳定性的影响,结果发现,即使在基线模型发生崩溃的条件下,TAIP仍能够维持稳定的MD模拟过程。最后,通过特征分布的可视化分析证实,TAIP能够有效减小训练数据集与测试数据集之间的分布偏移。
2 结果
2.1 预备知识
MLIPs被用于预测给定原子体系中的势能和原子间作用力。已经发展出了多种模型架构,包括结合神经网络的基于描述符的方法、线性模型以及高斯过程回归模型。近年来,图神经网络逐渐成为MLIPs中特别强大的模型架构。在典型的图神经网络MLIP中,可以将一个分子构型表示为
2.2 TAIP框架
该框架由能量和力预测主任务以及三个自监督学习任务组成,分别包括噪声强度预测、原子特征恢复和伪力恢复任务。所有任务共享一个编码器,该编码器用于将输入的原子结构转换为原子特征,并采用了现有MLIPs模型(如SchNet和PaiNN)的网络架构。主任务模块旨在预测体系能量
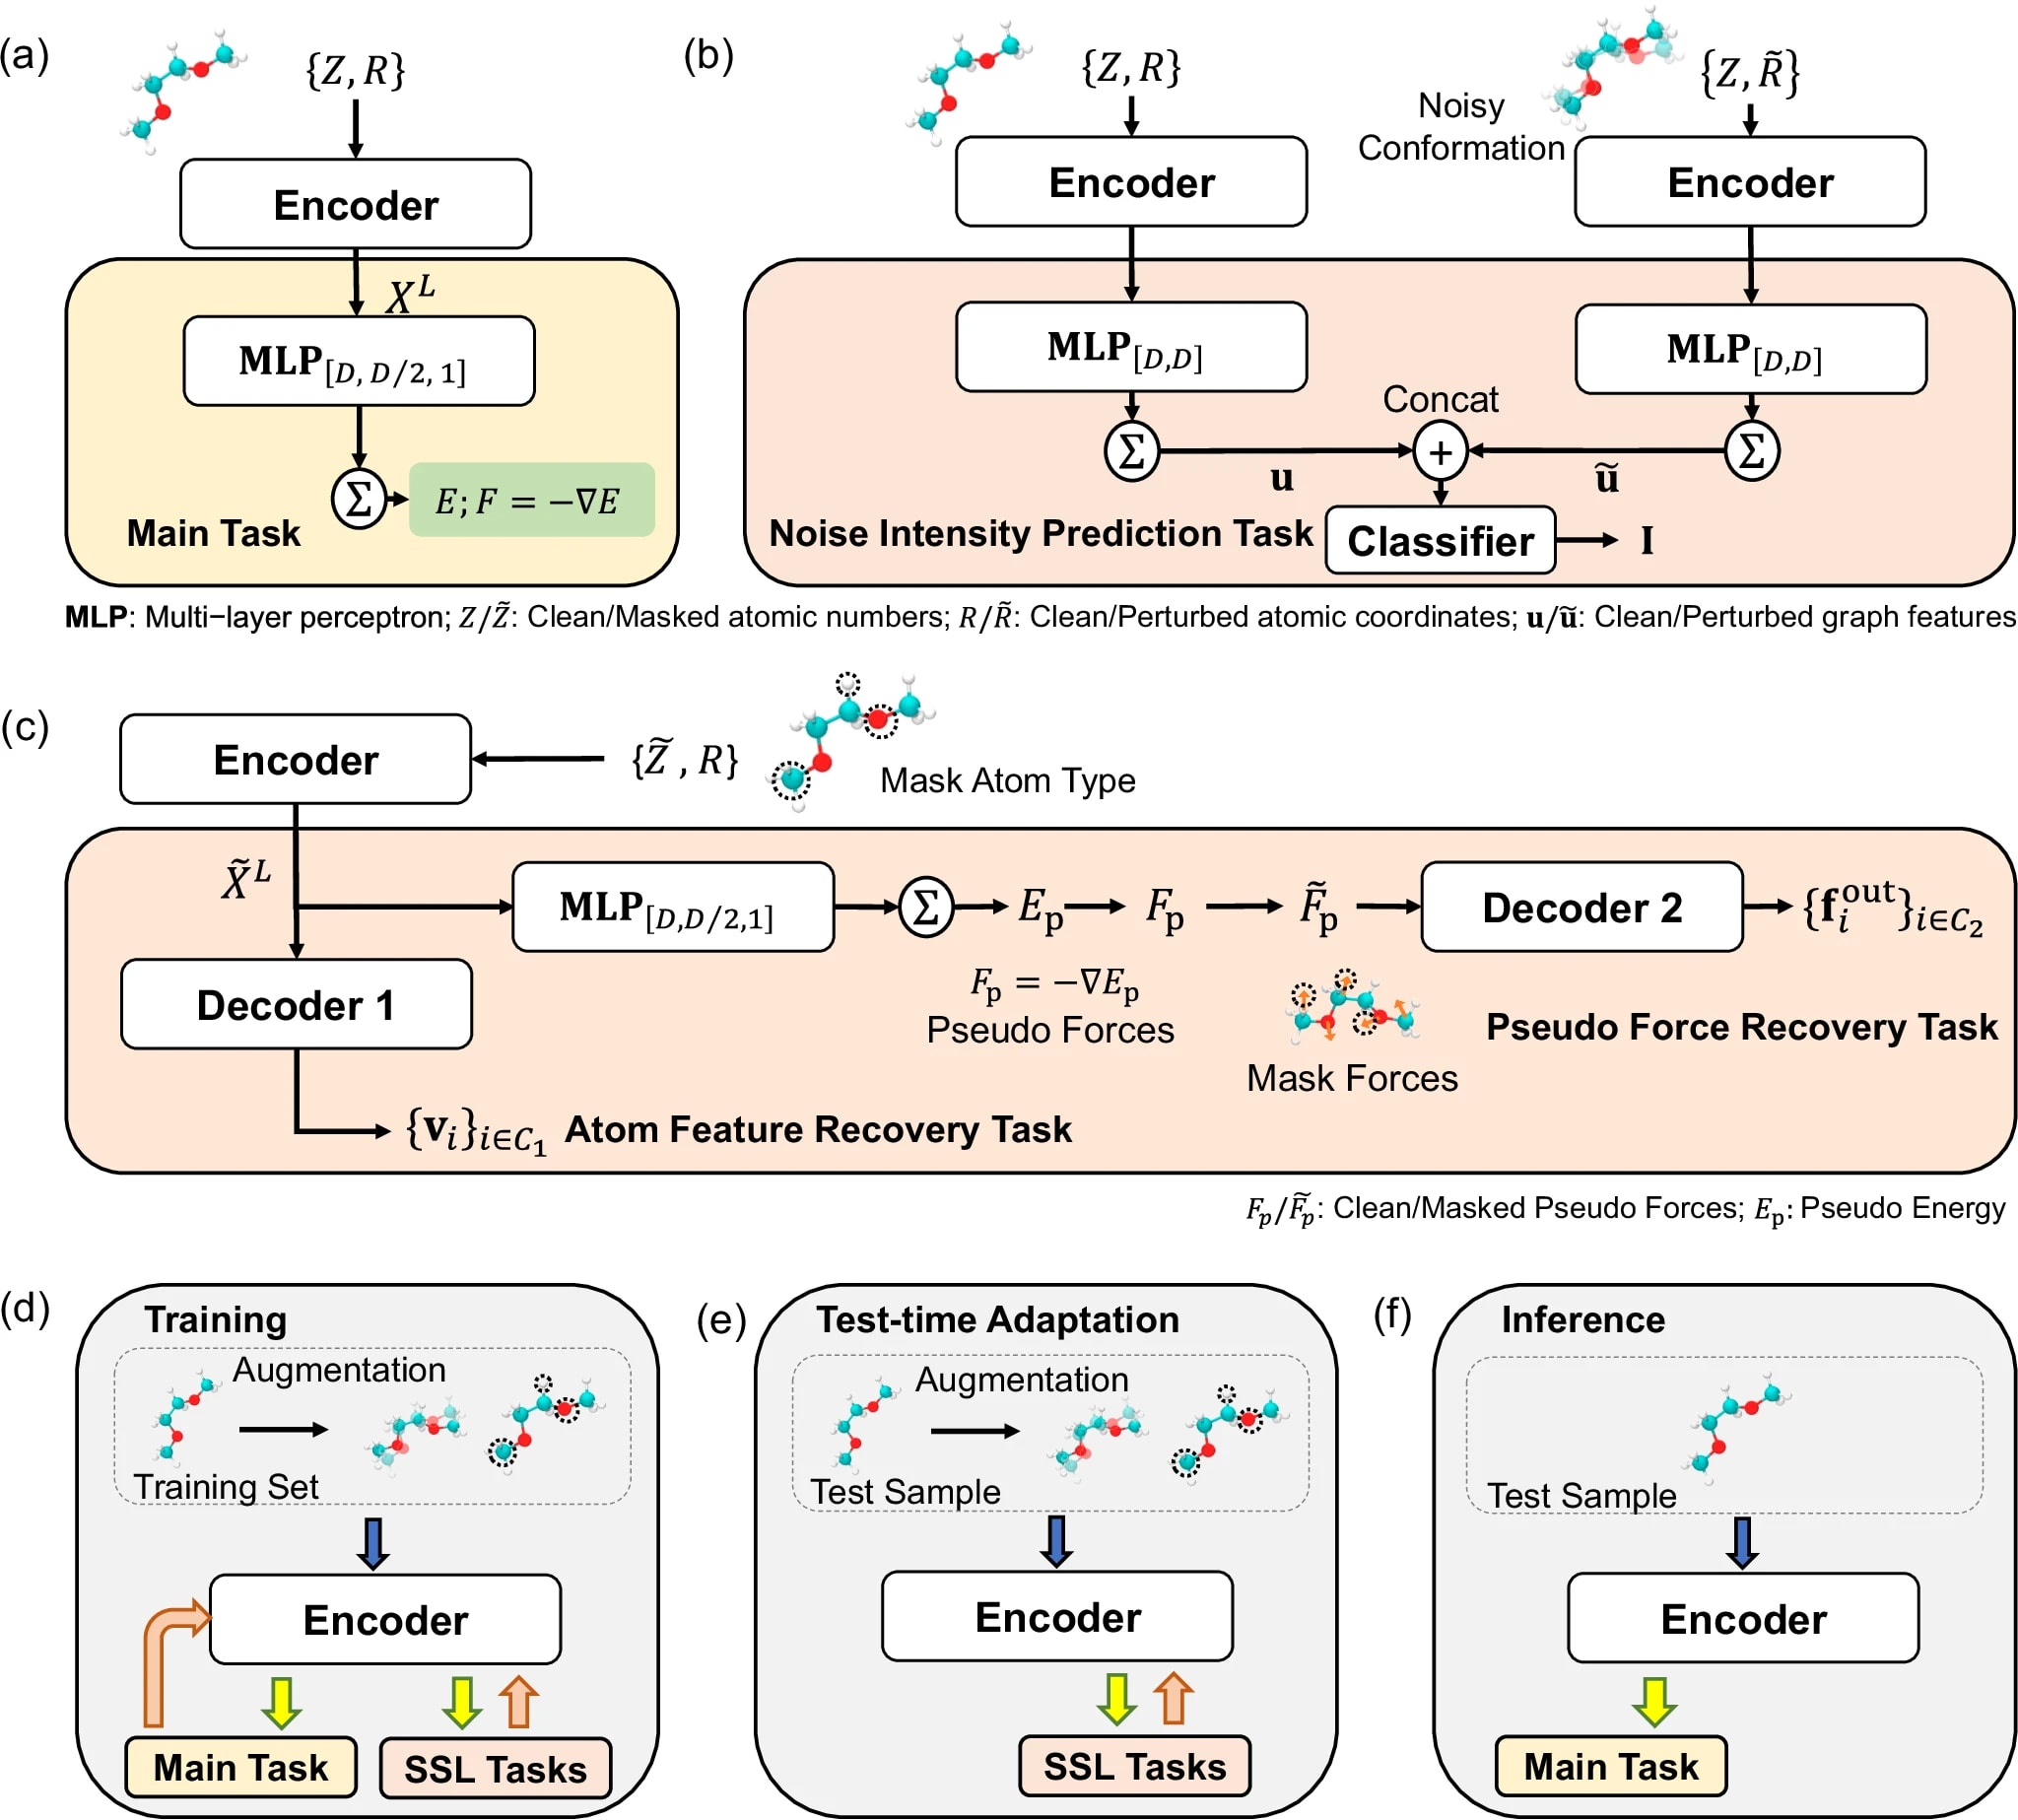
图1 | 概述 a. 能量和力预测主任务。 b. 噪声强度预测任务。c. 原子特征恢复任务和伪力恢复任务。d–f. TAIP的三个阶段:训练阶段、测试时适应阶段和推理阶段。在训练阶段,同时最小化主任务和自监督学习(SSL)任务的损失函数。在测试时适应阶段,通过最小化SSL任务损失函数,使编码器针对每个测试样本更新一次。随后,测试样本经过更新后的编码器,用于预测能量和力。
噪声强度预测任务用于评估输入结构受到扰动的程度。对于每个样本,利用均值为0、方差为
原子特征恢复任务对应于包含解码器1的分支。对于每个样本,随机选择一组原子
伪力恢复任务对应于包含解码器2的分支。与主任务中通过聚合原子特征获得能量
TAIP包含三个阶段,分别为训练阶段、测试时适应阶段和推理阶段。
在训练阶段,采用多任务学习方案,根据主任务(即能量和力预测)的监督学习损失以及三个自监督学习任务的损失函数,对模型中的所有参数进行更新。通过利用监督学习目标和自监督学习目标所提供的丰富信息,该策略能够使模型学习更加具有表达能力的特征表示。
在测试时适应阶段,由于测试样本中不存在能量和力标签,模型参数只能通过最小化自监督学习任务损失进行调整。在该阶段,仅对编码器中的参数进行一次更新,而保持其他参数固定,包括两个解码器中的参数以及编码器之外MLIPs模型中的参数。通过这种方式,模型能够适应测试数据,并获得更好的预测性能。
在推理阶段,测试样本经过在测试时适应阶段更新后的编码器,用于预测能量和力。与自监督学习任务相关的其他模型分支不参与推理过程。
2.3 实验
在多个数据集上开展了一系列实验,用于评估TAIP在广泛使用的MLIPs模型SchNet和PaiNN上的性能,其中SchNet和PaiNN分别属于不变模型和等变模型。首先,在MD-17数据集上验证了该方法的优越性能。随后,将评估范围扩展至ISO17数据集以及具有周期性边界条件的复杂体系,包括水体系和电解质溶液。上述数据集中的测试数据与训练数据之间存在更大的分布偏移,相关结果表明该特征能够用于研究TAIP在提升模型泛化能力方面的效果。随后,在上述复杂体系中利用MLIPs进行MD模拟,以评估TAIP的实际应用价值。此外,通过t-SNE方法进行降维分析,进一步探索TAIP对特征分布的影响,并从特征嵌入角度揭示模型性能提升的作用机制。
2.3.1 MD-17
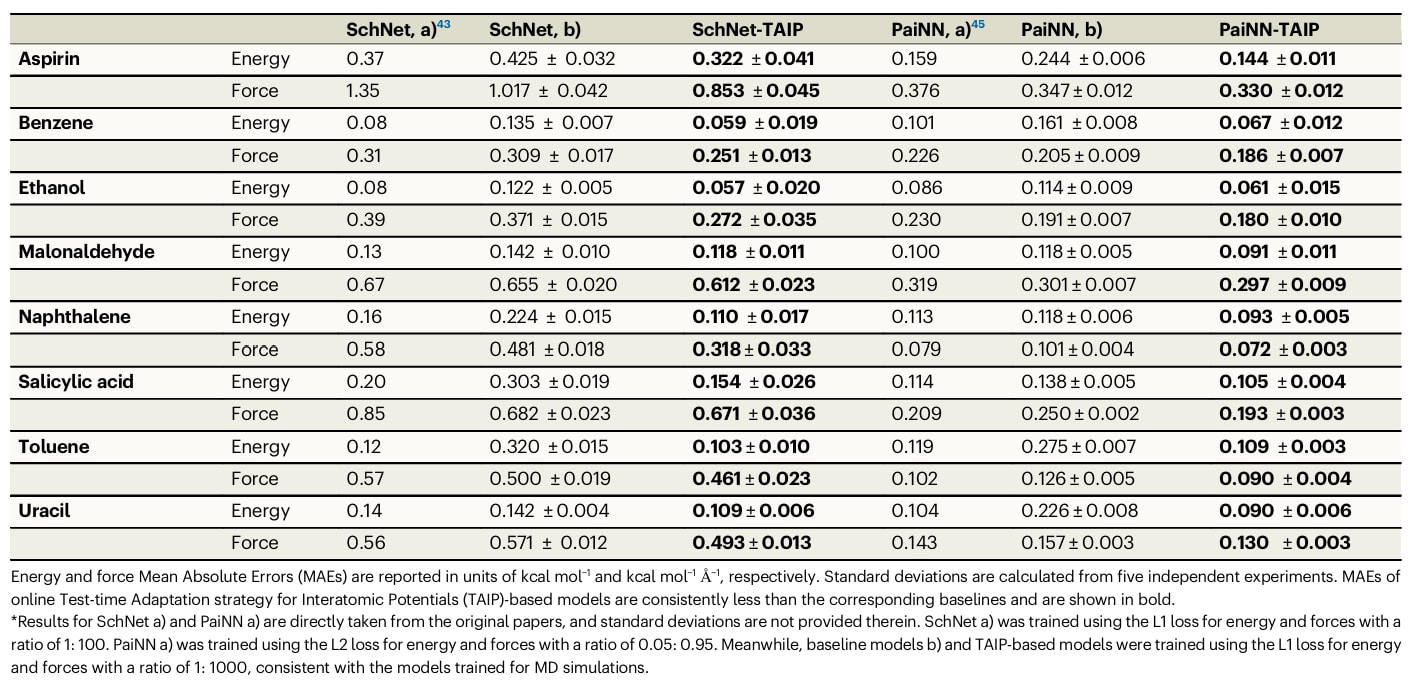
在广泛使用的MD-17数据集上评估了TAIP的性能。该数据集包含小型有机分子,其能量和力的参考值由从头算分子动力学(ab initio MD)模拟生成。不同模型对不同分子预测能量和力的平均绝对误差(MAEs)进行了比较。结果表明,基于TAIP的模型在全部8种分子上的表现均优于对应的基线模型,证明了该方法具有良好的泛化能力。
表1 | MD17数据集上的结果
2.3.2 ISO17
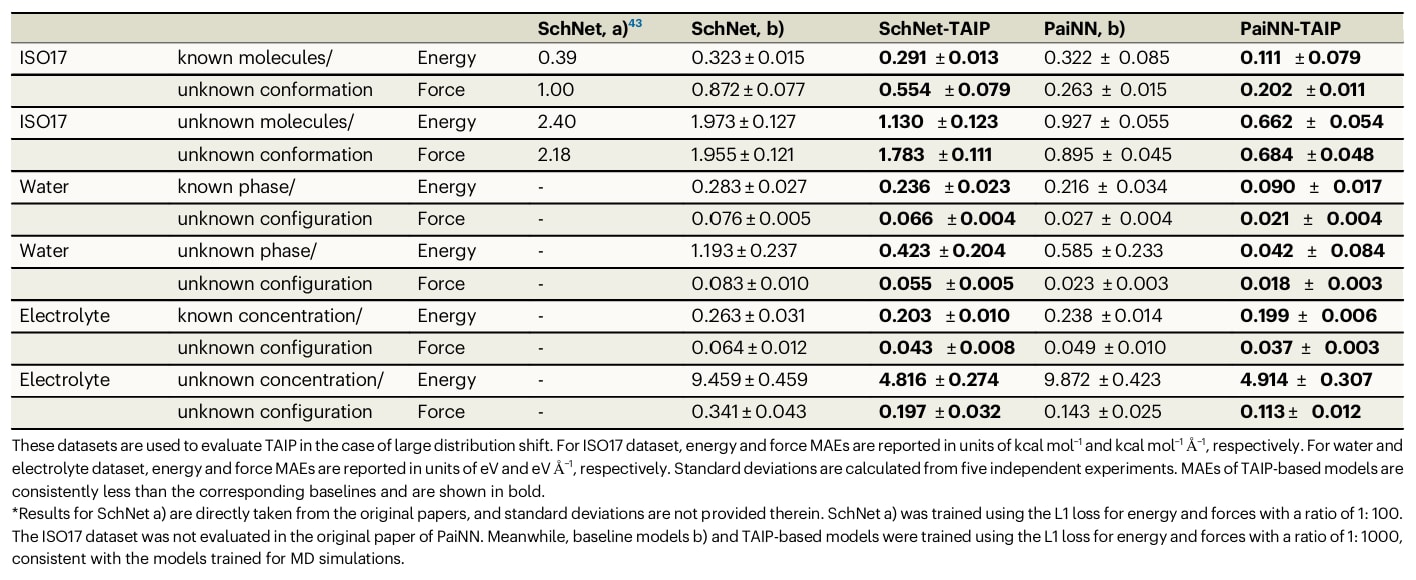
ISO17数据集包含
表2 | ISO17、水体系和电解质数据集上的结果
2.3.3 液态水和冰
水具有复杂的相态行为,这对计算研究提出了较大的挑战。液态水和冰之间的微观结构存在显著差异。液态状态下,水分子通过氢键形成高度动态的网络结构;相比之下,冰晶中的水分子形成稳定的六方晶格结构。不同相态之间的结构差异可能导致预测精度下降。因此,仅使用液态水数据训练模型,其中训练集包含1000个构型,验证集包含100个构型,并分别从剩余数据集中随机采样500个液态水和冰结构作为测试集,用于评估模型性能。液态水(已知相态/未知构型)和冰(未知相态/未知构型)的MAE结果显示,TAIP方法能够在已知相态和未知相态条件下,将未知构型的力和能量预测误差平均降低40%。
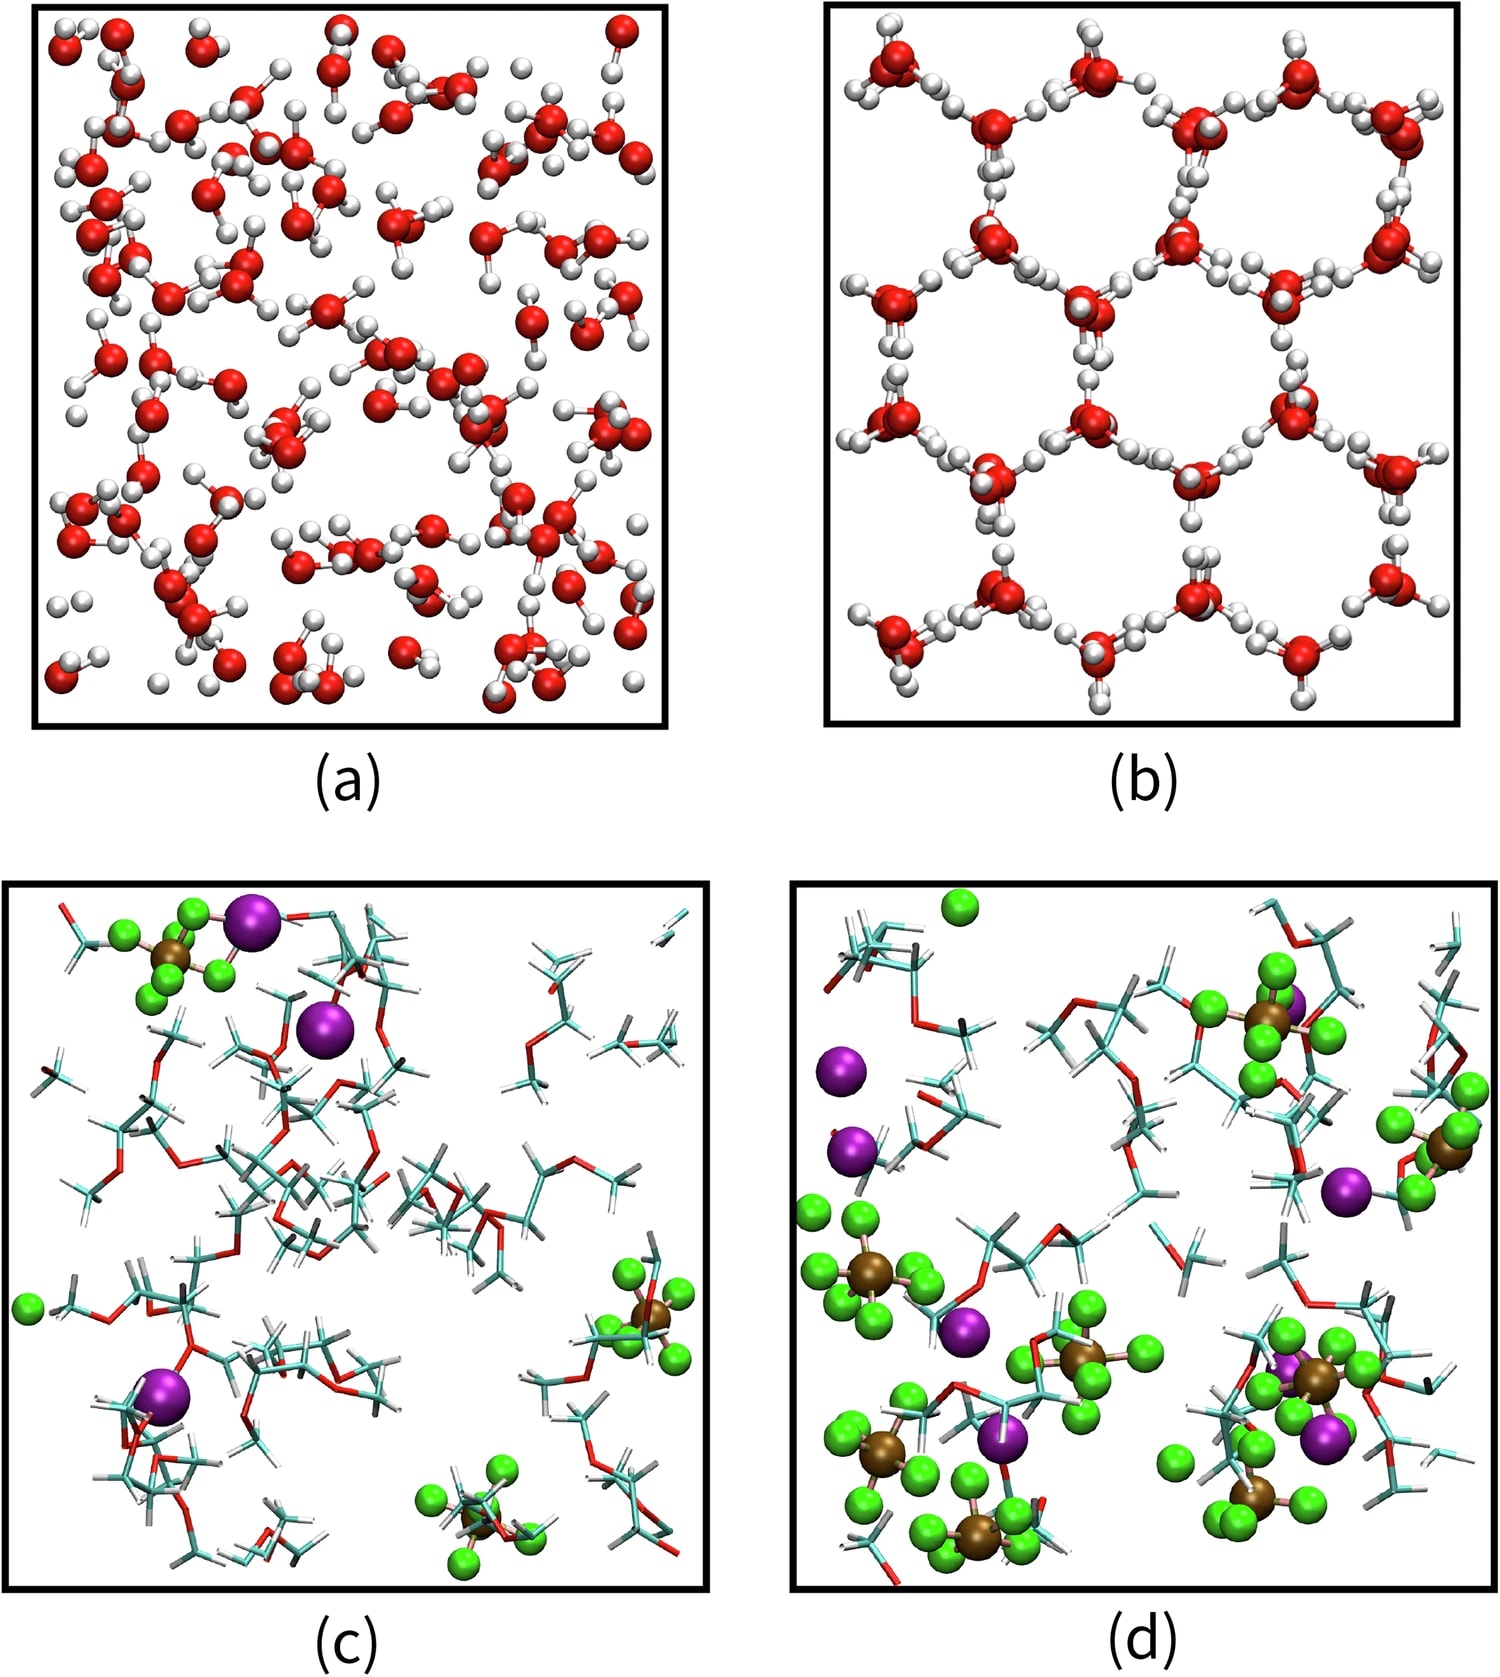
图2 | 原子结构可视化 a. 液态水。b. 冰。c. 1M(
2.3.4 不同浓度的电解质溶液
在电解质溶液数据集上评估TAIP的性能。该数据集由先前工作开发,包含带电离子和有机溶剂,涉及更多种类的元素、更强的静电作用以及更加复杂的原子间相互作用,因此相比水体系具有更高的复杂性。针对这类复杂体系训练MLIPs,并使训练后的模型能够泛化至不同浓度条件,均具有较大挑战。实验中,使用1M(
2.3.5 MD模拟
固定数据集上预测力和势能的MAEs并不足以全面表征MLIPs在长时间MD模拟中的性能。在MD模拟过程中,不断产生新的分子结构,而单个原子间作用力预测错误可能导致整个模拟体系发生崩溃。因此,进一步在周期性体系(水体系和电解质溶液)中分别利用TAIP和未使用TAIP的模型进行MD模拟,以分析TAIP对预测力以及MD模拟质量的影响。
选择了四种体系进行MD模拟,包括液态水、六方冰、1M和4M电解质溶液。对于SchNet基线模型和SchNet-TAIP模型,分析了这些轨迹中的势能、动能以及最大绝对力变化情况。结果表明,水体系模拟在250ps后出现不期望的力和能量不稳定性,冰体系模拟在248ps时发生崩溃。浓度为1M和4M的电解质溶液模拟分别由于在第258步(~0.1ps)和第1843步(~0.9ps)时丢失多个原子而发生崩溃。相比之下,使用TAIP的所有模拟均能够稳定运行超过500ps。冰体系和4M电解质溶液的模拟轨迹也进行了展示。此外,还利用PaiNN基线模型和PaiNN-TAIP模型进行了MD模拟。
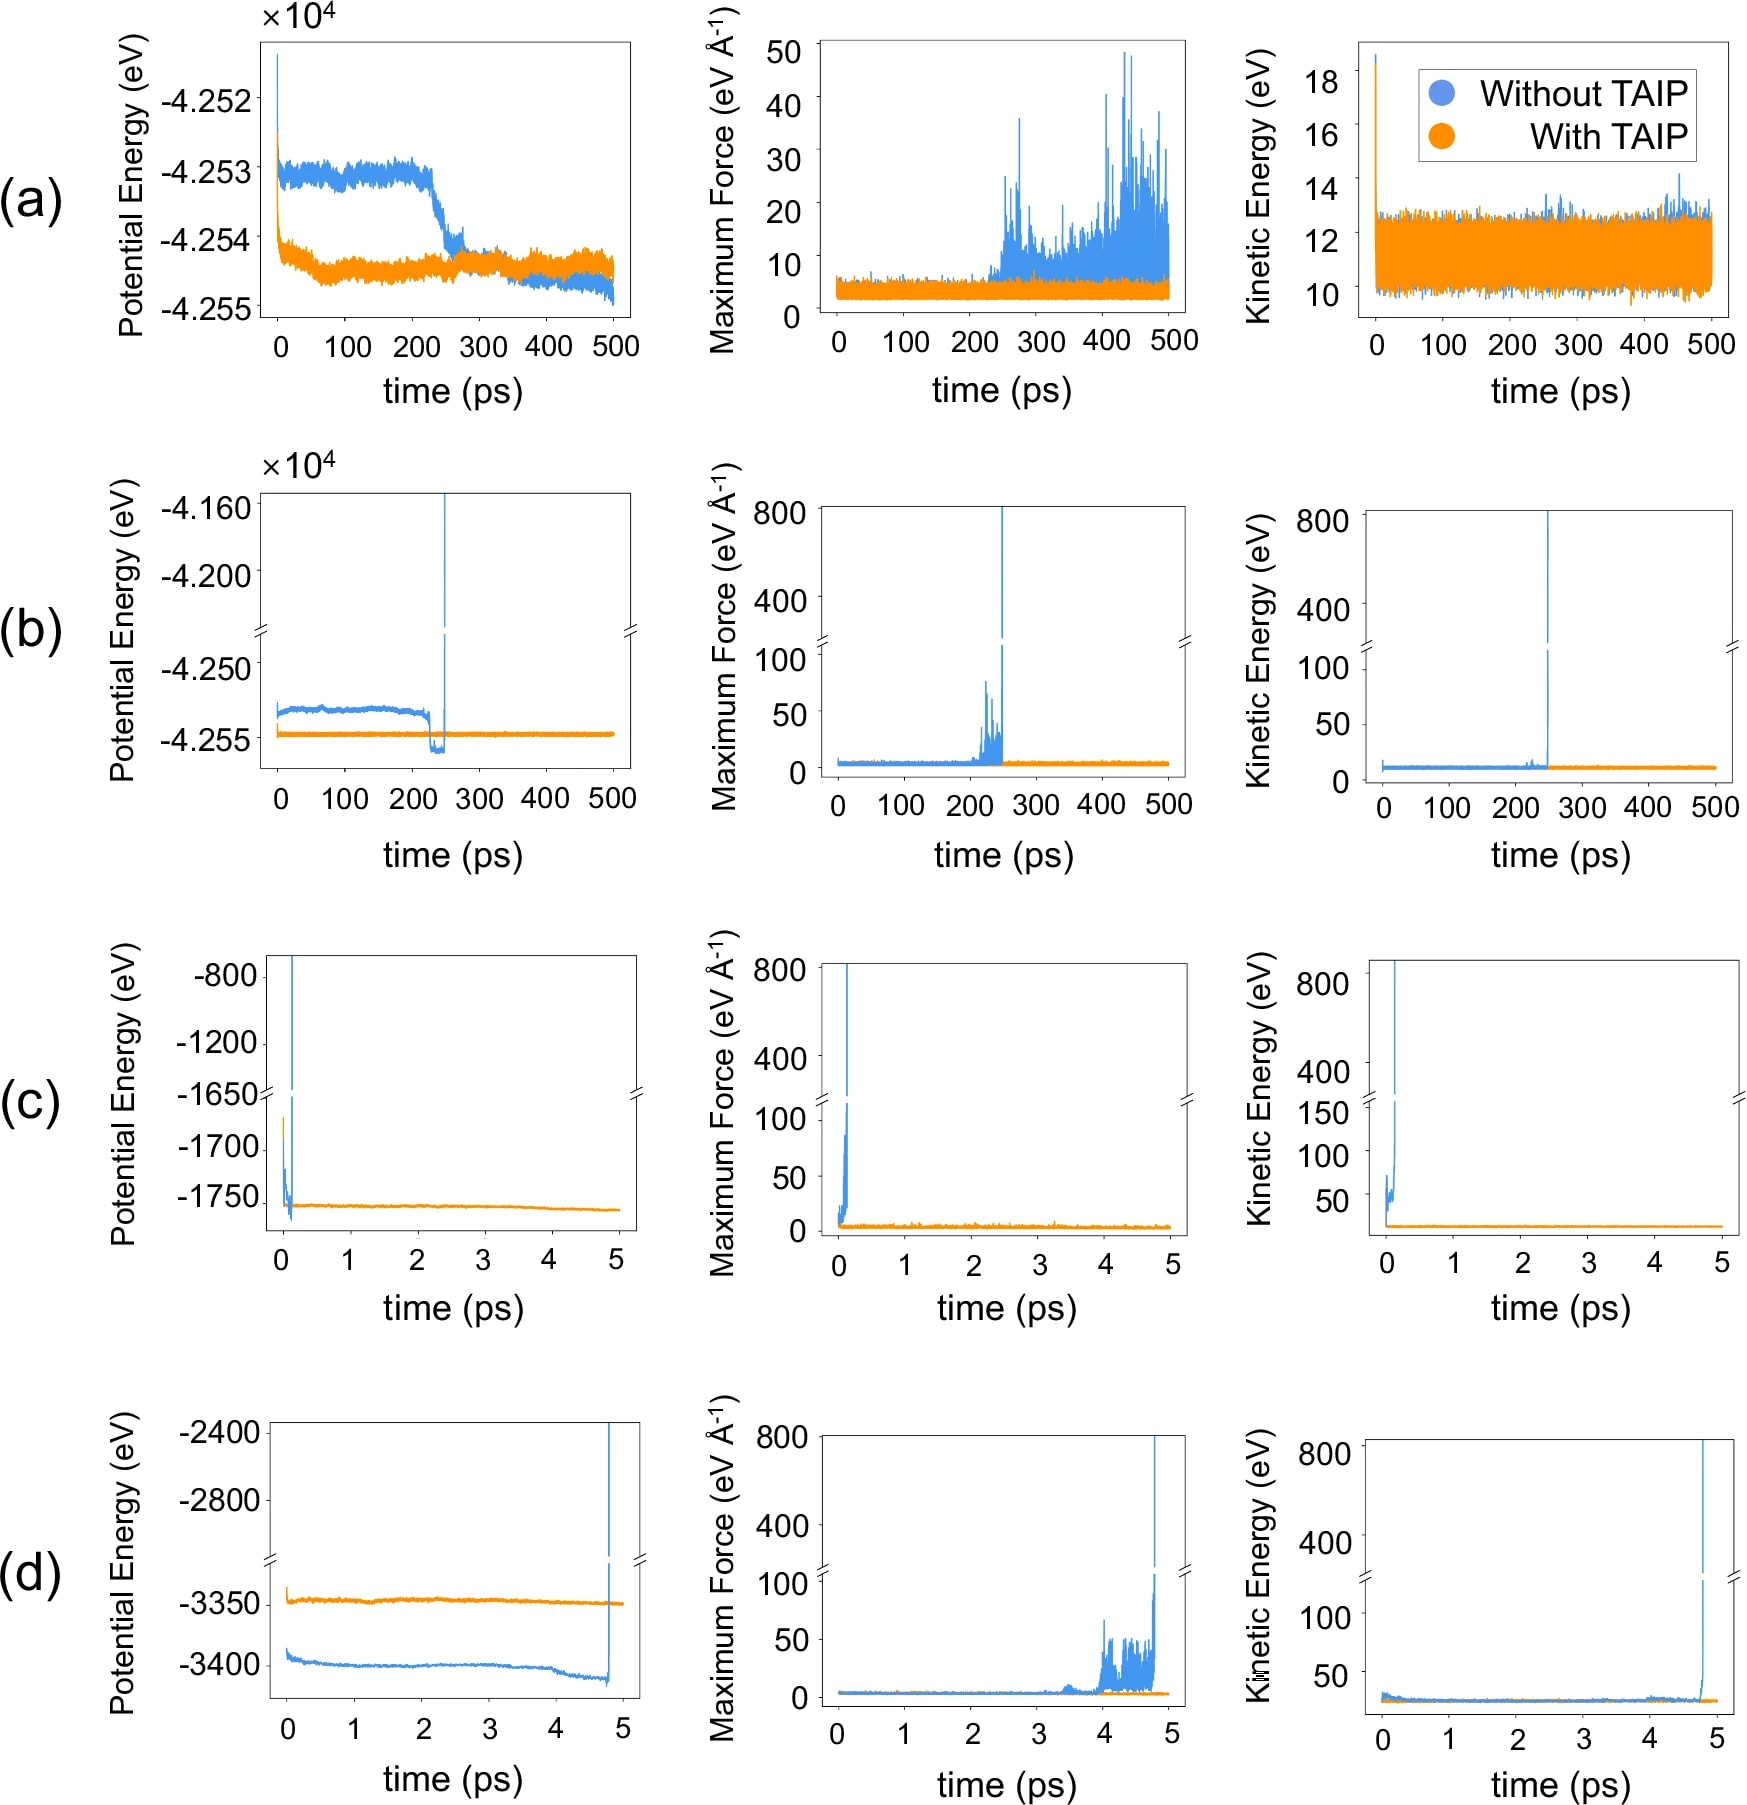
图3 | 分子动力学(MD)模拟结果 a. 液态水。b. 冰。c. 1M(
显然,MD模拟失败是由预测势能和力的发散导致的。对于基于MLIP的MD模拟而言,不稳定性是一个根本性问题,因为在面对未知构型时,不使用TAIP的MLIPs预测精度会受到严重影响。引入TAIP方法能够提升基于MLIP的MD模拟在处理未知分子结构时的整体性能,并可作为解决MD模拟不稳定问题的一种有效方案。
2.3.6 特征可视化
为了直观分析TAIP的作用,采用t-SNE方法对基准模型和TAIP模型中的训练数据集与测试数据集特征嵌入进行一系列降维映射。结果表明,TAIP模型中测试数据集的特征嵌入相比基线模型更加接近训练数据集的特征分布。这说明TAIP能够使MLIPs在处理未知分子结构时具有更低的不确定性,从而提升能量和力预测的准确性与泛化能力。
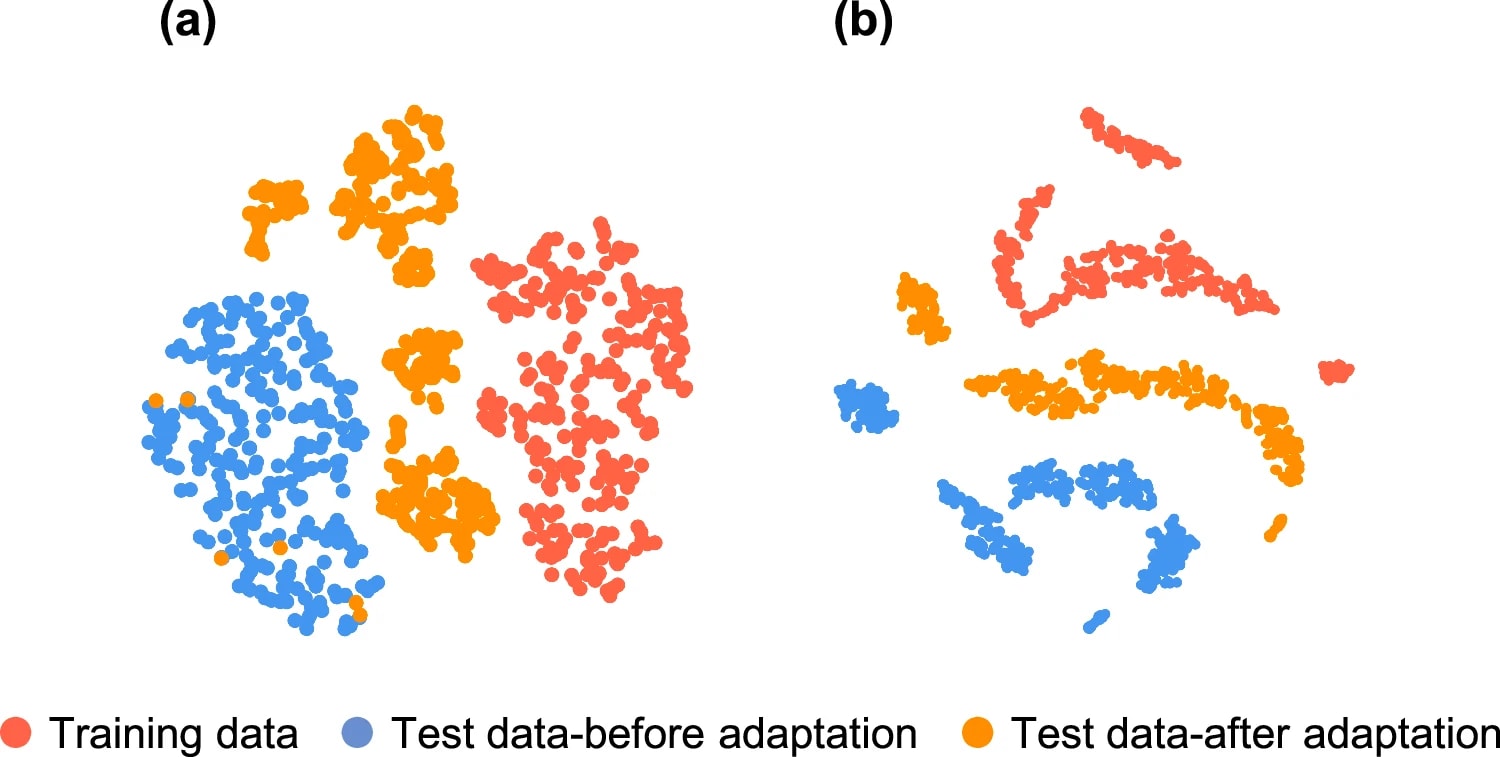
图4 | 特征空间可视化 a. 液态水(训练集)和冰(测试集)。b. 1M(
3 讨论
MLIPs在实际应用中面临的主要挑战之一,是在测试数据与训练数据存在分布偏移的情况下,仍能够保持准确预测的能力。具体而言,可应用于实际场景的MLIP需要在模拟过程中持续产生的新原子结构上保持足够的预测精度。研究结果表明,TAIP框架能够在无需额外数据的情况下,提高MLIPs在测试数据集上的性能,其中测试数据集被设计为与训练数据具有显著的分布偏移。TAIP的有效性主要归因于噪声强度预测、原子特征恢复和伪力恢复等自监督学习任务。这些任务在训练阶段与能量和力预测主任务同时进行优化。在推理前,根据自监督学习任务损失对模型参数进行调整。该方法能够有效缩小训练数据集与测试数据集之间的领域差距,t-SNE特征空间可视化结果进一步验证了这一点。消融实验表明,提出的多个自监督学习任务在提升模型性能方面具有互补作用。除了提高能量和力预测的准确性外,TAIP还能够实现基于MLIP的稳定MD模拟,其性能优于在相同条件下发生模拟失败的基线模型。不同分子体系上的实验结果进一步展现了该方法的广泛应用潜力。