NMI 2024|PSICHIC:用于从序列数据中学习蛋白质–配体相互作用指纹的物理化学图神经网络
今天介绍的是发表在 Nature Machine Intelligence 的工作——《Physicochemical graph neural network for learning protein–ligand interaction fingerprints from sequence data》。该研究提出 PSICHIC,一种融合物理化学约束的图神经网络,仅利用蛋白质序列和配体 SMILES,即可学习可解释的蛋白质–配体相互作用指纹。PSICHIC 不依赖三维复合物结构,在结合亲和力预测中达到甚至超过部分结构方法,同时能够识别关键结合残基和配体原子。进一步实验表明,该模型可用于功能效应预测、虚拟筛选和靶点选择性分析,并成功从 3 万余个化合物中筛得新的 A1R 激动剂,为基于序列的高效药物筛选和相互作用机制解析提供了新的思路。
获取详情及资源:
0 摘要
在药物发现中,确定小分子配体与蛋白质的结合亲和力及其功能效应至关重要。现有计算方法能够预测这些蛋白质–配体相互作用性质,但在缺乏高分辨率蛋白质结构时往往会出现精度下降,并且在功能效应预测方面仍存在不足。该研究提出 PSICHIC(Physicochemical Graph Neural Network,物理化学图神经网络),通过引入物理化学约束,仅利用序列数据即可直接解析蛋白质–配体相互作用指纹。借助这一设计,PSICHIC 能够解析蛋白质–配体相互作用背后的机制,并在预测精度和可解释性方面达到当前先进水平。
在使用完全相同的蛋白质–配体对、且不引入结构数据进行训练的条件下,PSICHIC 在结合亲和力预测中达到甚至超过了领先的基于结构的方法。在针对腺苷 A1 受体激动剂开展的实验性化合物库筛选中,PSICHIC 能够有效区分化合物的功能效应,并将唯一发现的新型激动剂排在前三位。PSICHIC 生成的可解释相互作用指纹还能够识别参与相互作用的蛋白质残基和配体原子,并有助于揭示决定蛋白质–配体相互作用选择性的关键因素。PSICHIC 有望推动虚拟筛选方法的发展,并进一步深化对蛋白质–配体相互作用机制的理解。
1 引言
小分子配体与蛋白质之间的相互作用是许多生物学过程的基础。药物通过选择性地与特定蛋白质相互作用而发挥预期效应。用于理解这些相互作用并预测相关性质的计算方法,可以在实验验证之前以较低成本探索广阔的化学空间,从而加速药物发现。为此,大量研究致力于开发能够准确预测小分子与其蛋白质靶点之间结合亲和力和功能效应的计算方法。
根据输入数据要求,现有计算方法大致可分为三类。基于序列的方法使用一维(1D)输入或二维(2D)输入:前者包括配体的分子字符串和蛋白质序列,后者则包括配体分子图和预测得到的蛋白质接触图。尽管蛋白质接触图可以通过实验测定,但计算预测得到的接触图也已具备足够的准确性。基于结构的方法需要三维(3D)蛋白质结构,并结合 1D 或 2D 的配体输入。传统上,蛋白质三维结构主要来源于实验测定,但目前越来越多地使用计算预测结构,例如 AlphaFold2 生成的结构。然而,基于结构的方法可能对计算结构预测引入的误差较为敏感。基于复合物的方法则要求提供蛋白质–配体共复合物结构,这一点不同于基于结构的方法,后者并不要求三维配体以共结合形式存在于蛋白质结构中。
在其他条件相同的情况下,基于序列的方法更具优势,因为它既避免了实验结构测定所需的巨大成本,也规避了计算结构预测可能带来的误差。此外,与基于结构的方法不同,基于序列的方法在预测小分子对蛋白质靶点的功能效应时,不依赖于蛋白质所处的具体结构状态,而是可以直接预测蛋白质–配体相互作用的结合亲和力和功能效应。近年来,应用于序列数据的深度学习方法已能够实现越来越准确的预测。然而,深度学习方法本质上依赖模式匹配,因此基于深度学习的序列方法可能具有过多且缺乏约束的自由度。这种情况可能导致模型拟合训练数据中的错误模式,从而限制其泛化能力。因此,基于序列的方法与基于结构的方法以及基于复合物的方法之间仍存在明显的性能差距。
该研究认为,仅依赖序列数据即可解析并构建蛋白质–配体相互作用指纹。不过,这一核心假设需要满足一个关键条件:深度学习架构必须引入充分的物理化学约束。与以往基于深度学习的序列方法相比,这种策略有望更加忠实地表征蛋白质–配体相互作用的内在规律,从而缩小基于序列的方法与基于结构或基于复合物方法之间的性能差距。近年来,基于图神经网络(graph neural network,GNN)的结构方法和复合物方法已经展现出这一方向的潜力。这些方法通过捕获三维几何约束和物理化学约束,其性能优于相应的卷积神经网络方法。然而,如何将这些约束整合到仅在 1D 或 2D 空间中运行的序列方法中,仍然具有挑战性。目前基于序列的 GNN 通常采用两种策略:一种是简单拼接蛋白质和配体的表征,另一种则是在所有蛋白质残基与配体原子之间进行完整的两两比较,以建模二者之间的相互作用。
该研究提出 PSICHIC(发音为“psychic”),即物理化学图神经网络(PhySIcoCHemICal graph neural network)。该方法旨在遵循物理化学原理,仅利用序列数据直接解析蛋白质–配体相互作用指纹。与以往基于序列的模型不同,PSICHIC 将物理化学约束显式引入模型,从而实现当前先进的预测精度与可解释性。作为一种基于二维信息的序列方法,PSICHIC 通过聚类算法在二维图结构上生成并施加这些约束,使模型在训练过程中能够优先拟合决定蛋白质–配体相互作用的合理基础模式。
在使用完全相同的蛋白质–配体对且不引入结构数据进行训练的条件下,PSICHIC 在结合亲和力预测中达到甚至超过了当前先进的基于结构和基于复合物的方法。在功能效应预测任务中,PSICHIC 的准确率达到
2 结果
2.1 PSICHIC 框架
PSICHIC 提出了一种从带标注的序列数据中学习蛋白质–配体相互作用指纹的框架(图 1 和扩展数据图 1)。PSICHIC 的输入可以是任意包含蛋白质–配体对的序列数据,其中蛋白质以氨基酸序列表示,配体则以简化分子线性输入规范(simplified molecular-input line-entry system,SMILES)字符串表示。训练 PSICHIC 时,这些蛋白质–配体对需要带有结合亲和力、功能效应等相互作用性质标签。
PSICHIC 根据配体的 SMILES 构建配体图(图 1a),并根据蛋白质序列构建蛋白质图(图 1b)。对于配体,首先利用原子类型特征和物理化学性质对原子进行嵌入,随后通过共价键连接形成分子图。对于蛋白质,则利用残基类型特征和物理化学性质对氨基酸残基进行嵌入,并利用蛋白质语言模型(protein language model,PLM)ESM2 预测得到的接触图连接各残基(方法部分)。
PSICHIC 通过三个物理化学图卷积层,将分子内和分子间相互作用交织起来,从而对蛋白质–配体相互作用进行建模(图 1c)。在每一层中,PSICHIC 首先建模分子内相互作用,分别采用两个独立的图神经网络(GNN),在配体内部的原子之间以及蛋白质内部的残基之间进行消息传递(图 1c 中的步骤 1)。
随后,PSICHIC 引入物理化学约束,为分子间相互作用建模做准备(图 1c 中的步骤 2)。对于配体,PSICHIC 使用联结树分解(junction tree decomposition)聚类算法,将配体原子划分为不同的官能团;对于蛋白质,则采用可学习的 minCUT 聚类算法,将蛋白质残基划分为不同的蛋白质区域。这些约束引导 PSICHIC 发现符合物理化学原理的相互作用模式。对于配体,这些约束有助于识别参与相互作用的关键官能团;对于蛋白质,则将相互作用限制在完整配体与特定聚类蛋白质区域之间,从而减少模型对随机、分散相互作用模式发生过拟合的可能性。
PSICHIC 通过三个步骤对分子间相互作用进行建模(图 1c 中的步骤 3)。首先,利用注意力聚合机制对各官能团在相互作用中的贡献进行加权,并将配体的多个官能团聚合为一个整体表征,称为“配体球”(ligand ball)。其次,PSICHIC 采用交叉注意力机制计算配体球与不同蛋白质区域之间的相互作用强度,从而识别潜在的结合位点。最后,将配体球重新解聚为更新后的配体原子,同时将蛋白质区域还原为更新后的蛋白质残基,由此完成一次物理化学图卷积层的循环。
PSICHIC 共执行三个循环,迭代更新分子内和分子间相互作用。在此过程中,根据配体原子和蛋白质残基对分子间相互作用的贡献,分别累积其重要性评分(图 1d)。基于这些重要性评分,PSICHIC 将蛋白质图和配体图汇总为一个嵌入蛋白质–配体相互作用信息的指纹。该指纹具有直接可解释性,因为这些评分能够突出对相互作用至关重要的蛋白质残基和配体原子,从而定位潜在的蛋白质结合位点以及关键配体官能团。
最后,应用层利用该相互作用指纹预测不同的相互作用性质。该指纹既可用于预测,也可用于解释蛋白质–配体的相互作用性质,包括结合亲和力和功能效应(图 1e)。
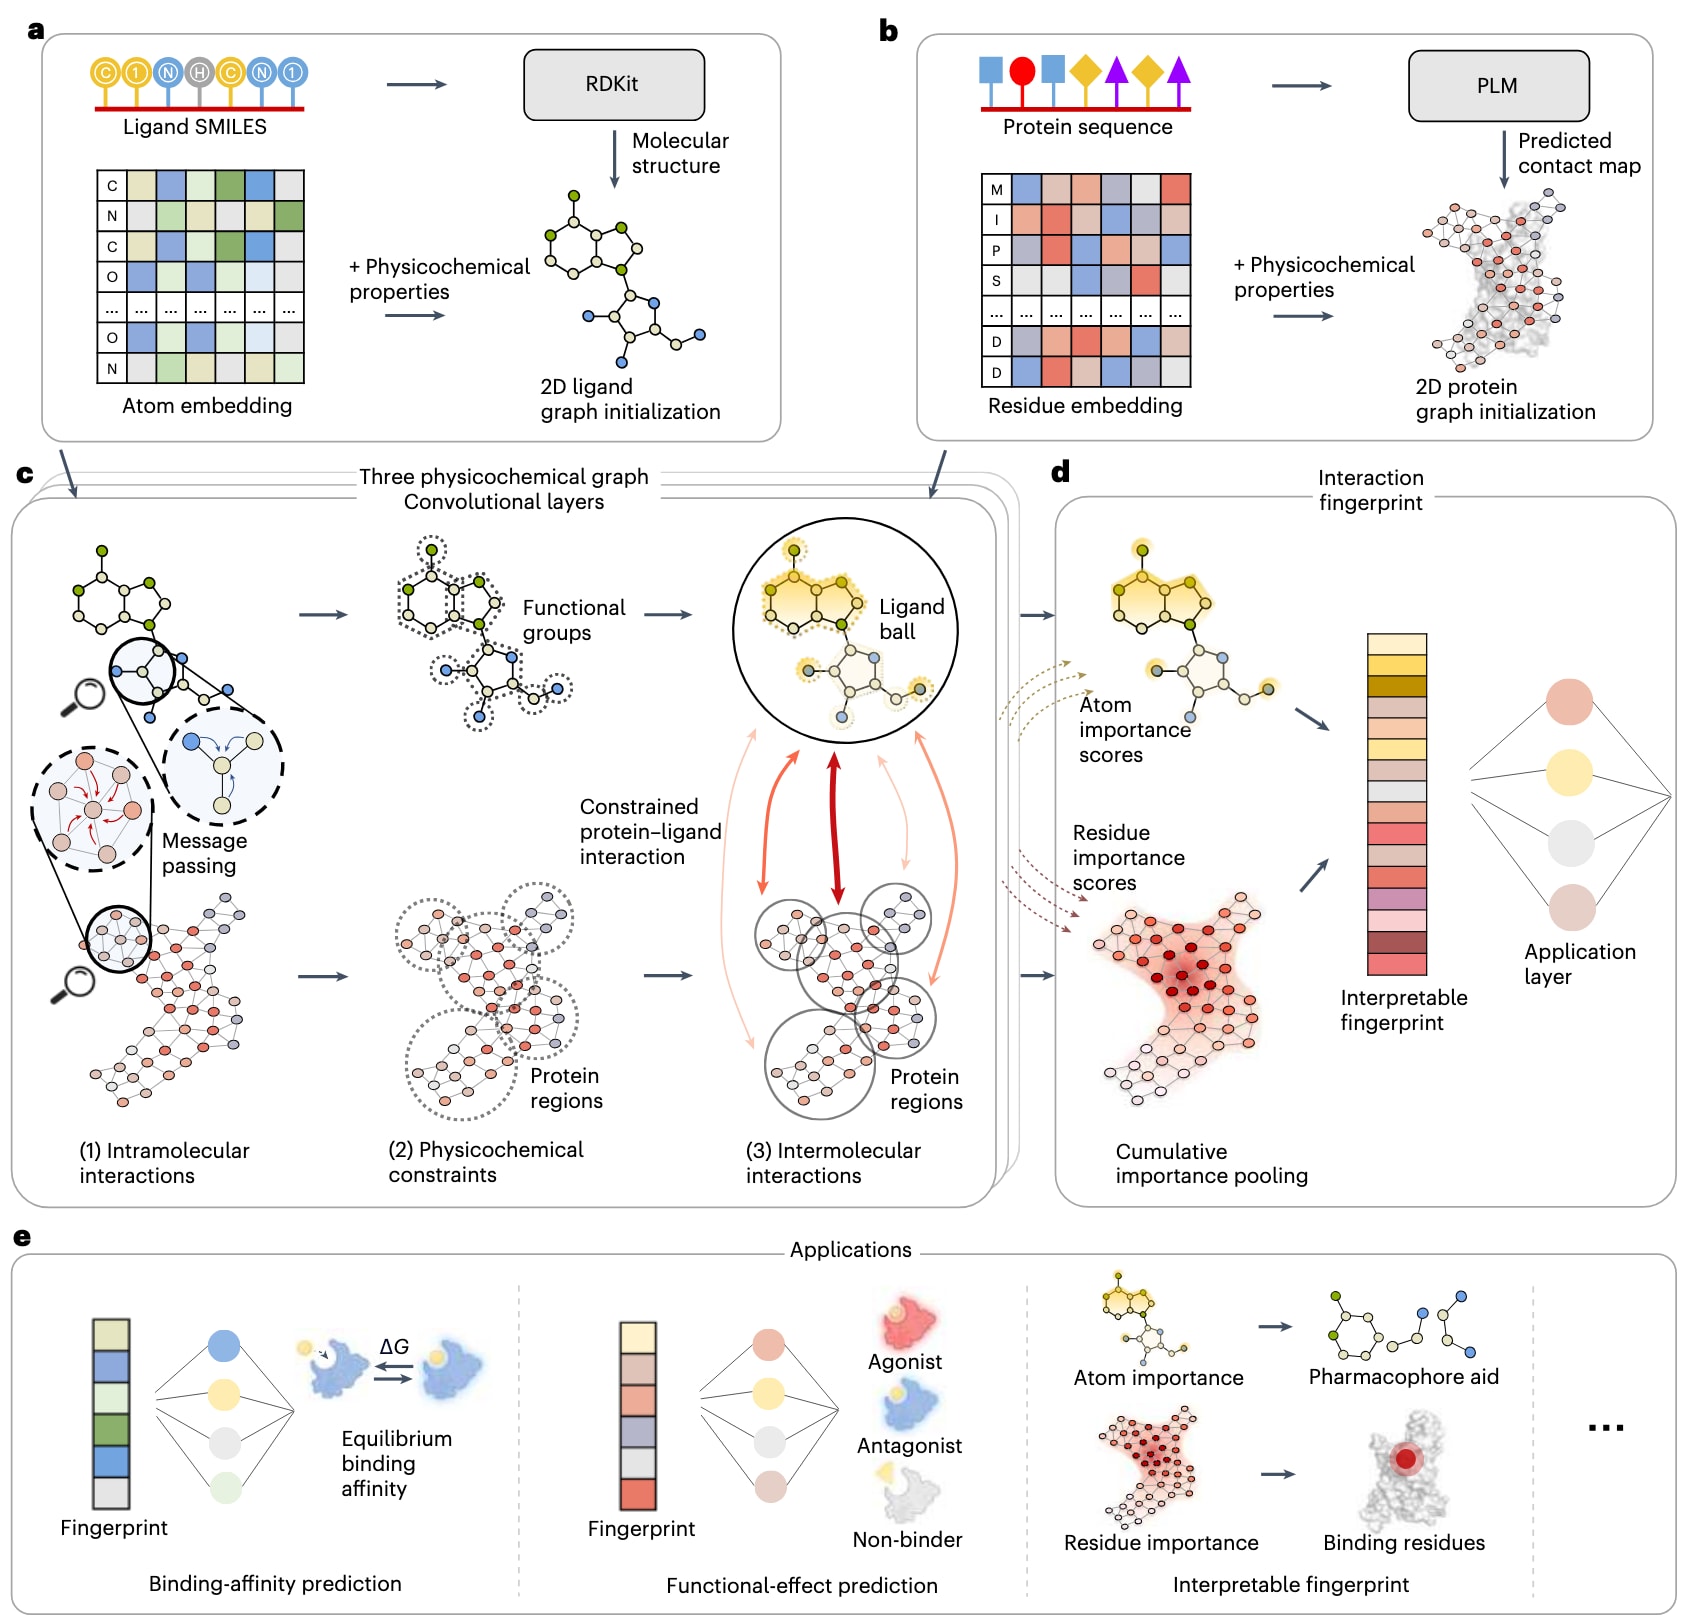
图1|PSICHIC(物理化学图神经网络) a,配体 SMILES 构建为原子图,原子采用原子类型嵌入和物理化学性质进行表征,并通过共价键连接。b,蛋白质序列构建为残基图,残基采用残基类型嵌入和物理化学性质进行表征,并通过蛋白质语言模型(PLM)ESM2 预测得到的接触图进行连接(方法部分)。c,在三个迭代层中:(1)PSICHIC 使用两个独立的 GNN,分别在原子之间和残基之间进行消息传递,从而建模分子内相互作用;(2)PSICHIC 通过将配体原子划分为官能团、将蛋白质残基聚类为不同蛋白质区域,引入物理化学约束;(3)PSICHIC 通过三个步骤建模分子间相互作用:首先,将配体官能团聚合为一个“配体球”(ligand ball);其次,计算配体球与不同蛋白质区域之间的相互作用强度;最后,将配体球解聚为更新后的配体原子,并将聚类的蛋白质区域还原为更新后的蛋白质残基,从而完成一个层的计算(方法部分和扩展数据图 1)。d,经过三个层后,PSICHIC 构建蛋白质–配体相互作用指纹,并根据分子间相互作用产生的重要性评分对原子和残基进行加权。该指纹具有可解释性:上半部分表示配体嵌入,并与由各原子聚合得到的重要性评分相关联;下半部分表示蛋白质嵌入,并与由各残基聚合得到的重要性评分相关联,从而反映各原子和残基参与相互作用的程度。该指纹随后作为单隐层网络的输入,用于性质预测。e,PSICHIC 的相互作用指纹可泛化至不同的相互作用性质预测任务,同时具备可解释性,包括结合亲和力(
2.2 评估与部署策略
在建立上述框架后,PSICHIC 的研究分为两个阶段:基准评估和真实场景部署。
在基准评估阶段,通过与当前主流方法进行比较,评估 PSICHIC 学习蛋白质–配体相互作用指纹的能力,具体设置如下:
- 结合亲和力回归。 为评估基于复合物、基于结构和基于序列的方法在结合亲和力预测中的效果,采用 PDBBind v2016 和 v2020 数据集,并沿用已有研究建立的训练集、验证集和测试集划分方式(表 1,图 2a–d)。
- 二分类相互作用预测。 为评估不同基于序列方法的泛化能力,采用 Human、BioSNAP 和 BindingDB 三个基于序列的数据集。分别使用随机划分、未见配体划分(unseen ligand split)和未见蛋白质划分(unseen protein split)三种策略,并按照既定的
比例划分训练集、验证集和测试集(图 2e)。对于 BioSNAP 和 BindingDB,还采用了第四种划分策略,即按照 DrugBAN 提出的方法,确保验证集和测试集中的蛋白质与配体不仅在训练集中未出现,而且与训练集中的对应样本具有较大的差异(图 2f)。 - 功能效应分类。 为评估不同基于序列方法预测功能效应的能力,构建了一个序列数据集,将配体相对于蛋白质的功能效应划分为激动剂、拮抗剂或非结合物三类,并按照
的比例随机划分训练集、验证集和测试集(图 2g)。
在全部 14 种基准设置中,PSICHIC 与各基线方法均从头开始训练和验证,并随后在测试集上进行评估,以确保比较的公平性。
在真实场景部署阶段,构建了一个大规模蛋白质–配体相互作用数据集,用于训练并建立 PSICHIC 的部署版本 PSICHICXL。训练完成后的 PSICHICXL 能够同时预测结合亲和力和功能效应,并对蛋白质–配体相互作用进行解释。有关数据集的具体信息及相应的 PSICHIC 适用范围,见扩展数据表 1。
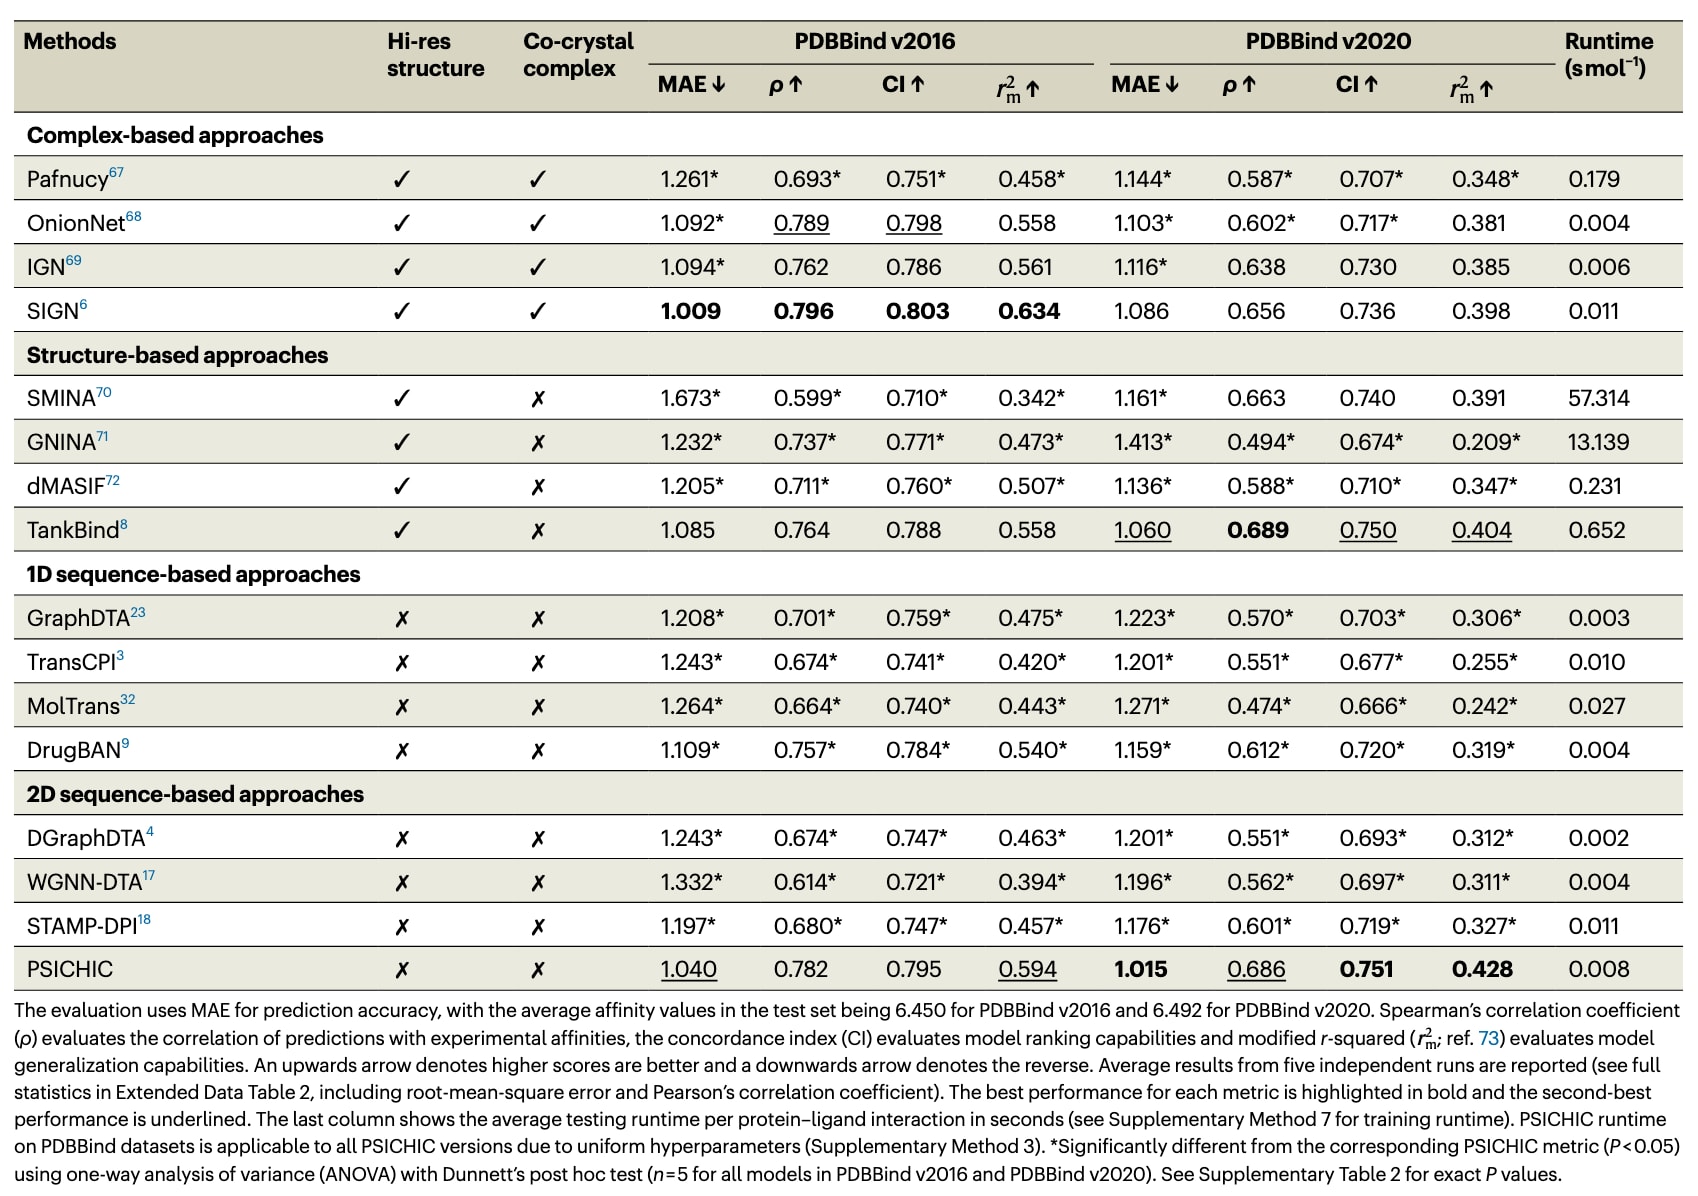
表1|PDBBind v2016 和 PDBBind v2020 基准数据集上蛋白质–配体结合亲和力预测的性能统计汇总
2.3 相互作用指纹的有效性
采用 PDBBind v2016 和 v2020 数据集评估 PSICHIC 的结合亲和力预测能力。PDBBind v2016 和 v2020 数据集均具有标准的训练集和测试集划分,分别包含约 3,000 和 17,000 个样本。每个样本均包含实验测定的蛋白质–配体复合物及其结合亲和力,后者以经过负对数转换的解离常数(pKD)或抑制常数(pKI)表示。PSICHIC 与三类当前先进方法进行了比较,包括基于复合物、基于结构和基于序列的方法。
基于复合物的方法使用完整的蛋白质–配体复合物结构;基于结构的方法使用实验测定的配体结合状态下蛋白质三维结构,但不包含配体的三维信息;基于序列的方法则仅使用配体 SMILES 和蛋白质序列。通过这一设置,所有方法均在完全相同的蛋白质–配体对上进行训练、验证和测试,区别仅在于可使用的信息类型不同。
在 PDBBind v2016 数据集上(表 1),PSICHIC 的性能仅次于基于复合物的 SIGN,优于其他所有基于复合物的方法、所有基于结构的方法,并显著优于全部基于序列的方法。在 PDBBind v2020 数据集上,PSICHIC 获得了整体最佳性能,超过所有基于序列、结构和复合物的方法。与此前的基于序列方法相比,PSICHIC 显著优于现有最佳的一维序列方法 DrugBAN,以及架构上更为相似的二维序列方法 STAMP-DPI,其平均绝对误差(MAE)分别降低
在两个 PDBBind 测试集上,PSICHIC 均表现出较强的稳健性。在不同蛋白质家族中,其性能持续优于其他方法,仅在 G 蛋白偶联受体(GPCR)上位居第二且差距较小(图 2a)。在不同蛋白质长度范围内,PSICHIC 同样表现突出(图 2b),尤其是在长度处于最高四分位数、即超过
进一步分析 PDBBind v2020 测试集发现,领先的基于结构方法 TankBind 和基于复合物方法 SIGN 的预测误差,会随着实验结构分辨率降低而增大(Pearson 相关检验,
总体而言,尽管领先的基于结构和基于复合物方法通常优于除 PSICHIC 之外的基于序列方法,但这些方法对三维结构中的误差较为敏感,无论该结构来源于实验测定还是计算预测。PSICHIC 在实现稳健且达到当前先进水平的预测性能后,也进一步体现出基于序列方法在药物早期筛选阶段的成本优势,而成本较高的实验结构测定则可更多用于获得更全面、深入的机制信息。
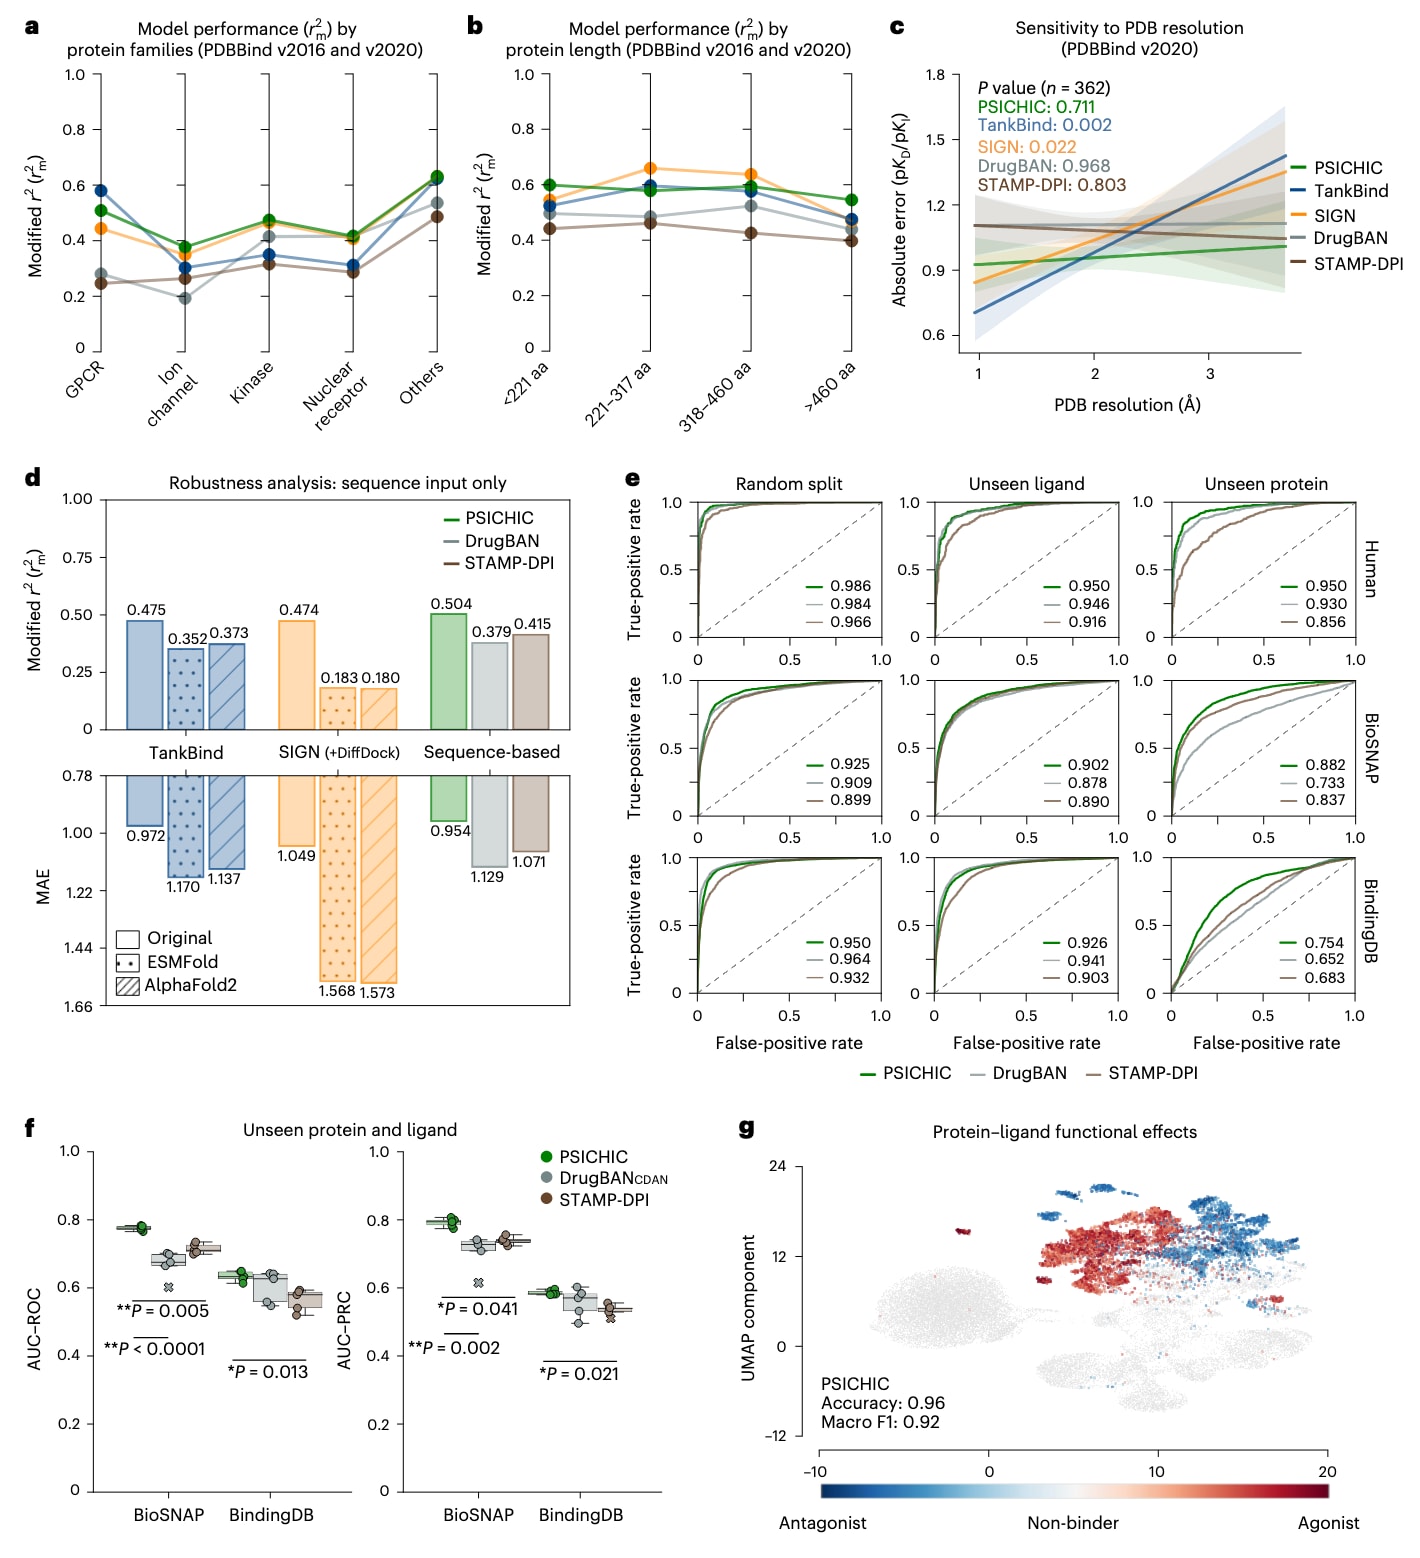
图2|相互作用指纹的泛化能力。 a、b,在 PDBBind v2016 和 v2020 合并测试集上,不同模型按蛋白质家族(a)以及按蛋白质长度四分位数分组(b)后的性能(
2.4 相互作用指纹的泛化能力
PSICHIC 仅利用序列信息便表现出超过基于结构和基于复合物方法的能力,因此进一步评估了其泛化性能。
采用仅包含序列信息的 Human、BioSNAP 和 BindingDB 数据集作为基准,设置了三种数据划分策略:随机划分、未见配体划分(unseen ligand split)和未见蛋白质划分(unseen protein split)。每种划分均进一步划分为训练集、验证集和测试集。未见配体划分确保测试集中的配体骨架在模型训练期间从未出现,而未见蛋白质划分则确保测试集中的蛋白质在训练阶段同样未出现。由此形成 9 种不同的实验设置,用于评估模型的泛化能力。通过二分类任务预测蛋白质–配体相互作用活性,并将 PSICHIC 与另外 7 种基于序列的方法进行比较。以受试者工作特征曲线下面积(AUC-ROC)衡量时,PSICHIC 的性能最高,其次是一维序列方法 DrugBAN 和二维序列方法 STAMP-DPI(图 2e 和扩展数据图 3)。
为进一步评估 PSICHIC 的泛化能力,在 BioSNAP 和 BindingDB 数据集上采用了第四种数据划分策略。按照 DrugBAN 提出的方案,使测试集中的蛋白质和配体不仅在训练集中从未出现,而且与训练集中的对应样本具有较大差异。与 DrugBAN 相同,由于 Human 数据集规模不足以支持有效划分,因此未纳入该项实验。在与 DrugBAN 和 STAMP-DPI 的比较中,PSICHIC 仍取得更优性能,尽管 DrugBAN 专门引入了跨域自适应机制(cross-domain adaptation mechanism,CDAN),以处理训练阶段未出现的蛋白质和配体(图 2f)。
在虚拟筛选中,除了判断蛋白质与配体之间是否存在相互作用外,进一步确定配体是激活靶蛋白的激动剂(agonist),还是抑制其活性的拮抗剂(antagonist),对于提高药物发现效率同样十分重要。为此,利用 ExCAPE、Papyrus 和 Cortellis 数据构建了蛋白质–配体功能效应数据集(扩展数据图 4)。在该数据集上训练 PSICHIC 后,模型能够预测配体相对于蛋白质靶点属于激动剂、拮抗剂还是非结合物。采用其中
总体而言,PSICHIC 能够有效学习具有泛化能力的蛋白质–配体相互作用指纹,从而准确预测结合亲和力和功能效应,体现出其在药物发现任务中的广泛适用性。
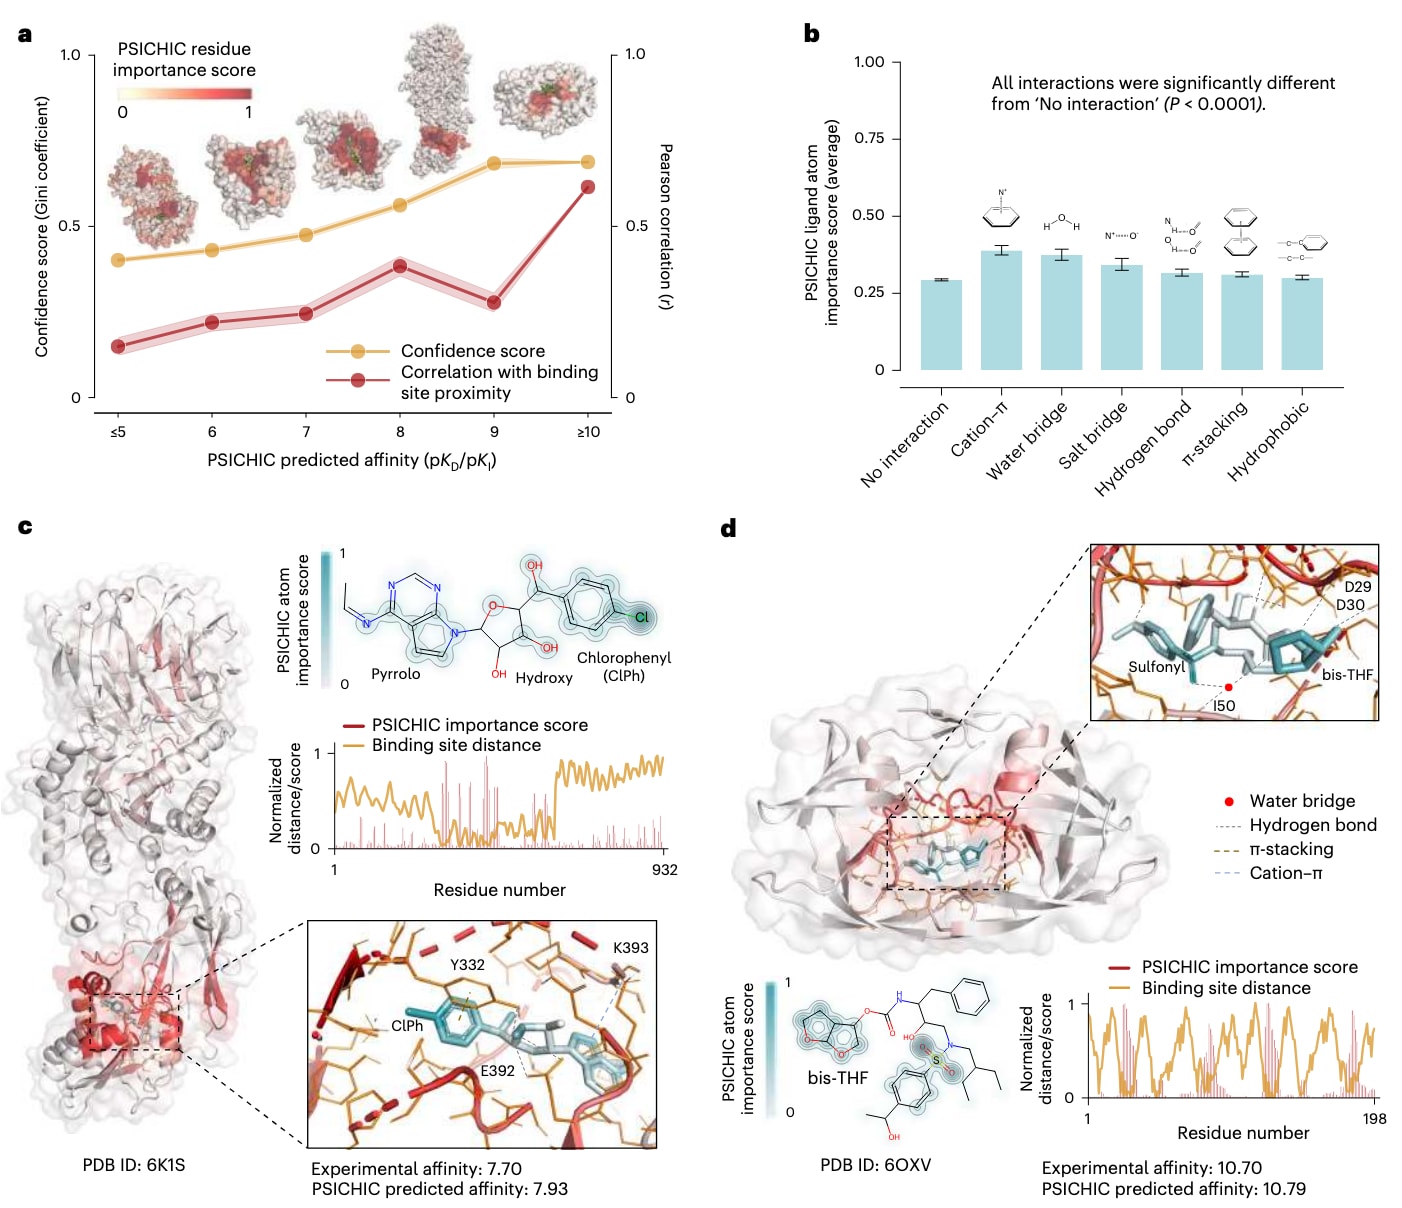
图3|相互作用指纹的可解释性。 a,折线图展示了基于 PSICHIC 预测结合亲和力的两组关系:(1)橙线表示结合亲和力(横轴)与残基重要性评分置信度(左纵轴)之间的关系,后者采用基尼系数(Gini coefficient)衡量;(2)红线表示结合亲和力(横轴)与 PSICHIC 残基重要性评分和残基距结合位点邻近程度之间相关性(右纵轴)的关系。阴影区域表示
2.5 相互作用指纹的可解释性
PSICHIC 究竟学习到了哪些信息?其推理过程是依赖于对训练样本的模式比较,还是已经捕获了决定蛋白质–配体结合的底层物理化学规律?为回答这些问题,在 PDBBind v2020 训练集上完成模型训练后,利用对应测试集中的序列数据获得 PSICHIC 的解释结果,并仅将共晶结构用于评估。
结果发现,当 PSICHIC 预测较高的结合亲和力时,模型会将更高的重要性评分集中赋予较少数目的特定蛋白质残基,这反映出模型对于哪些残基对结合最为关键具有更高置信度(图 3a,橙线)。进一步分析残基与结合位点之间的空间邻近程度和 PSICHIC 所赋予残基重要性评分之间的关系发现,这些高评分残基确实构成了真实结合位点,其证据在于残基重要性评分与结合位点邻近程度之间的相关性明显增强(图 3a,红线)。随着预测结合亲和力升高,重要性评分逐渐向结合位点集中,这一趋势符合物理化学原理:更强的结合亲和力意味着复合体系更有可能转变至稳定的低能状态。
为评估配体侧的可解释性,根据每个配体原子与结合位点残基形成的相互作用类型,对配体原子进行了标注。比较 PSICHIC 为这些原子分配的平均重要性评分后发现,参与相互作用的原子获得的评分显著高于未参与相互作用的原子(图 3b)。这一结果提示 PSICHIC 具有辅助药效团分析的潜力(扩展数据图 5),但其在前瞻性药效团筛选和设计中的实际有效性仍需进一步验证。
作为案例,进一步分析了两个高亲和力的蛋白质数据库(Protein Data Bank,PDB)复合物结构:6K1S 和 6OXV。对于 6K1S,即精氨酸 N-甲基转移酶 5 与抑制剂形成的复合物,PSICHIC 突出了结合位点中的关键残基,并识别出配体中的关键官能团,包括氯苯基、吡咯并基团和羟基,它们分别与 Y332、K393 和 E392 发生相互作用(图 3c)。在 HIV-1 蛋白酶–配体复合物 PDB 6OXV 中,PSICHIC 同样为结合位点残基赋予了较高权重(图 3d)。模型特别突出了配体中的双四氢呋喃基团,该结构特征对于规避耐药性具有重要作用;同时还识别出通过水分子桥联与 I50 相互作用的磺酰基。
这些结果支持该研究的核心假设,即通过引入物理化学约束,仅依赖序列数据即可直接解析并构建蛋白质–配体相互作用模式的指纹。当移除这些物理化学约束后,PSICHIC 无法再有效识别结合位点残基,这进一步支持了上述结论(扩展数据图 2e)。
PSICHIC 所表现出的、能够解析蛋白质–配体相互作用底层物理化学机制的涌现能力具有独特性。该能力完全通过仅包含序列数据和结合亲和力标签的训练获得,无需提供任何关于结合位点或残基–原子相互作用的信息。
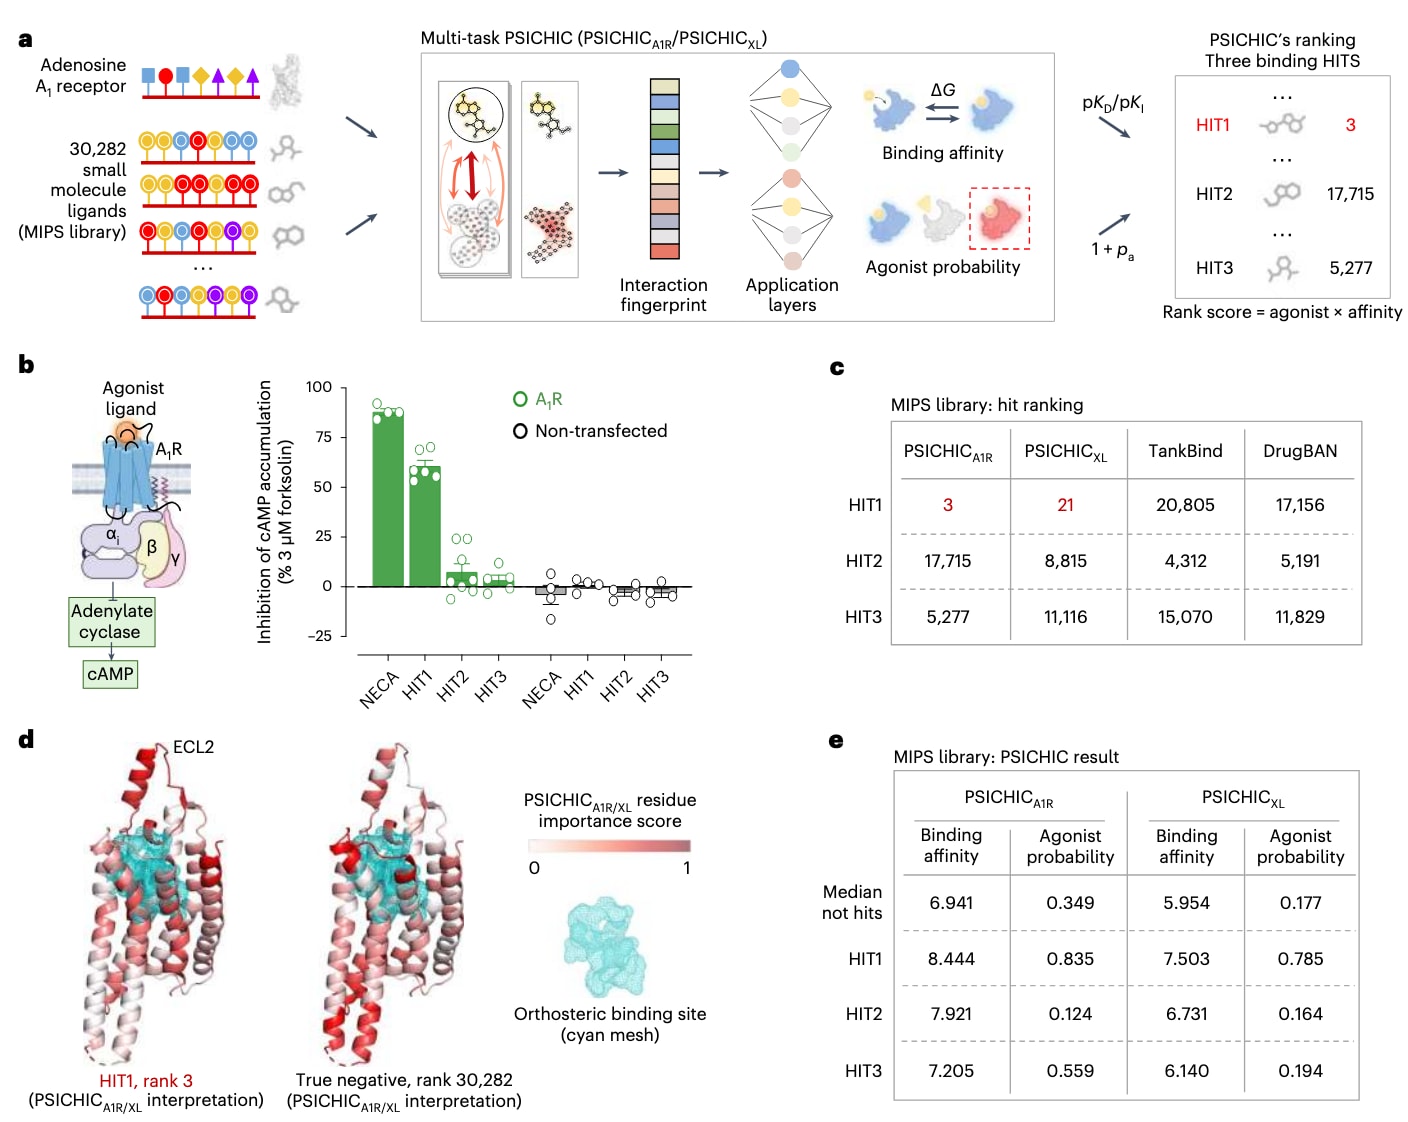
图4|利用相互作用指纹进行虚拟筛选。 a,基于 PSICHIC 对内部 MIPS 化合物库中的 30,282 个化合物进行计算筛选,以寻找潜在的 A1R 激动剂。构建了两个版本的 PSICHIC:PSICHICXL,适用于较广泛的蛋白质类型(扩展数据图 7);以及 PSICHICA1R,即在 A1R 相关数据上对 PSICHICXL 的应用层进一步微调得到的专用版本。化合物的评分与排序依据为结合亲和力(pKD/pKI)与
2.6 利用相互作用指纹进行虚拟筛选
在验证了 PSICHIC 的有效性和可解释性后,进一步将其用于虚拟筛选,以从莫纳什药物科学研究所(Monash Institute of Pharmaceutical Sciences,MIPS)内部包含 30,282 个化合物的化合物库中寻找新的 A1R 激动剂。A1R 是一种重要的 G 蛋白偶联受体(GPCR),与心血管疾病和神经系统疾病密切相关。该化合物库中的分子与已知 A1R 激动剂整体具有较低的结构相似性。
基于构建的大规模蛋白质–配体相互作用数据集,进一步开发了两个版本的模型:适用于广泛蛋白质靶点的 PSICHICXL,以及针对 A1R 专门优化的 PSICHICA1R。PSICHICXL 采用多任务和多样化采样优化策略在该数据集上训练,可在无需额外训练的情况下,对多种蛋白质直接预测结合亲和力和功能效应,并解释蛋白质–配体相互作用,因此能够直接应用于新的蛋白质–配体体系。在 PSICHICXL 的基础上,进一步利用大规模相互作用数据集中与 A1R 相关的数据进行微调,得到 PSICHICA1R。微调过程中,除应用层外,PSICHICXL 的其他参数均被冻结(图 4a),因此对于给定的蛋白质–配体对,两个模型所生成的相互作用指纹保持一致。
随后,利用 PSICHICXL 和 PSICHICA1R,根据预测的结合亲和力和激动剂类别概率对 MIPS 化合物库中的分子进行排序,并通过高通量筛选实验结果评估其排序效果。实验筛选分为两个阶段:首先通过高通量筛选鉴定能够与 A1R 结合的配体,随后对这些结合配体进行药理学表征,以评估其激活人 A1R 的能力。高通量筛选共发现 3 个能够与人 A1R 结合的配体,分别为 HIT1、HIT2 和 HIT3。其中,仅 HIT1 能够诱导与激动剂 5′-(N-乙基甲酰胺基)腺苷(5′-(N-ethylcarboxamido)adenosine,NECA)相当的
PSICHICA1R 的预测排序将唯一的激动剂 HIT1 排在第 3 位,即位于所有化合物的前
在解释 A1R–HIT1 相互作用时,具有相同骨干网络和相同可解释相互作用指纹的 PSICHICA1R 与 PSICHICXL,均优先突出 A1R 正构激动剂结合位点以及第二胞外环(extracellular loop 2,ECL2)中的残基(图 4d)。这些区域已知对激动剂结合和功能发挥具有关键作用。相比之下,PSICHICA1R 排名最低的配体所对应的残基重要性评分则分散在整个蛋白质范围内。
PSICHICA1R 与 PSICHICXL 对同一蛋白质–配体相互作用对具有完全一致的解释结果。微调仅作用于应用层,目的是提高模型针对特定蛋白质的排序能力(图 4c、e),不会改变 PSICHICXL 生成的相互作用指纹及其解释结果。
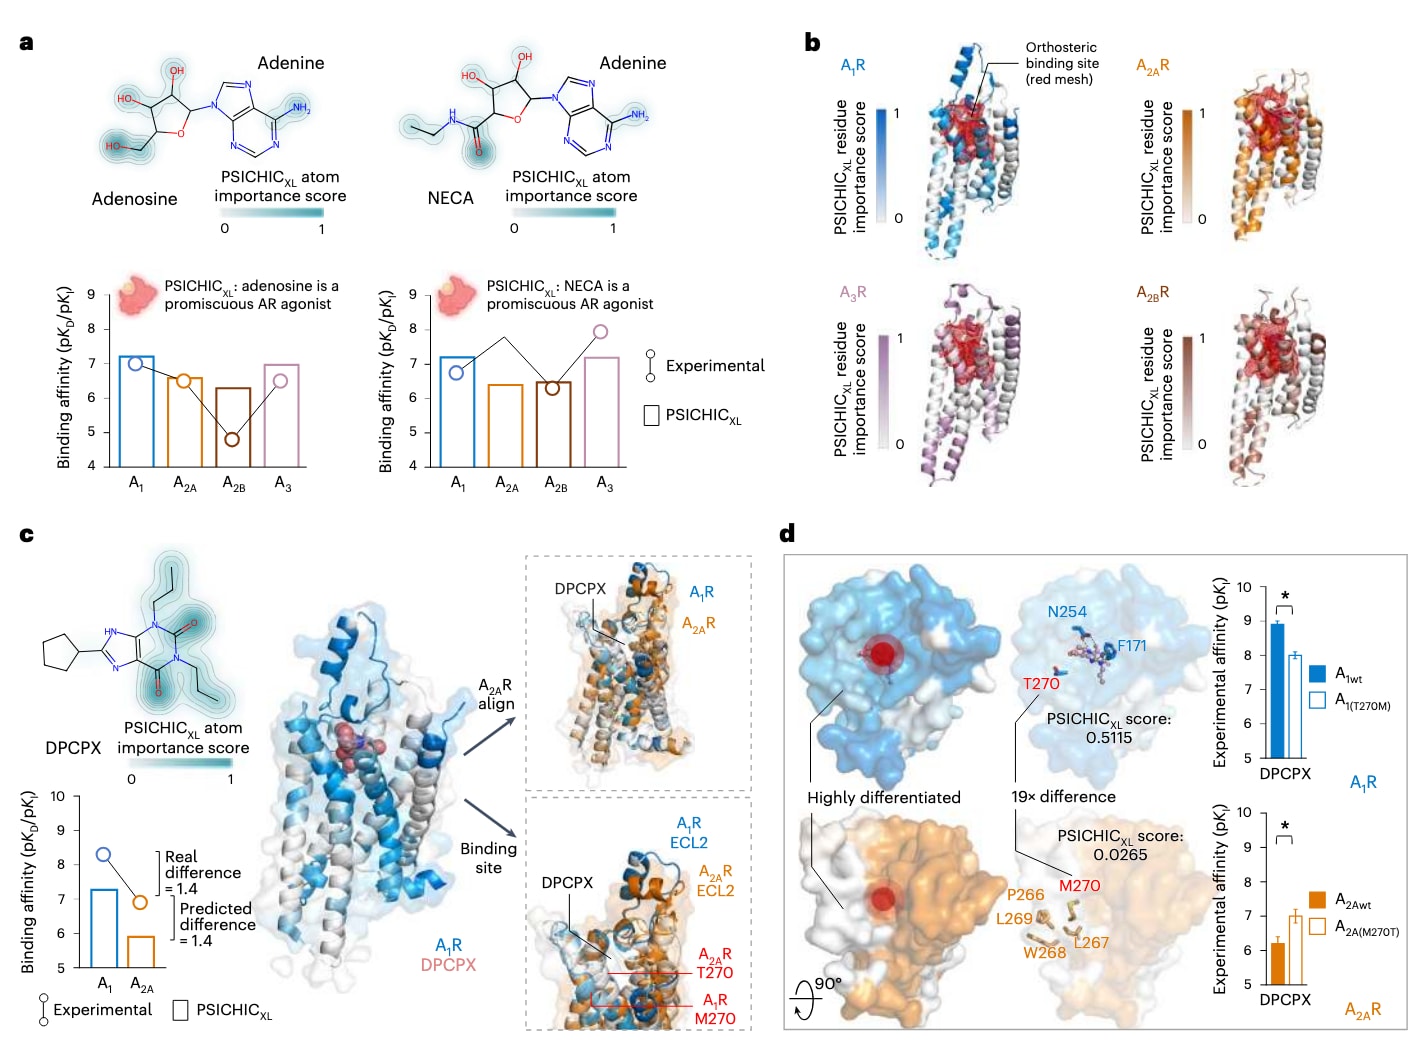
图5|利用相互作用指纹进行选择性分析。 a,腺苷受体(AR)与广谱激动剂腺苷和 NECA 相互作用的选择性分析。PSICHICXL 将原子重要性评分映射到腺苷和 NECA 上,并在不同 AR 亚型之间得到相似的解释结果。PSICHICXL 将腺苷和 NECA 识别为具有多亚型活性的 AR 激动剂。柱状图表示预测的结合亲和力,散点折线图表示来自 IUPHAR/BPS 数据库中间值的实验结果。b,在 AR–NECA 相互作用中,PSICHICXL 突出了不同 AR 亚型激动剂结合位点中的关键残基(红色网格)。用于可视化 PSICHICXL 重要性评分的结构信息见补充表 11。c,对相对于 A2AR 具有 A1R 选择性的配体 DPCPX 进行选择性分析。左上:PSICHICXL 在 DPCPX 上预测的原子重要性评分。左下:柱状图表示 PSICHICXL 预测的结合亲和力,散点折线图表示 IUPHAR/BPS 数据库中的实验亲和力。尽管 PSICHICXL 整体上存在低估结合亲和力的倾向,但仍能够准确区分 DPCPX 对 A1R 和 A2AR 的选择性。右侧:PSICHICXL 在 A1R 结构(PDB 5UEN,将 DPCPX 与 DU172 对齐)上的残基重要性评分主要集中在结合位点残基,对齐后的 A2AR 结构则显示出较高的亚型间一致性。d,对 A1R 和 A2AR 结合位点进行详细比较后,发现 5 个残基的 PSICHICXL 重要性评分存在明显差异,其中 A1R 的 T270 与 A2AR 的 M270 之间的重要性评分相差 19 倍,从而揭示了选择性产生的机制。柱状图数据来自此前的实验研究,以均值 ± s.e.m. 表示,展示了 DPCPX 在野生型 A1R 或 A2AR 与相应突变受体上的放射性配体竞争结合结果,其中第 270 位的“门控”残基在两个亚型之间进行了互换。与 PSICHIC 的预测一致,A1R-T270M 突变显著降低了 DPCPX 的结合亲和力,而反向的 A2AR-M270T 突变则显著提高了其结合亲和力(
2.7 利用相互作用指纹进行选择性分析
小分子配体通常具有多药理性(polypharmacology),能够与多个靶点结合。因此,在命中化合物鉴定之后进行选择性分析,对于保证药效并减少脱靶效应至关重要。对于 A1R 而言,这一点尤为重要,因为四种腺苷受体(adenosine receptor,AR)亚型——A1R、A2AR、A2BR 和 A3R——的正构结合位点高度保守,因此实现亚型选择性具有较大挑战。以 AR 不同亚型为案例,利用 PSICHICXL 的相互作用指纹预测配体在不同 AR 亚型之间的多靶性或选择性,并直接从序列数据解释其相互作用机制,以识别决定选择性的关键因素。
首先分析了两个经典的广谱激动剂——腺苷和 NECA——在不同 AR 亚型中的作用。PSICHICXL 能够准确预测二者对所有亚型的激动剂多靶性以及结合亲和力,预测值与实验结果高度一致,仅对 A2BR–NECA 相互作用的结合强度存在一定低估(图 5a)。与最初预期不同,PSICHICXL 赋予配体原子的高重要性评分并未集中在腺嘌呤基团上。这一结果与已有认识一致:许多腺嘌呤衍生物实际上是这些受体亚型的拮抗剂,例如 A1R 的 WRC-0571 和 A3R 的 MRS3777,因此其他官能团在区分激动剂和拮抗剂方面具有关键作用。在 AR–腺苷和 AR–NECA(图 5b)相互作用中,PSICHICXL 对蛋白质残基的重要性评分在不同亚型之间表现出较高一致性,主要突出结合位点残基。
随后分析了相对于 A2AR 对 A1R 具有选择性的配体 DPCPX(图 5c)。PSICHICXL 准确反映了 DPCPX 在 A1R 与 A2AR 之间约
由于 PSICHICXL 对 DPCPX 在两个受体亚型中的配体侧解释几乎完全相同,因此模型预测的 DPCPX 选择性很可能来源于两个亚型之间蛋白质残基解释的差异。基于这一判断,进一步重点分析了 PSICHICXL 认为对 A1R 重要、但对 A2AR 不重要的区域,将其视为潜在的选择性决定因素。值得注意的是,PSICHIC 对 A1R 结合位点中的残基以及 A2AR 结合位点中的大多数残基均赋予较高重要性评分(图 5c),但 A2AR 中有 5 个残基的重要性评分低于
在这 5 个残基中,M270 尤为值得关注,因为该位置在 A1R 和 A2AR 之间并不保守,A1R 对应为 T270,而 A2AR 对应为 M270。PSICHICXL 在该位点给出的显著重要性评分差异与此前实验研究结果一致。A1R 中的 T270 和 A2AR 中的 M270 可作为“门控残基”(gatekeeper),影响能够进入结合位点的配体类型,进而决定 DPCPX 的亚型选择性。已有实验数据进一步支持这一机制:A1R-T270M 突变会显著降低 DPCPX 的结合亲和力,而反向的 A2AR-M270T 突变则会显著增强其结合亲和力(图 5d)。
总体而言,结果表明 PSICHICXL 不仅可用于小分子药物发现,也有助于直接从序列数据深入理解蛋白质–配体相互作用。尽管该研究主要将其用于 A1R 相关小分子配体的虚拟筛选和选择性分析,但 PSICHICXL 在训练时覆盖了广泛的蛋白质靶点,因此可以直接用于多种靶点而无需额外训练(扩展数据图 7)。系统性的基准评估同样表明,PSICHIC 在多种蛋白质–配体相互作用性质预测中均取得了较好的结果,包括涉及新型蛋白质和新型配体的情况。尽管这些结果仍属于初步验证,但已展现出进一步拓展应用的潜力。基于这一应用前景,开发了一个用户友好且开源的 PSICHICXL 虚拟筛选与选择性分析平台,并集成 Google Colaboratory,以便直接通过网页使用。
3 讨论
蛋白质–配体相互作用指纹用于描述配体与蛋白质残基之间特定相互作用的特征。传统上,这类指纹通常从蛋白质–配体三维复合物结构中提取,但这一过程成本较高,并且结果容易受到结构分辨率质量的影响。相比之下,PSICHIC 仅依赖序列数据,为获得具有可解释性的相互作用指纹提供了一种不同的途径。通过引入物理化学约束,PSICHIC 展现出涌现能力,能够揭示蛋白质–配体相互作用机制,并有效预测相关相互作用性质。该方法无需三维结构数据,也为在大规模序列数据库上进行稳健学习提供了基础。
作为概念验证,PSICHIC 已被证明能够有效开展候选药物筛选和选择性分析。由于运行时仅需要序列数据,PSICHIC 有望成为药物发现中的通用工具。其可解释相互作用指纹未来还可进一步应用于从头配体设计(de novo ligand design),用于指导和优化分子结构。
目前,PSICHIC 仅能分析单个蛋白质与配体之间的相互作用。未来可进一步扩展至蛋白质复合物,例如与异源三聚体 G 蛋白形成复合物的 GPCR,从而有望直接基于序列数据更加全面地研究蛋白质–配体动态相互作用。此外,PSICHIC 在序列数据上的稳健学习能力,也为研究更加复杂的相互作用机制提供了可能,例如变构调节,从而帮助理解变构配体如何调控同一蛋白质靶点中的正构配体作用。
相关数据、代码及优化后的模型均已向科研社区开放。凭借在多种应用场景中表现出的稳健性和有效性,PSICHIC 展现出进一步发展的潜力,并有望推动虚拟化合物筛选以及新型小分子药物设计的发展。