JC 2026|利用力场引导改进蛋白质-配体复合物生成
获取详情及资源:
- 📄 论文: https://doi.org/10.1186/s13321-026-01198-2
- 💻 代码: https://github.com/wangxiaoyunNV/NV-AZ-DrugDiscovery
0 引言
近年来,基于扩散模型和流匹配的生成模型逐渐应用于基于结构的药物设计,但其生成的蛋白质–配体复合物中仍经常出现不符合物理规律的不合理相互作用。针对这一问题,该研究提出了一种能量引导框架,将分子力学力场 MMFF94 直接引入采样过程,在无需重新训练基础生成模型的情况下,引导分子生成向物理上更加合理、能量上更加稳定的构象演化。
该方法分别基于两种先进的生成架构进行了评估,包括流匹配模型 SemlaFlow 和扩散模型 EDM,并在 PDBBind 数据集上开展测试。结果表明,能量引导在两类模型中均能有效改善蛋白质–配体之间的焓相互作用能,并使配体应变能最多降低 75%。此外,该方法生成了超过 1000 个对接评分优于天然配体的候选分子。
这些结果表明,轻量级的物理引导机制能够在保持分子化学有效性和结构多样性的同时,显著提高生成式药物设计模型所生成复合物的物理合理性与结合质量。
科学贡献
该研究提出了一种无需额外训练的力场引导框架,在扩散模型或流匹配模型的采样过程中,利用 MMFF94 等经验分子力学力场直接引导配体生成,而无需修改或重新训练 EDM、SemlaFlow 等基础生成模型。该方法作为推理阶段的外挂式模块,通过势能反馈调整生成轨迹,从而得到应变能更低、与蛋白质具有更优预测相互作用的配体构象。
主要贡献包括:
- 无需重新训练的能量引导机制。 与依赖神经网络亲和力预测器梯度进行引导的方法不同,该方法直接在后验采样过程中引入经典分子力场 MMFF94 的能量反馈,从物理层面对生成轨迹进行校正。
- 改善对接性能与配体应变能。 与未采用引导的 EDM 和 SemlaFlow 相比,引入力场引导后生成结构的 AutoDock Vina 对接评分整体更优,同时配体应变能明显降低。即使最终结构统一采用相同的力场进行能量优化,这一优势仍然能够保持。
- 较强的兼容性与扩展性。 由于能量引导模块独立于基础生成模型,因此无需修改模型架构或重新训练,即可应用于不同类型的生成模型。同时,该框架并不局限于 MMFF94,也可以扩展至其他任意可微的势能函数。
- 对引导稳定性的理论解释。 理论分析表明,在常见的光滑性假设下,基于能量梯度的校正步骤本质上对应于沿势能下降方向进行更新。尽管完整采样过程还受到生成模型本身的预测项影响,并且扩散模型中还包含随机扰动,但能量引导项能够在局部持续将采样轨迹推向更低能量区域,从而为其改善生成稳定性和物理合理性的作用提供理论依据。
1 引言
基于结构的药物设计(structure-based drug design,SBDD)是现代药物发现中的重要方法,其核心是依据实验解析或计算预测得到的靶蛋白三维结构,设计并优化能够与特定受体结合位点形成有利焓相互作用的配体分子。借助靶蛋白的三维结构信息,SBDD 可以更加理性地设计与靶点紧密结合的化合物,例如通过与关键氨基酸残基形成氢键等特异性相互作用,或占据疏水口袋并置换其中能量不利的水分子,从而增强配体与靶蛋白之间的结合。
传统的 SBDD 主要依赖分子对接。此类方法通常基于物理模型,将给定配体放置到相对于静态靶蛋白结构最有利的结合位置,并综合考虑各种有利的特异性相互作用来预测其潜在结合强度。理想情况下,对接过程还需要同时考虑配体为适应特定结合构象而产生的构象应变。为实现这一目标,传统对接程序通常引入力场,即经过参数化的原子体系势能函数,用于估算蛋白质–配体之间的相互作用能以及配体自身的应变能。
近年来,扩散模型和流匹配模型推动了“三维生成方法”的快速发展,使机器学习模型不仅能够直接生成蛋白质–配体结合构象,还可以在给定靶蛋白结构的条件下,以完全数据驱动的方式直接设计潜在结合分子。相比单纯预测结合姿态,后一类方法尤其具有吸引力,因为模型有望直接生成与特定靶点结构互补的配体,从而减少额外的配体搜索过程,也无需再从数以百万计的候选化合物中逐一筛选潜在结合分子。
然而,已有多项研究发现,这类生成模型得到的结构往往难以通过最基本的物理合理性检验。例如,生成结构可能包含现实中难以实现的键长和键角,无法与靶蛋白形成具有实际意义的相互作用,或者呈现出明显不合理的高应变构象。尽管近年来相关生成模型已经取得一定改进,但为了获得物理上更加合理的几何结构,目前仍普遍需要在生成完成后,使用经典力场对模型提出的结构进行进一步能量最小化。
2 相关工作
2.1 引导式扩散模型与流匹配模型
近年来,扩散模型和流匹配模型受到广泛关注,并在文本生成图像、自然语言处理以及面向药物发现的分子设计等多个领域展现出强大的生成能力。最初的扩散模型和流匹配模型仅支持无条件生成,但近年来逐渐发展出多种引导机制,使生成过程能够朝着预期目标进行调控。其中,两种基础方法分别是分类器引导扩散(classifier-guided diffusion)和无分类器引导扩散(classifier-free guided diffusion)。
在分类器引导扩散中,需要单独训练一个外部分类器,根据给定样本预测其目标类别。在推理过程中,每个扩散步骤都会计算分类器输出相对于当前样本的梯度,并将其加入模型预测的噪声估计中。相比之下,无分类器引导不需要额外的分类器,而是在训练阶段同时利用有条件和无条件数据训练扩散模型。在推理阶段,通过对有条件和无条件噪声预测结果进行加权组合实现引导,并利用缩放系数控制条件信息的作用强度,从而无需依赖外部模型即可灵活调节生成过程。
上述两类方法主要针对类别条件设计,其中无分类器引导还可以支持文本嵌入。然而,在该研究所关注的场景中,条件变量具有连续属性,例如分子力场,因此上述方法并不能直接满足需求。另一类研究将条件引导扩展至连续变量,通过训练模型直接学习条件概率密度的对数梯度:
其中,
另一种方法采用强化学习范式,将扩散模型的迭代去噪过程重新表述为一个多步马尔可夫决策过程(Markov Decision Process,MDP)。在这一框架下,可以利用策略梯度方法优化采样轨迹,使生成样本最大化特定任务对应的奖励,例如基于人类反馈定义的奖励。
尽管上述两种方法都能够支持连续条件变量,但针对每一种新的条件输入,通常仍需要重新训练扩散模型。这一局限在基于结构的药物设计(SBDD)中尤为突出,因为同一项目的不同研发阶段,或者不同项目之间,都可能采用不同的条件输入。如果每一种新应用都需要重新训练模型,不仅耗时,而且会带来较高的计算成本。
与分子生成领域的发展趋势类似,近年来蛋白质构象生成研究也越来越多地在训练和采样过程中引入引导与条件信息。其中,一项代表性工作采用两阶段学习策略,使扩散过程不仅趋近于数据分布,还进一步趋向于满足物理规律的分布,尤其是描述物理体系平衡状态的玻尔兹曼分布。
在第一阶段,首先采用无分类器引导训练基础扩散模型,并将 ESMFold 预计算得到的序列表征作为条件得分模型的条件变量。在第二阶段,利用已经训练好的扩散模型计算中间作用力,并进一步利用这些作用力训练一个中间力网络。在推理阶段,该力网络会在每一个扩散步骤中计算力向量,并利用这些力向量引导蛋白质构象平移分量的更新。
与前述方法类似,当引入不同的引导目标时,这一框架仍需要重新训练并重新构建引导网络。在快速迭代的基于结构的药物设计场景中,经常需要迅速调整引导参数,或者加入新的、具有特定领域特征的物理约束。尽管该框架创新性地将基于分子动力学的能量引导机制纳入生成过程,并具有较强的性能,但在需要高效探索多种物理引导目标时,其作为“即插即用”方案的灵活性仍然有限。
另一类相关工作以 RFdiffusion 为代表,其采用了更加全面的条件生成框架,可以支持多种不同类型的约束,包括对称性指定、基序支架设计、结合靶标相互作用以及拓扑约束设计。
对于对称性约束,可以在推理阶段直接施加条件:首先利用对称操作对初始随机坐标框架进行变换,随后在整个去噪轨迹中,每一步都显式地对结构重新进行对称化处理,从而始终保持目标对称性。相比之下,其余几类条件主要在训练阶段引入。
在基序支架设计中,训练过程中通过掩蔽基序使其保持固定,推理时再直接输入这些基序的三维坐标,以引导支架结构的生成。而针对结合靶标相互作用和拓扑约束设计,则需要在专门的数据集上对模型进行微调,例如使用靶蛋白–复合物结构数据,或者采用用于描述目标蛋白折叠方式的块邻接表示。
尽管 RFdiffusion 支持较为全面的条件类型,并且部分条件能够在推理阶段直接注入,但其条件机制与模型学习得到的内部表示及网络架构深度耦合。因此,这一框架与该研究提出的引导范式仍存在本质区别:后者将引导目标设计为即插即用的模块化评分函数,并从模型外部直接调控采样过程。
与该研究提出的引导范式较为接近的是 ExEnDiff。该方法同样试图在保持原有训练流程不变的情况下,在采样阶段引入额外的引导信息。具体而言,该方法利用流形约束采样技术,根据生成构象计算一系列实验测量指标。在推理阶段,通过数值近似计算给定含噪样本时测量值对数似然的梯度,并由此构建一个校正势能项,将其加入原始得分函数中。借助这种方式,可以灵活整合不同类型的连续引导信息,而无需重新训练扩散模型。
需要指出的是,ExEnDiff 的现有形式建立在扩散模型框架之上,并与得分函数紧密耦合。流匹配模型则并不显式学习得分函数,而是学习定义从源分布到目标分布概率路径的向量场。因此,ExEnDiff 所采用的框架无法像该研究提出的方法一样,直接应用于流匹配模型。
后续将首先介绍具体的分子生成任务,以及该研究采用的条件信息形式,即可微分的分子力场描述符。在此基础上,将进一步介绍一种由分类器引导扩散方法改进而来的引导框架,使可微分的条件信号能够在采样过程中灵活加入,同时无需重新训练基础扩散模型或相应的描述符。
2.2 分子力场
分子力场(molecular force field)是一组用于描述原子体系势能的数学函数及其参数,可以根据体系中各原子的位置估算其势能。力场是分子力学(molecular mechanics,MM)和分子动力学(molecular dynamics,MD)模拟等方法的核心组成部分。经过长期发展,目前已经形成了多种适用于不同应用场景的力场,其中较具代表性的包括 AMBER、CHARMM、MMFF94 和 UFF。
AMBER 和 CHARMM 主要面向蛋白质、多肽以及蛋白质–配体相互作用等大型生物分子体系,通常具有较高的计算精度,但由于参数体系更加复杂,其计算成本也相对较高。对于该研究提出的引导框架而言,这会成为一个重要瓶颈,因为在整个去噪过程中需要反复进行力场能量计算。
相比之下,MMFF94 和 UFF 主要针对小分子及类药分子进行设计,计算速度更快。其中,UFF 的参数化较为通用,但相应地精度也相对较低;MMFF94 则在计算速度与准确性之间取得了更好的平衡,不过传统的 MMFF94 主要用于描述配体分子内部的相互作用。
因此,该研究选择 MMFF94 作为基础力场,并进一步将蛋白质结合口袋作为条件信息扩展到 MMFF94 中,使其能够描述蛋白质–配体相互作用。同时,该研究实现了基于 GPU 的力场计算,使相互作用能的计算既能够高效执行,又保持可微分性,从而适合直接整合到扩散模型和流匹配模型的采样过程中。
3 方法
该节介绍一种利用化学物理评分引导流匹配模型和扩散模型进行分子采样的方法,其中具体采用 MMFF94 分子力场作为引导信号。该方法无需对预训练扩散模型进行任何微调,而是完全作用于推理阶段,因此能够在不影响原有生成模型通用性的前提下,灵活引入特定领域的物理化学知识。
设分子空间为
其中,
对于每个节点
其中,
对于每条边
其表示原子
除小分子外,蛋白质及其结合口袋采用相对简化的表示方式。与小分子不同,蛋白质通常以 PDB 文件形式提供,其中往往不显式包含完整的化学键信息,因此需要进一步推断。设蛋白质空间为
需要说明的是,该研究不进一步区分完整蛋白质空间与蛋白质口袋空间,因为蛋白质口袋本质上可以视为原始蛋白质中一部分原子构成的子集。
3.1 条件流匹配
条件流匹配(conditional flow matching)是一类生成建模框架,通过常微分方程(ordinary differential equation,ODE)直接学习从噪声分布到真实数据分布的连续时间传输过程。
条件流匹配定义一个随时间变化的条件概率分布:
其中,
对于连续变量,一种常见的
并采用恒定的标准差。
基于这一条件分布,可以解析地得到相应的条件向量场:
该向量场利用参数为
并通过训练使其重构上述目标向量场。
除了直接训练模型预测
因此,只要模型能够根据当前的
为了生成能够与特定蛋白质靶点结合的分子,需要进一步将蛋白质口袋
其中,
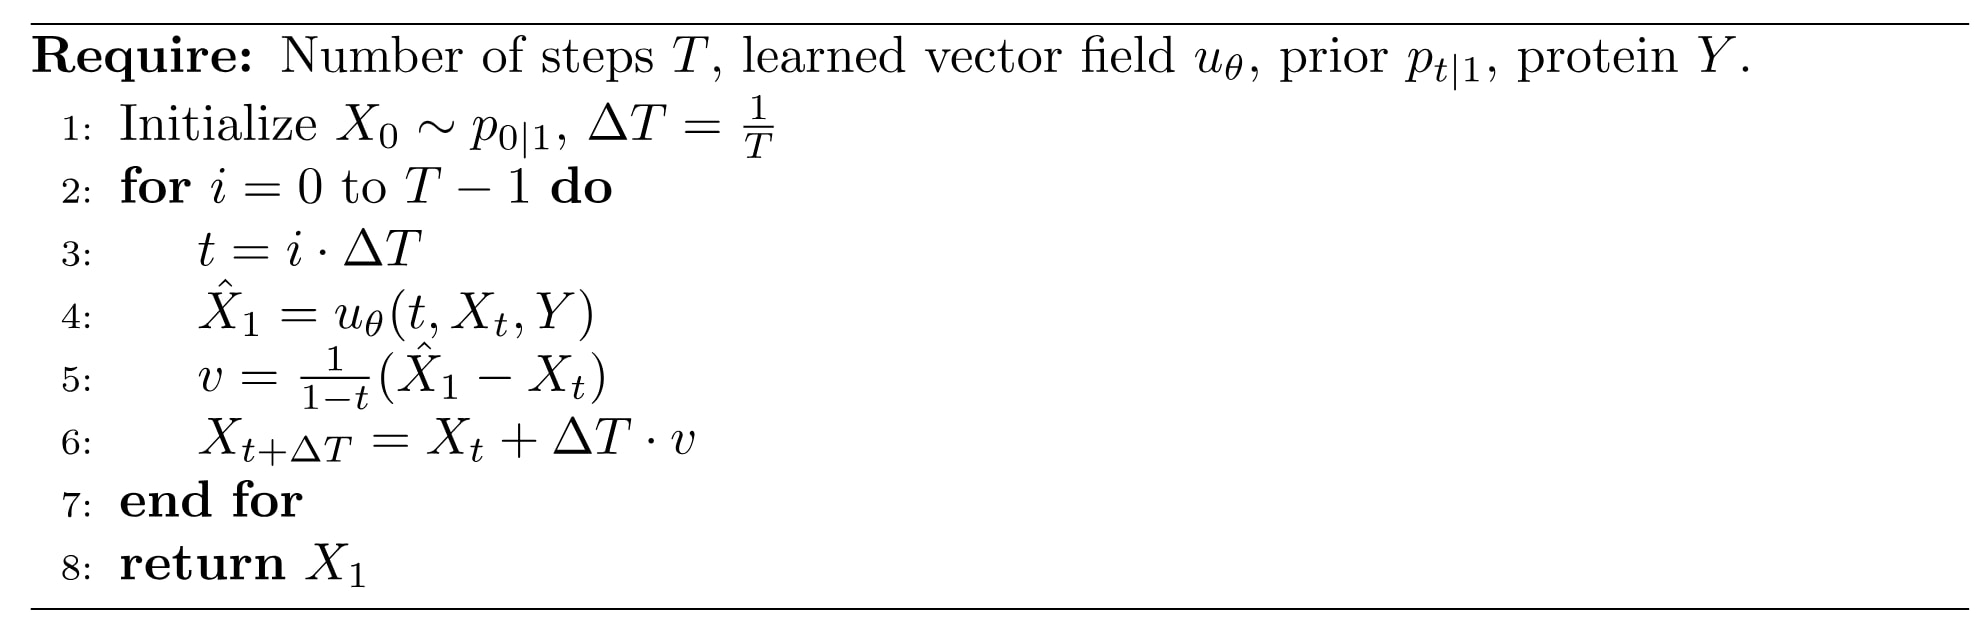
在生成新的分子样本时,通过标准 ODE 求解器对模型预测的向量场
该研究以 SemlaFlow 作为基础生成架构,并进一步扩展其模型,使其能够以蛋白质口袋作为条件进行分子生成。具体的蛋白质条件建模方式将在后续“蛋白质条件”部分进行介绍。
算法 1 | 条件流匹配采样
3.2 扩散模型
除条件流匹配模型外,扩散模型也是一类重要的生成模型。其基本思想是学习逆转一个不断向数据中加入噪声的过程,从而实现对复杂数据分布的采样。
为保证全文表述清晰并与流匹配模型的符号体系保持一致,该研究对扩散模型中常用的时间步记号进行了重新定义,引入重标记函数:
其中,
表示干净样本,而
表示最终含噪样本。采用这种记号主要是为了与“方法”部分介绍的流匹配模型保持统一,从而便于在同一框架下描述两类生成方法。
扩散模型主要包含前向过程和反向过程两个阶段。
在前向过程中,从真实数据分布中采样得到的样本会逐步加入噪声,最终被映射到一个简单且已知的先验分布
形式上,对于一个数据样本
其中,
当
反向过程则由参数为
该研究采用最后一种参数化方式,即建模:
选择这种形式的主要原因是,在每个采样步骤中都可以直接利用模型当前预测的原始结构计算分子能量,从而便于引入力场能量进行引导。
进一步地,为实现以蛋白质结构为条件的分子生成,将蛋白质
该研究采用 EDM 作为扩散模型的基础架构,并进一步扩展其结构,使其能够以蛋白质口袋作为条件。具体实现将在“蛋白质条件”部分介绍。
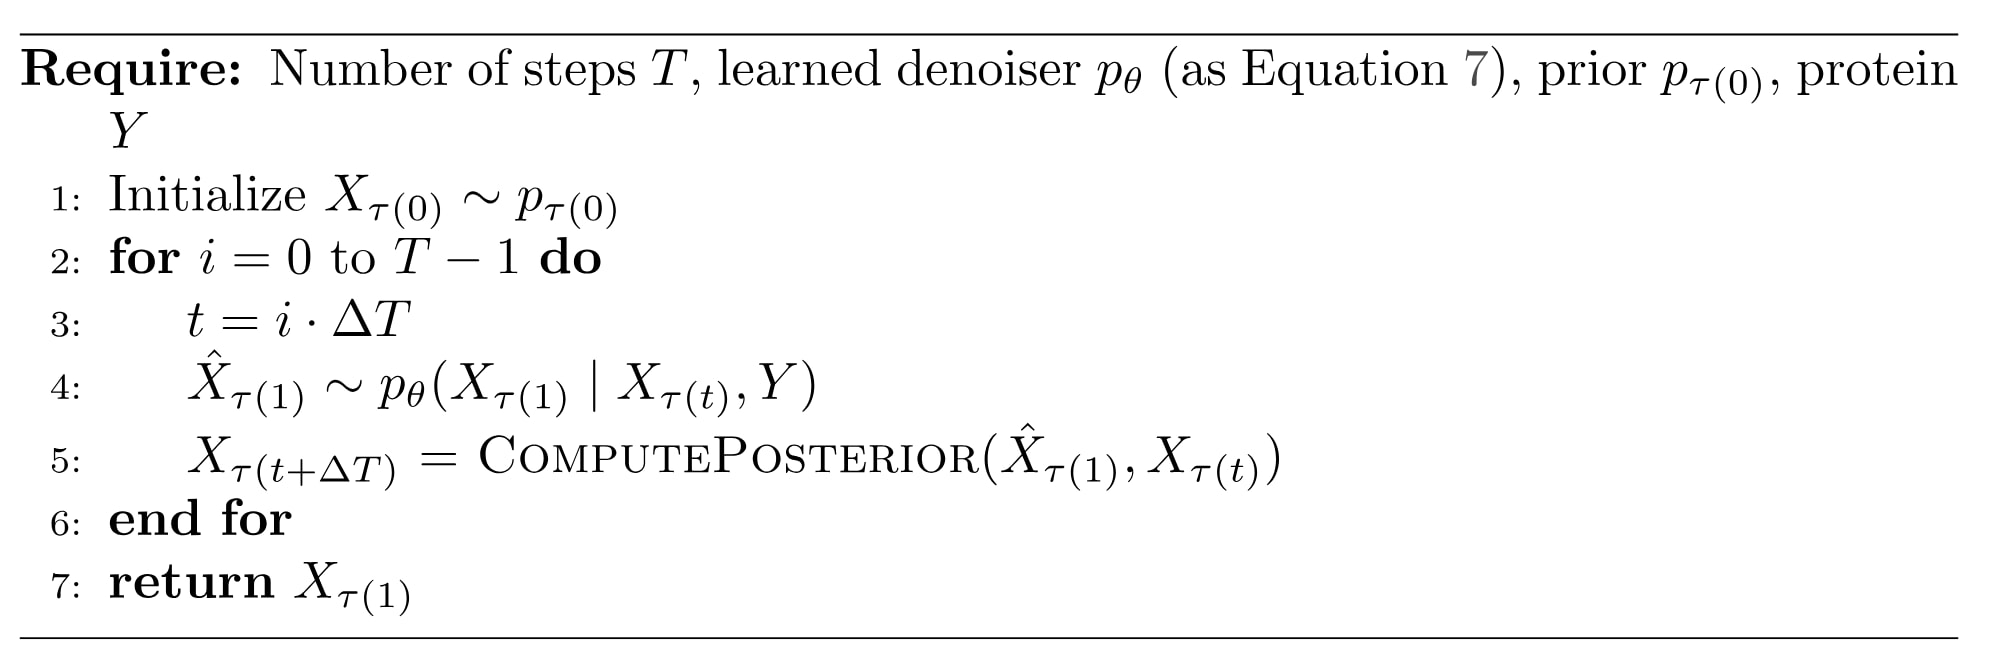
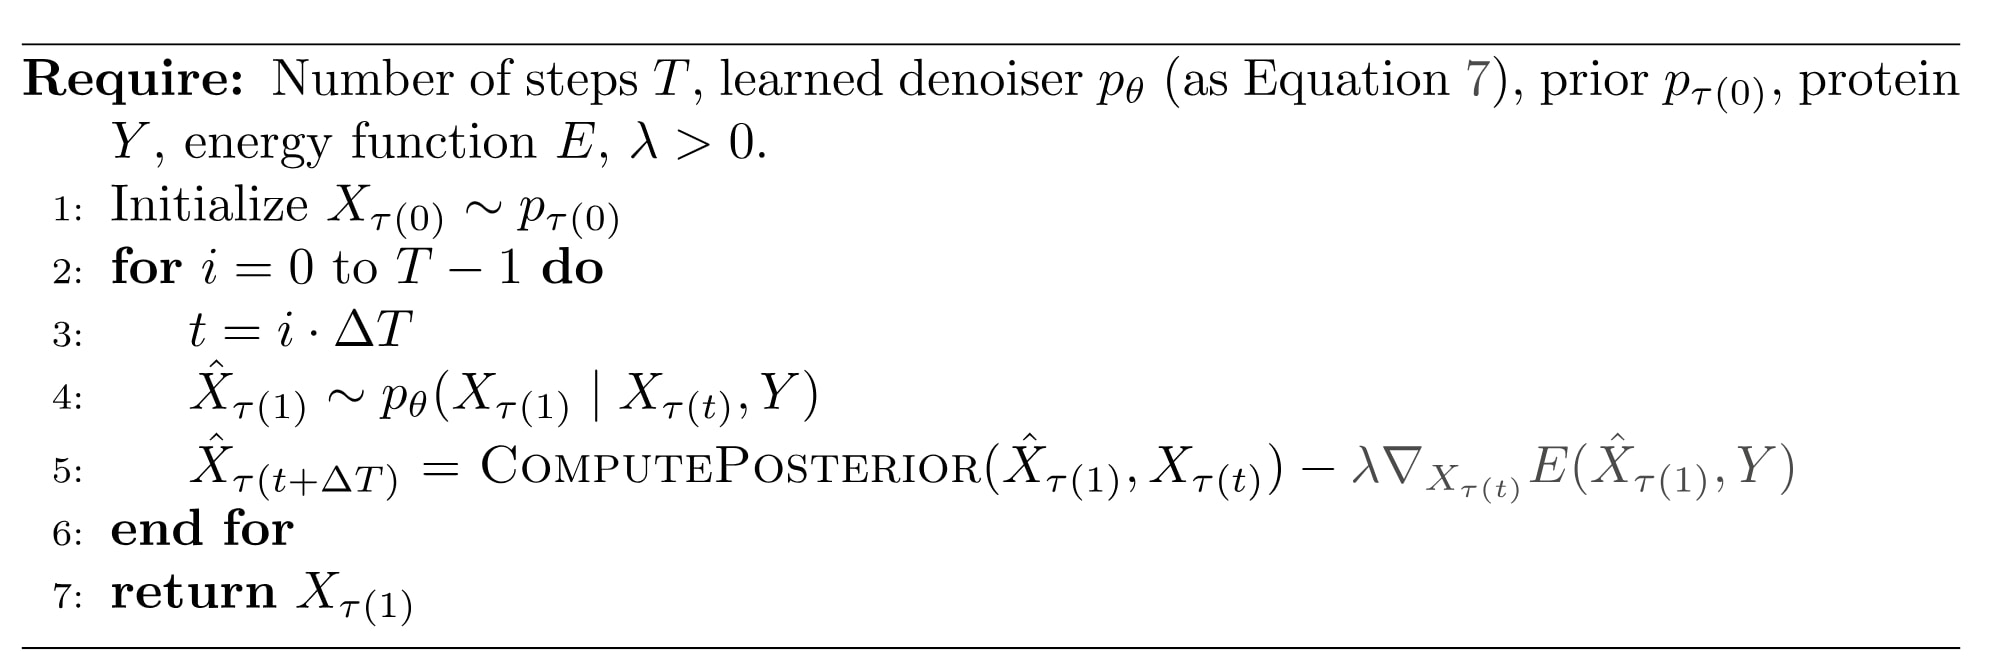
相应的采样流程见算法 2。其中,ComputePosterior 根据当前预测得到的
ComputePosterior 的具体计算方式见附录 A。
算法 2 | 扩散模型采样
3.3 蛋白质条件建模
对于扩散模型和流匹配模型,该研究分别采用 SemlaFlow 和等变扩散模型(Equivariant Diffusion Model,EDM)作为基础架构,并在此基础上进行扩展,使模型能够以蛋白质结构作为条件。本节主要介绍为实现蛋白质条件建模而引入的关键架构调整,重点关注模型层中的改动。
设有两个张量:
其维度分别为
蛋白质条件信息被引入注意力层,其核心更新形式可以表示为:
其中,前一求和项描述配体内部不同原子之间的信息交互;后一求和项则是该研究新增的蛋白质条件项,用于显式建模配体原子与蛋白质原子之间的相互作用。
函数
3.4 能量引导
在分子生成任务中,扩散模型和流匹配模型都可用于学习分子图或三维分子结构的分布。然而,这类模型通常主要基于数据似然目标进行训练,因此可能无法充分考虑决定分子稳定性的关键物理和化学性质。针对这一问题,该研究在推理过程中引入化学物理评分 MMFF94,通过能量信息对生成过程进行引导,使生成结果更倾向于物理合理且能量更有利的分子构象。
进一步地,该研究对 MMFF94 中的两个非键相互作用项进行了扩展,即范德华相互作用和静电相互作用,使其能够显式考虑作为生成条件的蛋白质结构。扩展后的 MMFF94 可表示为一个将蛋白质和配体映射为实数能量值的函数:
其定义为:
其中,
原子类型由 RDKit 根据 MMFF94 的参数化方案自动分配,并不会针对具体蛋白质环境重新推断。尽管 MMFF94 本身并不是专门面向蛋白质体系设计的力场,但该研究将截取后的蛋白质结构作为一个独立模型体系进行处理。输入结构的电荷不会被额外修改,其中蛋白质原子电荷由 Schrödinger PrepWizard 预先分配,并在蛋白质结构截取过程中保持不变。
在能量计算过程中不设置额外截断距离。整体实现本质上是对 MMFF94 的重新实现,并利用 PyTorch 完成基于梯度的优化。除梯度归一化外,不再引入其他形式的正则化。配体内部能量项
随后,能量函数
理论分析表明,若
其中,
需要注意的是,在完整采样过程中,该能量校正项还会与生成模型自身预测的更新共同作用,而在扩散模型中还包含随机噪声,因此并不能保证每一个采样步骤的总能量都严格下降。不过,能量引导项能够持续使采样更新偏向更低能量的构象区域,从而提高生成结构的物理合理性与稳定性。
算法 3|带能量引导的条件流匹配采样
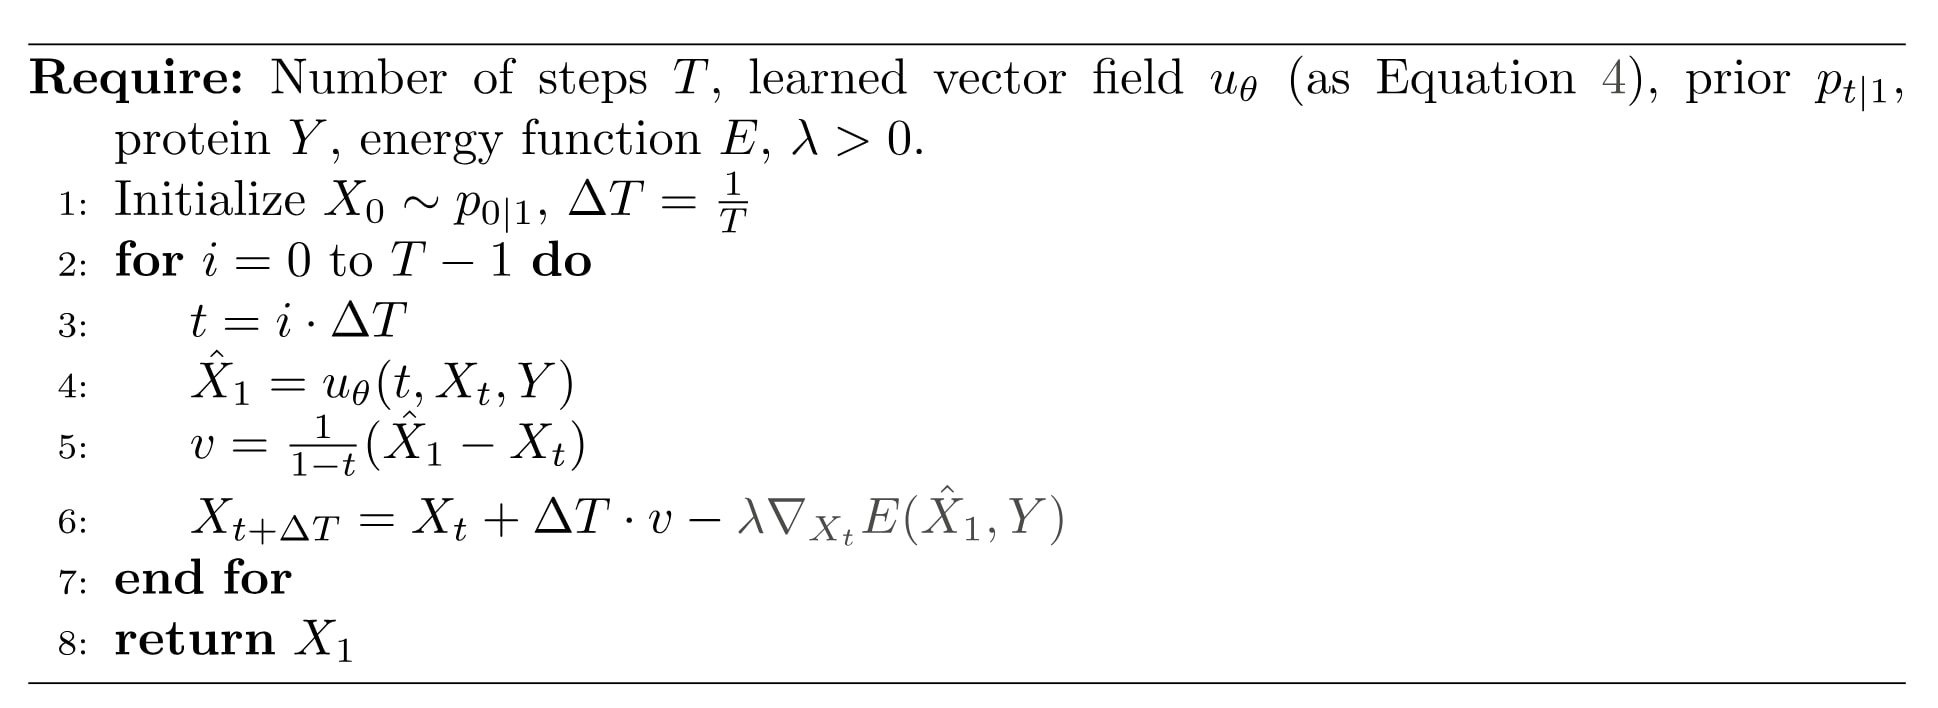
算法 4|带能量引导的扩散模型采样
4 实验
4.1 数据集
该研究采用 PDBBind 作为基准数据集,用于评估生成配体与蛋白质结合的质量。PDBBind 共包含 19,443 个蛋白质–配体复合物。从中选取 144 个复合物构建测试集,这些测试样本中的受体与训练集不存在重叠,其划分方式与 DiffDock 所采用的测试集完全一致,即 DiffDock 代码仓库中的 timesplit_test_no_rec_overlap。
尽管围绕 DiffDock 所采用测试集的选择存在一定争议,但该研究的目标并非分子对接,而是在蛋白质结合口袋中生成新的分子,因此这一测试集仍能够满足相应的评估需求。
数据预处理主要通过 Schrödinger 软件套件完成。首先,根据配体原子与蛋白质原子之间的距离,确定与每个配体对应的蛋白质结构。随后,利用 Schrödinger 的 PrepWizard 对蛋白质和配体进行预处理,包括修正几何结构以及分配合理的质子化状态。
结构预处理完成后,进一步使用 Glide 重新计算对接评分。只有能够顺利完成整个预处理流程,并且 Glide 评分为负值的蛋白质–配体复合物才会被保留,否则予以剔除。最终得到的训练集包含 18,990 个蛋白质–配体复合物,测试集包含 140 个复合物。
尽管 Schrödinger Glide 属于商业软件,该研究仍公开了复现实验数据预处理流程所需的代码,但实际运行仍需要有效的 Schrödinger 软件许可证。
对于每个蛋白质,进一步提取其结合口袋。具体而言,选择所有满足以下条件的残基:至少有一个原子距离天然配体不超过
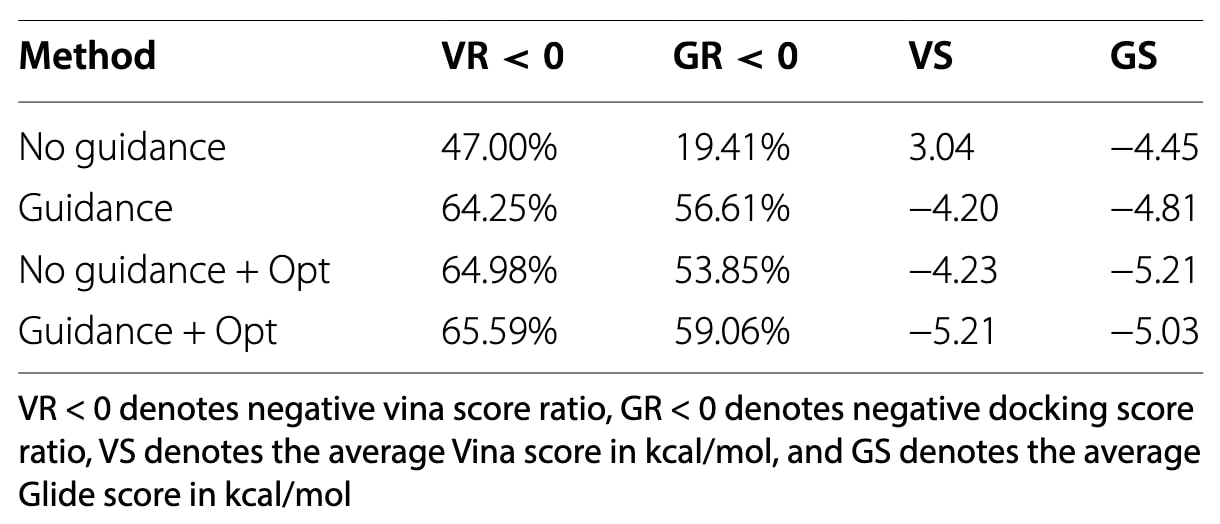
表 1|SemlaFlow 的 Vina 和 Glide 对接评分评估
4.2 实验设置
该研究采用两种先进的分子生成模型评估能量引导方法:基于流匹配的生成模型 SemlaFlow,以及等变扩散模型 EDM。
两种模型首先在 GeomDrugs 数据集上进行预训练。该数据集包含约 3,700 万个分子构象,覆盖超过 45 万种不同的小分子。需要指出的是,GeomDrugs 中并不包含蛋白质结构。预训练阶段采用各模型原始论文中报告的默认超参数设置。
完成预训练后,进一步使用 PDBBind 数据集中的蛋白质–配体复合物对模型进行微调,并采用前述数据集部分介绍的蛋白质–配体表示方式。在测试集中,共包含 140 个蛋白质结合口袋。针对每个蛋白质口袋,每种模型分别生成 128 个候选配体。
为了全面评估生成配体的质量,采用了一系列评价指标,涵盖结合相互作用、化学有效性、类药性、分子间相互作用以及构象应变等多个方面:
- Glide Score: 使用 Schrödinger Glide 计算的预测结合评分。Glide 是一种广泛使用的商业分子对接软件,其评分函数综合了基于物理的分子力学项和经验项,包括范德华相互作用、静电作用、配体应变、疏水包埋、氢键、去溶剂化效应以及其他来源于力场的贡献。该评分函数兼顾计算效率与预测准确性,因此广泛用于高通量虚拟筛选和先导化合物优化。
- Vina Score: 一种开源的蛋白质–配体结合评分方法。AutoDock Vina 使用经验评分函数,根据空间互补性、氢键、疏水相互作用以及扭转自由度惩罚等因素估算配体与蛋白质之间的结合能力。尽管其能量模型相比 Glide 更为简化,但 Vina Score 仍是分子对接研究中常用的标准评价指标。
- QED(Quantitative Estimate of Drug-likeness,定量类药性评估): 取值范围为 0–1 的标量指标,用于衡量分子的类药性,数值越高通常表示分子性质越接近已知药物。QED 综合考虑多种与口服药物相关的理化性质,包括分子量、脂溶性
、氢键供体和受体数量、极性表面积、可旋转键数量、结构警示片段以及芳香环数量等。 - PoseBuster Ratio(PBR): 生成配体通过全部 PoseBuster 质量检查的比例,可用于衡量生成结构在几何和化学层面的合理性。
- Better-Than-Native Count(BNC): 对接评分优于对应天然配体的生成配体数量。其中,“优于”表示具有更低的对接评分。
- Validity: 生成分子中同时满足语法正确和化学可解释要求的比例。具体通过 RDKit 等化学信息学工具进行评估,要求生成结果能够被成功解析为分子图,并能够正常初始化相应的力场对象,例如 MMFF94。
- 相互作用数量(Number of Interactions): 生成配体与蛋白质之间形成的氢键数量,使用 ProLIF 工具进行计算。
- 应变能(Strain Energy): 定义为生成配体构象与其经过 MMFF94 优化后的几何构象之间的能量差,并按照重原子数进行归一化。应变能越低,通常表明生成的分子构象越符合物理规律,在能量上也更加合理。
需要指出的是,性能评估在两种设置下分别进行:第一种直接使用生成模型输出的原始、未经优化的配体构象;第二种则使用经过条件 MMFF94 能量最小化后处理的构象。
与需要重新进行完整分子对接或大幅优化结合姿态的方法不同,该研究采用的是一种轻量级后处理策略,尽可能保留生成模型原本给出的分子结构与结合构象,仅通过小幅度的能量优化对局部几何结构进行调整。
表2|SemlaFlow 的质量评估指标
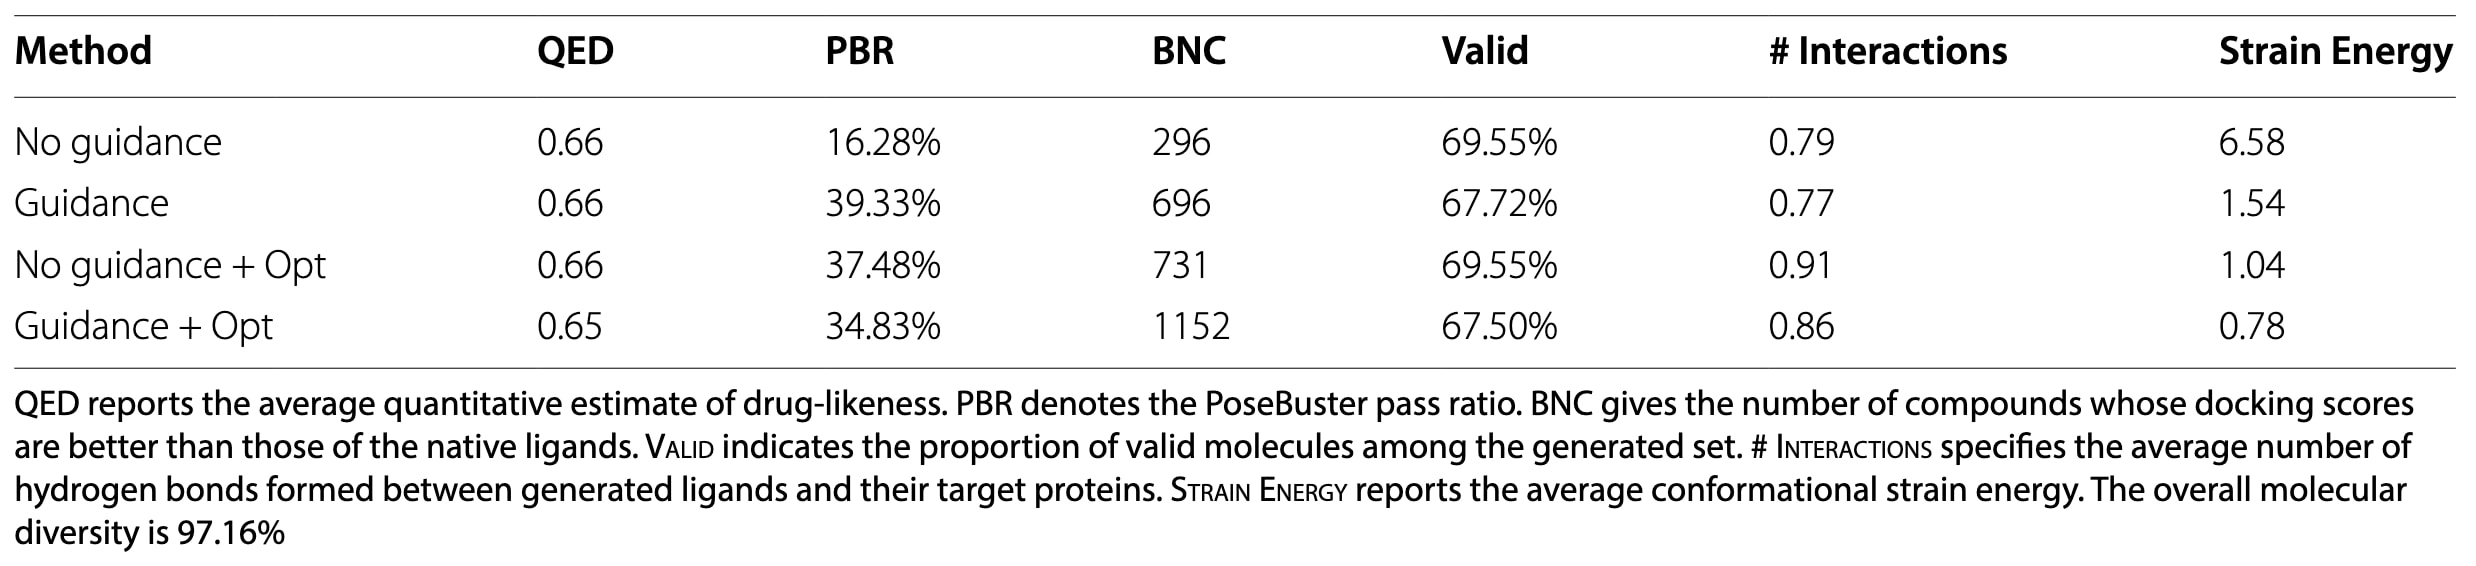
表3|EDM 的 Vina 和 Glide 对接评分评估
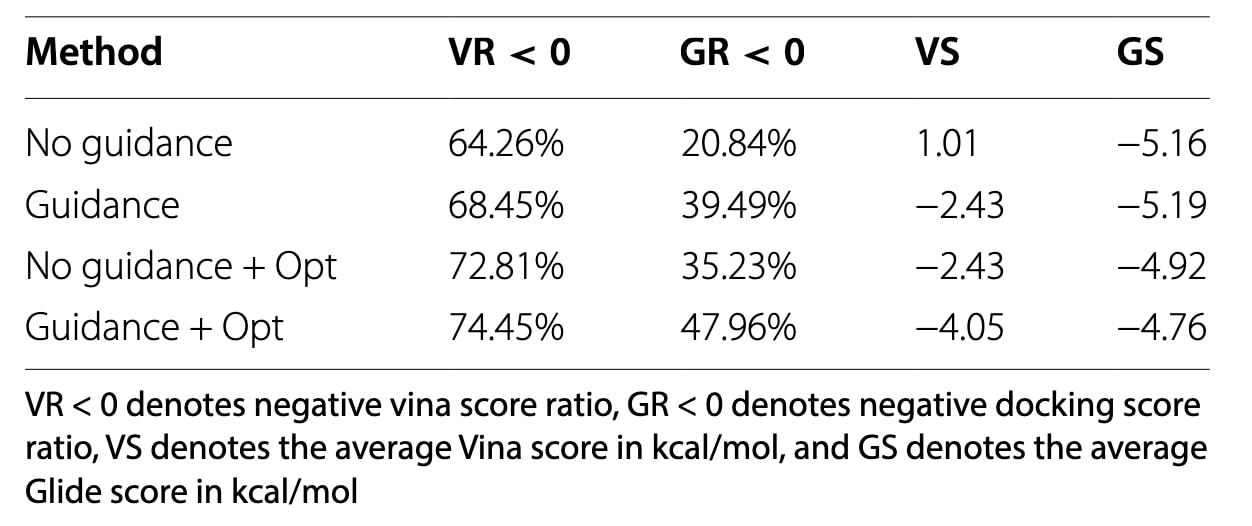
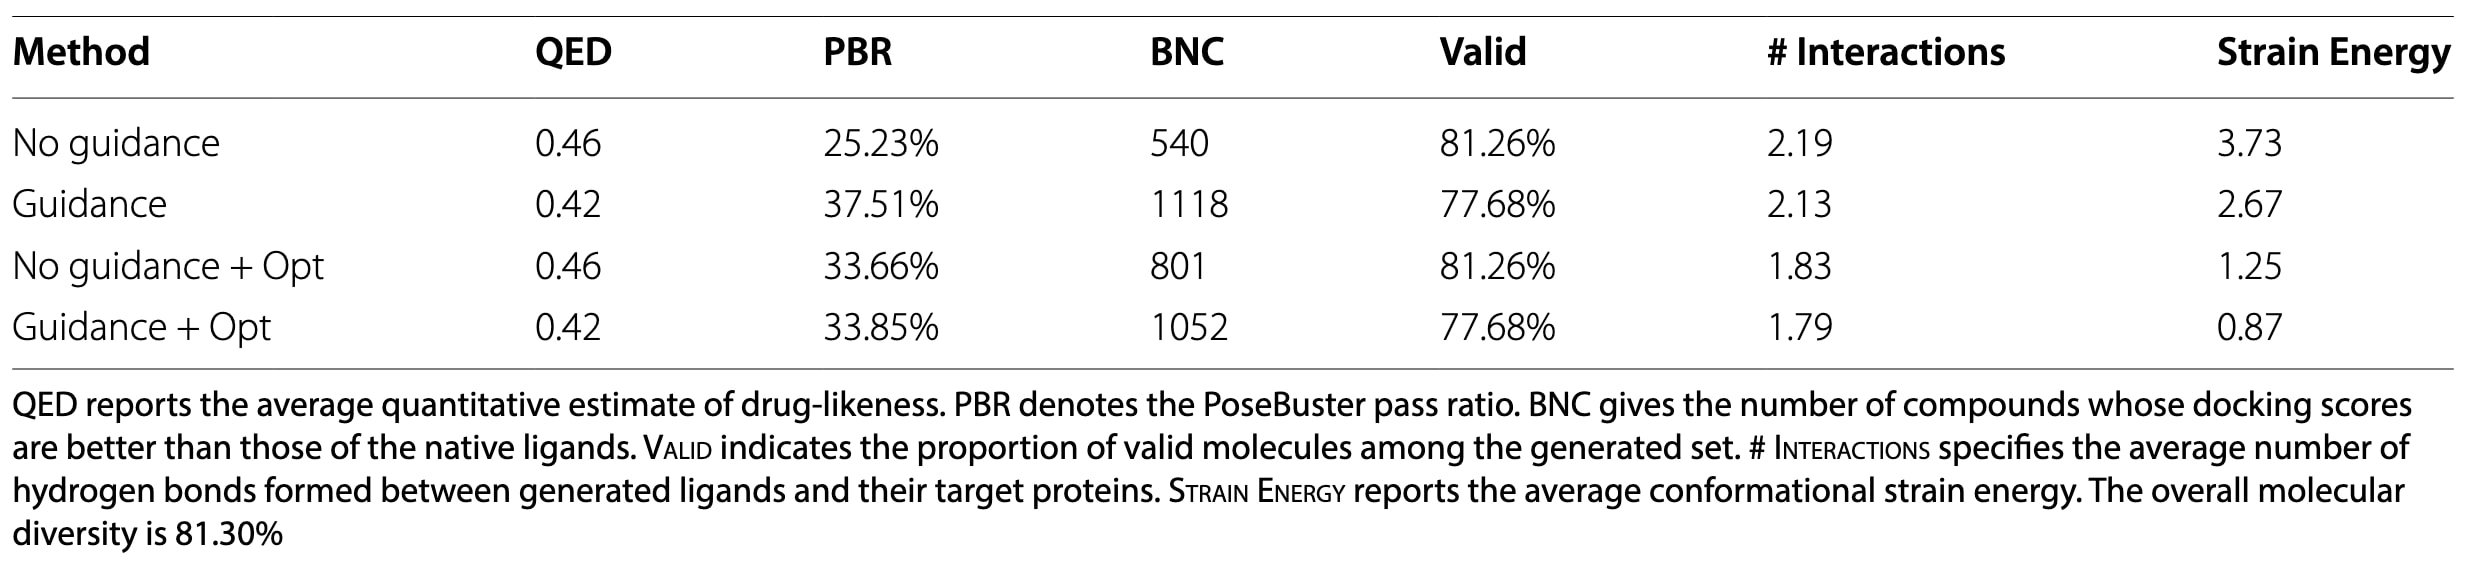
表4|EDM 的质量评估指标
5 结果
SemlaFlow 的实验结果见表1和表2。需要注意的是,所有指标均直接基于生成配体的原始构象计算,未进行重新对接。因此,这些评分对几何结构的合理性、空间位阻冲突以及构象应变较为敏感。由此,对接评分的改善更应理解为生成构象物理合理性的提升,而不能直接等同于结合亲和力提高,也不能代表在完整构象搜索条件下的分子对接性能。
表1给出了 Vina 和 Glide 的负评分比例,即生成配体中 Vina 或 Glide 评分小于 0 的比例,分别记为 VR 和 GR;同时报告平均 Vina Score(VS)和 Glide Score(GS),单位均为
结果表明,在推理阶段引入力场引导能够明显改善生成配体的对接评分。仅使用 MMFF94 能量引导时,VR 由 47.00% 提升至 64.25%,GR 则由 19.41% 大幅提升至 56.61%。与此同时,平均 Vina Score 从较差的
即使不使用能量引导,仅对基线模型生成结果进行后优化,也能获得明显改善:VR 提升至 64.98%,VS 改善至
其中,MMFF94 能量引导与后优化相结合取得了最佳整体性能。该设置下,VR 和 GR 分别达到 65.59% 和 59.06%,均为最高水平;平均 Vina Score 进一步降低至
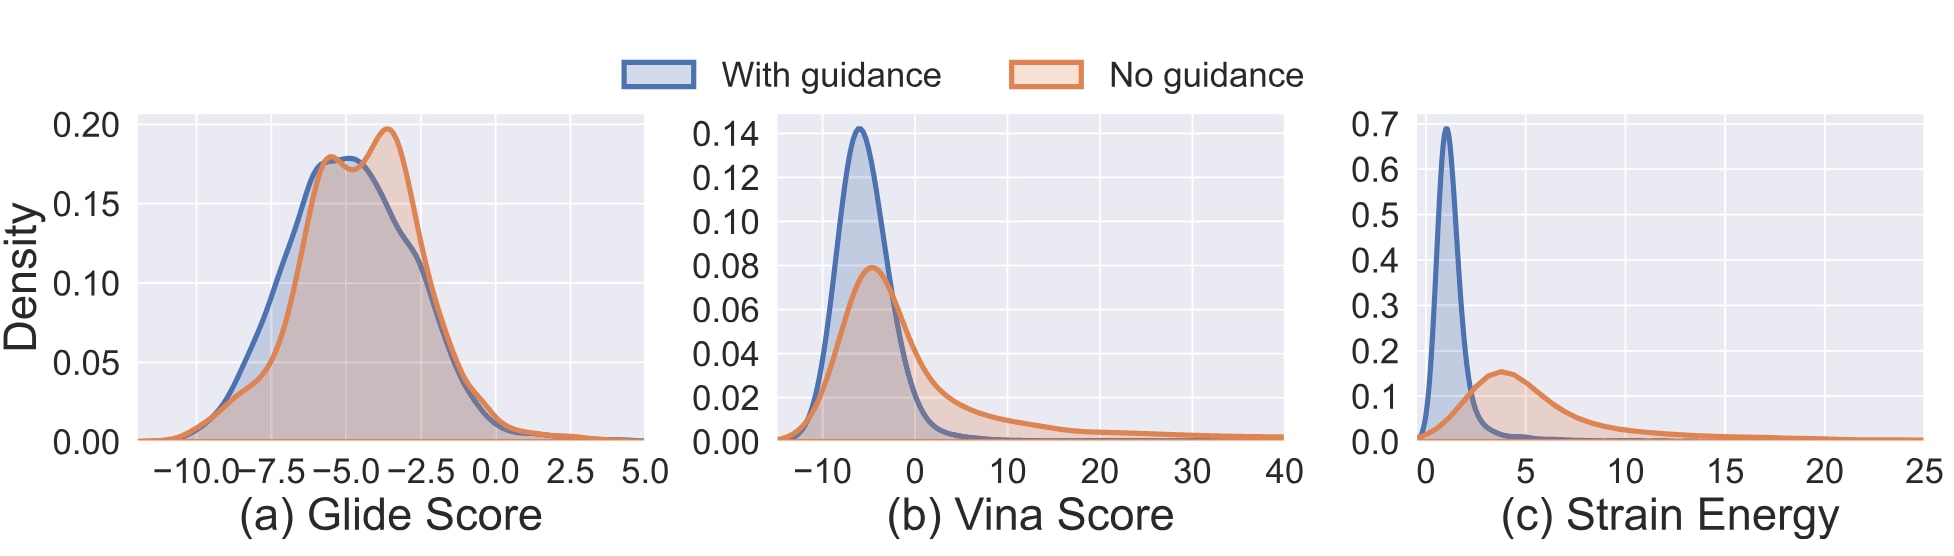
图1|SemlaFlow 模型在有无引导条件下生成分子的 Glide Score、Vina Score 和应变能分布。 a,Glide Score;b,Vina Score;c,应变能。引导生成的分子在更优评分和更低应变能附近呈现出更集中的分布,而未引导生成的分子分布更宽、方差更大,并出现更多评分较差的离群值。
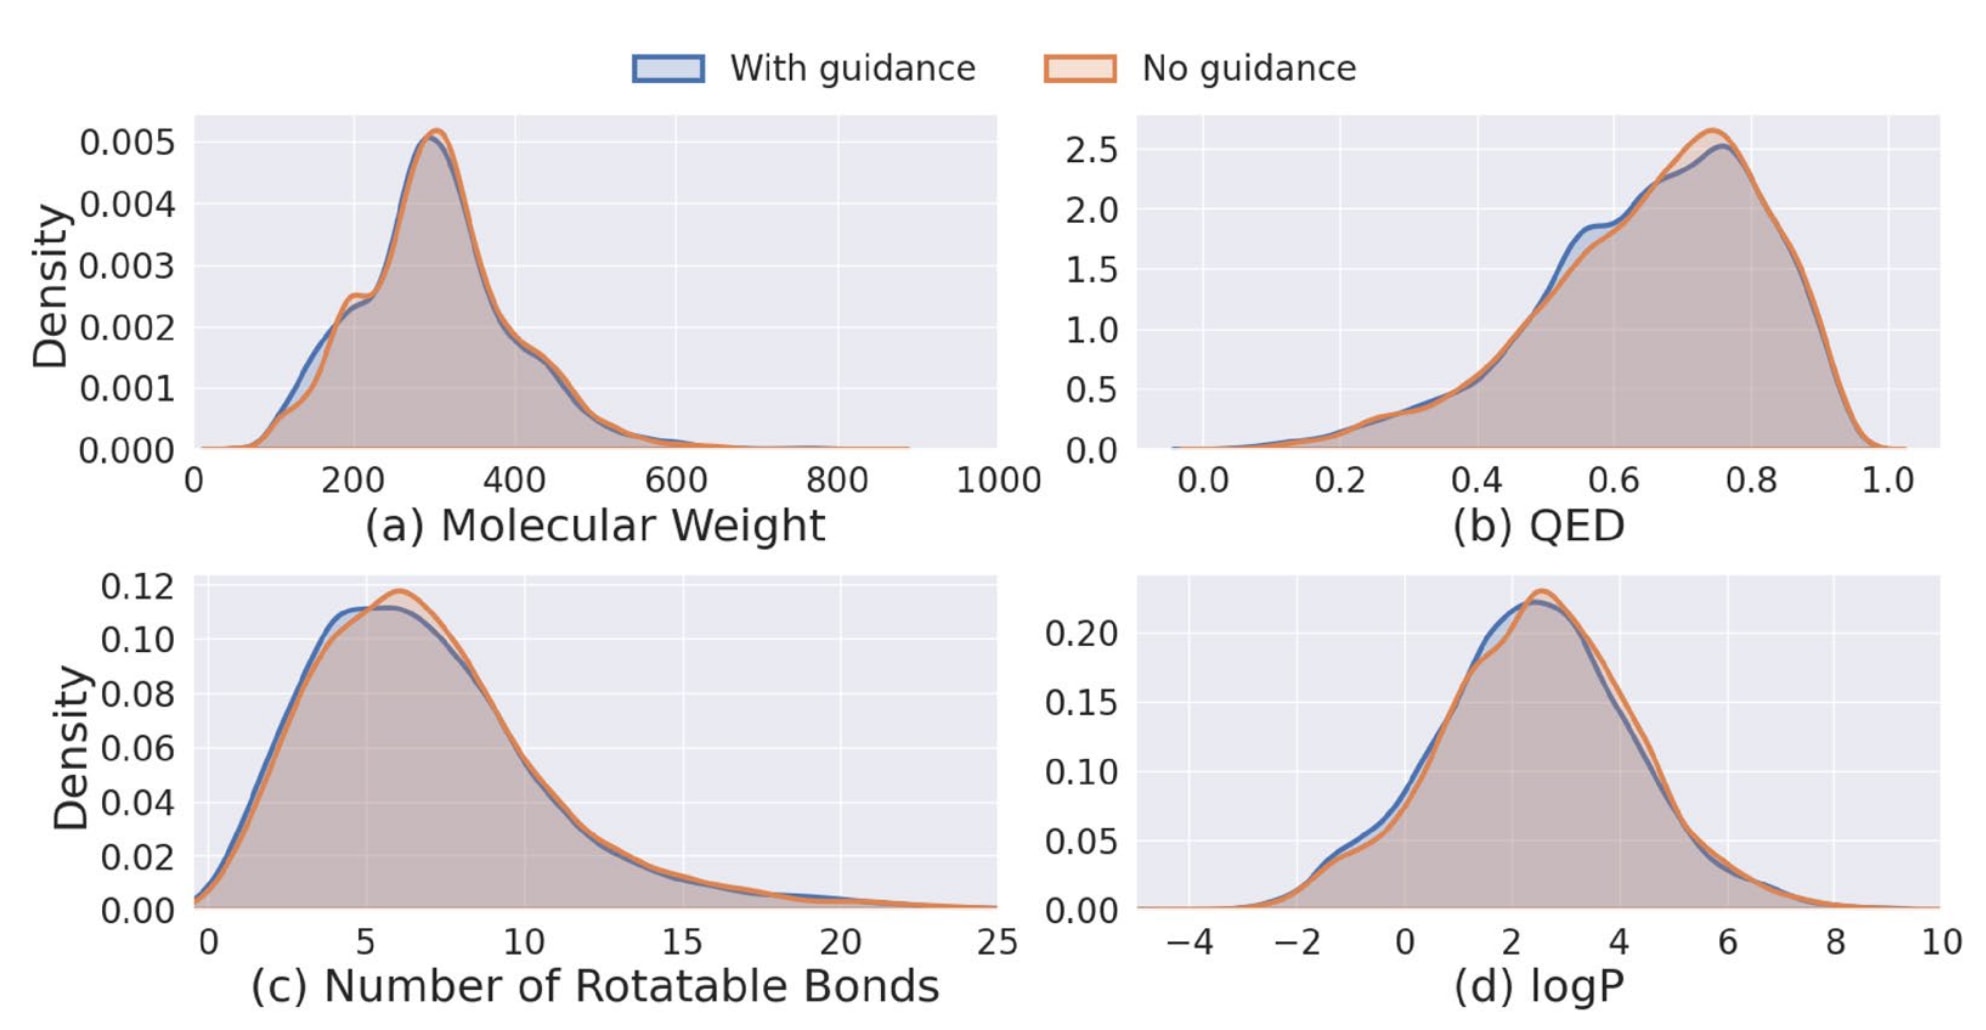
图2|SemlaFlow 模型在有无引导条件下生成分子的分子量、QED 和可旋转键数量分布。 a,分子量;b,QED;c,可旋转键数量。
表2进一步报告了对接评分之外的多项质量指标,包括 QED、PoseBuster 通过率(PBR)、优于天然配体的生成分子数量(BNC)、有效性(Valid)、相互作用数量(# Interactions)以及应变能(kcal/mol)。引入能量引导后,BNC 由 296 提升至 696,增幅约为 135%;同时,应变能由
在不使用引导的情况下,仅采用后优化策略同样能够带来明显改善,BNC 达到 731,应变能降低至
与 SemlaFlow 类似,表3和表4给出了 EDM 模型在相同指标下的评估结果。整体趋势与 SemlaFlow 基本一致:能量引导能够改善对接评分及相关质量指标,而能量引导与后优化相结合的策略在大多数评价指标上表现最佳。
需要强调的是,与 SemlaFlow 中的情况相同,这些结果应结合应变能和几何合理性的变化进行理解。能量引导和后优化都会降低构象应变并改善几何结构,而这些因素本身会直接影响对接评分。因此,评分提升主要反映了生成构象在物理和几何层面的合理性增强,而不能直接等同于配体固有结合能力的提高。
在表3中,EDM 基线模型的 VR 为 64.26%,采用能量引导与后优化后提升至 74.45%;VS 则由
表4进一步给出了 EDM 模型的分子质量指标。与基线模型相比,单独采用能量引导时,PBR 由 25.23% 提升至 37.51%;BNC 由 540 增加至 1118,超过基线的两倍,说明能量引导可以生成更多评分优于天然配体构象的分子。同时,应变能由
仅采用后优化时,BNC 由 540 提升至 801,应变能由
此外,还比较了 SemlaFlow 在有无能量引导条件下生成分子的 Glide Score、Vina Score 和应变能分布(图1)。Glide Score 的分布表明,引导生成的分子更加集中于较低、即更有利的评分区域,而未引导生成的分子分布更宽。Vina Score 也呈现类似趋势:引导生成的分子更多集中于较优评分区域,例如低于
这些结果进一步表明,能量引导可以改善生成结合构象的物理合理性,并由此获得更有利的对接评分。需要再次指出,这类改善主要体现的是对生成结构的几何和能量正则化作用,而这些因素本身会直接进入对接评分函数。
应变能分布显示,引导生成的分子整体具有明显更低的应变能。引导组的分布主要集中在约
为进一步考察能量引导框架对二维分子性质的影响,图2比较了 SemlaFlow 在有无引导条件下生成分子的多种化学性质分布,包括分子量、QED、可旋转键数量和
结果显示,引导组与未引导组在这些二维化学性质上的分布并未发生明显偏移。这一现象符合预期。虽然当前算法并未显式限制二维分子图的变化,但实际采样过程中二维结构发生改变的频率较低。即使二维分子图发生变化,能量引导也没有明显改变这些整体化学性质的分布。
这一结果与方法本身的设计一致:能量引导主要直接作用于分子的三维坐标,而二维分子图的变化仅通过流匹配模型内部二维与三维信息之间的耦合间接产生。
最后,图3展示了若干具体案例,用于直观说明能量引导对生成分子结构产生的影响。
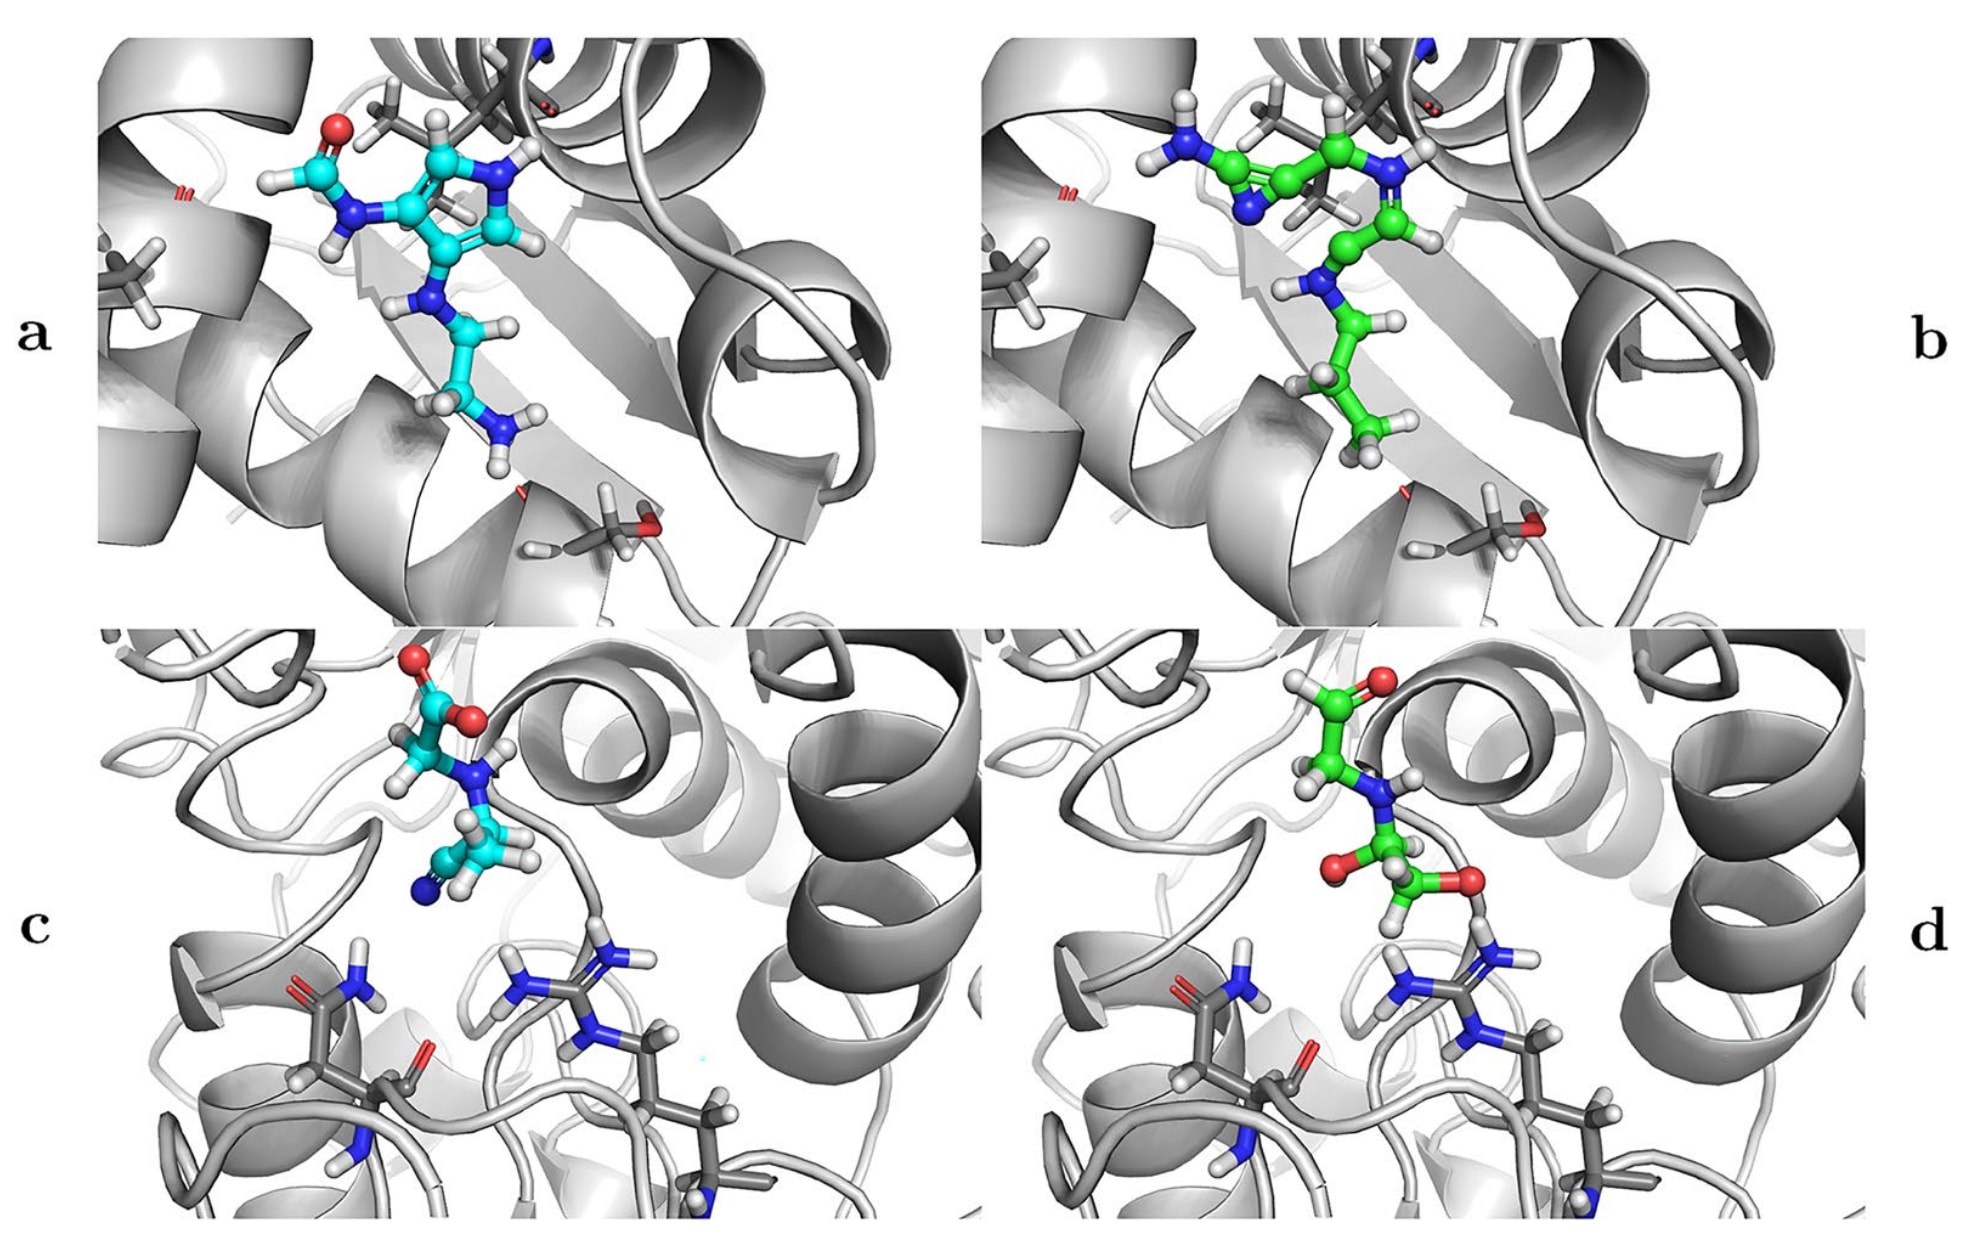
图3|EDM 模型生成分子中能量引导项影响的代表性案例。 在固定初始噪声条件下,分别比较采用能量引导(a、c)和不采用能量引导(b、d)的生成结果。上排为 Epstein-Barr 病毒核抗原 1(PDB:6NPM),下排为天冬氨酸半醛脱氢酶(PDB:6C85)。蛋白质以灰色卡通形式表示,部分结合口袋残基以棒状形式显示;生成配体采用球棍模型表示,其中能量引导生成的配体碳原子以青色表示,默认模型生成的配体碳原子以绿色表示。
6 结论
该研究提出了一种用于蛋白质条件分子生成的能量引导框架,将基于物理的 MMFF94 力场约束引入扩散模型和流匹配模型。通过进一步扩展 MMFF94 中的范德华和静电相互作用项,该框架能够显式描述蛋白质–配体相互作用,并在分子生成过程中利用能量梯度对采样轨迹进行引导。相比依赖高计算成本重新对接或结合姿态优化的方法,该方法更加轻量,同时具有较好的实际效果。
在 PDBBind 数据集上的系统评估表明,该方法在多项关键药物发现指标上均取得明显改善。其中,SemlaFlow 的应变能由
同时,SemlaFlow 和 EDM 中优于天然配体的生成分子数量分别提升至基线的 3.9 倍和 1.9 倍。焓相互作用能相关指标同样明显改善,例如 SemlaFlow 中 Vina 负评分比例由 47.00% 提升至 65.59%。
传统基线模型的损失函数主要用于推动生成分布逼近训练集中的数据分布,而加入力场引导后,采样过程会进一步偏向符合物理规律的构象区域,因此无需额外重新对接即可直接获得更优的对接评分。该方法在 SemlaFlow 和 EDM 两种不同生成架构上均表现出一致的改进趋势,说明其具有较好的通用性。
除实验结果外,理论分析进一步表明,当引导步长满足
其中
更重要的是,在改善生成构象质量的同时,该方法仍能够保持较高的分子多样性(超过 80%)和化学有效性。因此,能量引导并未以明显压缩化学空间探索范围为代价,而是在保持生成多样性的基础上,提高了蛋白质–配体复合物的物理合理性和结合相关性质。