JMC 2026|计算机辅助 ADMET:从当前实践到新型预测工具
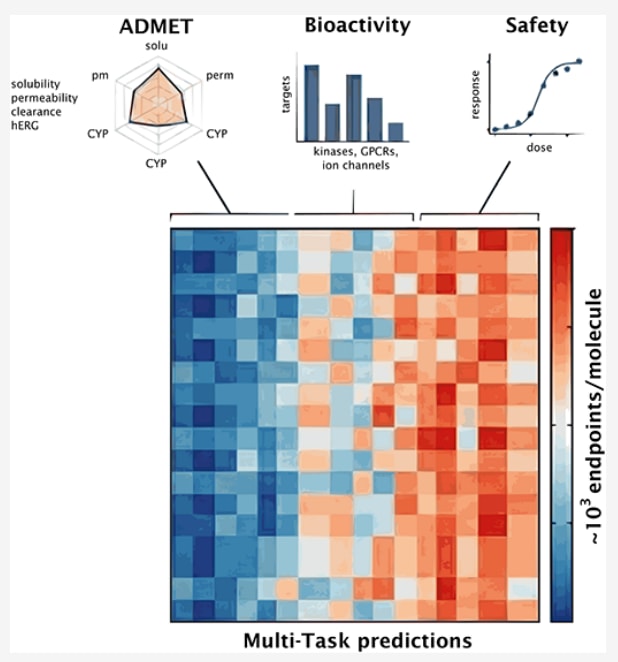
今天介绍的是一项聚焦 ADMET 预测与多任务学习(MTL) 的系统研究。药物研发中,吸收、分布、代谢、排泄和毒性性质直接影响候选化合物能否顺利进入临床,但现有许多 ADMET Web 工具长期依赖高度重复、缺乏充分整理的老旧数据集,模型性能也因此受到限制。针对这一问题,该研究系统梳理了当前主流 ADMET 在线预测平台,并构建了经过严格整理的 OneADMET 数据集,涵盖 73.8 万余个化合物、111.9 万条测量数据、44 个 ADMET 终点及 1489 项生物活性。在此基础上,作者采用 ChemProp 构建统一的大规模多任务模型。结果表明,MTL 在整体性能上可达到或超过单任务模型,尤其在小样本任务中更具优势,同时还能显著降低多模型部署、优化和维护成本,为大规模药物性质预测提供了更实用的数据和建模范式。
获取详情及资源:
0 摘要
多任务学习(multitask learning,MTL)是计算药物发现中一种颇具前景的策略,相较传统单任务模型,有望提升预测性能与泛化能力。MTL 在吸收、分布、代谢、排泄和毒性(ADMET)以及药物效力预测方面尤具价值,而这些性质是药物设计中的关键考量因素。然而,目前许多 Web 服务器仍依赖相同的、未经充分整理且已有十余年历史的数据集,由此造成了数据资源看似多样、实则高度重复的现象。
该研究系统评述了现有开源 ADMET Web 服务,揭示出该领域普遍存在严重的数据冗余和数据整理不足问题。在此基础上,作者构建了 OneADMET 数据集,其中包含经过严格整理的 738,161 个化合物、1,119,719 条测量数据,覆盖 44 个 ADMET 终点和 1,489 项生物活性。
此外,该研究基于 ChemProp 构建了统一的 MTL 模型,可同时处理数百个连续型预测任务,在模型部署与维护方面具有明显的实际优势。结果表明,这类 MTL 模型的预测准确性能够达到或超过对应的单任务模型。总体而言,该研究展示了大规模多任务学习在药代动力学性质分析中的应用价值,并为相关研究提供了具有实用性的模型工具和数据资源。
1 引言
先导化合物优化是药物发现过程中的关键阶段。在获得初始命中化合物后,需要进一步改善化合物的药效、选择性和药代动力学性质,使其具备成为候选药物的潜力。同时,还需要深入理解并控制其潜在毒性。随后,候选药物进入临床前开发阶段,以在人体试验之前系统评估其安全性。
由 ADMET 性质引起的先导化合物优化失败,仍然是药物开发面临的主要障碍之一。对于小分子药物而言,约 60% 的临床试验失败与 ADMET 问题有关,这不仅会显著延缓新疗法惠及患者的进程,也会造成巨大的研发投资损失。与此同时,药物研发的经济成本持续攀升,一款新药从研发到上市的平均成本估计已超过 26 亿美元。因此,在研发早期识别并优化 ADMET 特征,对于提高药物研发成功率至关重要。相应地,开发新的 ADMET 评估方法和预测模型,有助于提升新药研发效率。
该研究首先对现有 ADMET 预测 Web 服务器及多任务学习方法进行了系统性评述,揭示了该领域存在的数据来源高度重叠、数据整理不足以及长期依赖老旧数据集等问题。在此基础上,作者构建并发布了 OneADMET 数据集,这是一项经过系统整理的公共数据资源,涵盖 44 项 ADMET 性质和 1,489 项生物活性,同时提供了相应的预测模型。
这些模型采用标准的 ChemProp 图神经网络(graph neural network,GNN)架构,其重点并非提出新的模型结构,而是用于验证 OneADMET 数据集的质量,并展示大规模多任务学习在实际应用中的优势(图 1)。
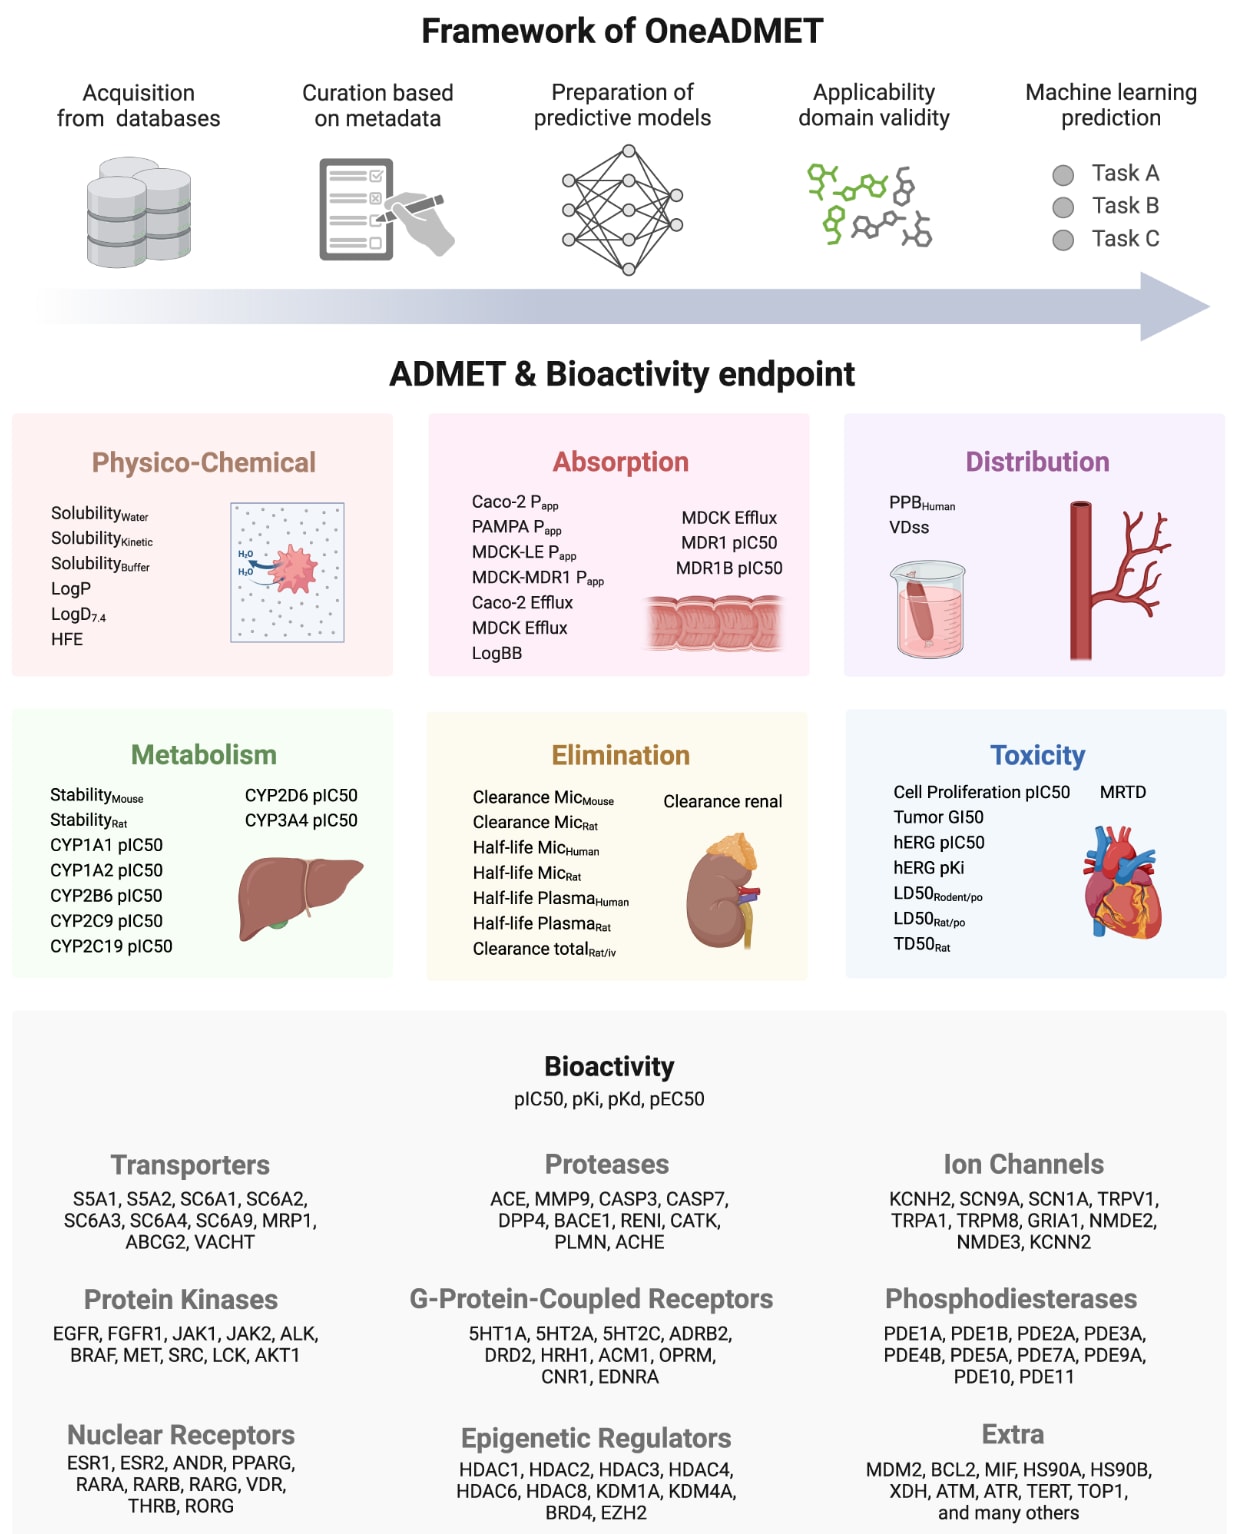
图1|Web 服务器预测流程及其覆盖的 ADMET 与生物活性终点。
1.1 多任务学习在 ADMET 建模中的兴起
多任务学习(multitask learning,MTL)是指使用单一模型同时针对多个任务进行优化。该方法能够在多个统计建模任务之间共享通用的特征表示和模型参数。已有研究表明,对于彼此相关的任务,这种共享机制可能提高模型的泛化能力,但不同任务之间是否能够产生协同效应通常难以预先判断。
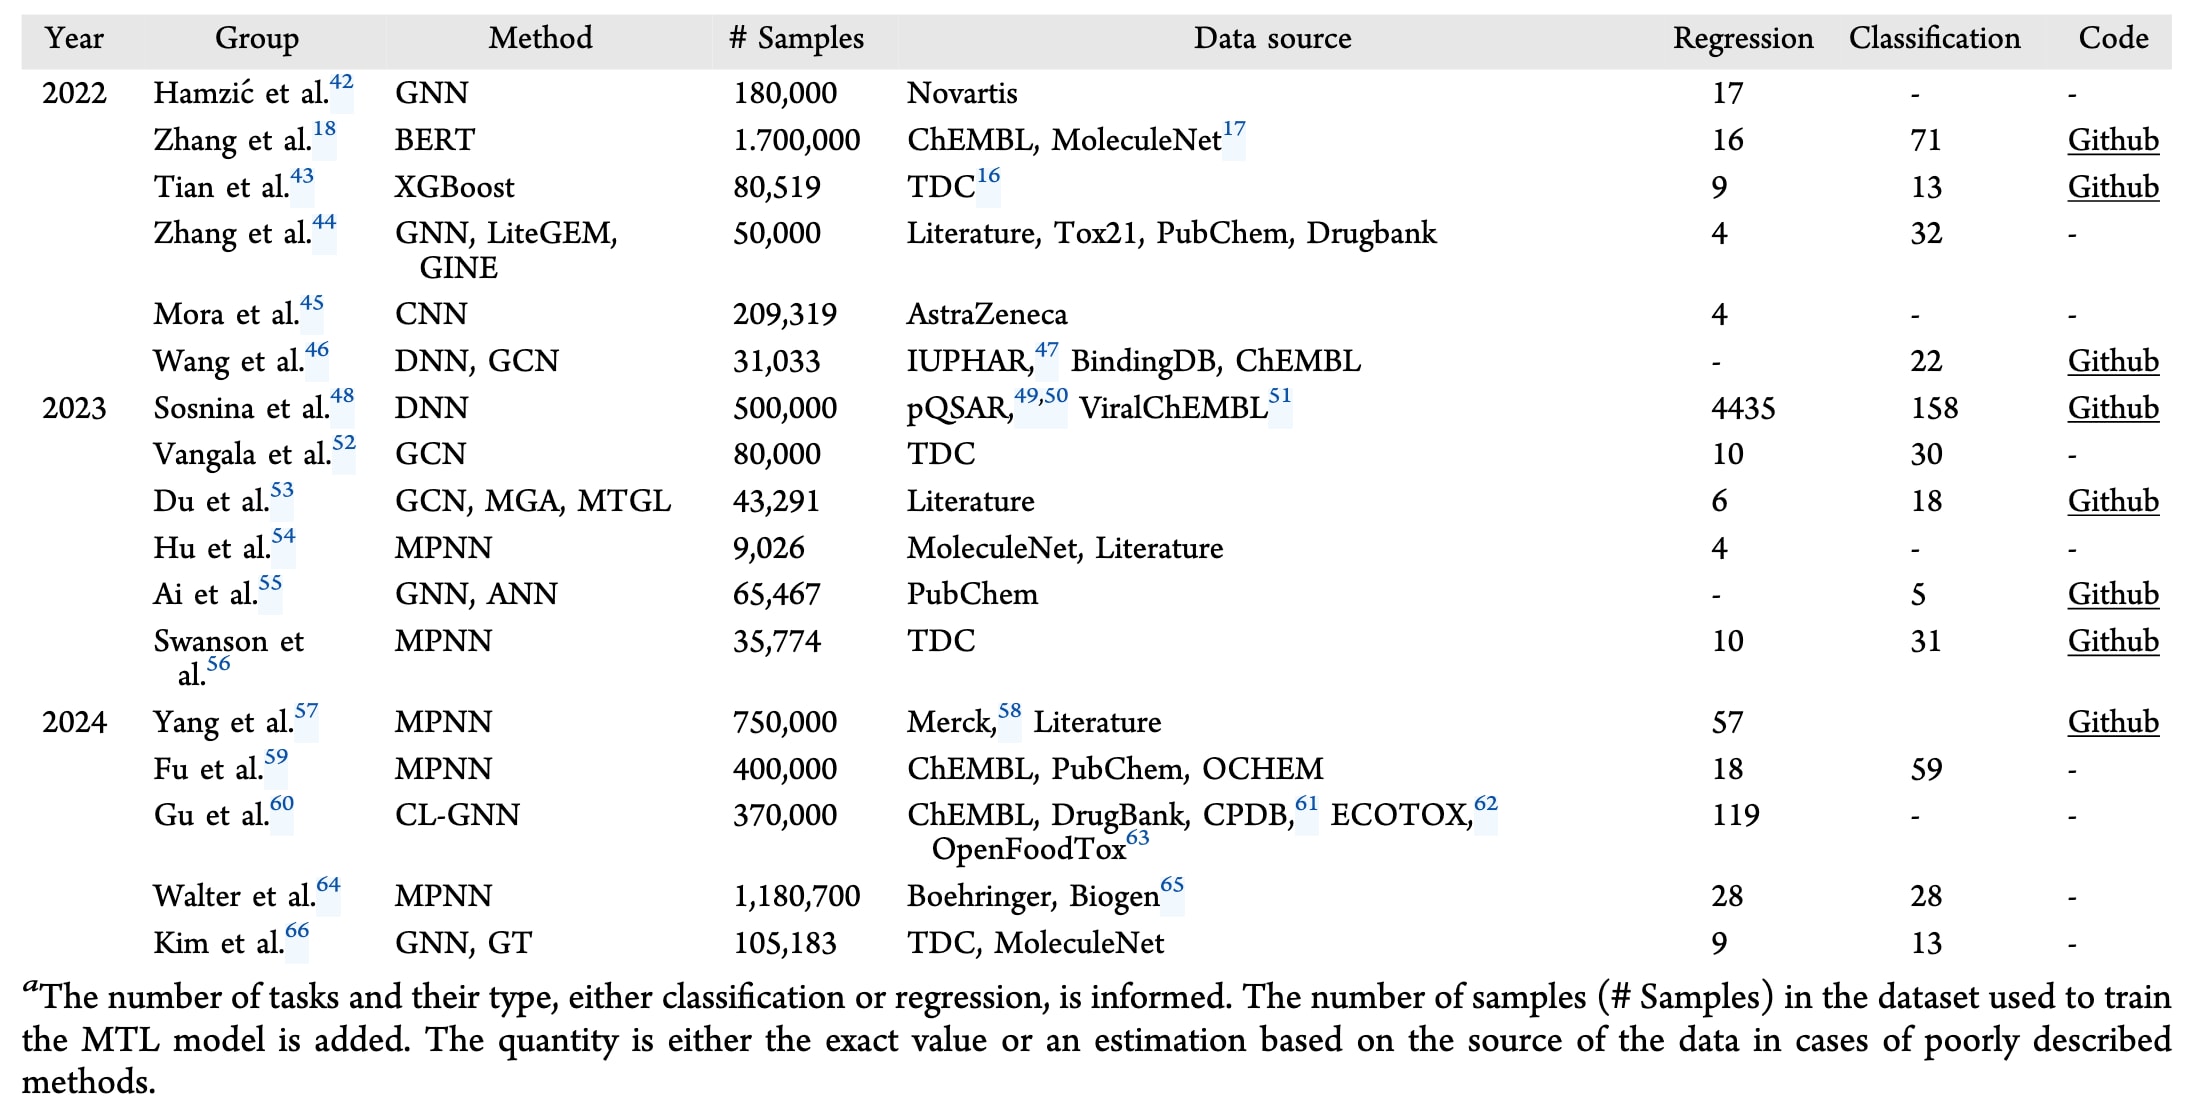
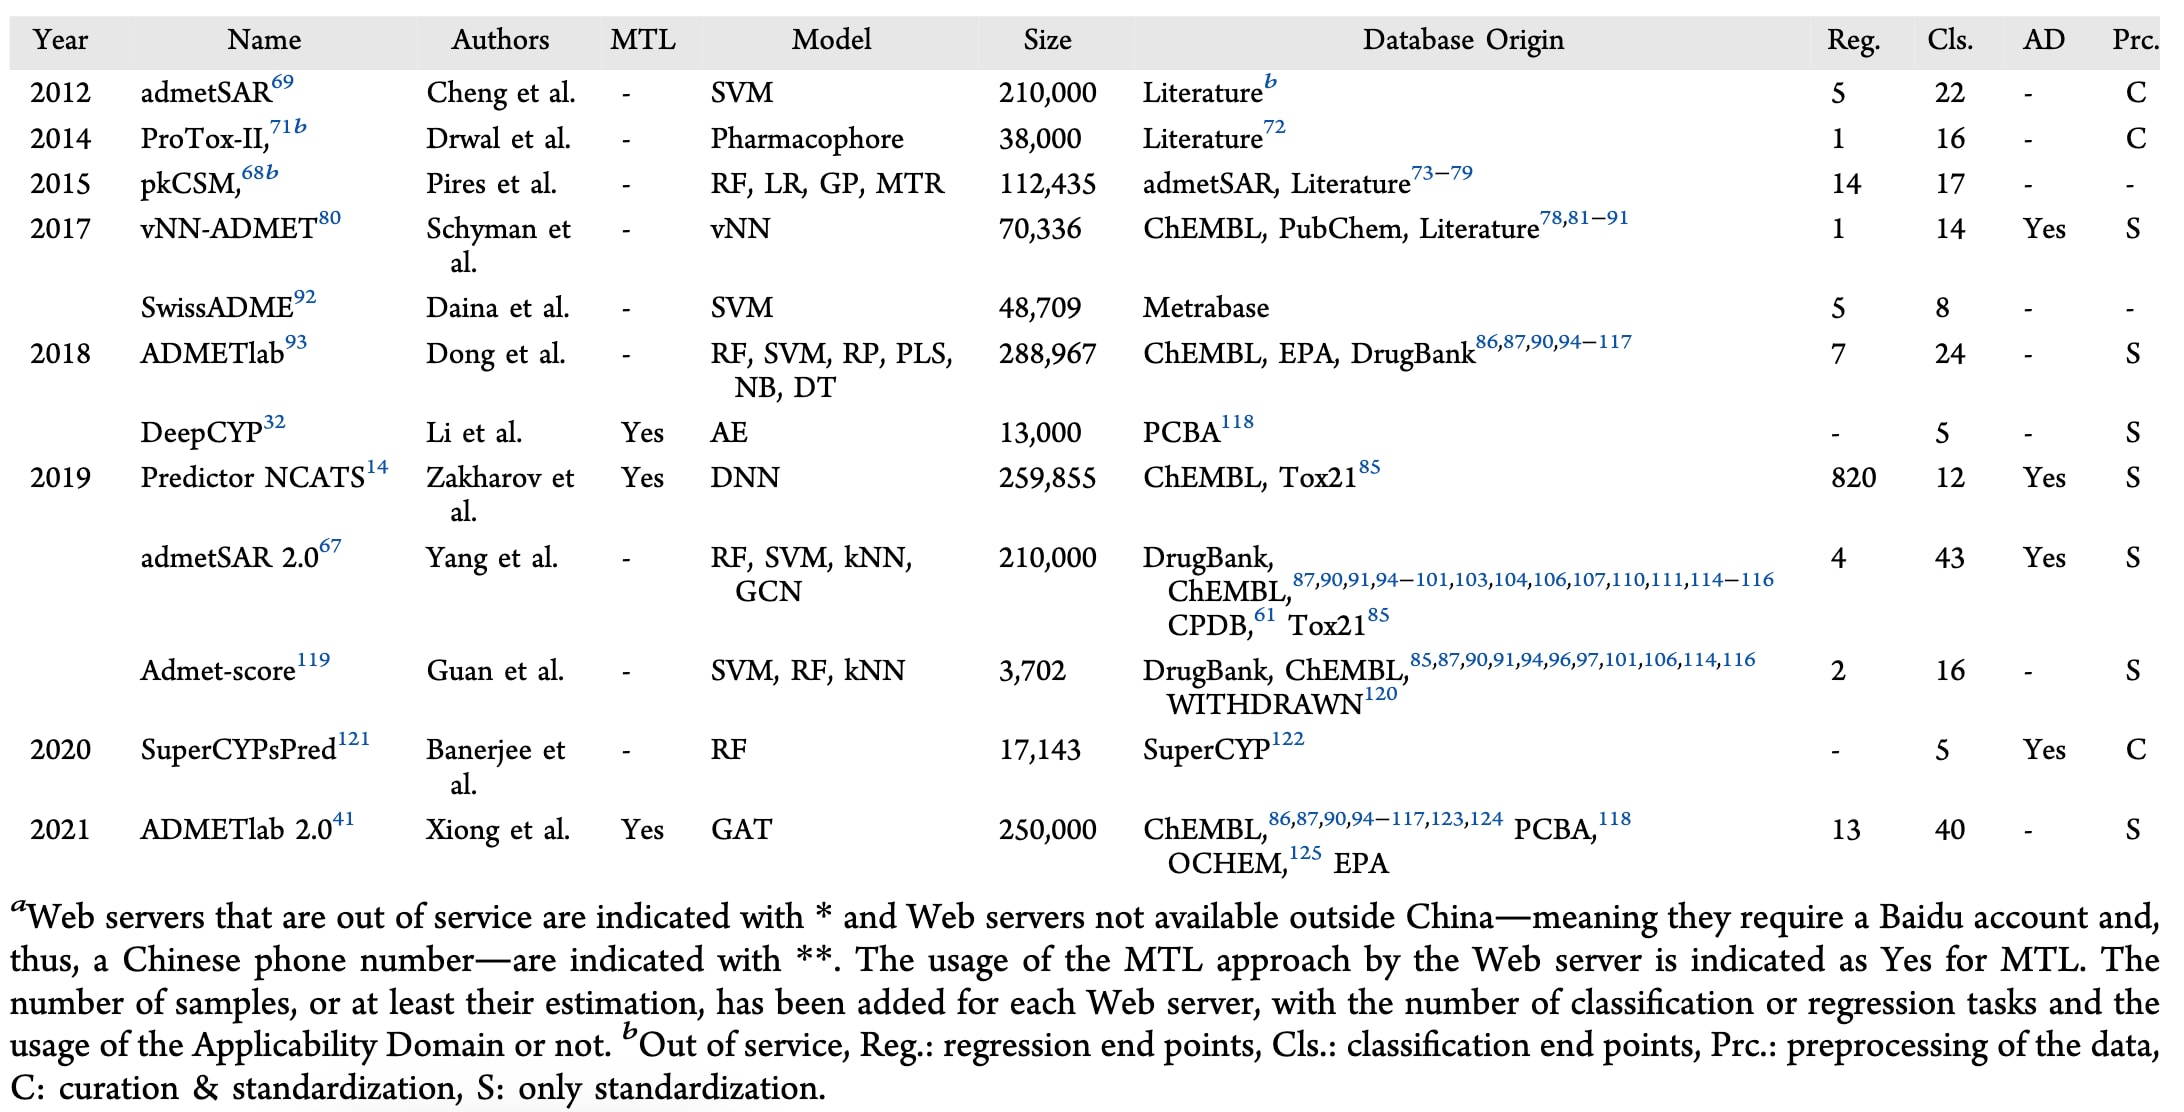
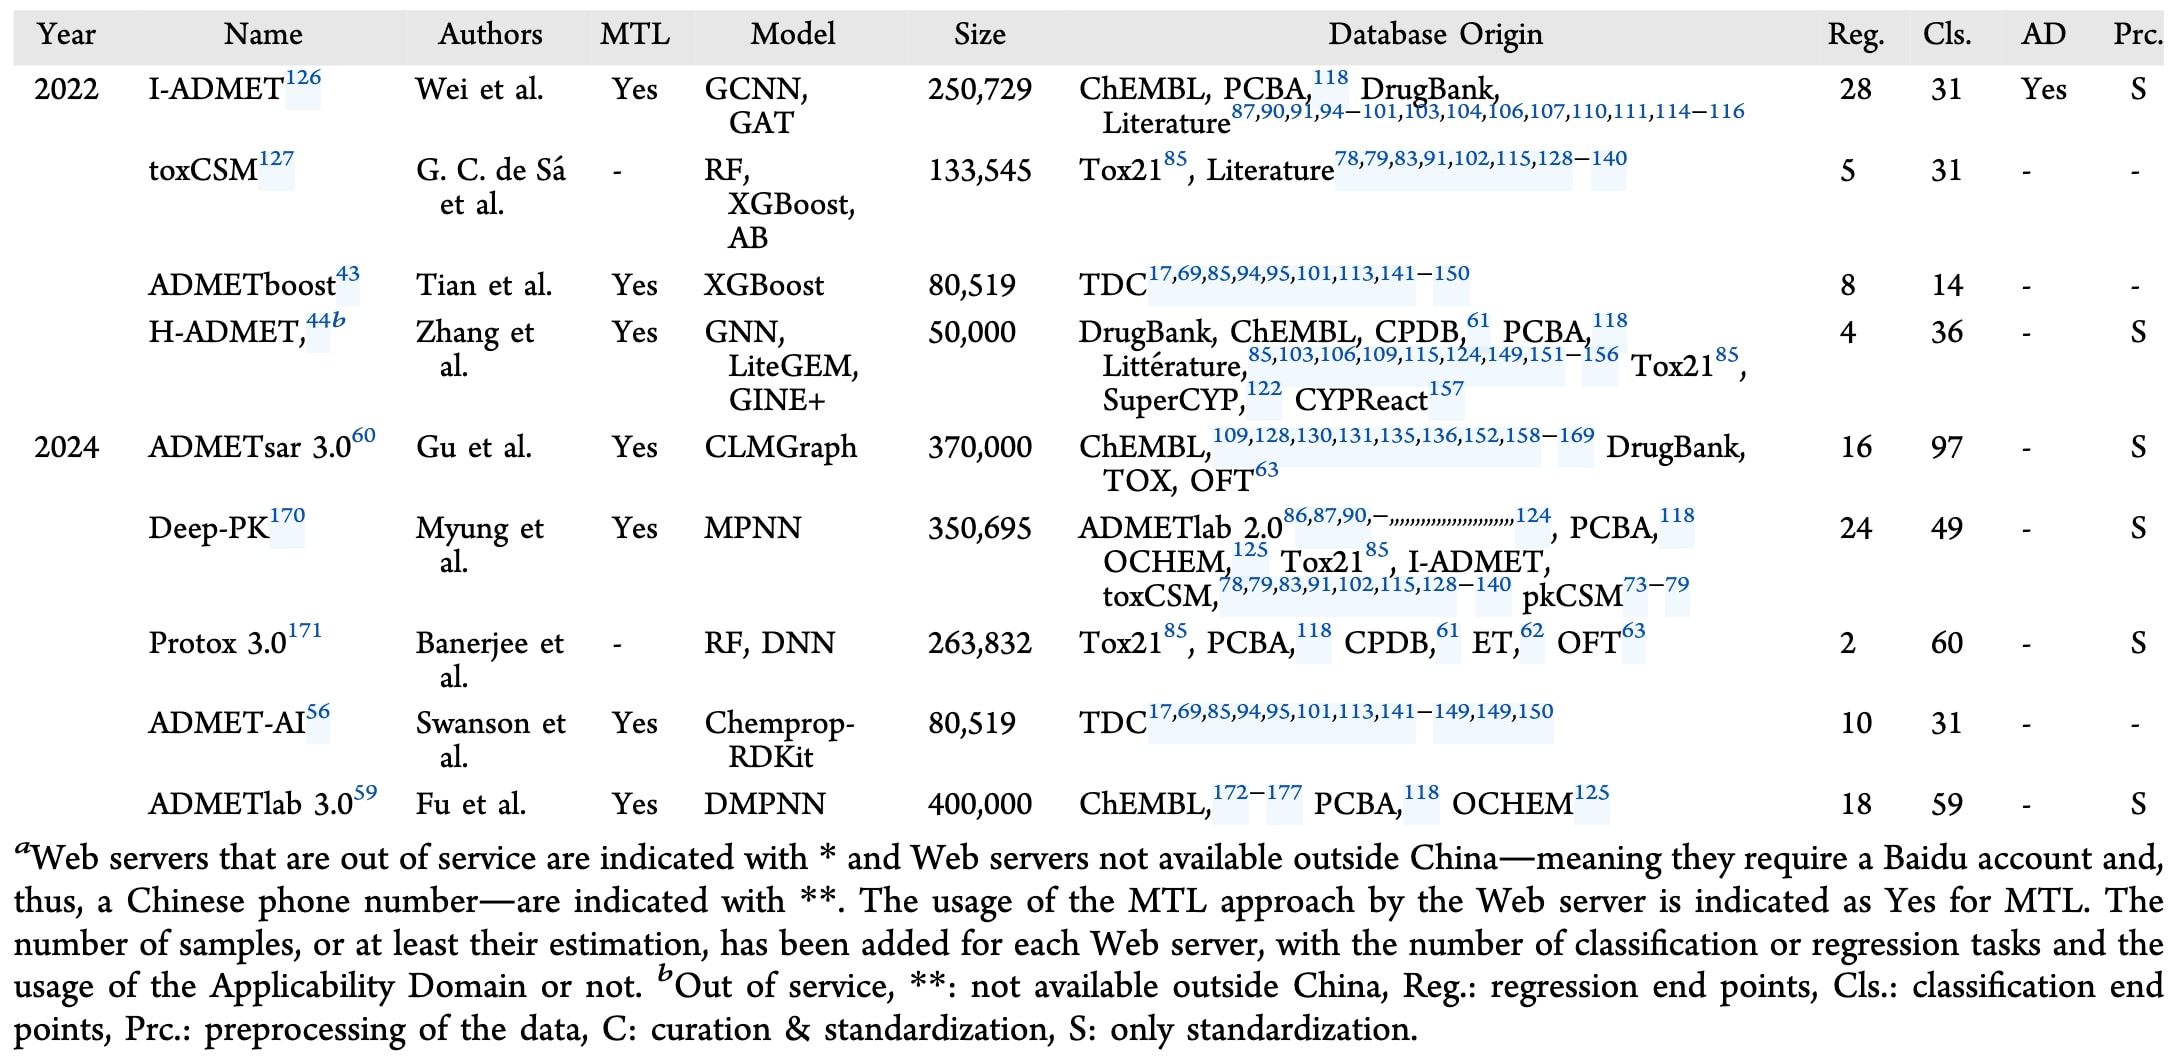
下文将回顾 MTL 在 ADMET 建模领域的发展现状,并对目前可用的 Web 服务器进行评估(见表 1 和表 2),重点比较这些工具所采用的底层数据和模型之间的差异。此外,还将考察各方法是否定义了适用域(applicability domain,AD)。适用域用于界定模型能够进行可靠预测的化学空间,对于控制预测准确性至关重要。如果未对适用域进行合理限定,模型在预测超出训练数据覆盖范围的化合物时可能产生不可靠的结果。
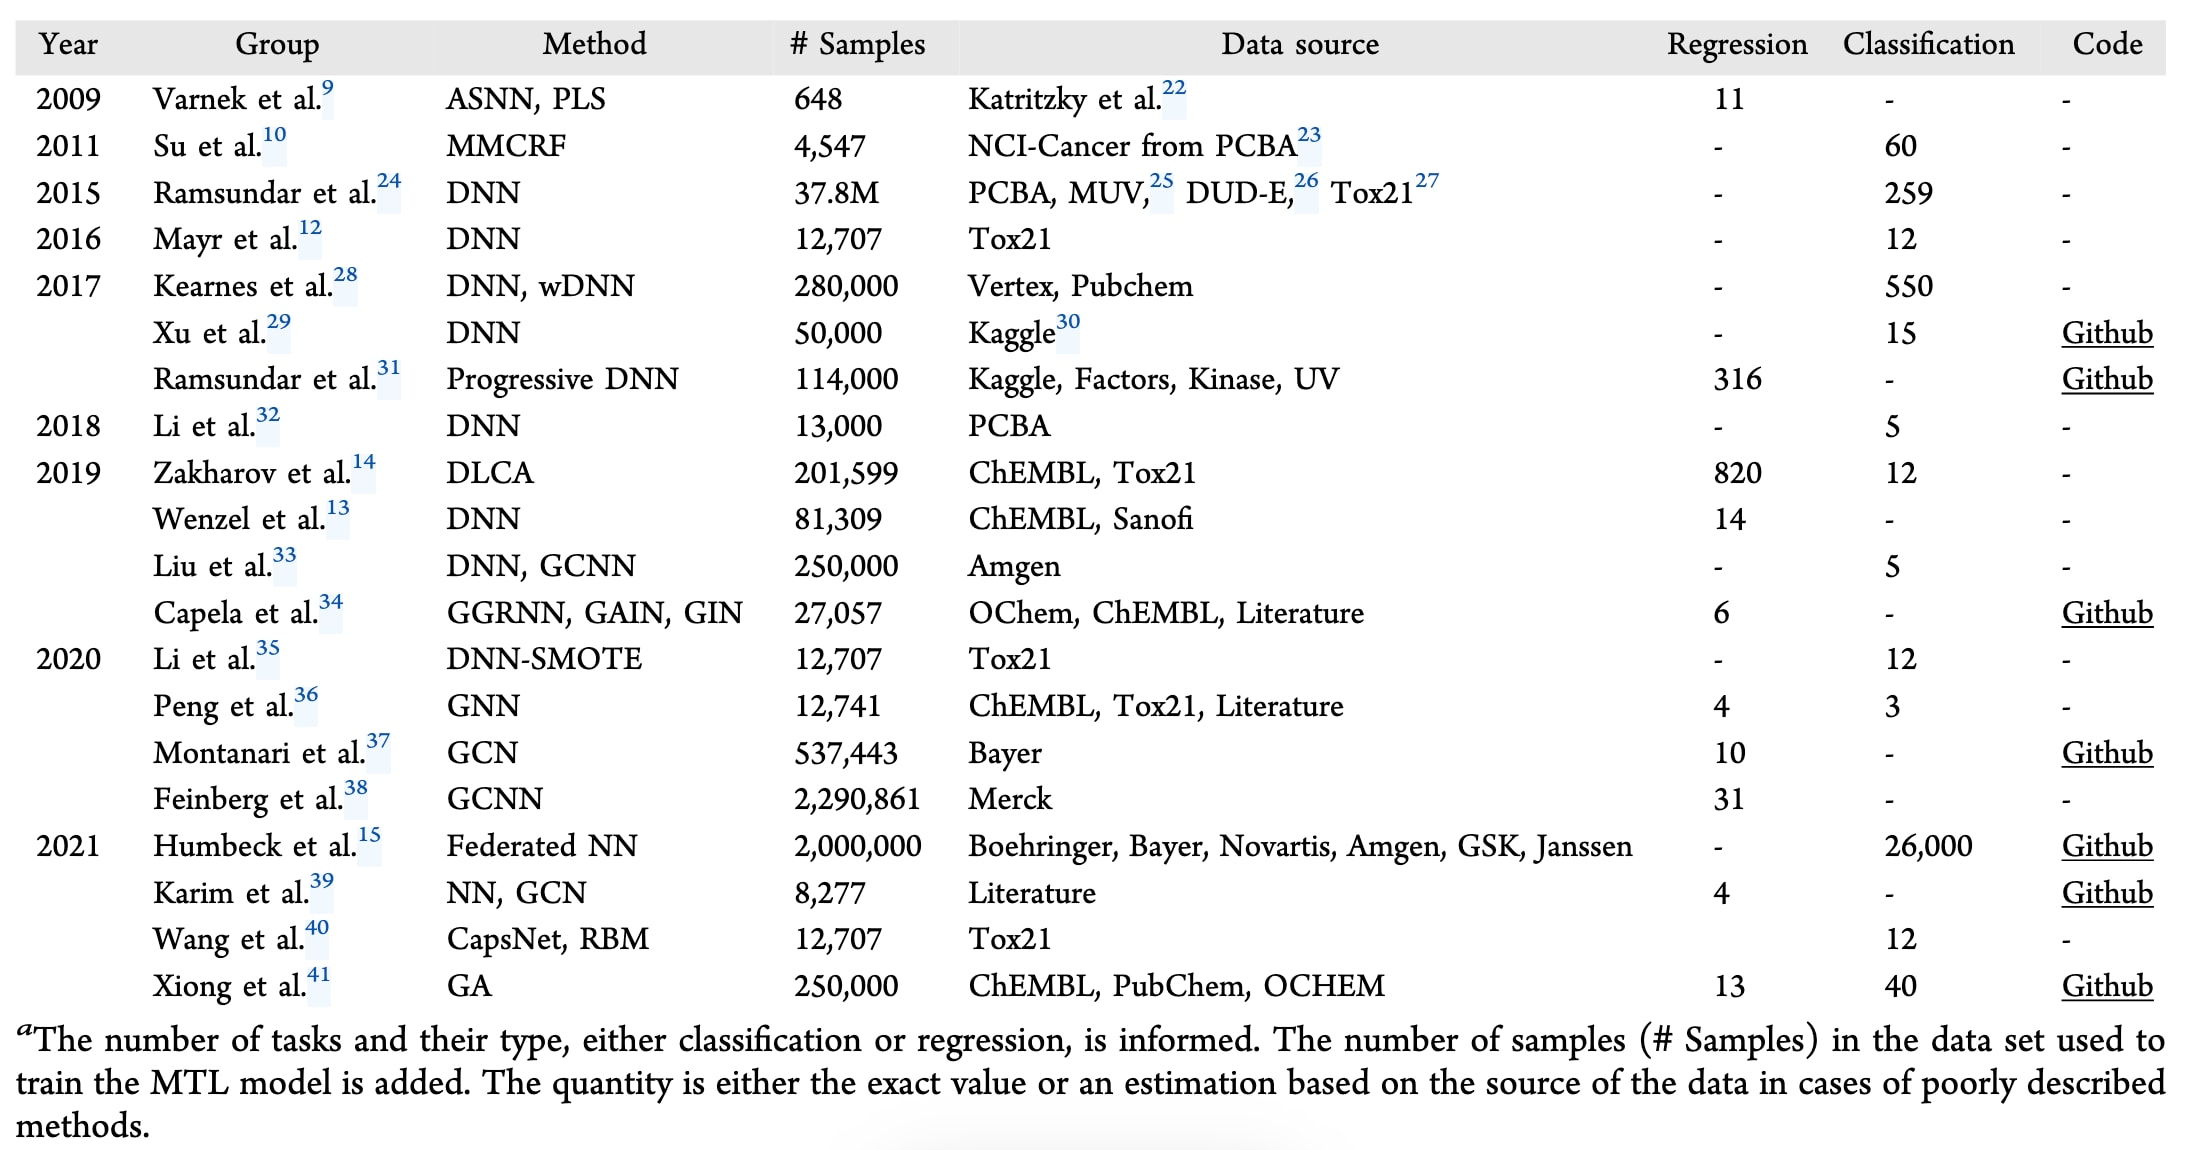
ADMET 领域最早报道的多任务学习应用可追溯至 2009 年 Varnek 等人的研究。该研究在 MTL 框架下采用人工关联神经网络(artificial associative neural network,ASNN),利用包含 648 个样本的数据集,同时完成 11 个回归任务,用于预测人和大鼠不同组织中的组织-空气分配系数。
2011 年,Su 等进一步推动了该领域的发展,采用最大间隔条件随机场(max-margin conditional random fields,MMCRF)预测化合物针对癌细胞系的生物活性。该数据集包含 4,547 个样本,共涉及 60 个分类任务。这些早期研究初步展示了 MTL 在化学信息学和 ADMET 建模中的应用潜力。
表1|2009—2021 年多任务学习(MTL)方法在 ADMET 建模中的应用历程
1.2 Tox21 挑战赛推动下的快速发展
2016 年成为 ADMET 多任务学习发展的重要转折点,这一阶段的快速推进在很大程度上得益于 Tox21 Data Challenge 的成果。Tox21 是由美国多个联邦机构共同参与的合作计划,旨在开发更有效的毒性评估方法。该挑战赛提供了包含 12,707 个化合物的数据集,这些化合物接受了 12 项体外实验测试,涉及核受体信号通路和应激反应通路。
Mayr 等采用多任务学习框架下的深度神经网络(deep neural networks,DNNs),同时预测这 12 项毒性相关任务,并在多项实验中取得领先性能,相较单任务学习(single-task learning,STL)模型表现出明显优势。部分任务的性能提升幅度最高可达约 5%,表明 MTL 在处理复杂生物学数据方面具有较高潜力。
此后的 5 年间,共有 16 项研究探索了 MTL 在 ADMET 领域的应用,其中 7 项来自工业界。例如,Sanofi 的 Wenzel 等指出,在构建任务数量较少、规模中等的 MTL 模型时,应优先组合来自相关领域的任务。研究发现,引入彼此无关的任务反而可能降低模型性能,说明任务选择对于 MTL 至关重要。
与此同时,部分研究开始通过显著增加并行任务数量来拓展 MTL 的规模。Zakharov 等开发了深度学习共识架构(deep learning consensus architecture,DLCA),使用来自 ChEMBL 和 Tox21 的 201,599 个样本进行训练,同时覆盖 820 个回归任务和 12 个分类任务。该研究展示了 MTL 模型处理大规模、多样化数据集的良好扩展能力。
MELLODDY(Machine Learning Ledger Orchestration for Drug Discovery)联盟则进一步将联邦学习引入多任务学习。该联盟由多家制药企业参与,通过对加密数据执行算术运算,实现不同企业之间的协同模型训练。在这一框架下,共涉及约 26,000 个分类任务,其中包括与 ADMET 相关的任务,并使用工业合作伙伴提供的数据进行训练,构成了当时极具代表性的大规模 MTL 应用。
2022 年,多个研究团队推动将 Therapeutics Data Commons(TDC)和 MoleculeNet 作为标准化基准数据集,并配套使用统一的评估协议。此后,至少有 5 项专门针对 ADMET 多任务学习的研究,全部或部分采用这些基准数据进行模型验证。例如,Zhang 等于 2022 年基于 ChEMBL 和 MoleculeNet 中超过 170 万个样本构建了基于 BERT 的模型,共覆盖 71 个分类任务和 16 个回归任务。
然而,标准化基准数据集的设计目标并不等同于保证数据质量和数据相关性。Walters 曾指出,这些数据集中可能存在一些问题,例如相同化合物的重复记录却对应相互矛盾的实验结果、离子化状态处理不一致以及分子标准化不足等。这些问题可能扰动模型预测并造成评估偏差,从而降低模型结果的可靠性。
针对这些问题,Polaris 等协作式开源项目开始致力于构建经过严格整理的高质量标准化基准数据集。不过,要全面解决数据质量问题仍需要持续投入,尤其值得关注的是,目前部分使用存在质量缺陷的数据集训练得到的模型已经部署在公共 Web 服务器上。
表2|2022—2024 年多任务学习(MTL)方法在 ADMET 建模中的应用历程
1.3 ADMET Web 服务器的出现与早期发展
过去 12 年间,专门用于 ADMET 性质分析的 Web 服务器在药物发现和毒性预测中发挥了重要作用。这些平台早期主要采用支持向量机(support vector machine,SVM)、随机森林(random forest,RF)等机器学习方法。
2012 年,Cheng 等推出了 admetSAR,这是该领域较早出现的 Web 服务器之一。该平台基于从文献中整理得到的约 21 万个化合物数据,采用 SVM 构建预测模型,覆盖 5 个回归任务和 22 个分类任务,为后续 ADMET 在线预测工具的发展奠定了基础。
到 2015 年,Pires 等开发的 pkCSM 进一步整合了多种机器学习方法,包括 RF、逻辑回归(logistic regression,LR)和模型树回归(model tree regression,MTR),并基于超过 11.2 万个化合物的数据预测 ADMET 性质。pkCSM 可完成 14 个回归任务和 17 个分类任务的预测,进一步展示了不同机器学习方法在 ADMET 性质分析中的广泛适用性。
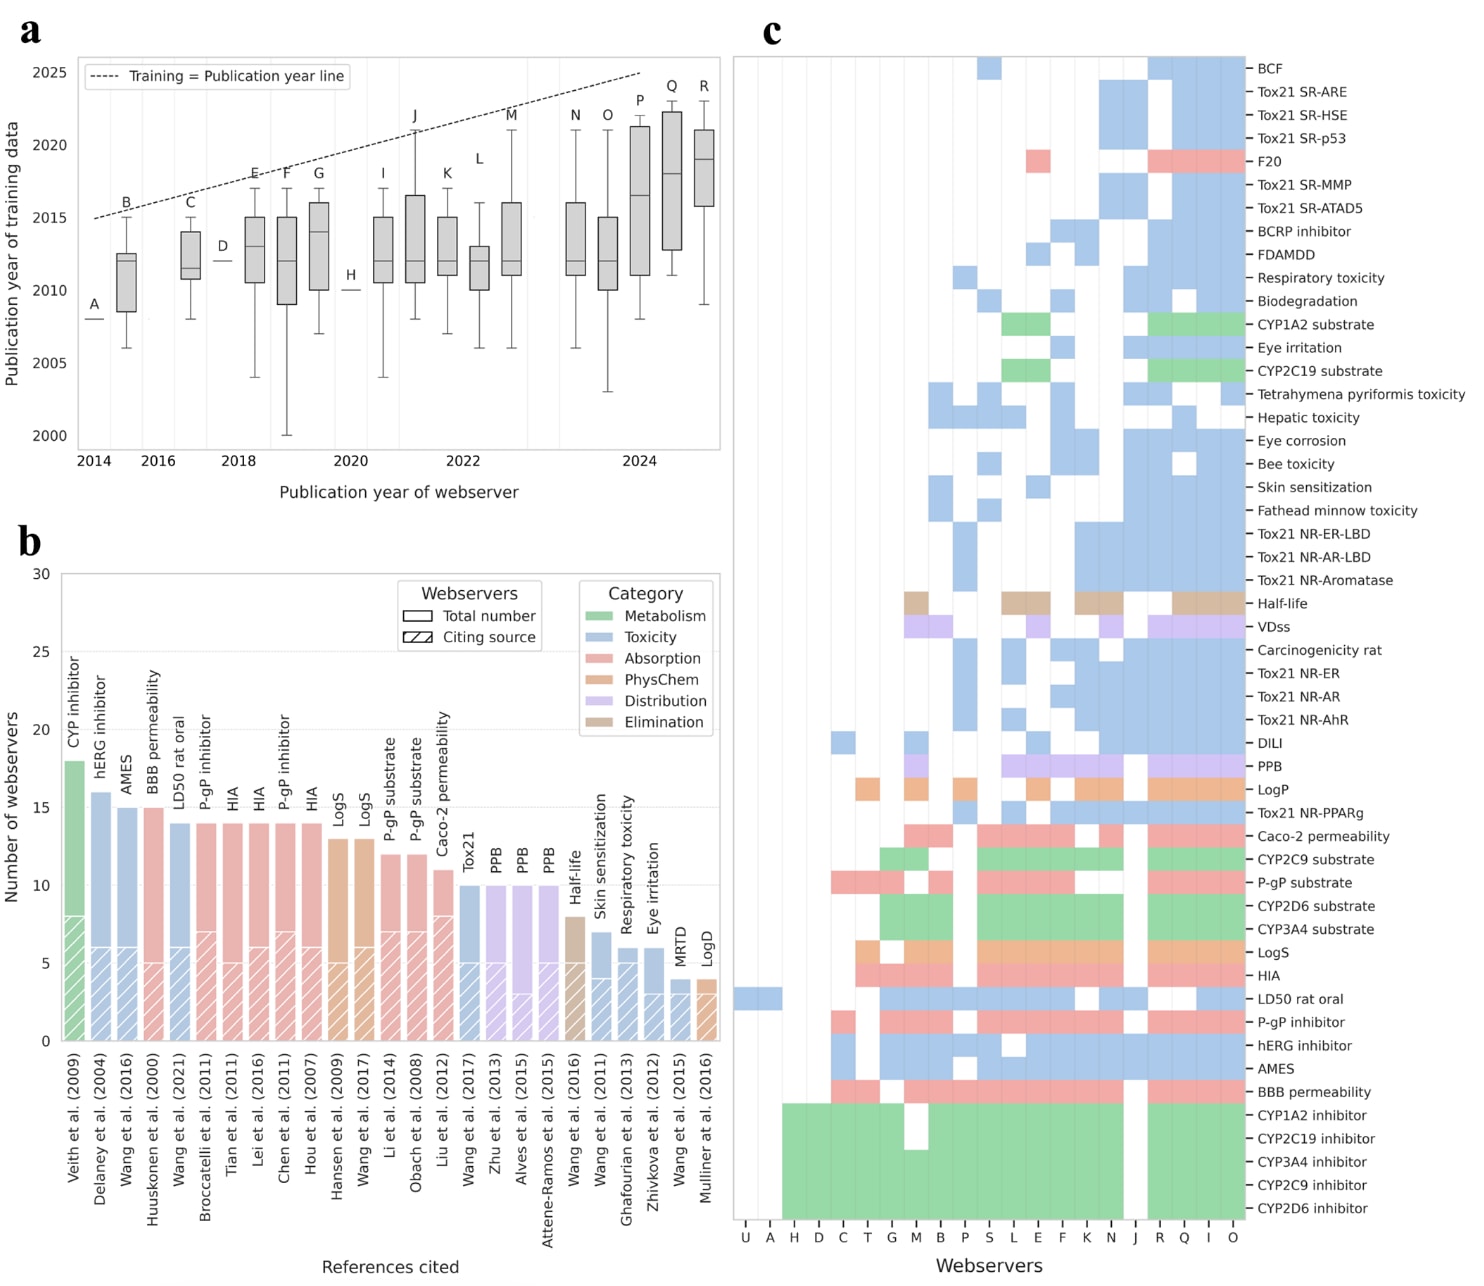
图2|Web 服务器所使用数据及预测终点的分析。 a,Web 服务器发表年份与其训练数据发表年份分布的箱线图。虚线表示数据发表年份与 Web 服务器发表年份相同的时间线。图中仅纳入明确引用数据来源的 Web 服务器,并标注为:A,ProTox-II;B,pkCSM;C,vNN-ADMET;D,DeepCYP;E,ADMETlab;F,admetSAR 2.0;G,Admet-score;H,SuperCYPsPred;I,ADMETlab 2.0;J,toxCSM;K,I-ADMET;L,H-ADMET;M,ADMETboost;N,ADMET-AI;O,Deep-PK;P,Protox 3.0;Q,ADMETlab 3.0;R,ADMETsar 3.0;S,admetSAR;T,SwissADME;U,Predictor NCATS。b,Web 服务器最常引用参考文献的计数图。实心柱表示提供相应终点预测的 Web 服务器数量,斜线填充柱表示针对该终点引用相应文献来源的 Web 服务器数量。c,各 Web 服务器所提供热门 ADMET 终点的热图。空白区域表示对应 Web 服务器未提供该终点的预测。
1.4 基于多任务学习模型的 Web 服务
2018 年,随着多任务学习方法的引入,ADMET Web 服务的发展格局开始发生变化。Li 等开发的 DeepCYP 是较早采用多任务学习方法的工具之一,其基于包含约 13,000 个化合物的数据集,利用自编码器(autoencoder,AE)预测化合物与细胞色素 P450(cytochrome P450,CYP)酶之间的相互作用。
到 2021 年,基于深度人工神经网络的 ADMET 模型进一步增多。当年新提出的 10 个 Web 服务中,有 8 个采用了不同类型的 MTL 架构。例如,Xiong 等开发的 ADMETlab 2.0 使用图注意力 Transformer 网络(graph attention transformer,GAT),基于来自 ChEMBL、PubChem、OCHEM 和 EPA 数据库的约 25 万个化合物进行建模,可预测 13 个回归任务和 40 个分类任务。
与此同时,ADMET 模型训练数据的平均规模也显著扩大,逐渐接近 20 万个化合物,并覆盖数百万条数据记录。这一增长反映了可用化学数据资源的持续扩充。
表3|2012—2021 年可用于 ADMET 与生物活性分析的 Web 服务器列表
1.5 数据过度复用与实际现状
当前 ADMET Web 服务器面临的一个关键问题,是对相同数据集的过度依赖。这导致不同平台之间存在显著的数据重叠,也使各平台所谓的“独特性”受到质疑。许多常用 Web 服务器,如 admetSAR、ADMETlab 和 ADMET-AI,均使用了 Tox21、TDC 等数据集,相关情况见表 1 和表 2。
其中,Tox21 数据被频繁使用尤其值得关注,因为该数据集仅覆盖相对有限的毒性终点,其对于全面 ADMET 建模的实际价值存在一定局限。此外,不同服务器通常缺乏对数据整理过程的详细说明,这意味着其数据预处理可能较为有限,从而潜在影响模型的可靠性。
与此同时,尽管近年来 ADMET 多任务学习研究所使用的数据规模持续扩大,部分研究已达到 100 万至 200 万个化合物,但许多 Web 服务器仍未覆盖如此广泛的化学空间。
此外,一些平台还存在可访问性问题。例如,H-ADMET 在论文发表时仍可公开访问,但目前已限制为需要百度账号的用户使用,这实际上降低了中国以外用户的可访问性。
表4|2022—2024 年可用于 ADMET 与生物活性分析的 Web 服务器列表
1.6 Web 服务器之间的数据与任务重叠
尽管不同 ADMET Web 服务器看似提供了各具特色的功能,但进一步分析可以发现,它们在所使用的数据集和提供的预测任务方面存在大量重叠,这也使不同平台之间的实际差异及其应用价值受到质疑。图 2 展示了这些 Web 服务器采用的主要数据集及所覆盖的预测任务。
数据是 ADMET 建模中的稀缺资源,需要依赖领域专家进行整理,才能转化为适合模型训练的数据。图 2a 比较了 Web 服务器的发表年份与其所使用数据的发表时间。多数数据来源可追溯至 2012 年左右,即使是 2024 年发表的 Web 服务器,其大部分数据仍主要来自 2012—2015 年,与当前公共数据库的实际发展水平存在超过 10 年的时间差。只有 ADMETlab 3.0 和 admetSAR 3.0 似乎采用了相对较新的数据来源,其发表时间距今约 5 年。与此同时,新数据的整理和质量控制仍较为有限(表 3 和表 4)。
图 2b 展示了不同预测终点引用相同数据来源的比例。总体来看,至少一半的 Web 服务器似乎建立在相同的数据集之上,并且除 SMILES 标准化外,通常没有进行额外的数据整理(表 3 和表 4)。需要指出的是,该统计仅涵盖明确注明数据来源的研究,因为部分研究并未报告其数据来源。
图 2c 展示了这些 Web 服务器中最常见的预测任务。其中,占比最高的是细胞色素 P450(CYP)抑制剂和底物预测任务,其数据主要来源于 Veith 等和 Carbon-Mangels 等构建的数据集。这些数据集已被纳入 TDC,并被几乎所有 ADMET Web 服务器广泛使用,其中约一半的平台明确引用了这些来源。
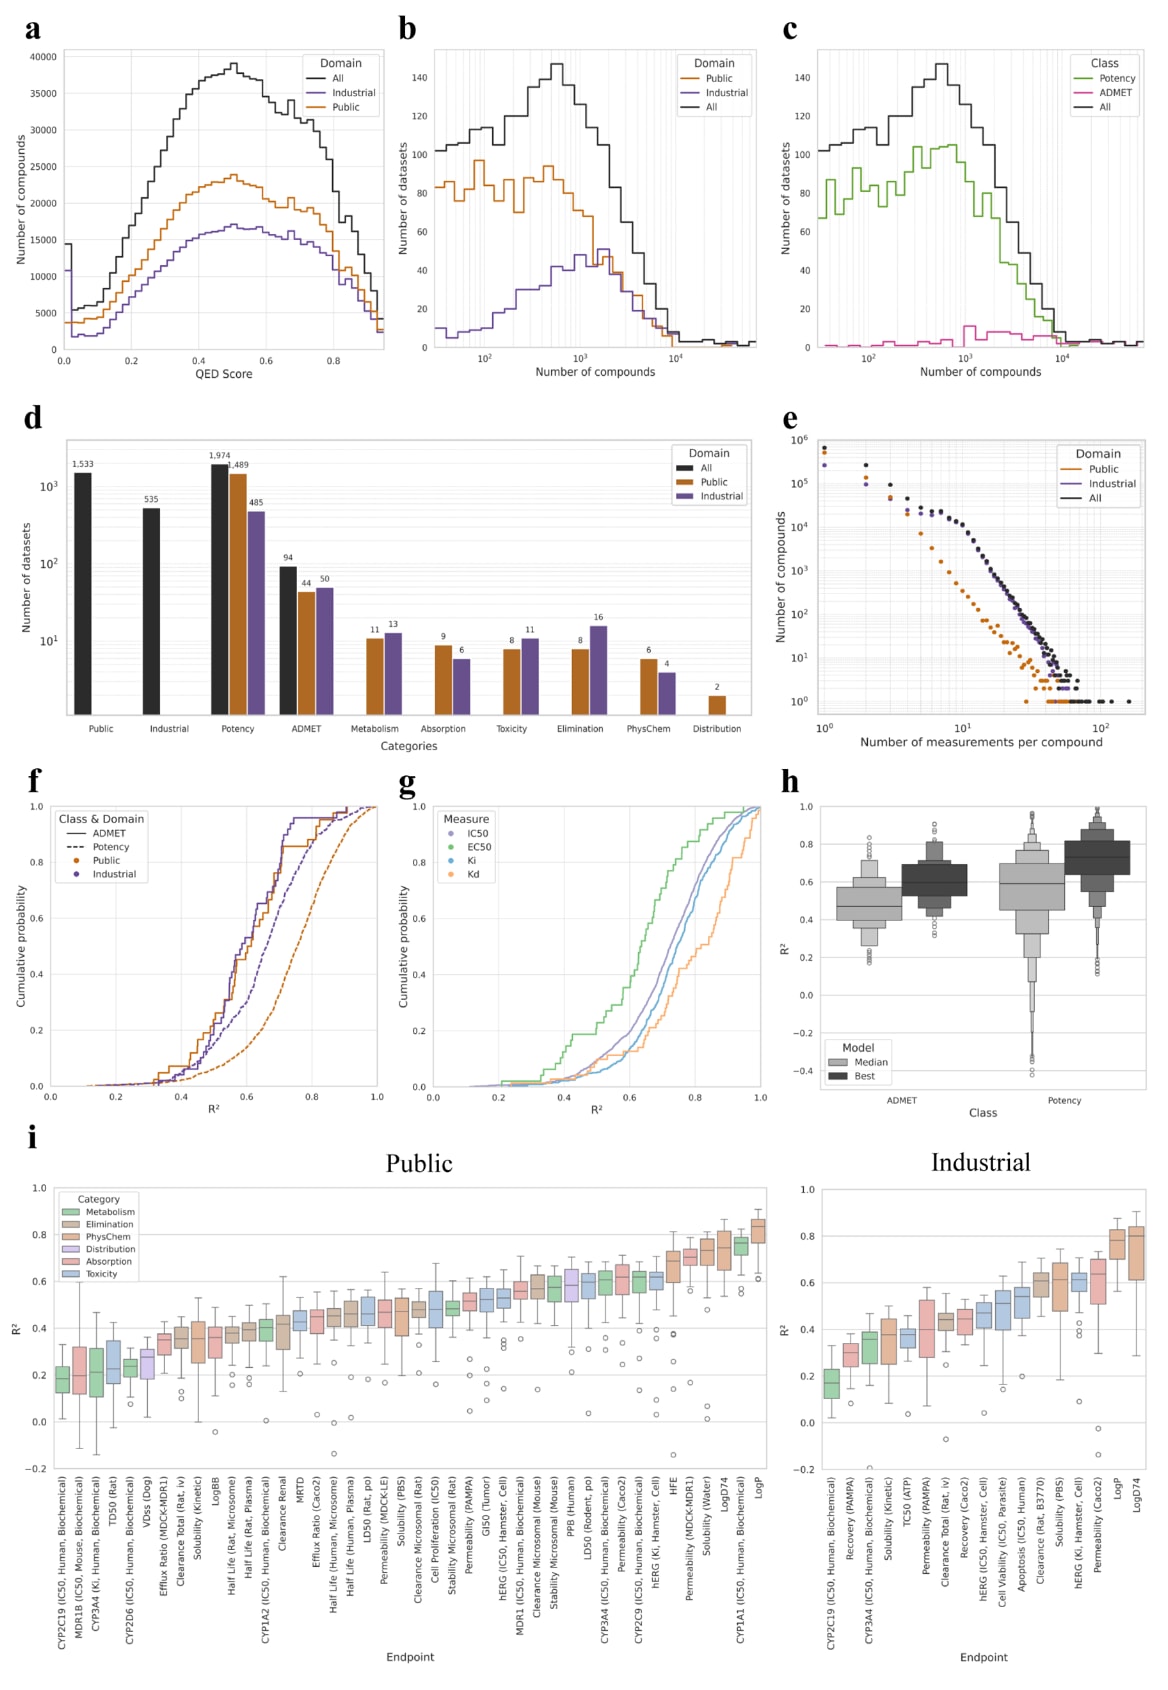
图3|OneADMET 数据概览:从类药性指标到各 ADMET 终点的整体
此外,使用频率较高的数据还包括 Martins 等提供的血脑屏障(blood-brain barrier,BBB)通透性数据、AqSolDB 中的水溶解度(LogS)数据,以及 Hou 等提供的人体肠道吸收(human intestinal absorption,HIA)数据。Broccatelli 等整理的 P-糖蛋白(P-glycoprotein,P-gP)数据也被广泛使用。Zhu 等研究中的 LD
这些平台在数据来源、预测任务上的高度重叠,以及数据整理不足和数据集老化等问题表明,许多 Web 服务器并未采用专门的数据整理策略来进一步提升预测模型的数据质量,从而削弱了不同平台之间的独特性及其整体有效性。很多情况下,数据集几乎被直接用于建模,研究者主要依赖既有研究结果的可靠性,而较少补充近年来新增的实验测量数据。
然而,将不同研究中的实验数据进行汇总本身就容易受到实验条件不一致等异质性因素的影响。随着数据处理实践以及对相关数据的理解不断深入,即使是来源可靠、已经发表的研究数据,也有必要定期重新审视,并结合新的认识和实验数据进行必要的更新。
2 结果与讨论
OneADMET 是一个经过领域专家严格整理的公共数据集,旨在支持药物发现领域稳健且透明的预测建模。OneADMET 整合了来自多个公共来源的高质量数据,并尽可能保证一致的数据收集规范。其中,与 ADMET 相关的终点数据主要来源于 OChem 和 ChEMBL,生物活性数据则主要来源于 OChem 和 BindingDB。OneADMET 指公开发布的数据集,而包含工业数据的扩展版本由于涉及工业数据无法公开。
公开版 OneADMET 共包含 738,161 个化合物和 1,119,719 条测量记录(图 S1a 和 S1b)。其中,大多数化合物符合定量药物相似性(QED)标准(图 3a)。该数据集共覆盖 1,533 个终点,包括 44 个 ADMET 终点和 1,489 项生物活性。生物活性数据主要由 IC
工业数据集与 OneADMET 公共数据集之间的差异,体现了工业测量更加聚焦和系统化的特点。例如,Caco-2 通透性、LogD
OneADMET 主要划分为两个数据域:ADMET 终点和生物活性任务。尽管生物活性任务的数量更多,但 ADMET 任务对应的数据集通常更大,每个任务一般包含 1,000~10,000 个化合物;相比之下,每个生物活性任务通常仅包含 100~1,000 个化合物(图 3c 和 3d)。
该研究进一步分析了每个化合物对应的测量终点数量。公共数据集中的化合物通常仅在单一终点上进行测量(图 3e),而工业数据集中的化合物一般会测量约 2~3 个终点。这进一步体现了制药研发流程中系统化的化合物评估方案。
为探索不同任务之间的关系,该研究根据任务之间共享的化合物构建了相关性矩阵。在 OneADMET 的公共数据集中,约 50% 的任务表现出正相关或负相关,并由此形成多个相互关联的活性任务簇。这些聚类通常能够将预期存在关联、且已在其他研究中报道过的任务归为一组。例如,CYP pIC
工业数据集表现出更强的任务相关性。由于工业数据中的测量方式更加一致,一些在公共数据集中难以观察到的任务关系能够更加清晰地体现出来。在工业药物研发过程中,化合物通常不仅针对目标生物学性质进行研究,还会较为系统地测定微粒体稳定性、LogD
进一步分析不同终点之间的化合物共享情况发现,公共数据集中不同终点之间的重叠程度相对有限,例如 CYP 与微粒体清除率之间的化合物共享较少(图 S4)。相比之下,工业数据集中相关终点之间的化合物测量具有较高重叠度,这反映了工业药物开发流程的系统性。例如,在研究化合物目标生物学性质的同时,通常还会常规评估微粒体稳定性、LogD
基于这些观察,可以预期不同任务之间的相关性能够进一步转化为 MTL 建模中的协同效应。高度相关的任务簇往往反映了共同的底层过程或作用机制,因此有助于 MTL 利用任务之间的相互依赖关系,从而提升模型学习效果。
2.1 机器学习方法的开发
公开版 OneADMET 数据集被用于开发预测模型。这些模型一方面用于评估各个任务的可建模性,另一方面也作为对数据集质量的验证。
模型训练采用 80% 的数据作为训练集,其余 20% 作为验证集。超参数优化被纳入整体训练流程,采用分层三折交叉验证,并进行 30 轮贝叶斯优化。整个建模过程以系统且一致的方式实施:所有模型均使用相同的数据划分方案进行训练、测试和交叉验证。单任务学习(STL)模型和多任务学习(MTL)模型也均基于完全相同的数据进行训练。
总体而言,该研究对 ChemProp 图神经网络(GNN)多任务模型进行了优化,并与多种当前主流方法进行基准比较,包括随机森林(Random Forest)、XGBoost、单任务 GNN、核岭回归(kernel ridge regression,KRR)、K 近邻(K-nearest neighbors,KNN)以及支持向量回归(support vector regression,SVR)。针对不同描述符与预测终点的组合,对各类方法进行了系统评估,以探索大规模特征空间下不同任务的可建模性。
2.2 ADMET 与生物活性终点的预测性能
预测模型的性能采用各终点对应的
首先可以观察到,两类模型在 ADMET 终点上的整体预测性能较为接近。其次,生物活性任务总体表现出更高的预测性能,其中
2.3 效力指标与终点复杂性
随后,研究进一步根据 IC
IC
不同效力终点的预测难度存在明显差异。其中,EC
IC
相比之下,
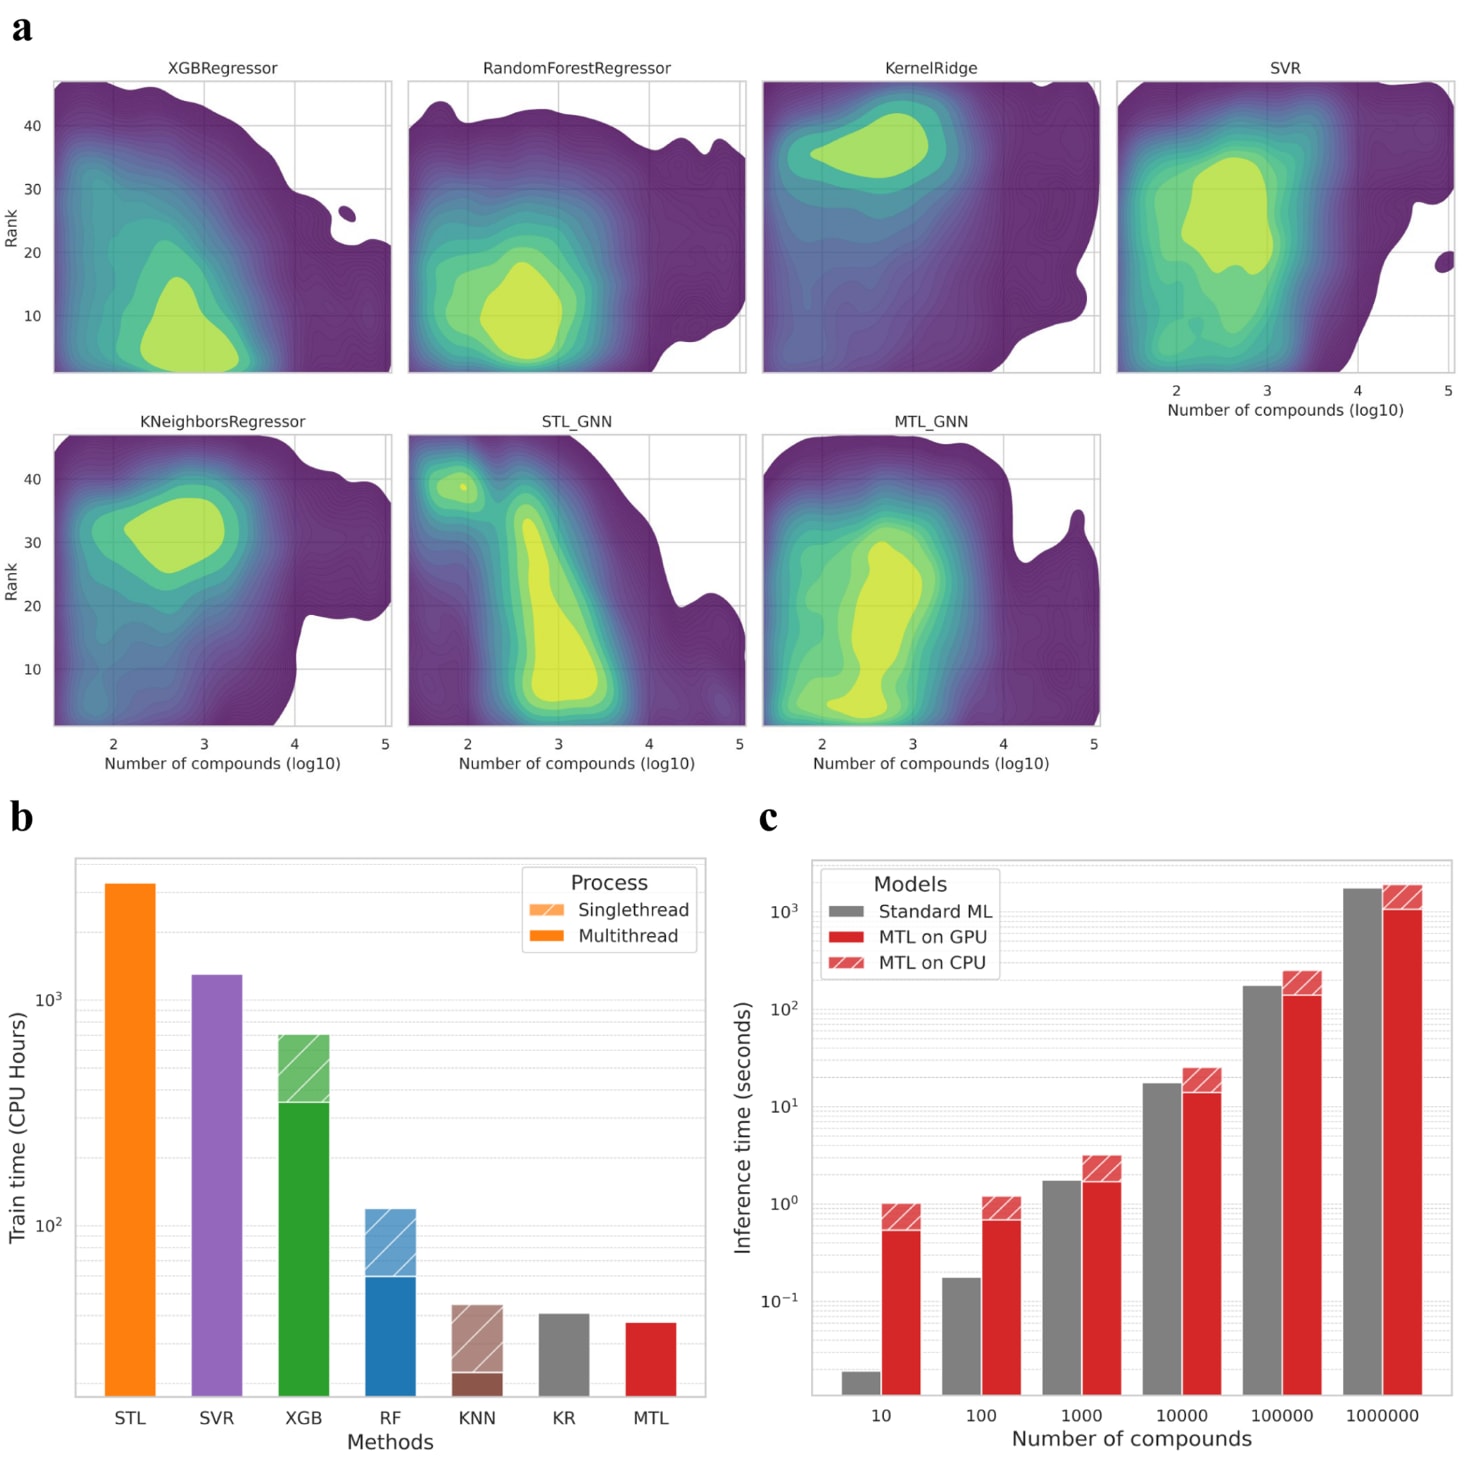
图4|预测模型性能分析。 a,测试集上模型性能排名随数据集规模以 10 为底对数变化的密度分布。颜色由紫色(低密度)到黄色(高密度)表示不同的数据密度。MTL,多任务学习;STL,单任务学习;ML,机器学习。b,不同方法针对全部预测终点进行模型训练和优化所需总计算时间的柱状图,以 CPU 小时计。对于 GNN 模型,该时间按照单 CPU 或单 GPU、单线程运行计算(虚线,非并行);对于 Random Forest、XGBoost 和 K-Nearest Neighbors 等支持多线程的方法,则采用多线程并行运行时间计算(非虚线,并行)。c,推理时间随化合物数量变化的关系,以秒计,分别比较标准机器学习方法(Random Forest)与多任务 GNN,并进一步比较 CPU(虚线)和 GPU(非虚线)上的运行性能。
3 总体预测性能
为评估所有预测模型的整体表现,该研究分别分析了各预测终点的中位
对于 ADMET 终点:
- 中位
通常位于 0.4~0.6。 - 最佳模型相较中位性能可提高约 0.1~0.2 的
,表明合理的超参数优化对于提升模型性能十分重要。
对于生物活性任务:
- 中位
通常位于 0.6~0.8,最佳模型的 则经常超过 0.8。 - 最佳模型相较中位性能通常可提高约 0.05~0.1 的
。
决定系数
此外,生物活性终点的预测性能表现出更大的波动,这可能与其数据集规模较小有关。部分数据集包含同系列化合物,并表现出较为明确的构效关系(structure–activity relationship,SAR),例如人苏氨酸酪氨酸激酶(TTK)的 p
不过,该研究并未进一步分析各个数据集中的异常值。部分误差可能仍然来源于某些生物学靶标定义不够明确所造成的歧义。例如,CDK2 活性通常默认是在 CDK2/cyclin A2 体系中测定,但实际实验设置仍需要进一步核实,以避免与其他细胞周期蛋白依赖性激酶实验、不含 cyclin 的亲和力测定,或与其他 cyclin 形成复合物的实验相混淆。NU6027(CHEMBL303948,BDB5566)就是一个可能因这类原因造成 CDK2 活性数据混淆的化合物实例。
此外,潜在误差来源还包括实验噪声、不同探针的使用、不同工程化蛋白或细胞系、化合物稳定性、DMSO 比例,以及底物浓度对 IC
不过,结果表明,生物活性终点总体上比 ADMET 终点更容易建模。这可能与 ADMET 数据中更高的实验噪声有关,对 ADMET 数据集和生物活性数据集的标准差(SD)进行比较时也观察到了这一现象。尽管如此,经过充分优化的 ADMET 终点预测模型仍能够取得具有竞争力的性能。
3.1 不同类别终点的预测表现
不同类别终点的
此前的研究也发现了类似问题,尤其是在 Caco-2 和 PAMPA 实验中。例如,通透性预测结果之间的差异往往与实验条件造成的变异有关,这使得公共数据难以直接与工业数据合并,也导致基于公共数据训练的模型难以直接应用于工业数据。外排比(efflux ratio)和表观通透性(apparent permeability)的测量进一步体现了这种差异。
以 Caco-2 实验为例,工业实验通常会加入牛血清白蛋白(bovine serum albumin,BSA),以改善对吸收过程的模拟;而公共数据集通常完全不使用 BSA,而采用相对简化的实验方案。类似地,不同 PAMPA 实验在膜类型、pH 梯度和转运条件等方面也存在差异,从而导致
测试集性能的箱线图表明,工业数据集与公共数据集的整体性能分布较为相似。主要差异出现在预测表现最差的一部分任务中,其中某些特定毒性指标的公共数据终点表现出最低的
3.2 方法比较
为评估不同分子描述符和建模方法对预测性能的影响,该研究在所有数据集上进行了系统比较,旨在识别特定描述符或方法更适用的情形,并评估 MTL 在大规模应用中的额外价值。具体而言,对于每个预测终点,根据均方根误差(RMSE)对所有模型进行排序。每个模型对应一种建模方法与一组分子描述符的组合,其中预测性能最好的组合获得最低排名(图 4a)。此外,还基于
部分公共数据集上的
该研究进一步通过 ADMET 和生物活性终点的模型排名热图,分析描述符、建模方法与预测性能之间的关系(图 S8a 和 S8b)。没有任何一种方法能够在所有方法中始终获得低于 7 的中位排名,说明不存在普遍优于其他方案的方法与描述符组合。不过,XGBoost 的整体表现持续优于 RF,而 RF 又优于其他多数方法。
对于生物活性终点,Avalon 和 ECFP 描述符的性能略占优势;而对于 ADMET 任务,不同描述符之间的性能差异更加明显。总体而言,XGBoost 或 RF 与 Avalon 或 ECFP 描述符组合,是对新数据集开展建模时较为可靠的选择,仅需有限的超参数优化即可获得较好的预测性能,
进一步分析发现,将所有终点的
即便进行了严格的数据整理,实验条件差异仍可能影响模型性能,因为大量样本可能缺乏完整、规范的元数据注释,从而限制了数据集的进一步清理和优化。同时,实验本身固有的噪声也会进一步加剧这一问题。例如,转运蛋白表达水平、测量条件以及化合物自身性质,包括亲脂性及其对实验器材的吸附亲和性等,都可能增加测量变异。因此,无论数据集规模多大,都很难持续获得非常高且稳定的预测性能。
结果显示,当数据集规模约为 1,000 个化合物时,模型性能出现一个较明显的峰值,
这一结果尤其值得关注,因为 MTL 的一个重要优势正是能够借助大规模联合训练,从相关任务中补充数据稀缺任务所缺失的信息,从而提高统计模型在小样本数据集上的泛化能力。该研究表明,即使采用默认的任务权重方案,这种统计优势仍能够在如此大规模的 MTL 模型中得到体现。
3.3 Web 服务器比较
该研究未与现有 ADMET Web 服务器,如 ADMET-AI、ADMETlab 3.0 或 admetSAR 3.0,进行直接的基准性能比较。不同 Web 服务器采用的数据来源、终点定义、数据整理流程以及训练集/测试集组成均存在差异。即使针对名义上相同的预测终点进行比较,也会同时混入数据质量、数据规模、终点定义和模型架构等多种因素,因此无法将观察到的性能差异明确归因于某一个单独因素。
3.4 数据划分策略
该研究在方法学上的一个局限,是训练集与测试集划分采用了分层随机划分。尽管基于骨架的划分或时间划分通常更适合评估模型在前瞻性场景下的泛化能力,但在如此大规模的数据条件下,这两种方法都面临明显的实际限制。
对于基于骨架的划分,研究共涉及 1,533 个任务,而不同任务的数据集规模高度不均衡,从 30 个到超过 100,000 个化合物不等,同时不同终点之间共享的化合物也较少。如果统一采用骨架划分,将导致大量终点在测试集中仅剩极少数据,甚至完全没有数据,从而无法进行系统性评估。
时间划分则要求每条实验测量记录具有一致、可靠的实验时间或数据入库时间。然而,在 ChEMBL、OChem 和 BindingDB 等公共数据库中,如此大规模的数据并未系统提供这些时间信息。
需要强调的是,这里并不存在传统意义上的数据泄漏问题。与那些在数十亿个化合物上进行预训练的基础模型不同,该模型仅接触过 OneADMET 的训练数据。同时,通过全局约束确保任何同时出现在多个终点数据集中的化合物,在所有任务中只能被统一分配至训练集或测试集,而不会同时出现在二者中。
不过,随机划分仍可能导致性能估计偏乐观,尤其是对于包含大量同系列化合物的终点。补充信息图 S10 给出了训练集与测试集之间 Tanimoto 相似度的分布,供进一步评估这一影响。
3.4.1 ADMET 与生物活性的联合建模
将 ADMET 终点与生物活性任务整合到同一个多任务学习框架中,主要出于技术和实际运行层面的考虑,而非基于二者在生物学机制上的一致性假设。
统一模型可以在一次推理过程中同时完成多个维度的生物学性质分析,并且相比维护多个彼此独立的模型体系,更有利于模型的部署和后续维护。尽管 ADMET 性质与特定靶标生物活性背后的生物学机制并不相同,但药物研发所关注的化合物在这两个领域之间存在较大重叠,因此 GNN 编码器学习到的共享分子表示可能捕获同时与多种预测任务相关的结构特征。
不过,目前尚不能确定同时学习 ADMET 与生物活性任务是否能够直接提升预测性能,这一问题仍有待未来研究进一步验证。
3.4.2 多任务学习终点之间的协同效应
多任务学习相较单任务学习何时能够提高性能、何时反而会降低性能,是一个复杂且高度依赖具体任务的问题。此前针对通透性预测的研究中,已经专门考察了 Caco-2 和 PAMPA 实验中任务协同效应出现的条件。
然而,在当前研究规模下,共涉及超过 1,533 个任务,并覆盖多种不同类型的预测终点。如果要系统比较不同任务组合并开展消融实验,将需要非常庞大的计算资源;同时,在如此高维的参数空间中解释任务协同效应也十分困难。
因此,该研究并未声称已经在这一规模上证明了任务协同效应。不过,数据中观察到的任务间相关性(图 S2 和图 S3)与潜在的协同学习效应是一致的。
3.4.3 不同数据集规模下的方法排名比较
为进一步评估不同方法的性能,该研究分析了模型排名随数据集规模变化的关系(图 4a)。
对于小型数据集(少于 500 个化合物),STL GNN 的表现往往较差,而 MTL GNN 通常仍能保持较高排名。此类小数据集上,SVR 和 KNN 也具有较强竞争力。
对于中等规模数据集(500~5,000 个化合物),XGBoost 和 RF 的整体效率更高,其中 RF 在样本量相对较少的数据集上表现更为突出。不过,STL GNN 和 MTL GNN 同样属于较优的候选方法。值得注意的是,随着数据集规模增大,MTL 和 STL 的相对排名会发生交换:MTL 更适合较小数据集,而 STL 在较大数据集上更具优势。
对于大型数据集(超过 5,000 个化合物),STL GNN、MTL GNN 和 XGBoost 成为表现最好的几类方法。总体来看,MTL GNN 和 XGBoost 在较广泛的数据集规模范围内都具有较好的适用性。
相比之下,Kernel Ridge 的表现持续处于劣势。与 SVR 不同,Kernel Ridge 在建模时会使用数据集中的所有数据点,并采用二次损失函数,因此对异常值更加敏感。该研究推测,要使这种方法充分发挥性能,可能需要更高质量的数据,同时还需更系统地探索核函数空间。
3.4.4 训练与推理的计算效率
模型开发还需要考虑分子描述符计算、模型训练和推理所需的计算时间。该研究分析了不同数据集规模下的训练时间(图 S8d)。
所有计算均在 Amazon Web Services 上完成,使用多台 g5.4xlarge 实例,每台配置 16 个 CPU、64 GB 内存和 1 块 NVIDIA A10G GPU,并在实例内部进行并行计算。CPU 多线程和 GPU 的计算时间采用 timeit 模块进行估算,因此文中报告的时间结果仅作为参考。
对于 MTL,报告的是同时覆盖所有终点的整个模型训练时间;对于 STL,则报告依次训练所有单任务模型所需的总时间。所报告的计算时间也包括分子描述符计算。
SVR、KNN 和 Kernel Ridge 的训练时间对数据集规模表现出较强依赖性。当数据集较大时,SVR 的训练时间逐渐接近 STL GNN。在所有方法中,STL GNN 的训练速度最慢,而 MTL、RF 和 XGBoost 的扩展性最好。MTL GNN 的训练时间与 XGBoost 大致相当。
此外,MTL 方法只需要进行一次超参数优化,而一系列 STL 模型则需要针对每个任务分别优化超参数。因此,从整体建模流程来看,MTL 能够显著减少模型开发和维护成本。
推理速度同样是实际应用中的关键因素。推理时间采用单台 g5.xlarge 实例进行测试,其配置为 4 个 CPU、16 GB 内存和 1 块 NVIDIA A10G GPU,并分别采用 CPU 或 GPU、单线程或多线程方式运行。
该研究比较了 RF、SVR 等传统方法与 MTL GNN 在 CPU 和 GPU 上处理不同规模数据集时的推理时间(图 S9)。结果表明,数据标准化和分子描述符计算是主要的计算瓶颈。
无论采用哪种方法,推理时间均会随待预测数据集规模近似线性增长。当数据集规模超过 10,000 个化合物时,GNN 方法表现出更高的推理效率。作者推测,这可能源于 GNN 对嵌入式分子特征表示的计算更加高效。此外,MTL GNN 能够充分利用 GPU,在处理最大规模数据集时表现出显著更快的推理速度。
3.5 适用域
当预测模型应用于此前未见、且在分子结构或响应值上与训练样本存在明显差异的数据时,其预测结果往往缺乏可靠性控制。为降低这一风险,预测模型需要在适用域(applicability domain,AD)范围内运行。适用域用于识别待预测化合物是否位于模型已经学习到的化学空间之内。
对于每个预测终点,该研究采用局部离群因子(Local Outlier Factor,LOF)算法构建 AD,并使用标准超参数:n_neighbors = 20,contamination = 0.2。LOF 是一种基于密度的异常值检测方法,通过比较样本的局部密度与其邻近样本的局部密度识别异常点。LOF 得分接近 1 表示该化合物在训练化学空间中具有较好的代表性,而较高的得分则提示该化合物位于化学空间中代表性不足的区域。
对于每个终点,AD 均基于构建相应 STL 模型时所使用的描述符集合进行定义,从而保证 AD 与对应数据集以及 STL、MTL 模型之间的一致性。只有当 LOF 过滤后至少有 10% 的测试集化合物位于 AD 内时,才进一步讨论相应的外部验证性能指标。不同终点的 AD 覆盖率分布见图 S11。
目前的 AD 实现方式基于各个独立预测头,并未考虑多任务 GNN 中共享的分子表示。对于大规模 MTL 模型而言,如何合理定义适用域仍然是一个尚未解决的问题。共享编码器需要处理数十万种结构高度多样的分子,而每个预测头对应的训练样本可能仅有几十到数千个,并且各自具有不同的化学空间分布。因此,对这种复杂模型进行完整的适用域表征超出了该研究的范围,针对大规模 MTL 模型开发专门的 AD 方法仍有待未来进一步研究。
为更直接地量化 MTL 相对于 STL 的性能差异,图 S12 展示了所有终点中
4 结论
该研究通过将统一的 MTL 框架与大规模 OneADMET 数据集相结合,为提升药物发现中的预测建模能力提供了一套系统性方案。OneADMET 共涵盖 738,161 个化合物和 1,119,719 条测量数据,覆盖 44 个 ADMET 终点和 1,489 项生物活性指标,为长期以来的数据资源局限提供了更系统、更可靠的解决方案,可同时服务于学术研究和工业应用。
该研究的主要贡献包括两个方面:第一,对当前 ADMET 预测 Web 服务器及其数据使用方式进行了系统性评述,揭示了该领域普遍存在未经充分整理的数据集被反复使用的问题;第二,构建并发布了经过严格整理的 OneADMET 数据集,作为现有数据资源的一种高质量替代方案。
该研究采用标准 ChemProp 架构构建预测模型,其目的并非提出新的模型结构,而是验证严格数据整理流程的质量,并说明在标准模型设计下,高质量数据同样能够获得具有竞争力的预测性能。整个数据构建过程采用严格的数据标准化方案,包括仔细过滤重复记录、尽量降低实验噪声以及实施严格的质量控制。这种数据基础更准确地反映了药物发现中复杂的化学和生物学现实,也延续了此前关于整合异质数据时应加强系统性处理的研究思路。
从 STL 转向 MTL 具有多方面优势。STL 需要针对每个预测终点分别进行超参数优化,随着任务数量增加,计算复杂度也会显著上升。相比之下,MTL 可以通过一次统一的优化过程覆盖所有任务,从而简化建模流程并降低额外计算开销。
MTL 中共享的潜在表示还有助于捕获任务之间的依赖关系,例如 CYP 抑制、微粒体稳定性和亲脂性之间的相关性。这一观察与此前研究结果一致,并进一步说明 MTL 在数据有限的情况下可能具有更明显的预测优势。将多个预测任务整合到同一个模型中,也能够减少模型部署和长期维护的复杂度,相比维护大量独立 STL 模型更加高效。
尽管对于单一终点而言,MTL 看起来可能比实际需要更加复杂,但其真正价值在于整合多个相关终点,从而提供更加丰富的预测信息。与此同时,其推理时间仍可与 STL 模型保持相近,因为二者都需要经历类似的分子结构标准化和特征计算过程。
在模型性能方面,ADMET 任务的最佳
不过,该领域仍然存在若干挑战。实验条件差异带来的数据变异仍会持续影响模型性能,这一点此前也已被多位研究者强调。针对这一问题,Polaris 等项目正在推动更加严格的数据整理和数据可访问性建设,以减少不同数据源之间的不一致性。类似地,OpenADMET 也致力于构建由社区驱动、开源、透明且可重复的 ADMET 预测工具。此外,联邦学习以及整合型数据库的发展,也为进一步提升相关模型提供了潜在方向。
未来,OneADMET 数据集与统一 MTL 框架可作为进一步发展大规模多任务药物预测模型的基础。后续工作应重点关注持续的数据整理、开发适用于大规模多任务架构的适用域方法、进一步优化 AD 定义,并持续纳入新的实验测量数据,以覆盖更加复杂的生物学相互作用。
此外,如果能够进一步整合更多化学和生物学信息,模型预测性能仍有提升空间。与此同时,模型可解释性、不确定性估计以及多模态数据融合等方向的持续发展,也有望推动预测方法进一步进步,最终形成更加高效、可靠的药物发现预测流程。