JACS 2024 | 强化学习提升化学反应性能
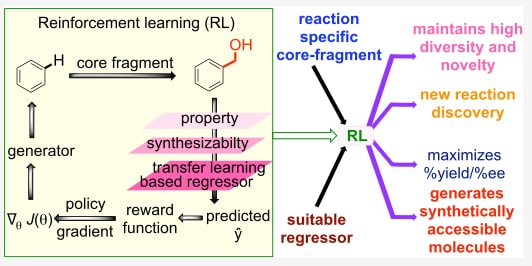
今天介绍的是发表在 JACS 上的一项研究工作。化学反应发现与优化长期依赖实验经验、化学直觉以及大量试错过程,而复杂反应空间的高效探索仍然面临效率低和成本高等挑战。该工作提出了RE-EXPLORE,一种结合深度强化学习(RL)与基于循环神经网络(RNN)的深度生成模型框架,用于识别具有更高产率和选择性的潜在反应物与催化剂。该方法利用迁移学习模型预测反应结果,并通过改进奖励函数增强化学空间探索能力,避免模型重复生成相似分子。在三类不同反应任务中的实验结果表明,RE-EXPLORE能够发现高产率底物以及具有高对映选择性的手性催化剂,为人工智能辅助化学反应发现和药物分子合成规划提供了新的研究方向。
获取详情及资源:
0 摘要
深度学习(DL)方法已经在分子空间中的预测任务和生成任务中获得了显著关注。然而,其在化学反应中的应用仍然严重不足。化学反应本质上具有复杂性:除了断键/成键事件外,通常还涉及多个分子。在反应发现过程中,目标是最大化产率和/或选择性,而这些性质取决于多个因素,主要集中于反应物以及反应条件。 在此,提出了RE-EXPLORE,这是一种新方法,将深度强化学习(RL)与基于循环神经网络(RNN)的深度生成模型相结合,用于识别潜在的新型反应物/催化剂,并利用预训练回归器估计其产率/选择性。 三个化学数据库(ChEMBL、ZINC和COCONUT,其中包含50万至100万个未标记分子)分别用于对生成模型进行预训练,以利用多样化化学空间中的有价值信息丰富模型。研究发现,标准强化学习方法存在不足,因为学习器倾向于优先进行能够获得即时收益的利用(exploitation),从而导致重复生成相同或相似分子。 构建的奖励函数在强化学习循环中加入了基于Tanimoto相似性的唯一性因子,提高了环境探索能力,并帮助模型获得更高的累积收益。将用户定义的核心片段整合到生成分子中,促进了模型对特定反应类型的学习。 总体而言,RE-EXPLORE能够引导反应空间向具有实际意义的区域移动,并在三种不同反应类型中实现显著提升。该方法能够识别高产率底物以及具有高度对映选择性的手性催化剂。 这种基于强化学习的方法具有加速反应发现以及辅助重要化合物(包括药物和药物分子)合成规划的潜力。
1 引言
化学反应的发现对于新药分子和材料的合成具有重要意义。寻找新型反应以及提高已知反应效率的努力一直处于该领域研究的前沿。 实际上,经验性发展依赖于多个因素,例如化学直觉和领域专家知识,以及在识别合适底物、兼容试剂和最佳反应条件过程中不可避免的一系列试错实验。这一阶段被称为反应开发/优化,其涉及对反应参数进行调整,以实现预期结果。 化学反应复杂性的明显来源在于多个分子的同时或连续参与(例如底物、催化剂、碱、添加剂、溶剂以及其他多种环境因素),这些因素共同作用以生成最终产物。 目标产物的形成程度通常以产率(%yield)表示,而产率取决于多个因素,例如反应物的性质和反应条件。对这种复杂、庞大且高维度反应空间的探索,使其成为一个具有吸引力的研究主题。 尽管已有大量已知反应可供利用,但合成复杂目标分子,例如抗感染化合物或抗癌化合物,通常仍然可能成为一项极具挑战性的任务。 在反应发现和底物范围扩展过程中,通常会产生大量分散的数据。随着数据驱动方法由于其能够从复杂输入参数空间中学习而越来越受到化学领域的认可,这些反应数据很可能成为反应发现过程中不可或缺的一部分。 有效利用机器学习(ML)技术进行反应发现具有潜力,并可能减少目前新反应发现所需的时间。 充分发挥这些工具的潜力,首先需要基于给定反应数据开发稳健的机器学习模型,而这些数据通常较为稀疏,仅包含数百或数千个样本。 目前,已经利用不同的分子特征化策略构建了具有潜力的模型,例如基于量子化学计算得到的描述符、捕获结构和连接性的分子指纹、分子图以及基于SMILES的方法。 大多数用于产率或选择性预测的机器学习模型都局限于学习训练数据中输出值范围内的关系,因此使外推任务变得不可行。 这一限制在反应发现过程中尤其突出,因为湿实验早期阶段通常只能获得较低产率的结果。 虽然可以采用基于模型的优化策略,例如贝叶斯优化(BO),但该方法可能涉及依赖预定义搜索空间的评估过程,以及所采用代理模型准确性的影响。 鉴于典型的反应开发目标是在保持合理实验成本、危险性和时间等条件下最大化产率和/或选择性,可以考虑采用逆向设计方法,以加速对大型设计空间的探索。 机器学习模型应能够识别在目标反应中可能提供更高产率/选择性的潜在化合物。 理想情况下,该设计策略应生成产率高于训练集中反应的新分子。 有趣的是,基于深度学习(DL)的逆向设计,尤其是采用强化学习(RL)的方法,已经被发现能够有效应用于目标导向药物设计。 这些探索任务主要集中于分子性质的预测/优化,例如logP和药物相似性定量估计(QED)。 尽管强化学习在分子空间中取得了这些进展,但其很少被用于解决反应发现问题。 不同于性质预测中每次只涉及一个目标分子的情况,反应样本包含多个反应物/分子的分子表示。 因此,用于化学反应的强化学习设计是一项新颖且非简单的任务,需要及时关注。 这一关键问题可以通过图1a所示的一对异构醇分子进行理解。尽管二者具有几乎无法区分的logP和QED值,但在相同条件下进行氟化反应时,其产率分别为94%和65%。 产率之间的显著差异表明,针对化学反应性问题,需要创新的机器学习模型,而不能仅依赖现有的分子性质预测模型。 此时需要注意Gao等人和Chen等人关于反应条件推荐的几项有趣研究。Gao等人采用多类别分类方法结合回归模型预测反应温度,而Chen等人则专注于利用分类模型生成候选条件,并根据预测温度和相关性对其进行排序。 该方法与传统分类模型存在本质区别,因为其利用强化学习动态探索化学空间。 鉴于这一研究空白,以及反应发现本身的重要性,开发适用于化学反应的强化学习方案成为研究兴趣所在。 尽管大多数基于深度学习的生成模型能够将搜索空间引导至目标区域,但生成分子的质量以及其在可合成性方面的可行性并不总是得到评估(图1b)。 整合分子性质约束(例如分子量、电荷、可合成性评分等)可能有助于生成更加真实的分子。 这能够确保生成分子不仅满足预期标准,同时也更有可能通过实验验证。 对深度生成方法进行此类优化,可以帮助识别可合成分子,从而加速反应发现过程。 在此,展示了将策略梯度强化学习(RL)与循环神经网络(RNN)框架结合用于反应发现的方法。 利用迁移学习(TL)模型预测新生成分子产生的反应产率(图1c)。 强化学习用于引导新分子的生成,使其趋向更高产率/选择性的区域。 构建了一种基于片段的方法,其中用户定义的核心片段与生成字符串相结合,以促进针对三种不同反应数据集的反应特异性学习。 与已有实验数据相比,Reaction_A(醇的脱氧氟化反应)的平均产率、Reaction_B(手性磷酸(CPA)催化亚胺与硫醇偶联反应)的平均对映选择性,以及Reaction_C(利用轴手性催化剂对亚胺或烯烃进行不对称氢化反应)均实现了显著提升。 所提出的模块化框架能够加速设计-制备-测试-分析循环,从而解决反应发现过程中的主要瓶颈之一。
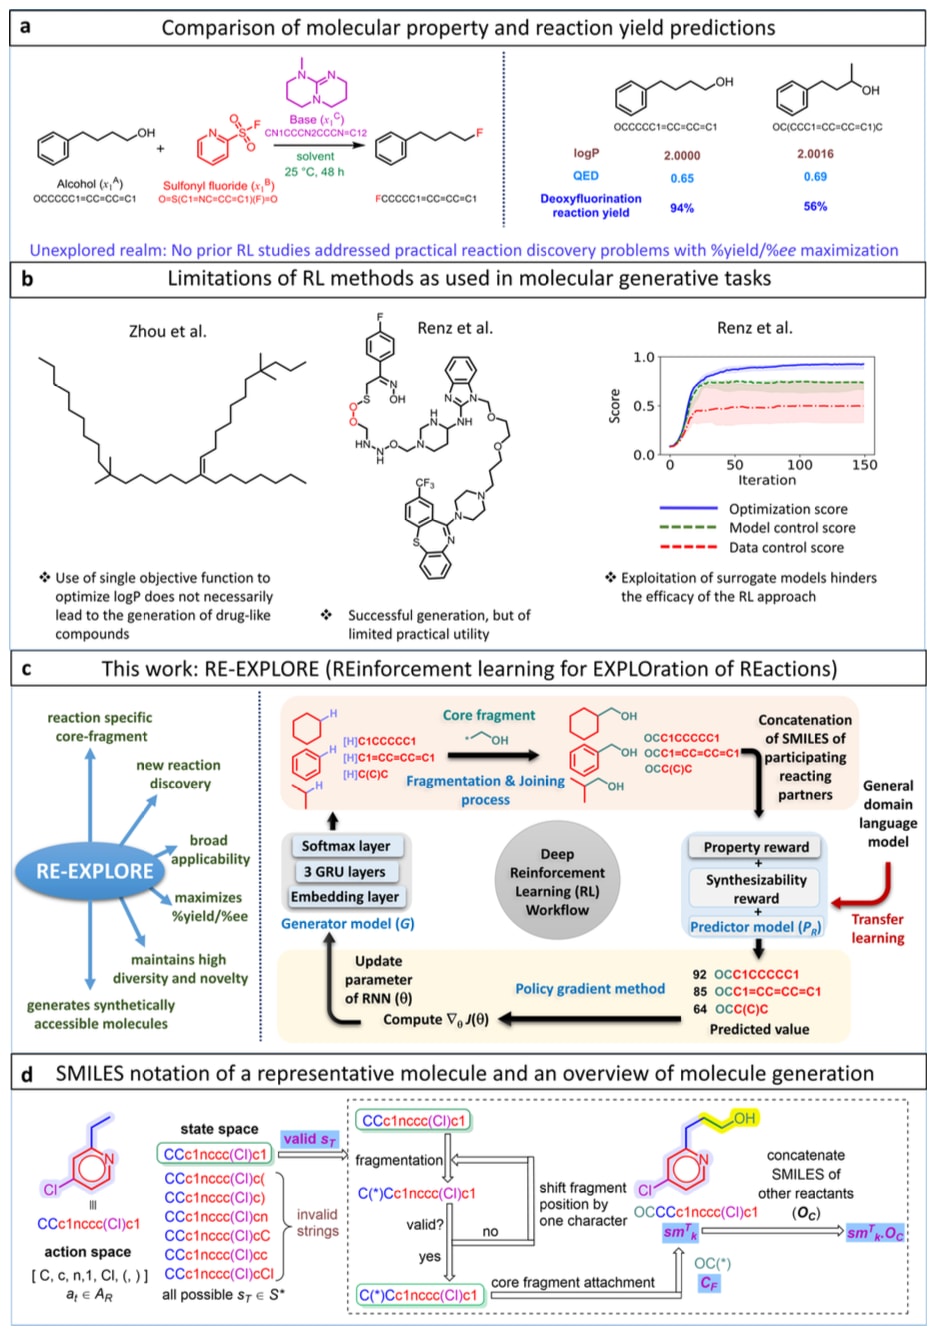
图1|RE-EXPLORE用于化学反应发现的强化学习框架 a. 代表性反应(醇的脱氧氟化反应)。展示了反应物(左侧)、试剂(箭头上方)以及产物(右侧)及其对应的SMILES字符串,同时展示了一对异构醇分子几乎相同的计算分子性质,以及通过相应产率揭示出的其在脱氧氟化反应中的差异性行为。b. 以往目标导向生成方法的局限性。c. 强化学习模型(RE-EXPLORE)的构建模块概述。d. 一个代表性分子的SMILES表示方式以及分子生成过程概述。展示了来自动作集合
2 结果与讨论
2.1 RE-EXPLORE框架
该方法结合了一个类似于大型语言模型(LLM)的自回归RNN化学语言模型、一个基于迁移学习(TL)的回归器(PR,用于预测产率/%ee(对映体过量值)),以及一个用于优化新分子生成的策略梯度强化学习算法。 RNN模型在由ChemBL/ZINC/COCONUT数据集中提取的、由元素∈{C、N、O、F、P、S、Cl、Br、I}组成的分子上进行训练。 在此,“分子”指的是一般性分子,而不是本研究中特定于任何反应的分子,并不明确包含与目标反应相关的反应物、产物、试剂、催化剂或溶剂。 每个分子首先通过对应的规范SMILES表示进行表示,该表示作为RNN模型的输入。典型的SMILES表示方式以及分子生成过程概述如图1d所示。 在RNN训练过程中,模型学习在给定前缀字符串的情况下生成下一个标记(token)的概率分布。 经过充分训练后的生成器(G)随后可以用于生成新的分子。 经过训练得到的生成模型和回归模型随后被用于构建强化学习(RL)工作流程,以优化反应结果。 生成器的参数(θ)被用作策略参数,而PR则提供反应结果的评价值。 状态空间S被定义为所有长度范围从0到T的终止字符串和非终止字符串的集合。 动作
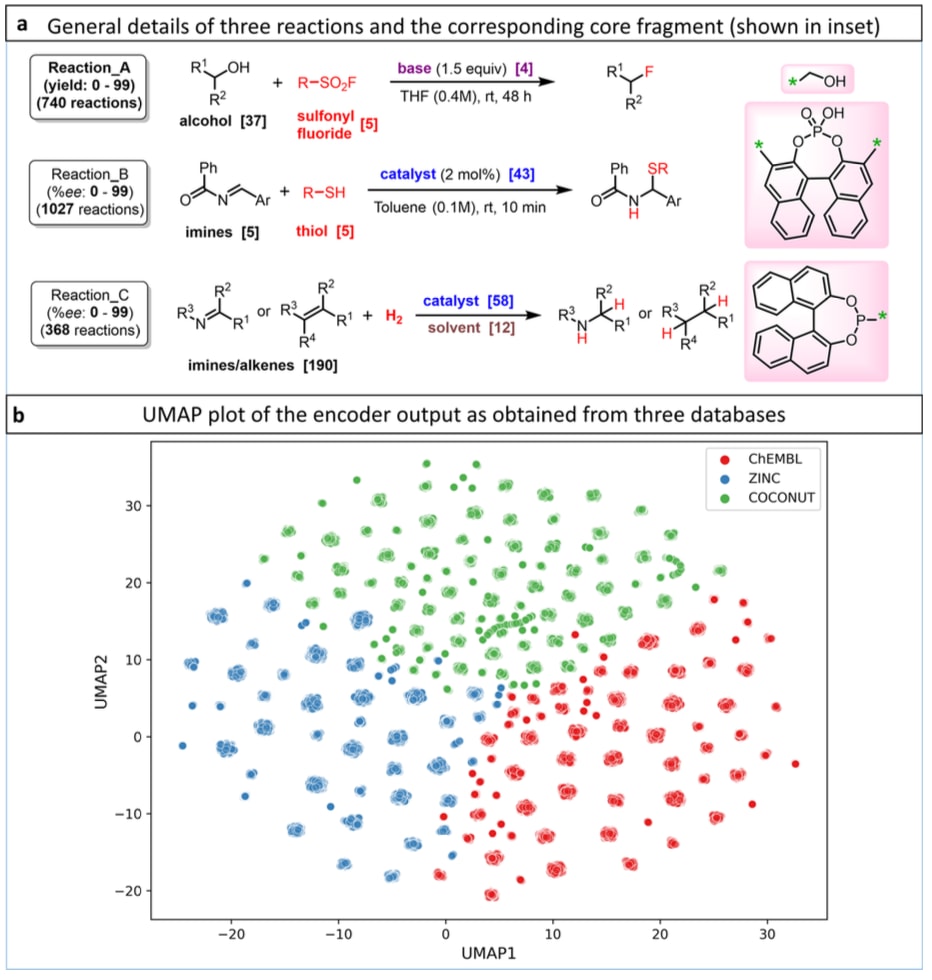
图2|三种反应数据集及分子表示可视化 a. 本研究所考虑的三种反应的重要细节。每个反应中不同碱和催化剂的数量以方括号形式标注在反应箭头上方。插图中展示了每个反应对应的核心片段。b. 从三个不同数据库中获得的编码器最终隐藏状态的UMAP可视化结果。
2.2 面向反应定制的功能设计
由于强化学习在反应发现领域中的应用目前仍然非常有限,因此有必要通过引入如下所述的反应特异性功能进行合理定制。 1. 鉴于在实际反应开发场景中,稀疏分布的小规模数据集更为常见,因此本研究中所采用的回归模型利用迁移学习(TL)方法可能更加适合。 首先,在包含约100万个分子的大规模数据集上对通用领域语言模型进行预训练。 针对目标产率/%ee预测的迁移学习回归器(PR)分别在三个不同的反应数据集上进行微调(见Supporting Information)。 在此,将各个反应参与物(根据具体情况包括催化剂、底物以及添加剂/溶剂)的连接SMILES作为PR模型的输入。 这些PR模型表现出非常低的过拟合现象以及良好的泛化能力(见Methods部分)。 2. 另一个重要考虑因素是,目标分子(底物)应具有参与反应所需的官能团。 例如,在脱氧氟化反应中,底物应具有醇(−OH)官能团。 因此,在强化学习优化循环中引入了反应特异性的“核心”片段(CF)(图1d)。 不同反应使用不同的CF(图2a),这为未来应用于其他反应类型提供了更大的灵活性。 3. 仅利用预测模型获得的预测结果值(或其某种函数)来量化奖励可能会产生误导。 如果将该数值作为唯一优化目标,模型可能倾向于重复生成能够获得高奖励的相同分子,从而导致化学空间探索不足。 为了解决这一问题,将与预测产率或%ee相关的奖励值与基于Tanimoto相似性的唯一性因子相乘,以惩罚重复分子或结构相似分子的生成。 4. 一个理想模型不仅应该最大化反应结果,同时还应生成真实可行的分子。 因此,考虑了多种性质,例如分子量、电荷、氢键受体/供体数量以及合成复杂性评分,用于过滤不现实的分子并评估其合成适用性。 通过考虑这些属性,构建了一种序列奖励函数,该函数综合考虑了生成分子的合成可行性和效用(图3a)(见Supporting Information)。
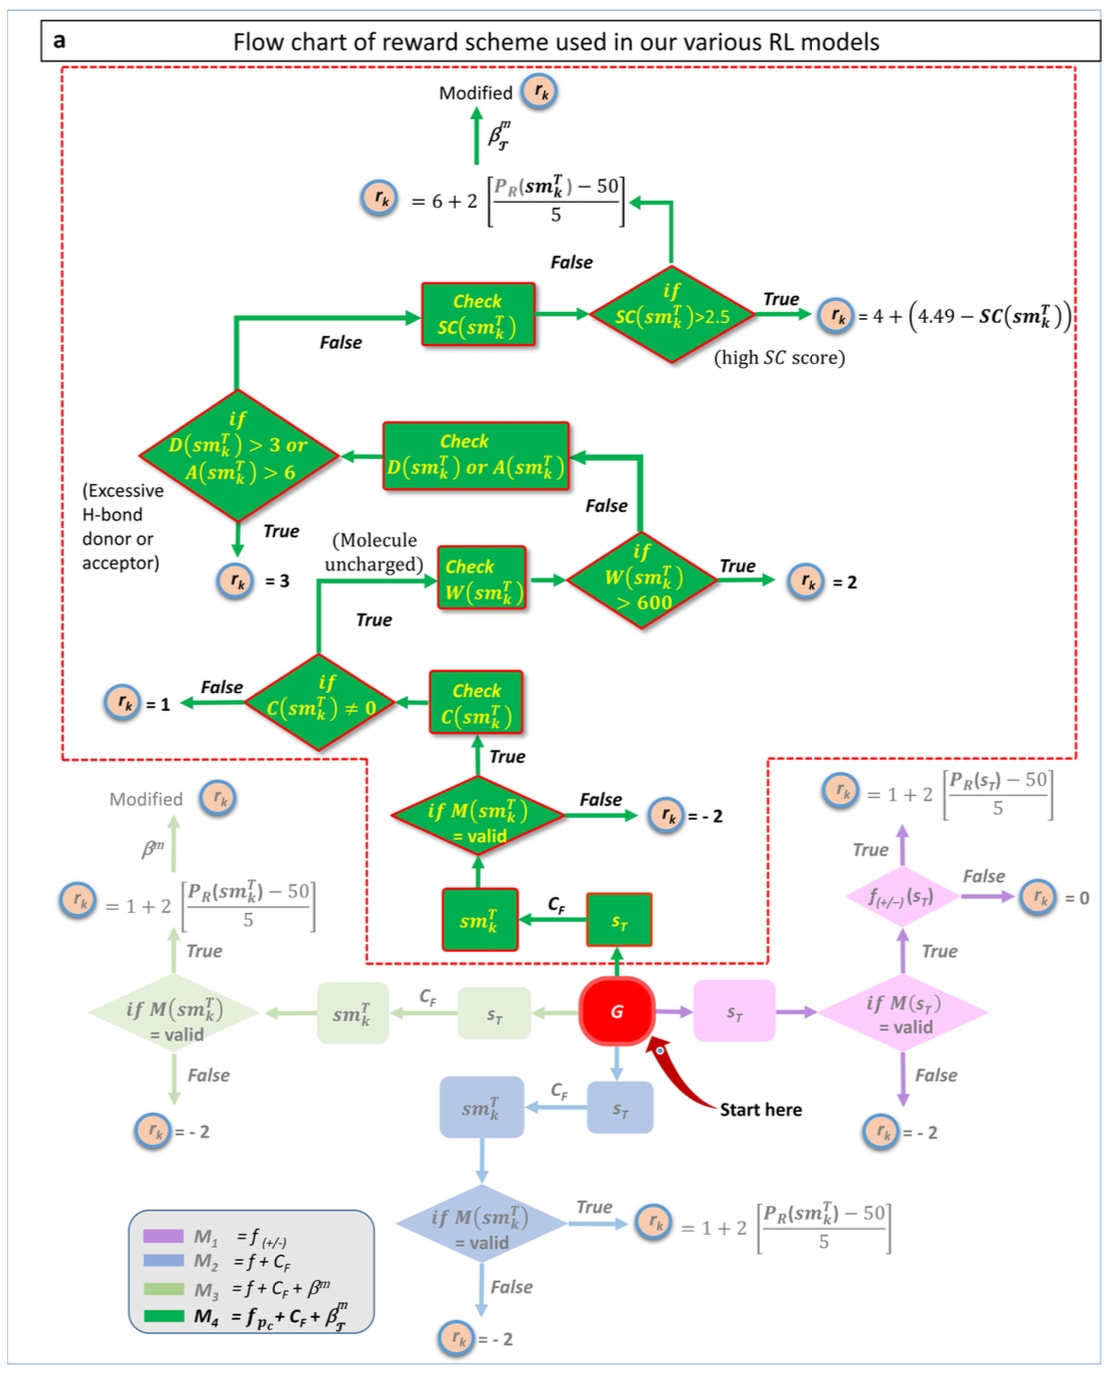
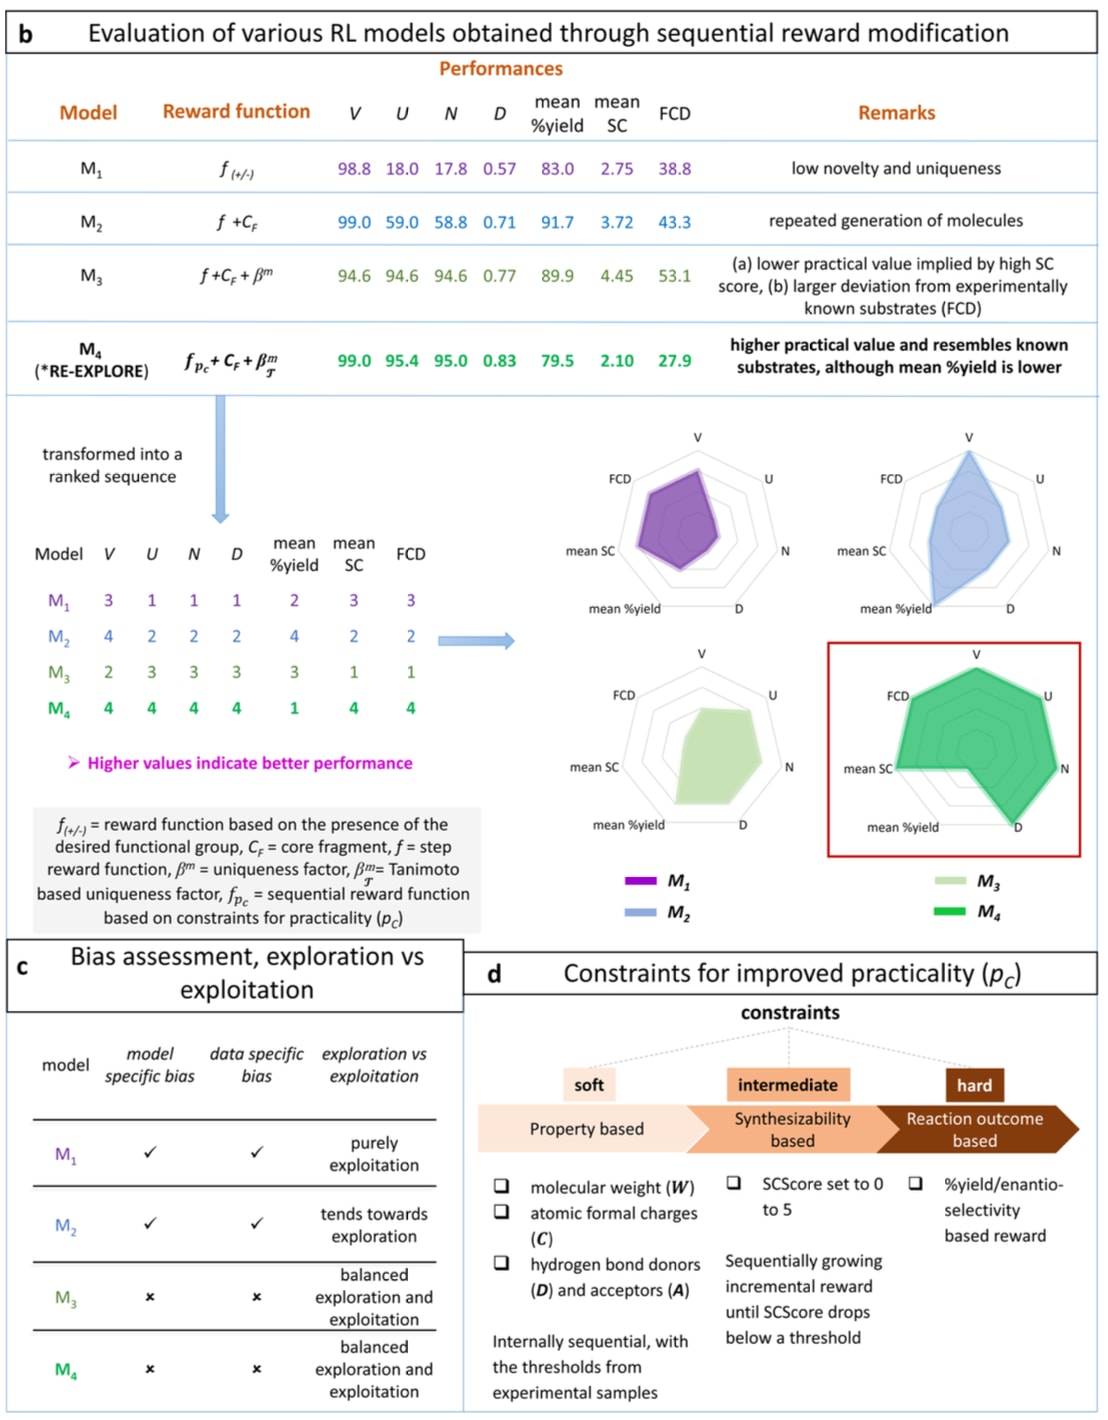
图3|奖励函数流程及不同强化学习模型性能评价 a. 不同强化学习模型中所采用的奖励函数流程图。这里,
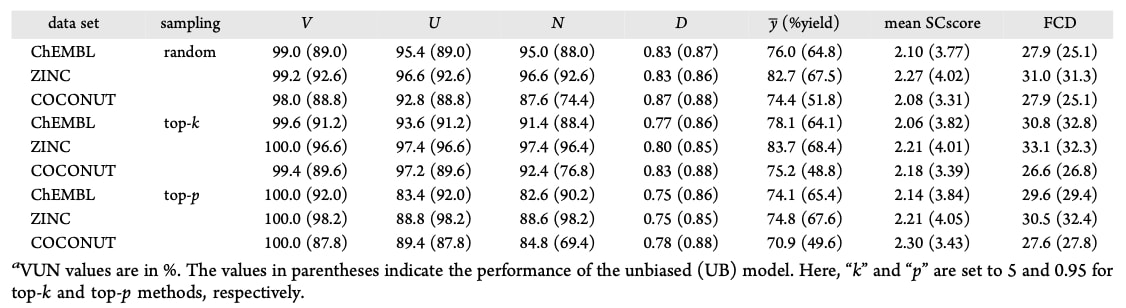
表1|不同预训练数据集和采样方法下RE-EXPLORE在Reaction_A中的性能
2.3 关键案例
RE-EXPLORE能够在三种具有不同数据规模和输出值分布的多样化反应中有效生成具有价值的分子。其中一种涉及底物探索,即在化学空间中搜索目标分子发生高产率官能团转化的结构。其他两种则关注催化剂设计,目标是探索具有高选择性(所形成产物的%ee)的催化剂。 此外,对生成分子进行了分析,以突出所设计元素在反应开发任务中的优势。 采用三个化学数据库(ChEMBL、ZINC和COCONUT)训练基于RNN的生成器(G)(见Methods部分)。虽然这些数据库已经被用于生成模型以及迁移学习中,但其在探索化学反应空间中的作用仍有待进一步确定。 利用UMAP图对RNN编码器输出进行可视化,发现存在三个明显不同的区域(图2b),这表明这些数据库内部以及数据库之间具有不同的特征。 在每个区域中,都存在具有不同类型官能团或相似子结构的独立聚类,例如含吡啶环的化合物或多羟基化合物。 这种差异可以被用于改进反应发现过程,因为这些数据库包含了各自化学空间中丰富且多样化的信息。 强化学习训练包含两个阶段。首先,生成器G和预测器
2.4 底物探索
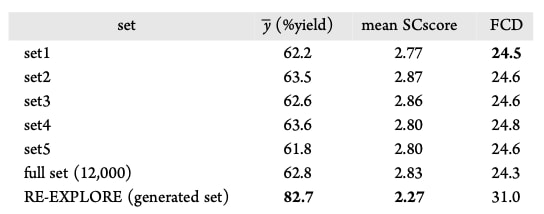
RE-EXPLORE被用于在脱氧氟化反应(Reaction_A)中识别高产率醇类化合物。该反应涉及通过磺酰氟(SF)和碱(B)的作用,将醇(底物)转化为其氟化衍生物。已知引入氟元素对于多种药物应用具有积极作用,并且已广泛应用于治疗领域。 采用了一个高通量实验(HTE)数据集(即所有反应均在相同条件下进行),该数据集包含740个反应的产率数据,由37种醇、5种SF以及4种B组成(图2a)(见Reaction Data Sets部分)。 选择伯醇([OC(*)])作为核心片段(CF),重点探索醇结构,同时固定B4(BTPP)和SF5(PBSF)(见Supporting Information)。 在奖励方案中,将其他多种属性,例如电荷、分子量以及氢键特征,作为软约束条件,以帮助排除不现实的醇类分子(图3a)。 这些软约束条件的阈值根据数据集中实验已知化合物对应的数值进行选择。 利用SCscore加入可合成性阈值,以引导生成过程朝向具有实际意义的分子。 满足所有约束条件的生成醇随后被用于反应产率评价。 这些重要的评价标准确保能够对生成分子进行全面评估,而不仅仅关注预测目标值。 实验结果如表1和图3所示。 如实验设计部分所述,分别在三个不同预训练数据集上进行了独立的强化学习实验,因此探索了不同的“化学空间”。 此外,还采用了多种采样方法,具体细节见Supporting Information。 这些方法包括在每一步生成过程中,根据学习得到的概率选择标记(token),利用随机或随机化策略,以及top-k和top-p采样等方法,从而生成新颖且多样化的分子结构。 模型能够在三个预训练数据集以及所采用的采样技术中,持续生成具有更高平均产率的新型醇分子。 比较所有评价指标后可以发现,“random”采样方法优于其他采样技术。因此,后续讨论主要集中于random采样方法获得的结果。 与已报道的湿实验HTE结果进行比较(其中只有约20%的反应产率高于70%)可以发现,强化学习模型能够通过提出多种更适合该反应的底物,有效填充高产率区域(约90%的反应产率高于70%)。 生成醇分子的平均SCscore约为2.10,与已报道醇分子的平均SCscore约2.32非常接近(图4a)。 这表明生成醇分子具有更高的实际应用价值。 较低的FCD值表明,生成醇分子的分布与训练数据集中醇分子的分布相匹配(图3b)。 所设计的奖励方案进一步确保生成醇分子同时满足基于性质的标准以及可合成性要求。 该策略抑制了不现实分子的生成,而这些分子如果仅根据较高预测产率进行判断,可能会被认为是最佳候选分子。 在强化学习训练过程中观察到的一些有趣现象值得在此说明。 注意到,强化学习过程最初的几个阶段(总计60个阶段)会产生不现实分子,而随着模型训练的进行,这些分子由于模型中所采用的奖励方案逐渐受到抑制(如图3a所示)。 在训练初始阶段,奖励值保持在接近3.7的水平,表明生成分子未满足SCscore标准(见图S5)。 随着训练过程推进,奖励值从3.7显著提升至9.9,这表明生成分子逐渐满足SCscore要求,并符合指定的基于性质的标准(图3d中的pC)。 有趣的是,其他引入额外性质的强化学习模型,例如可旋转键数量、环数量以及log P等,在生成满足这些约束条件的分子方面似乎存在困难,这一点可以从对应的奖励值中看出(图S6)(更多细节见Supporting Information)。 这一观察结果支持了在RE-EXPLORE模型中加入图3c所示特定性质的合理性,使模型具有更高的实际应用价值。 当将模型性能与标准基于强化学习的性质优化任务中所使用的方法进行比较时,可以明显观察到所设计元素带来的优势。 例如,直接将类似M1的强化学习模型(图3a)应用于脱氧氟化反应,会导致较低的唯一性值,表明探索效率较低(图3b、c)。 虽然M1仅根据醇官能团的存在情况分配奖励,但M2依次加入了反应特异性的“核心”片段,而M3进一步考虑了唯一性因子。 这种奖励方案提高了探索能力,这一点可以从更高的VUN值中体现出来(见排序序列表,图3b)。 需要注意的是,M1和M2模型利用回归器进行优化,这表明探索过程会受到回归器所使用训练数据的影响。 这种情况也可能意味着强化学习方法中简单奖励设计的一种失败模式(图3c)。 然而,这些替代方法仍然无法有效引导探索进入化学空间中具有更高实际价值的区域,这一点可以通过生成分子更高的SCscore体现出来。 相比之下,RE-EXPLORE(M4)通过精心设计的奖励塑形策略,确保了更高的实际可用性,并能够针对目标反应生成真实可行的分子。 M4相较于其他奖励设计方案的优势可以从雷达图中的分布情况看出(图3b),尤其体现在平均SC和FCD评分方面。 为了评价基于强化学习的生成任务效果,考虑了以下几种不同类型的比较: (a)与利用图遗传算法(GA)优化得到的分子进行比较,该算法被作为标准基准方法; (b)利用回归器对商业可获得分子进行虚拟筛选; (c)与top-k分子的性能进行比较。 除了基于平均产率进行评价外,还计算了Reaction_A中top-k生成醇分子的平均性能,其中k代表不同水平下性能最高的分子数量(k=1、5、10、20、100、200、300、500)。 表2中展示的top-k指标能够提供性能信息,但也可能导致对强化学习模型实际能力的误解。 例如,对于强化学习生成分子,top-1至top-100指标并未超过对应实验获得的产率值,这可能会导致低估模型效果。 然而,在top-200至top-500范围内,与实验已知分子相比,强化学习模型表现出的优势更加明显。 强化学习模型能够通过生成更多高产率醇分子,超过已知实例的表现。 例如,强化学习模型生成了295个新型醇分子,其预测产率范围为72%至80%,这一结果令人鼓舞,因为实验报道实例中仅有3种醇能够达到这一较高产率范围。 强化学习模型获得更多高产率分子的现象,可以从图4所示的分布图中观察到。 因此,综合考虑生成分子的平均性能、分布曲线分析以及top-200至top-500评价指标,可以进一步体现使用强化学习模型的优势。 对于虚拟筛选,利用PubChem数据库筛选具有醇结构亚基并被报道具有可合成性的分子。 首先获得12000个分子,并从中随机抽取500个分子作为子集。 利用PR模型对每个子集进行评价,并计算不同性能指标。 表3总结的结果显示,RE-EXPLORE模型在平均产率和平均SCscore方面均优于所有这些子集以及完整数据集。 这一结果进一步说明,基于强化学习的生成设计对于探索反应空间具有重要意义。 在上述所有实验中,强化学习模型主要针对反应中的一个关键组分进行优化,例如Reaction_A中的主要底物(醇),而其他反应物(例如Reaction_A中的B和SF)保持固定。 在进一步研究中,构建了另一个强化学习模型,用于识别能够实现多组分探索的最佳B-SF组合。 在该方法中,通过将生成分子分别与20种可用B-SF组合结合,预测每个生成分子的产率。 随后,将能够产生最高产率的组合传递至奖励函数计算过程。 因此,强化学习模型能够从已有选择中识别最有利的B-SF组合。 如图5所示,该模型不仅能够识别高产率醇分子,还能够识别与其反应并生成产物的最佳反应伙伴。 在20种可能的B-SF组合中,模型识别出其中7种更适合生成醇分子。 柱状图中更重要的信息是,在这7种B-SF组合中,生成醇分子的预测平均产率
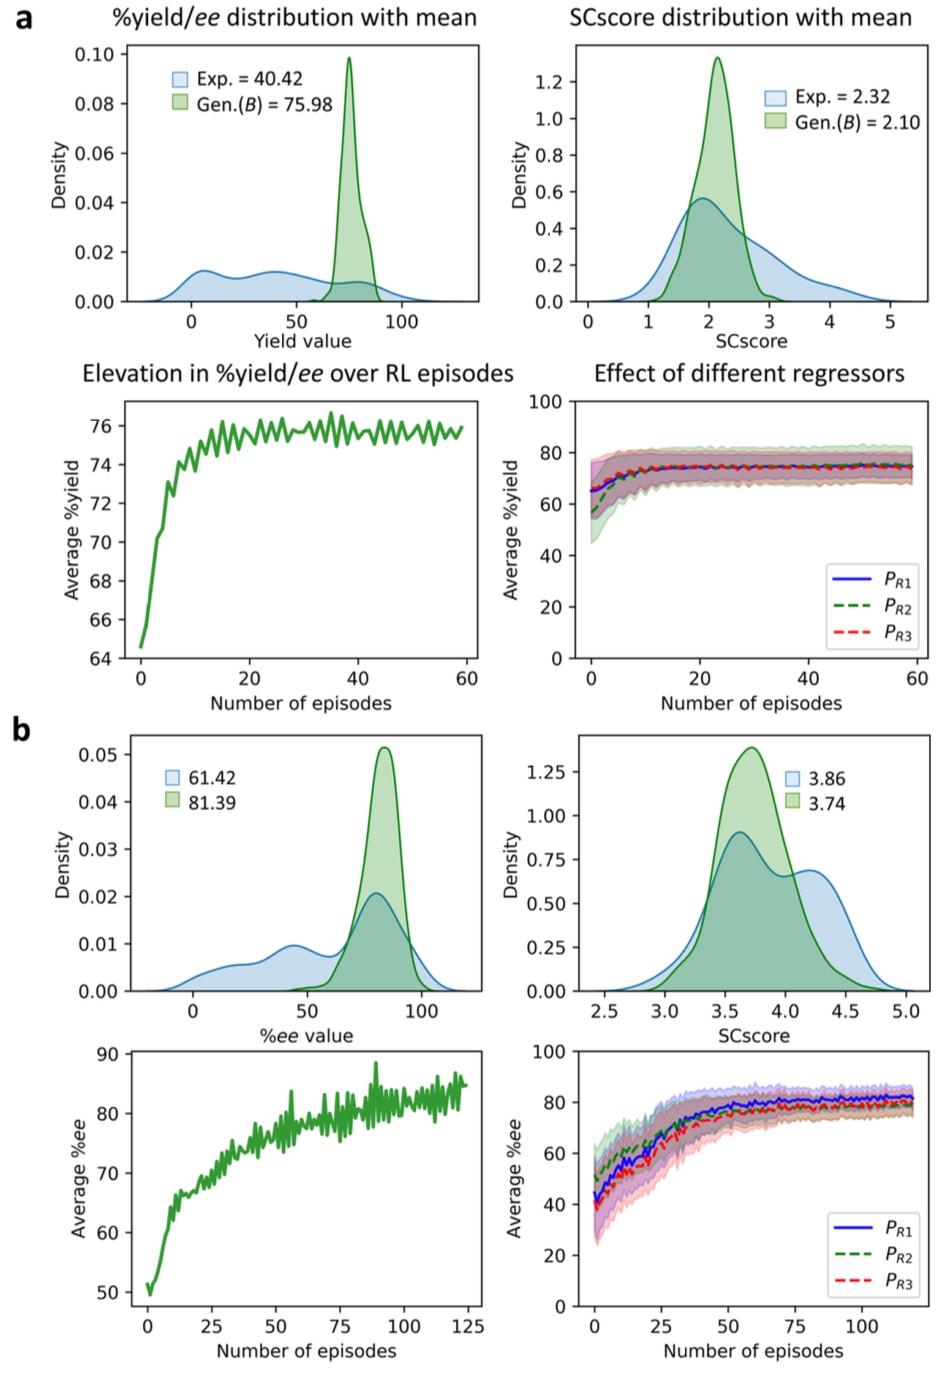
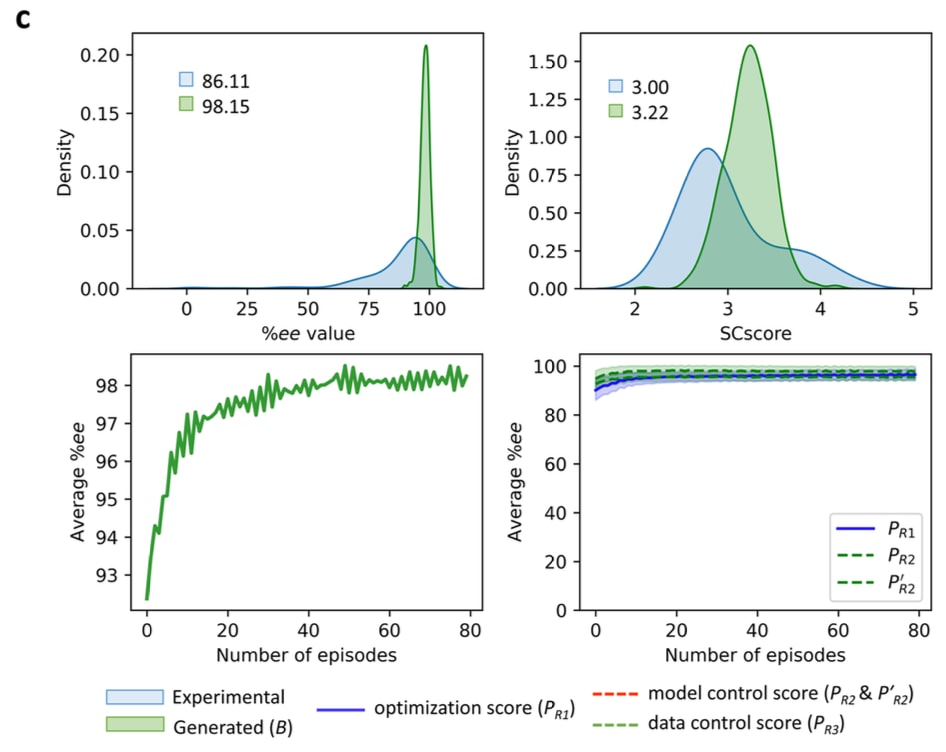
图4|Reaction_A、Reaction_B和Reaction_C中模型性能比较 (a) Reaction_A、(b) Reaction_B和(c) Reaction_C在以下方面的比较:生成分子与真实分子的%yield/ee值(第1列)以及SCscore(第2列);强化学习训练阶段中
表2|Reaction_A中基于Top-k指标的性能表现

表3|RE-EXPLORE模型获得的醇分子与商业可获得醇分子的性能比较
2.5 催化剂设计
受到脱氧氟化反应中令人鼓舞结果的启发,将该策略扩展用于探索能够在不对称反应中提供高对映选择性的新型催化剂。 在这些转化过程中,一种对映体的生成量高于另一种,通常表示为%ee。较高的%ee值是理想目标,因为具有对映体纯度的分子在药物和制药领域具有重要价值。 重点关注两种反应:N,S-缩醛形成反应(Reaction_B)以及不对称氢化反应(Reaction_C),二者均由手性磷酸(CPA)催化(图2a)(见Reaction Data Sets部分)。 Reaction_B的数据集来源于与Reaction_A类似的组合方法,而Reaction_C则呈现出明显不平衡的分布,并偏向高ee区域。 虽然如图2a所示,这两种反应分别具有不同的核心片段,但所采用的总体强化学习(RL)方案与Reaction_A类似。 模型性能结果如表4和图4所示。 对于两种反应,模型均能够有效推动生成CPA的
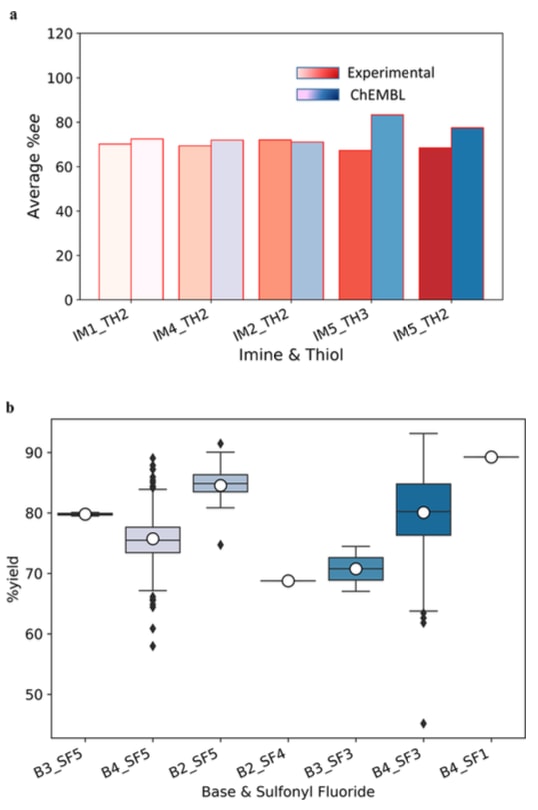
图5|Reaction_A中不同B-SF组合下生成醇与真实醇的平均产率比较 a. Reaction_A中所有B-SF组合下,生成醇与真实醇平均产率(
表4|采用随机采样方法时RE-EXPLORE在Reaction_B和Reaction_C不同预训练数据集下的性能表现
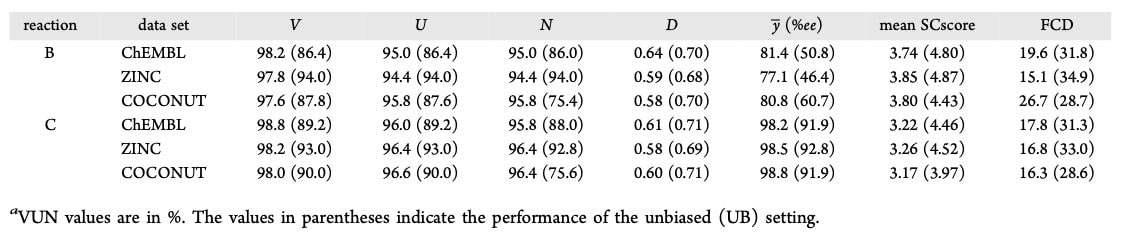
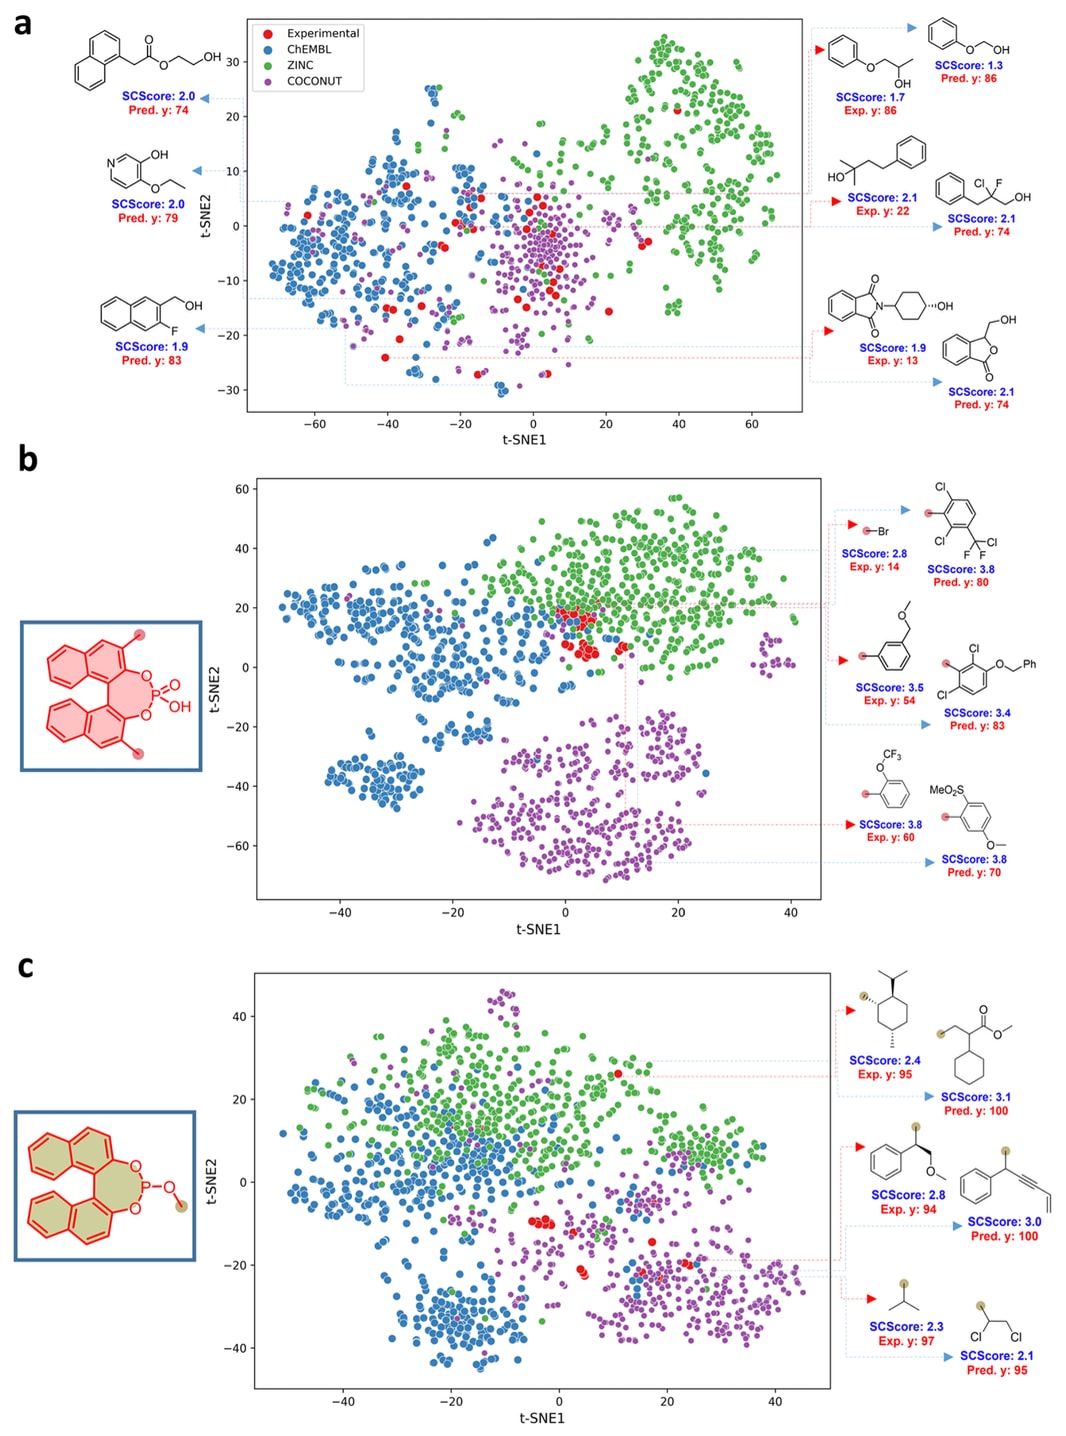
图6|基于t-SNE可视化展示强化学习生成分子的化学空间分布 展示了分别基于ChEMBL(蓝色)、ZINC(绿色)和COCONUT(深粉色)数据集进行独立预训练后,由强化学习生成分子所覆盖的化学空间。此前报道的已知分子(红色点)、其产率/%ee(标记为Exp.
2.6 局限性
正如许多可用的辅助工具一样,机器学习模型预计也会存在一定的局限性。 在此,指出当前版本RE-EXPLORE模型存在的两个关键限制: (a)该模型可能无法适用于包含某些具有非标准成键方式分子的数据集。这一问题源于标准SMILES表示方法的局限性,其不适用于涉及过渡金属π-烯丙基键合或复杂成键情况的体系,例如二茂铁中的复杂键合结构。 (b)另一个限制是,目前该模型尚未针对目标导向的正向合成任务进行训练。 然而,通过工作流程中提出的基于片段的方法,该模型能够提供探索目标分子中特定区域所需的灵活性。
3 结论
已经证明,强化学习中的新型奖励工程能够帮助引导反应结果朝向最佳产率/%ee方向发展。 鉴于发现,在策略梯度强化学习框架下,依赖于目标官能团存在或缺失的标准奖励函数会导致低效探索,仅产生18%的新颖分子,因此将强化学习应用于化学反应是一项重要且具有价值的工作。 相比之下,利用所提出模型生成的分子中,95%被发现具有新颖性,同时在实际应用价值方面也更高。 这一结果得益于在强化学习框架中谨慎整合不同功能模块,例如用于反应特异性学习的用户定义核心片段、用于可靠预测的基于迁移学习的回归器,以及用于抑制结构相似分子生成的基于Tanimoto相似性的唯一性因子。 此外,引入结合分子性质(分子量、电荷、氢键供体/受体数量)以及合成复杂性评分的创新奖励塑形策略,使模型能够更广泛地探索反应空间,并识别具有实际应用价值的区域。 考虑到化学反应通常涉及多个反应参与物,除了通过强化学习过程获得的关键反应物之外,该模型还被设计用于识别能够实现更高产率/%ee的最佳反应伙伴。 该强化学习模型在三种不同反应中展现了其优势,其中脱氧氟化反应的产率最高提高了35个单位,不对称亚胺-硫醇偶联反应的%ee提高了20个单位,以及亚胺/烯烃不对称氢化反应的%ee提高了近12个单位。 关于强化学习模型的稳健性,结果显示不存在模型特异性偏差或数据特异性偏差,因此增强了其在反应发现领域潜在应用中的可信度。 该模型能够在不同预训练生成器中持续探索具有合成可行性的新型分子,这些生成器分别基于化学多样性数据库进行训练,包括ChEMBL(约0.5M)、ZINC(约1.0M)和COCONUT(约0.5M),每个数据库均有助于模型探索不同的化学空间区域。 总体而言,所提出的工作流程能够通过快速识别具有更高产率/%ee潜力且具有实际价值的底物/催化剂,帮助规划重要分子的合成,从而减少繁琐的经验性试错过程。