NC 2026|HME:异质分子编码下的化学—语言共享空间探索
今天介绍的是一项面向化学语言模型的多模态分子表示与生成工作。该研究提出异质分子编码框架 HME,将 1D SMILES、2D 分子拓扑、3D 几何结构以及数据驱动的分子片段统一引入大语言模型,并通过 Query Learning 模块实现不同结构模态与语言空间的对齐。进一步地,作者提出片段链(CoF)机制,先生成关键分子片段作为“化学蓝图”,再完成最终分子生成。同时构建了百万规模多条件分子设计数据集 MCMoD。实验表明,HME 在分子描述、问答、性质预测及条件分子生成等任务中均取得较好表现,并能够实现性质—片段联合控制和零样本多目标分子设计,为构建统一的化学—语言模型提供了新的技术路径。
获取详情及资源:
0 摘要
化学语言模型是探索化学空间的有力工具,但其通常依赖分子字符串等线性表示,这种表示方式会造成语义鸿沟,限制模型将自然语言与复杂分子结构进行充分关联的能力。该研究表明,通过异质分子编码,化学语言模型能够获得对分子更全面的多模态理解。该编码方式综合了一维序列、二维拓扑、三维几何结构以及基于统计方法得到的分子片段信息。
在此基础上,作者进一步提出了一种基于查询的模块,将异质结构信息转换为与语言模型兼容的统一表示;同时引入碎片链(chain-of-fragment)机制,通过分层化学蓝图构建过程引导分子生成。为支持该领域的进一步研究,作者还构建了一个面向多目标分子设计的百万规模数据集。
实验结果表明,该框架能够实现化学—语言空间的双向导航,在分子理解和分子设计任务中均相较于具有较强竞争力的基线方法取得了稳定提升。
1 引言
近年来,化学空间探索已成为现代化学与分子科学的重要基础。随着分子结构及其文本描述数据的快速增长,一种新的研究范式正在形成,即化学—语言空间(chemical-linguistic space)。该空间能够以更加直观的方式表征分子性质及分子间相互作用。为建模这一空间,研究者开发了化学语言模型(chemical language models,CLMs),通常采用简化分子线性输入规范(Simplified Molecular Input Line Entry System,SMILES)和自引用嵌入字符串(Self-Referencing Embedded Strings,SELFIES)等基于序列的表示形式,将分子视为类似自然语言的线性 Token 序列。通过掩码语言建模或因果语言建模,CLM 能够学习分子结构与自然语言之间的双向依赖关系,并应用于条件分子生成和分子理解等任务,在药物设计与虚拟筛选中展现出重要潜力。然而,对单一线性分子表示的依赖限制了 CLM 对分子结构复杂性及多维特征的充分捕捉能力,从而制约了其对复杂化学现象的建模效果。
分子表示学习的发展已经催生出针对二维(2D)分子图结构和三维(3D)坐标的高效编码器。将这些专用编码器与语言模型结合,可以构建连接自然语言与分子结构的强大多模态模型,为分子设计与分析提供更广阔的应用空间。然而,长期以来,不同视角下的分子表示,包括一维(1D)SMILES、2D 分子图和 3D 构象,都存在各自固有的局限性。具体而言:(1)SMILES 序列通常通过深度优先遍历生成,不具有置换不变性,因此分子结构中的微小变化可能导致序列发生不成比例的显著改变,为分子设计带来困难;(2)2D 分子图虽然擅长描述拓扑结构,但图神经网络(Graph Neural Networks,GNNs)可能受到过度平滑问题影响,而 Graph Transformer 则可能过度强调全局相互作用;(3)3D 几何模型主要关注原子的空间排列,因此在区分几何形态相似但化学结构不同的分子时可能存在困难,同时也可能难以保持对构象变化的鲁棒性。因此,整合不同模态之间具有互补性的分子表示,对于实现准确、可靠的化学设计与分析至关重要。
与此同时,通用大语言模型(Large Language Models,LLMs)在科学领域中的应用也取得了显著进展。其中,一个具有代表性且成效突出的研究方向,是利用外部化学专用工具增强 LLM。这一范式将 LLM 作为高级控制器,协调各类专业软件完成合成规划和自动化发现等任务。尽管这种方式具有很强的能力,但其效果主要依赖于所集成工具的专门功能,而不是提升 LLM 本身对分子结构的内在理解能力。若要构建面向化学科学的统一且通用的框架,一个关键要求是使 LLM 自身能够直接感知和处理丰富的多模态分子信息。
此前,为构建具备化学理解能力的模型,已有研究探索了多种多模态对齐策略。部分工作通过对比学习对齐 2D 和 3D 分子视图,以获得稳健的纯分子表示,但通常并未引入语言信息。进一步地,CLAMP 等方法通过对比学习对分子与文本的嵌入表示进行对齐,成功连接了分子与文本,可用于判别式任务。尽管这种范式十分适合性质预测、检索等基于相似度的任务,但其本身并非针对复杂的、由指令引导的生成任务而设计。这一区别揭示了一个关键缺口:需要一种超越相似度对齐的统一生成式框架。此类框架的目标,是在给定多模态上下文的条件下,直接建模生成目标输出——例如分子或其文本描述——的条件概率,从而在单一端到端架构中支持更加广泛的科学任务。然而,目前相关探索尚未系统解决各种单一分子表示方式所具有的综合局限。
为解决上述问题,该研究提出异质分子编码(Heterogeneous Molecular Encoding,HME)**框架,使生成式 LLM 能够获得更加全面的多模态化学结构理解能力。具体而言,HME 同时从序列和几何两个视角对分子输入进行编码。在几何编码方面,采用专门的 2D 和 3D 分子编码器。为连接这些专用编码器与 LLM,作者提出**查询学习(Query Learning)模块作为模态适配器。该模块通过交叉注意力机制,将不同编码器产生的原子特征转换为语言模型可直接处理的软 Token 序列。在此基础上,进一步构建融合模块,将 2D 和 3D 软 Token 进行整合,形成具有协同效应的几何表示。
此外,该研究还将分子片段作为额外模态引入 LLM。通过子图挖掘算法,作者构建了数据驱动的分子片段词表,并扩展 LLM 原有词表,使模型能够将分子片段作为独立 Token 进行处理。这一策略既能够与 LLM 的预训练知识自然融合,也为引入片段链(Chain-of-Fragment,CoF)机制提供了基础。CoF 将分子生成组织为一种分层的化学蓝图构建过程:首先生成组成目标分子的片段序列,随后以该结构蓝图为条件生成最终的 SMILES 字符串。该机制能够提高分子生成准确性,并实现对生成结构更加细粒度的控制。为支持这些多条件生成能力的训练和系统评估,作者还构建了大规模多条件分子设计(Multi-Condition Molecular Design,MCMoD)数据集。
结果表明,HME 框架在多类分子任务中均具有良好的有效性与泛化能力。将 HME 分别集成到 Llama-3、Llama-2 和 Qwen-2.5 等多种 LLM 骨干网络后,增强模型在分子描述生成和问答(Question Answering,QA)等分子理解任务上取得了显著提升。在分子生成方面,基于 MCMoD 数据集的评估表明,HME 能够稳定完成由文本描述、化学性质及分子片段约束引导的分子设计任务。此外,在具有较高挑战性的基于口袋的配体生成任务中,HME 同样表现出较强能力,在标准基准测试中取得了可与专用 3D 生成模型竞争的结果。进一步地,HME 在多目标分子设计场景中还展现出较强的零样本泛化能力,表明其作为化学发现与分子工程通用工具具有广泛应用潜力。
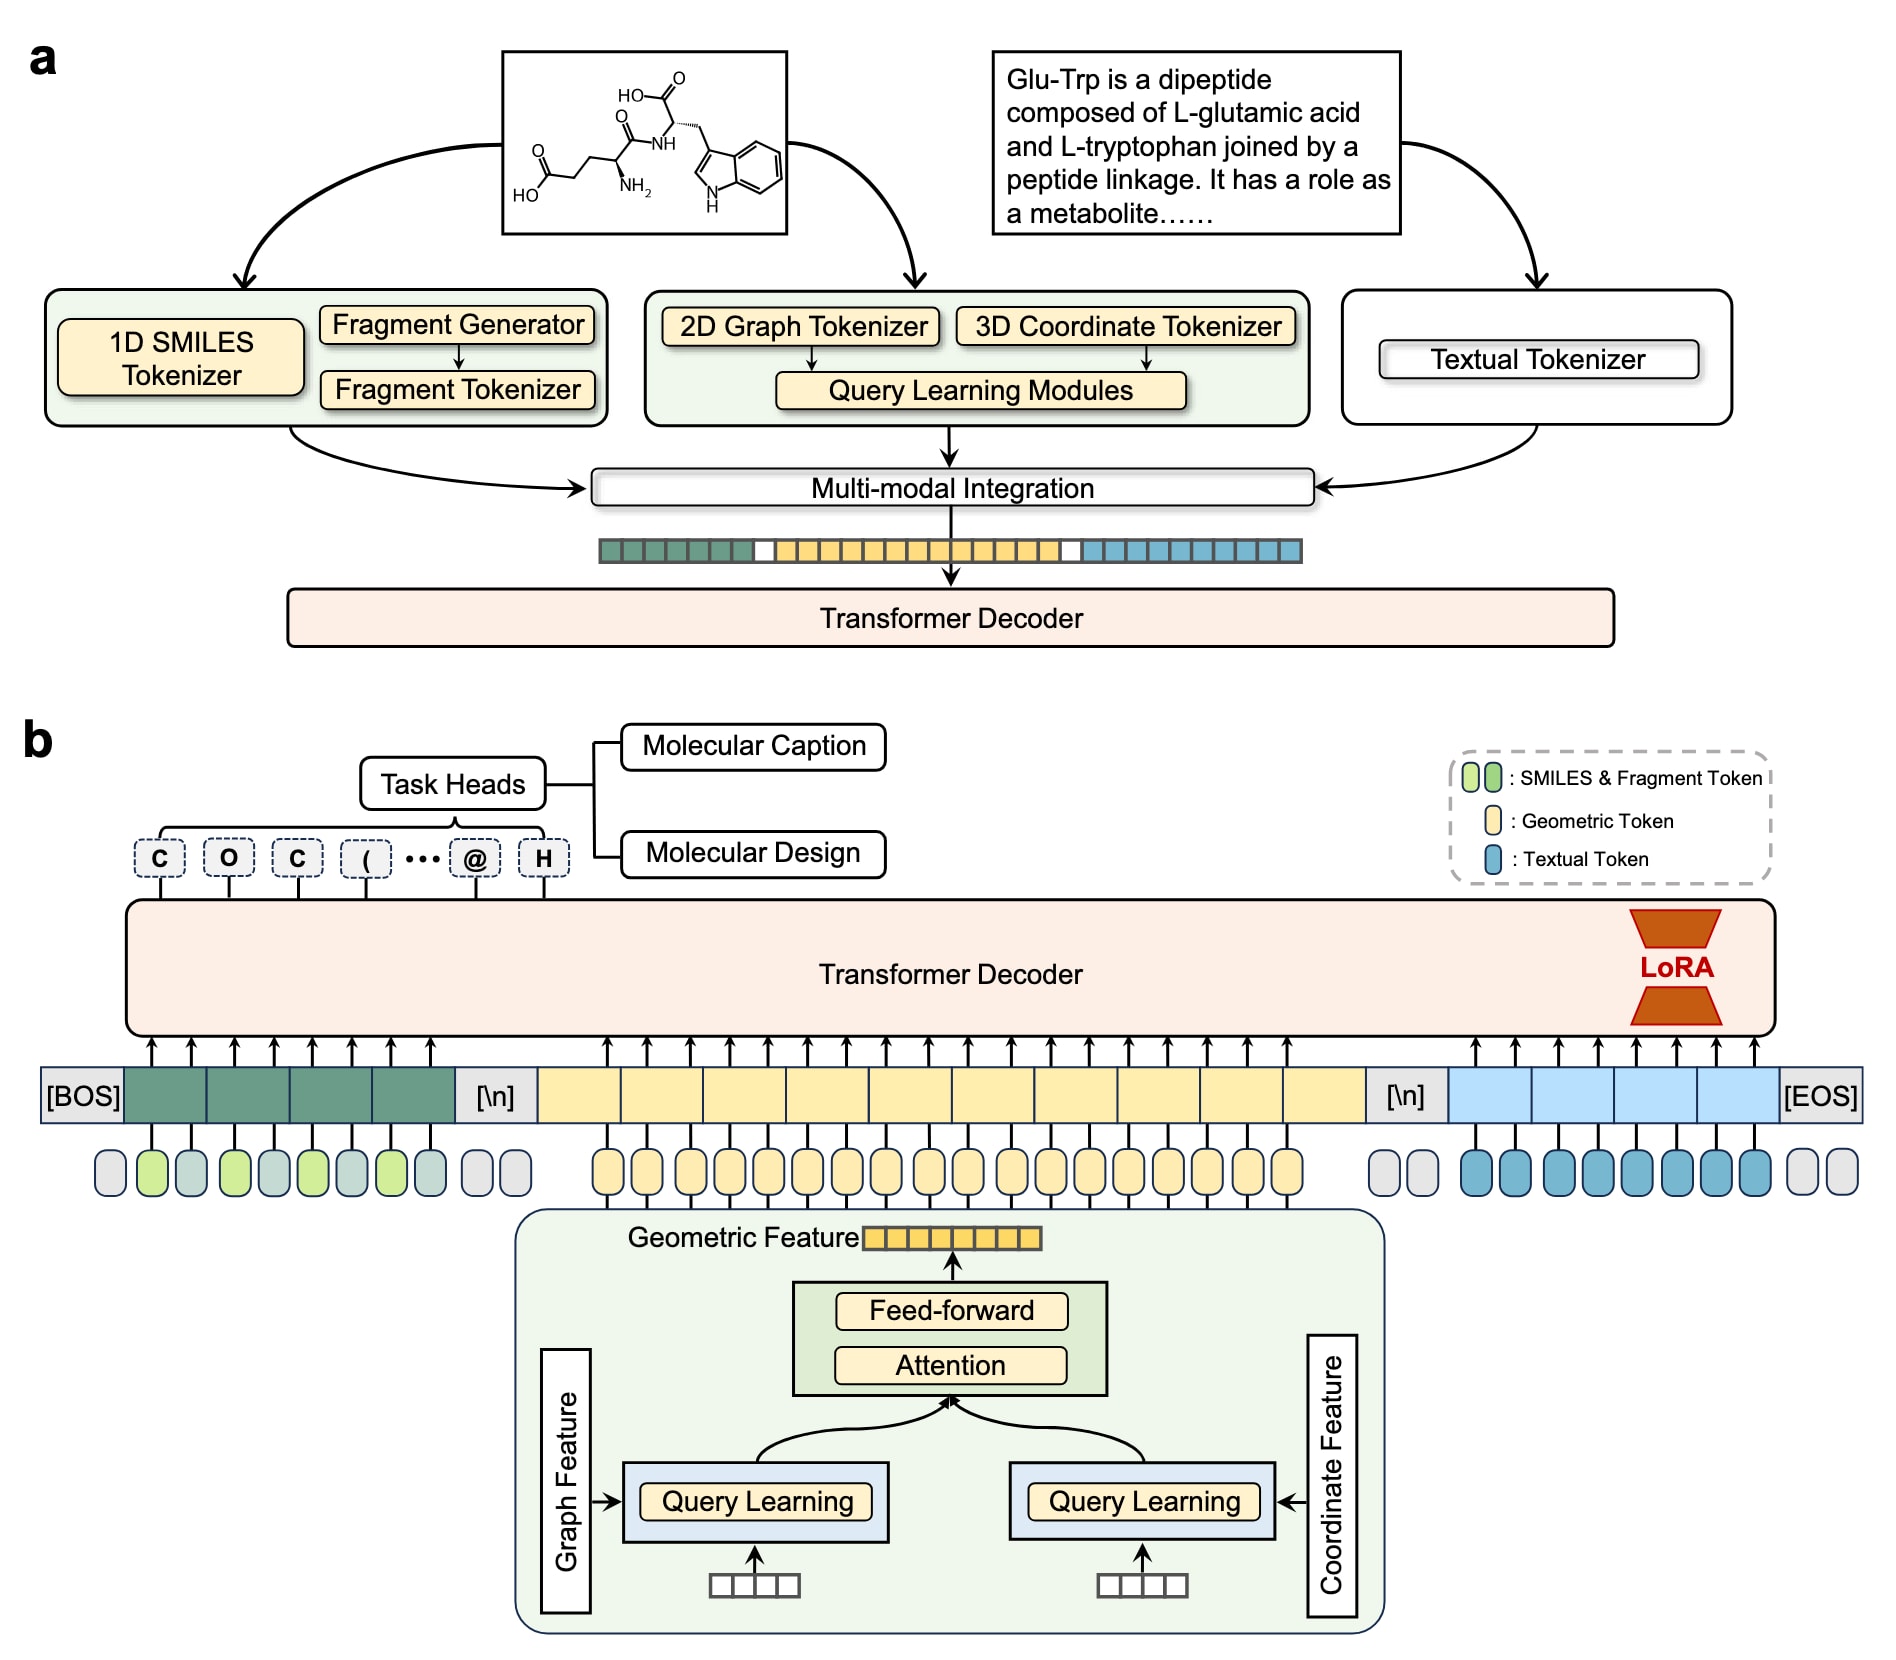
图1|HME 框架。 a,对齐阶段。将不同分子编码器(即 Tokenizer)提取的特征投影至统一表示空间,并与文本空间进行对齐。b,任务特异性监督微调阶段。采用低秩适配(Low-Rank Adaptation,LoRA)方法,在 Transformer 解码器中引入可训练的低秩更新矩阵,以参数高效的方式进行自回归生成建模,实现文本、分子和分子片段的生成。1D,一维;2D,二维;3D,三维。
2 结果
2.1 异质分子编码结构的构建
图1展示了 HME 框架的整体流程。HME 从不同视角整合同一分子的特征,以实现更深入、全面的分子理解。如图1a所示,HME 从四类分子 Tokenizer 中获得编码信息:(1)1D SMILES Tokenizer,将分子的 SMILES 字符串嵌入文本特征空间,从而最大程度利用 LLM 中已有的预训练知识;(2)2D Graph Tokenizer,对分子拓扑结构进行编码,以提供结构信息;(3)3D Coordinate Tokenizer,对每个原子的欧氏坐标进行编码,从而提供更加细粒度的空间信息;(4)Molecular Fragment Tokenizer,利用子结构词表作为额外 Token,对更高层次的化学片段进行显式表示。
与 Group SELFIES、SAFE 等通过基于规则的字符串表示替代 SMILES 的方法不同,HME 将分子片段视为一种额外的信息来源。该方法引入子图挖掘算法,构建数据驱动的分子片段词表,并扩展 LLM 原有词表,使模型能够将分子片段作为独立 Token 进行处理。
图1b进一步展示了 HME 的结构细节。其中,一个关键架构组件是查询学习(Query Learning)模块,其作为可学习适配器,将不同结构编码器产生的异质输出映射到 LLM 所要求的统一输入空间。该模块将各编码器输出的特征嵌入转换为一系列软 Token,使其能够与语言模型兼容,同时解决由于不同分子原子数量不一致而导致的计算效率问题。随后,采用基于交叉注意力的融合机制,促进 2D 与 3D 软 Token 之间的双向信息交互,从而构建具有协同效应的融合几何表示。
来自各结构模态的软 Token 随后与 SMILES 编码器和分子片段编码器产生的 Token 嵌入进行拼接,并将得到的复合序列输入 Transformer 解码器进行统一的自回归建模。由此,分子理解与分子生成均可统一表述为下一 Token 概率建模问题。
这一架构进一步支持一种结构化的分层生成方法,即片段链(Chain-of-Fragment,CoF)。CoF 可视为一种化学蓝图构建过程:模型首先生成由关键分子片段组成的中间序列,以建立结构基础,随后再生成最终完整分子。此外,HME 还支持在统一的自然语言提示中,同时指定分子片段、定量性质以及抽象描述等多种条件。
表1|分子描述生成任务的性能比较
2.2 MCMoD:面向多条件分子设计的大规模数据集
HME 能够对化学—语言空间进行双向建模,即在统一框架下同时支持分子理解与分子生成。因此,有必要系统评估其在这两类核心任务中的表现。在分子理解领域,目前已经建立了较为完善且全面的化学语言模型(CLM)评测基准;在条件分子生成领域,也已有针对基于文本描述进行条件控制的分子生成基准。然而,这类基准通常仅关注单一条件,且数据规模较小,难以全面评估 CLM 的条件分子生成能力。针对这些局限,作者构建了 MCMoD 数据集。
MCMoD 旨在支持多目标分子设计模型的训练与评估,整合文本描述、理化性质和分子片段等多种控制条件。该数据集包含超过 100 万个分子,覆盖合成分子、天然产物和蛋白质配体等多种化学实体。有关其化学空间、性质分布和文本统计特征的详细分析见补充说明 2。MCMoD 支持多目标联合控制,例如同时以特定性质数值和指定分子片段作为生成条件。此外,该数据集还创新性地利用片段序列作为文本模态与分子模态之间的桥梁,用于探索片段链(CoF)范式在 CLM 中的应用。
总体而言,MCMoD 不仅能够用于系统评估 HME 及其他 CLM 在条件分子生成任务中的表现,其多样化的控制条件也有助于推动模型在药物研发和化学工程等实际场景中的应用。MCMoD 的源数据来自 PubChem、ZINC、ChEBI、COCONUT 和 DTP 等数据集与数据库。作者使用 RDKit 对分子进行标准化规范化处理,并计算常用分子性质,同时利用所开发的片段生成器获得分子片段序列。数据处理遵循既有的化学结构整理规范,具体的数据标准化流程和构象生成方法见补充说明 2。
2.3 分子理解任务评估
分子理解旨在建模从化学空间到语言空间的映射,即捕获分子的化学结构信息,并以人类可理解的自然语言进行表达。这种能力对于弥合计算化学与人类直觉之间的差距、促进知识传递,以及提高药物设计和相关文档整理效率具有重要意义。然而,现有方法要么未能充分利用来自不同视角的分子特征,要么没有发挥大语言模型(LLM)在交互能力和领域知识方面的优势。
所提出的 HME 基于先进的 LLM 构建,将分子描述生成(molecular captioning)、**通用问答(QA)和性质问答(property QA)**统一到自然语言对话框架中。值得注意的是,HME 显式整合了多种具有互补性的分子信息,使模型能够更加全面地理解和解释分子结构。
该研究采用专门面向化学语言模型设计的 3D-MoIT 数据集作为分子理解任务的评测基准,并在原始数据基础上进行了进一步处理,包括获取分子图结构、三维坐标以及分子片段序列等信息。
在基线模型方面,选取了多种具有代表性的方法,包括:MolT5,主要关注 SMILES 与文本之间的双向转换;MoMu,结合 SMILES 与分子图信息进行分子理解;3D-MoLM,重点利用分子的三维坐标信息;MolCA,将预训练图编码器与 LLM 相结合;以及 3DMolT5,将三维结构信息编码到 SELFIES 表示中。
2.4 分子描述生成
与图像描述生成类似,分子描述生成(molecular captioning)旨在为分子生成相应的描述性文本。这一任务对于弥合化学结构与人类理解之间的语义鸿沟具有重要意义,并有助于在药物设计过程中做出更加充分的信息驱动决策。该研究采用标准文本生成指标评估分子描述生成性能,包括 BLEU、ROUGE 和 METEOR。这些指标分别从准确率、召回率和文本对齐质量等不同侧面衡量生成文本与参考文本之间的相似程度。
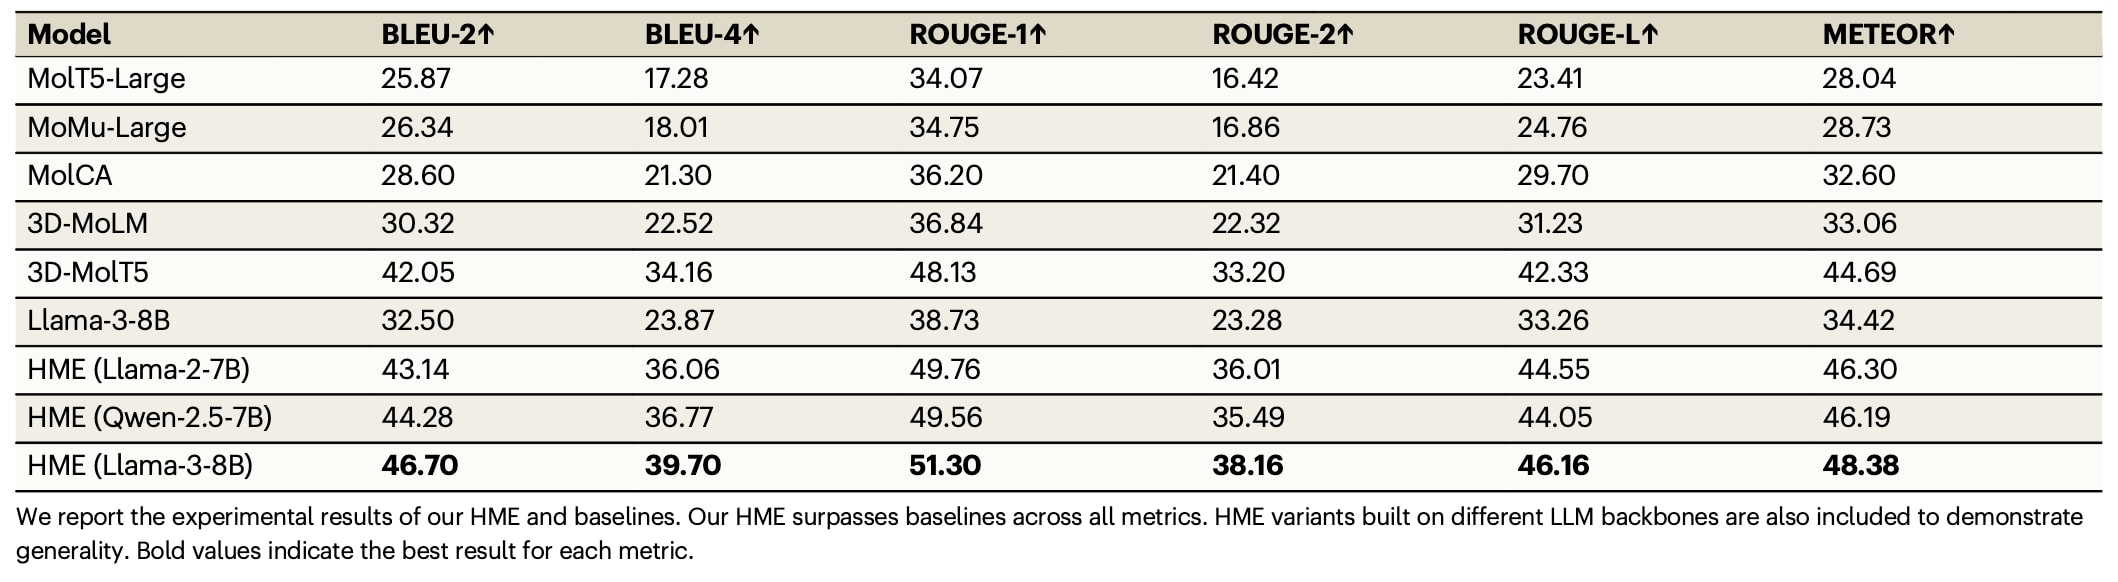
如表1所示,HME 在所有评价指标上均优于其他基线方法。例如,**HME(Llama-3-8B)**的 BLEU-4 得分达到 39.70,相比表现较强的 3D-MolT5 基线(34.16)相对提升 16.2%。这一结果表明,异质分子编码能够为文本生成提供更加丰富的结构上下文信息。同时,HME 带来的性能提升在不同 LLM 骨干网络上具有较好的普适性,**HME(Llama-2-7B)**和 **HME(Qwen-2.5-7B)**的表现同样优于 3D-MolT5。
图2a进一步聚焦于高质量生成文本,例如 BLEU-2
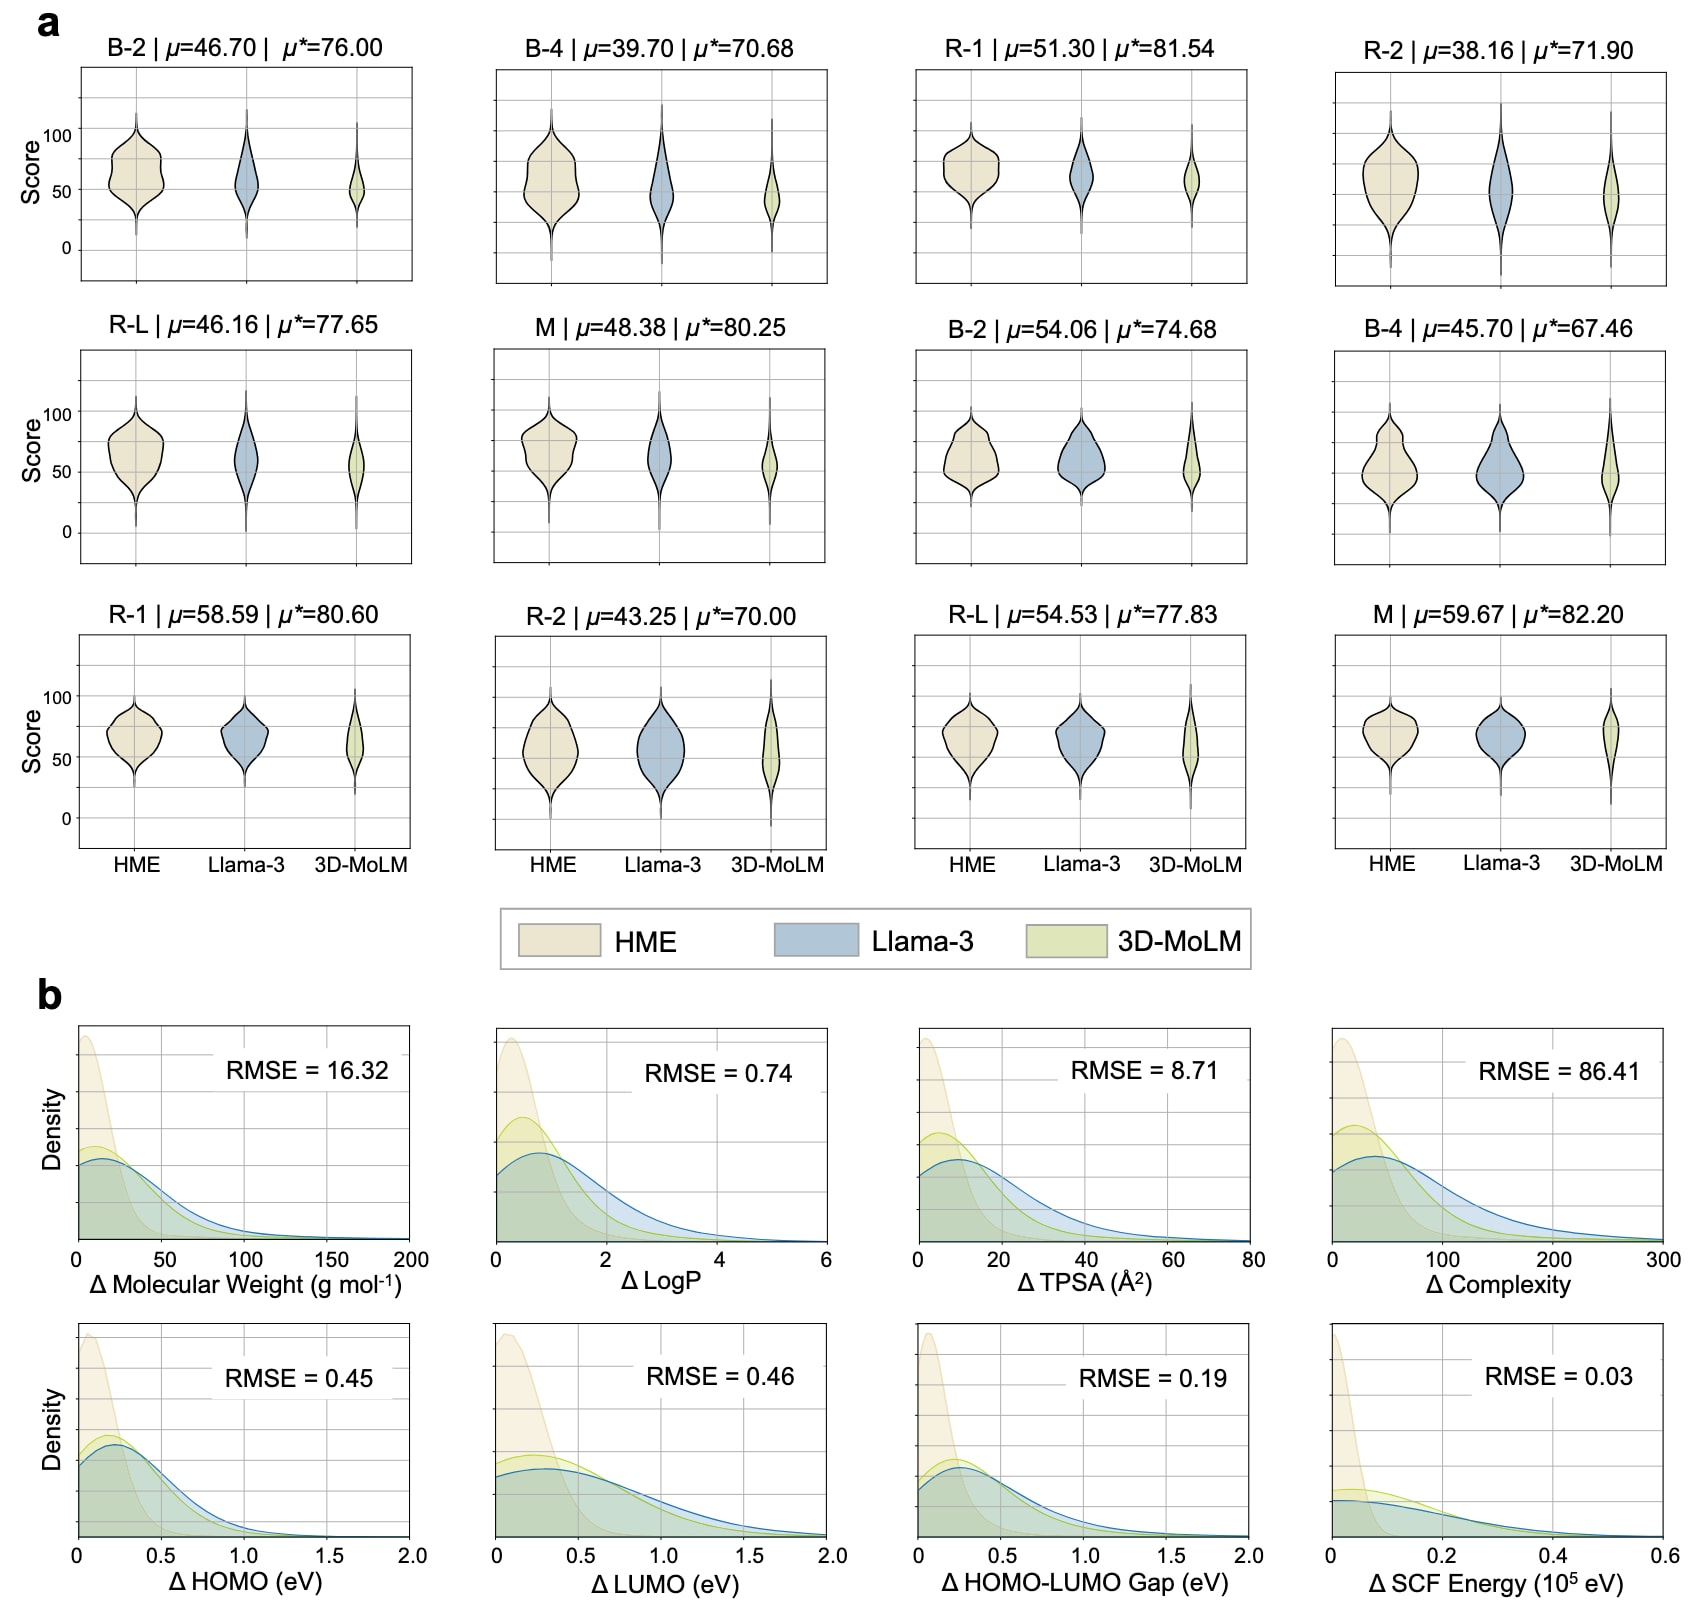
图2|分子理解任务的实验分析。 a,分子描述生成任务与通用问答任务:展示 HME 与各基线模型生成文本和参考文本之间相似度得分的小提琴图。针对不同评价指标,分别采用 50、30、50、30、40 和 40 作为 B-2、B-4、R-1、R-2、R-L 和 M 的高质量文本判定阈值。小提琴图面积与高质量文本所占比例呈正相关。B-2 和 B-4 分别表示 BLEU-2 和 BLEU-4;R-1、R-2 和 R-L 分别表示 ROUGE-1、ROUGE-2 和 ROUGE-L;M 表示 METEOR。
2.5 分子通用问答
近年来,ChatGPT 等大语言模型(LLM)已经展现出回答各种人类问题的能力。由此,人们也逐渐产生了针对分子进行提问的需求,希望借此了解其理化性质、功能、来源及其他相关信息。为满足这一需求,**分子通用问答(molecular general QA)**任务应运而生,使用户能够通过自然语言与模型交互,从而获得更加全面且易于理解的分子知识。该任务采用与分子描述生成相同的评价指标,以评估生成答案的正确性。
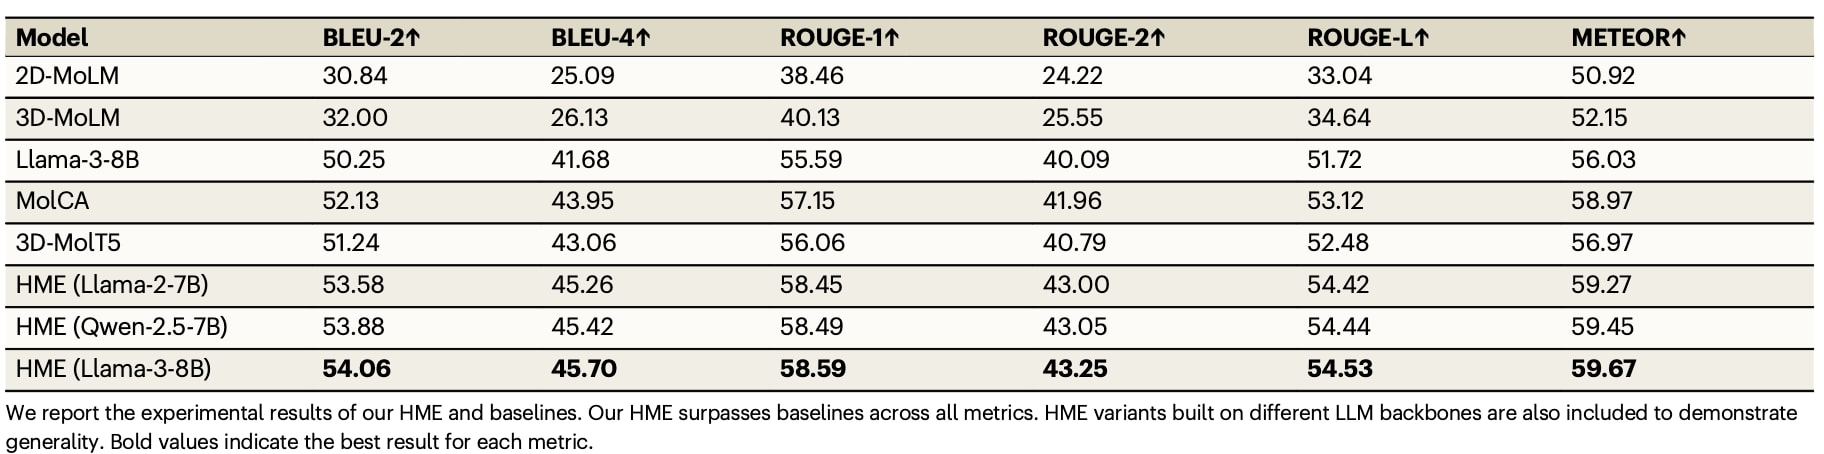
如表2所示,HME 在该任务上同样优于各类基线模型。与表现较强的基线相比,**HME(Llama-3-8B)**继续保持较好的性能,其 METEOR 得分达到 59.67,高于 MolCA 的 58.97 和 3D-MolT5 的 56.97。这一稳定优势进一步表明,异质分子编码能够为 LLM 提供更加丰富的多模态上下文,从而支持其回答复杂的分子相关问题。此外,基于 Llama-2-7B 和 Qwen-2.5-7B 构建的 HME 分别取得 59.27 和 59.45 的 METEOR 得分,说明该架构的有效性具有良好的普适性,并不依赖于某一种特定的 LLM 骨干网络。补充表13中的具体案例显示,HME 能够准确回答分子的物理状态、熔点和溶解度等关键细节,体现出其实际应用价值。
图2a还采用小提琴图展示了高质量生成文本的得分分布。从后六幅图可以看到,尽管 HME 与 Llama-3-8B 使用相同的 Transformer 解码器,HME 在 QA 任务中仍能生成数量更多、质量更高的答案。为进一步考察模型的鲁棒性,作者还按照近期提出的方法,分析了模型性能随测试分子相对于训练集的分布外程度变化的情况。结果表明,即使面对与训练数据差异较大的分子,HME 仍能够保持较强的性能,完整分析见补充说明6。
表2|通用问答任务的性能比较
2.6 分子性质问答
分子性质预测的目标是根据分子结构推断不同的性质数值。在 HME 框架中,传统分子性质预测被转化为**分子性质问答(molecular property QA)**范式,使用户能够通过自然语言查询指定感兴趣的分子性质。由此形成了一种更加友好且统一的模型,可同时预测多种分子性质。
HME 能够预测给定分子的多类性质,不仅包括分子量、LogP 和拓扑极性表面积(TPSA)等常规性质,还包括最高占据分子轨道(HOMO)、最低未占据分子轨道(LUMO)、HOMO–LUMO 能隙以及自洽场(SCF)能量等量子化学性质。为评估模型性能,作者利用正则表达式从生成答案中提取预测数值,并与真实值进行比较。
如图2b所示,作者绘制了预测值与真实值之间绝对误差的分布。结果显示,HME 显著优于所有基线方法,体现了异质分子编码的有效性。具体而言,2D 分子图能够提供更加稳定的分子表示,其中包含键类型、原子连接关系等专家知识;3D 坐标虽然能够提供更加细致的空间信息,但也可能存在潜在误差,并且稳定性相对较弱。通过融合 2D 与 3D 信息,HME 能够获得更加稳健、全面的分子几何结构理解。
补充说明5.3进一步采用平均绝对误差(Mean Absolute Error,MAE)进行了详细的定量比较。结果表明,HME 取得了领先性能,其中在分子量预测任务上,相比表现较强的 3D-MolT5 基线,预测误差降低了 46.4%。
此外,HME 在标准社区基准上同样表现出较好的鲁棒性。补充说明5给出了其在 MoleculeNet 的 6 个分子性质预测任务以及 PDBBind 配体亲和力预测基准上的表现。结果显示,HME 的性能可与专门设计的模型相当,部分任务中甚至超过这些模型,进一步验证了 HME 所学习分子表示的实际应用价值。
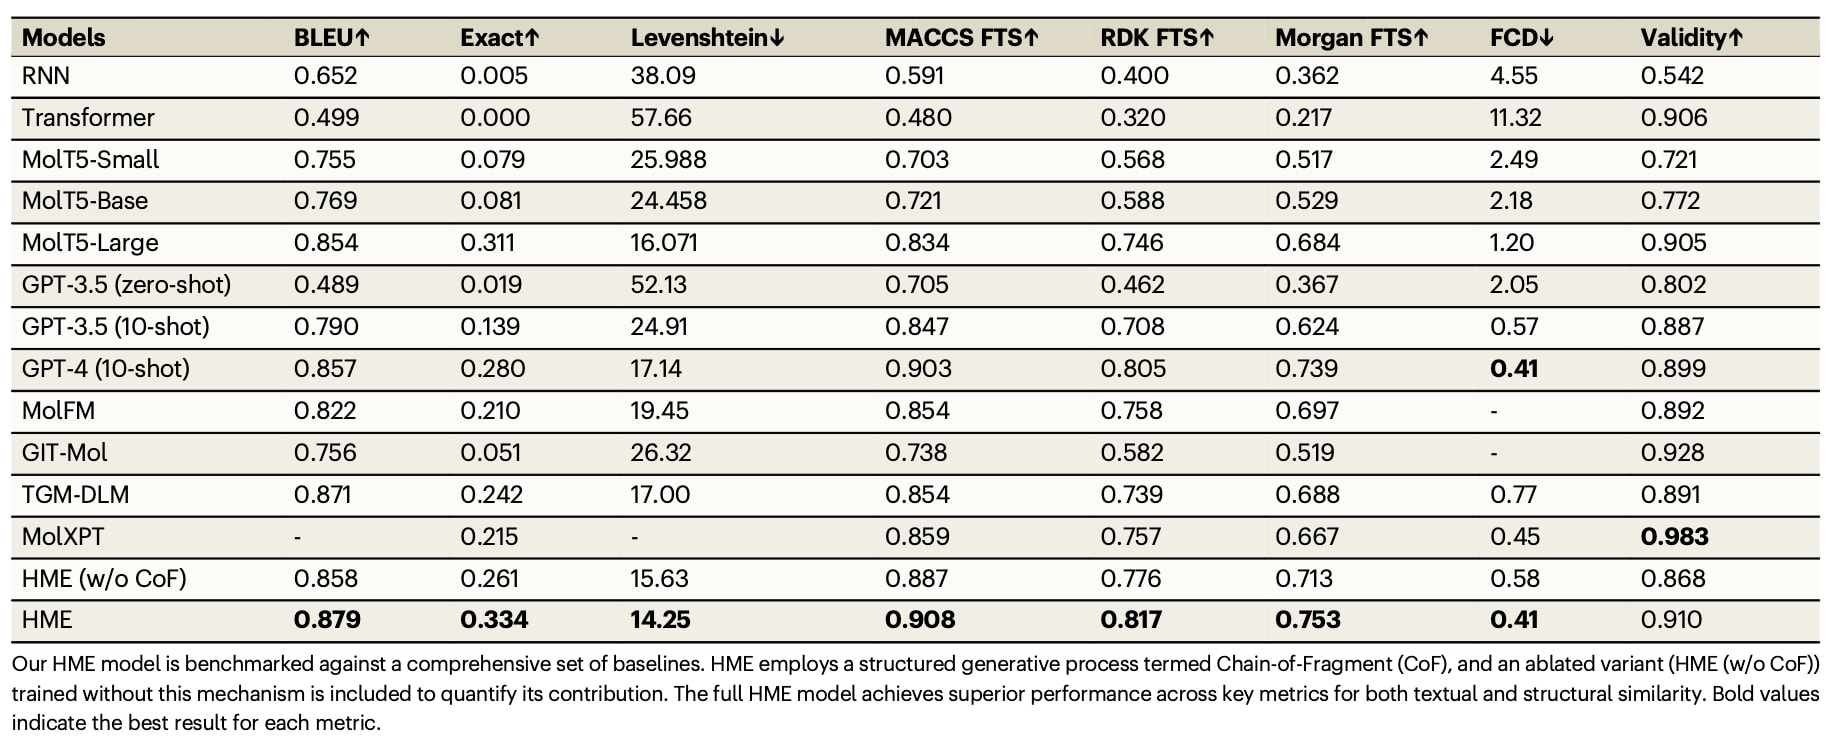
表3|基于描述的分子生成任务性能比较
2.7 条件分子生成任务评估
条件分子生成旨在设计满足特定约束的分子,对于药物设计及相关应用具有重要意义,因为它能够减少在庞大化学空间中的盲目探索。现有方法通常缺乏一种能够灵活进行条件控制的统一框架。在 HME 框架中,作者通过将不同条件表述为自然语言,将多种条件分子生成任务统一为下一 Token 预测问题。借助自然语言的灵活性,HME 展现出显著的零样本泛化能力。与此同时,引入分子片段序列还使模型能够采用一种结构化生成过程,即片段链(Chain-of-Fragment,CoF)。
该研究以 MCMoD 数据集为基准,对 HME 在三类条件分子生成任务中的表现进行了评估,包括基于描述的分子生成、蛋白质–配体设计以及多目标逆向分子设计。基线模型涵盖范围较广,包括简单 RNN、基础 Transformer、不同规模的 MolT5、具有较强零样本/少样本能力的 GPT-3.5,以及生成式分子预训练模型 MolXPT。此外,还纳入了近期提出的多个强基线模型,包括 MolFM、GIT-Mol 和基于扩散模型的 TGM-DLM,以进行更加全面的比较。
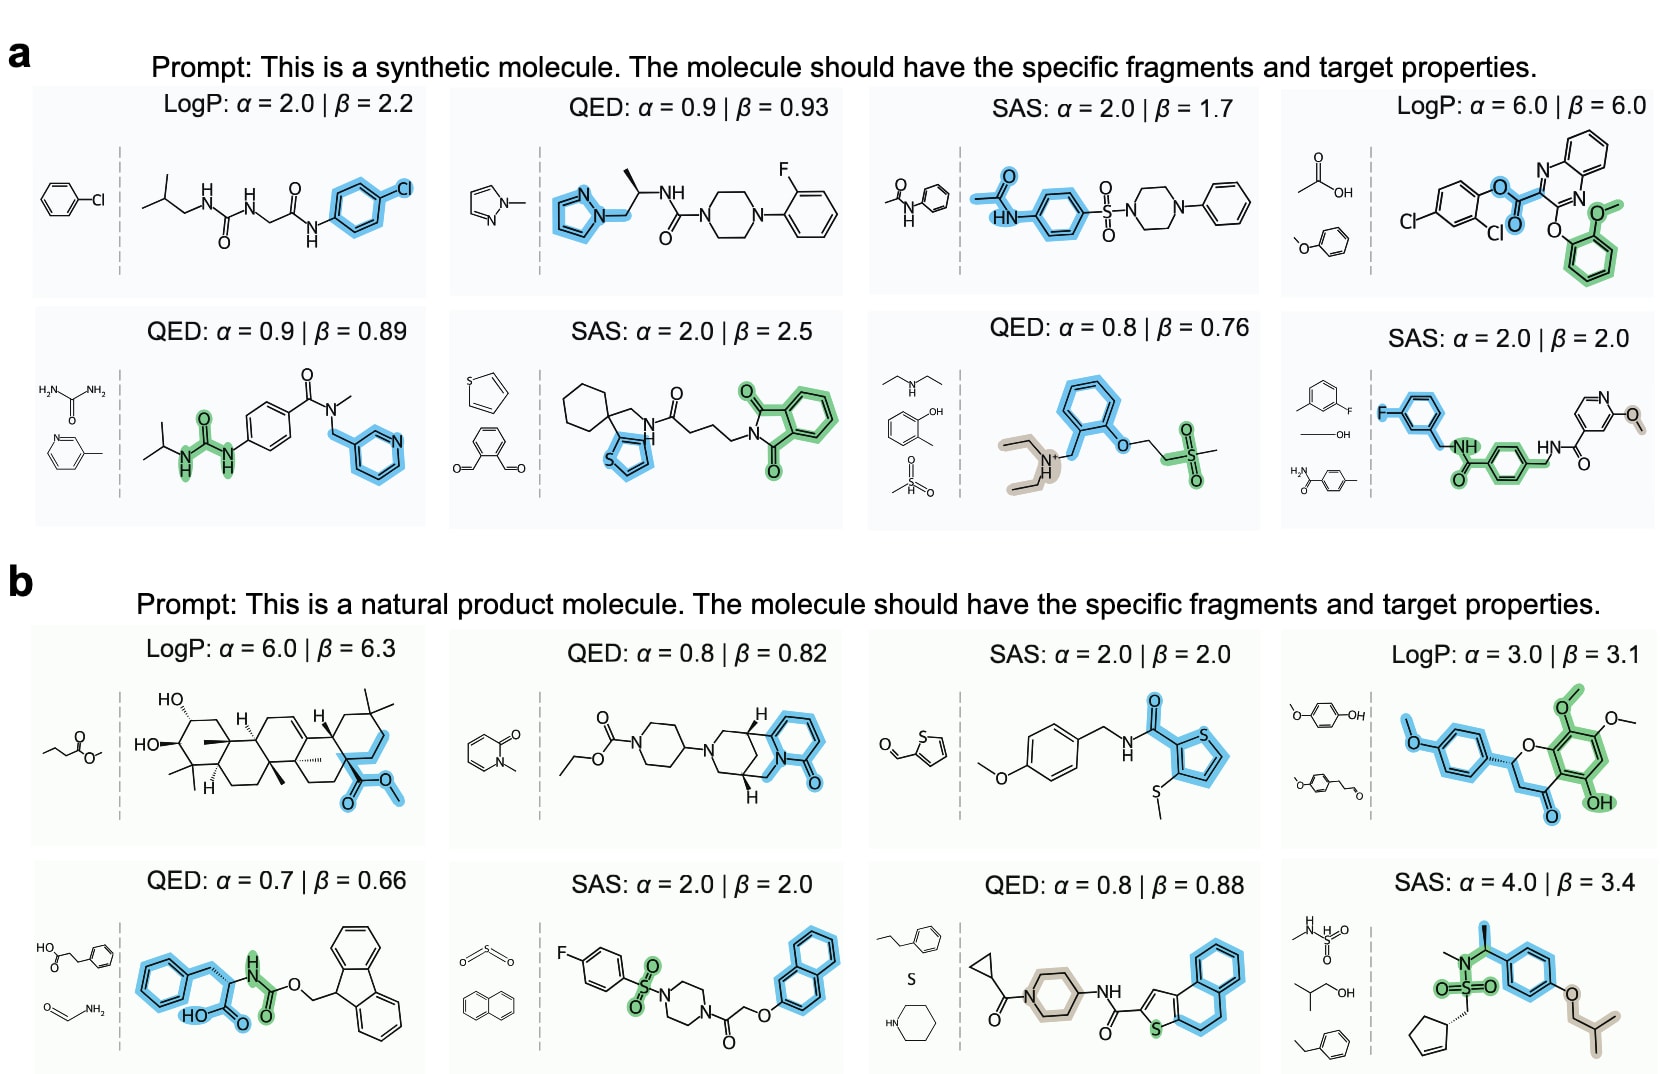
图3|HME 条件分子生成结果可视化。 a,在性质数值和特定分子片段的联合控制下,展示 HME 设计的 8 个合成分子。
2.8 基于描述的分子生成
与分子描述生成任务相反,该任务旨在根据详细的文本描述生成对应分子。其重要意义在于,化学研究人员可以通过给出精确的自然语言要求来设计分子,从而连接人类设计意图与计算分子设计。
以往方法通常直接将文本描述映射为 SMILES,而 HME 则采用 CoF 机制实现分层的化学蓝图构建过程。该方法首先确定分子片段 Token,再进一步确定精确的原子排列,从而提高分子生成准确性。为评价模型生成分子与参考分子之间的相似程度,该研究采用了多种指标,包括 BLEU、不同类型的分子指纹相似度,以及用于衡量分子在化学空间中分布距离的 Fréchet ChemNet Distance(FCD)。
如表3所示,HME 在 8 项评价指标中的 7 项取得最佳性能,超过了包括 MolT5-Large 和基于扩散模型的 TGM-DLM 在内的强基线。例如,HME 获得了最高的精确匹配率(Exact Match)0.334,以及最低的 Levenshtein 距离 14.25,表明其在精确生成目标分子结构方面具有较强能力。
为直接量化 CoF 机制的贡献,作者进一步进行了消融实验,将 CoF 模块从模型中移除。如表3最后两行所示,移除 CoF 后,各项关键指标均出现稳定且明显的性能下降。例如,Exact Match 相对下降 21.9%,Morgan 指纹相似度(Morgan FTS)相对下降 5.3%。这些结果验证了该结构化生成机制的重要作用。关于 CoF 机制的更多定性案例和定量分析见补充说明3。
2.9 基于口袋的配体生成
为在更具科学严谨性和实际意义的场景中评估 HME 的能力,该研究进一步从简单的亲和力预测转向**基于口袋的配体生成(pocket-based ligand generation)**任务。该任务的目标是在给定蛋白质结合口袋三维几何结构的条件下,生成候选配体。这要求模型学习从多样化的 3D 口袋结构到满足特定性质要求的分子之间具有泛化能力的映射关系。
为此,作者在 HME 架构中进一步加入专门的蛋白质结构编码器及对应的 Query Learning 模块,用于处理蛋白质口袋的几何信息。此外,还采用**多条件提示(multi-conditional prompting,MCP)**为模型提供显式的指令引导。通过将目标性质,例如 QED 为 0.7、SAS 为 4、结合亲和力为
该方法在标准 CrossDocked2020 数据集上进行评测,以确保能够与现有主流方法进行直接比较。结果表明,与多种强基线相比,HME 能够稳定生成性质更加理想的分子。具体而言,HME 获得了领先的平均结合亲和力
这种优势同样体现在药物样性质方面。例如,HME 的平均 QED 达到 0.71,明显高于所有基线模型。综合各项性质后,HME 的成功率达到 44.4%,同样处于领先水平,并明显超过次优模型 TamGen。完整的性质分布结果见补充说明4。
多条件提示机制进一步赋予了 HME 较强的生成可控性。通过系统改变输入提示中的目标性质数值,可以有效调节所生成分子的性质分布。同时,生成分子在结构和几何层面也表现出较高的一致性,其化学键、原子间距离以及环系分布与参考分子较为接近。
这些综合评估结果表明,HME 可作为一种稳健且可控的基于口袋的配体生成框架。关于模型可控性、结构一致性以及该任务的其他详细分析见补充说明4.3。
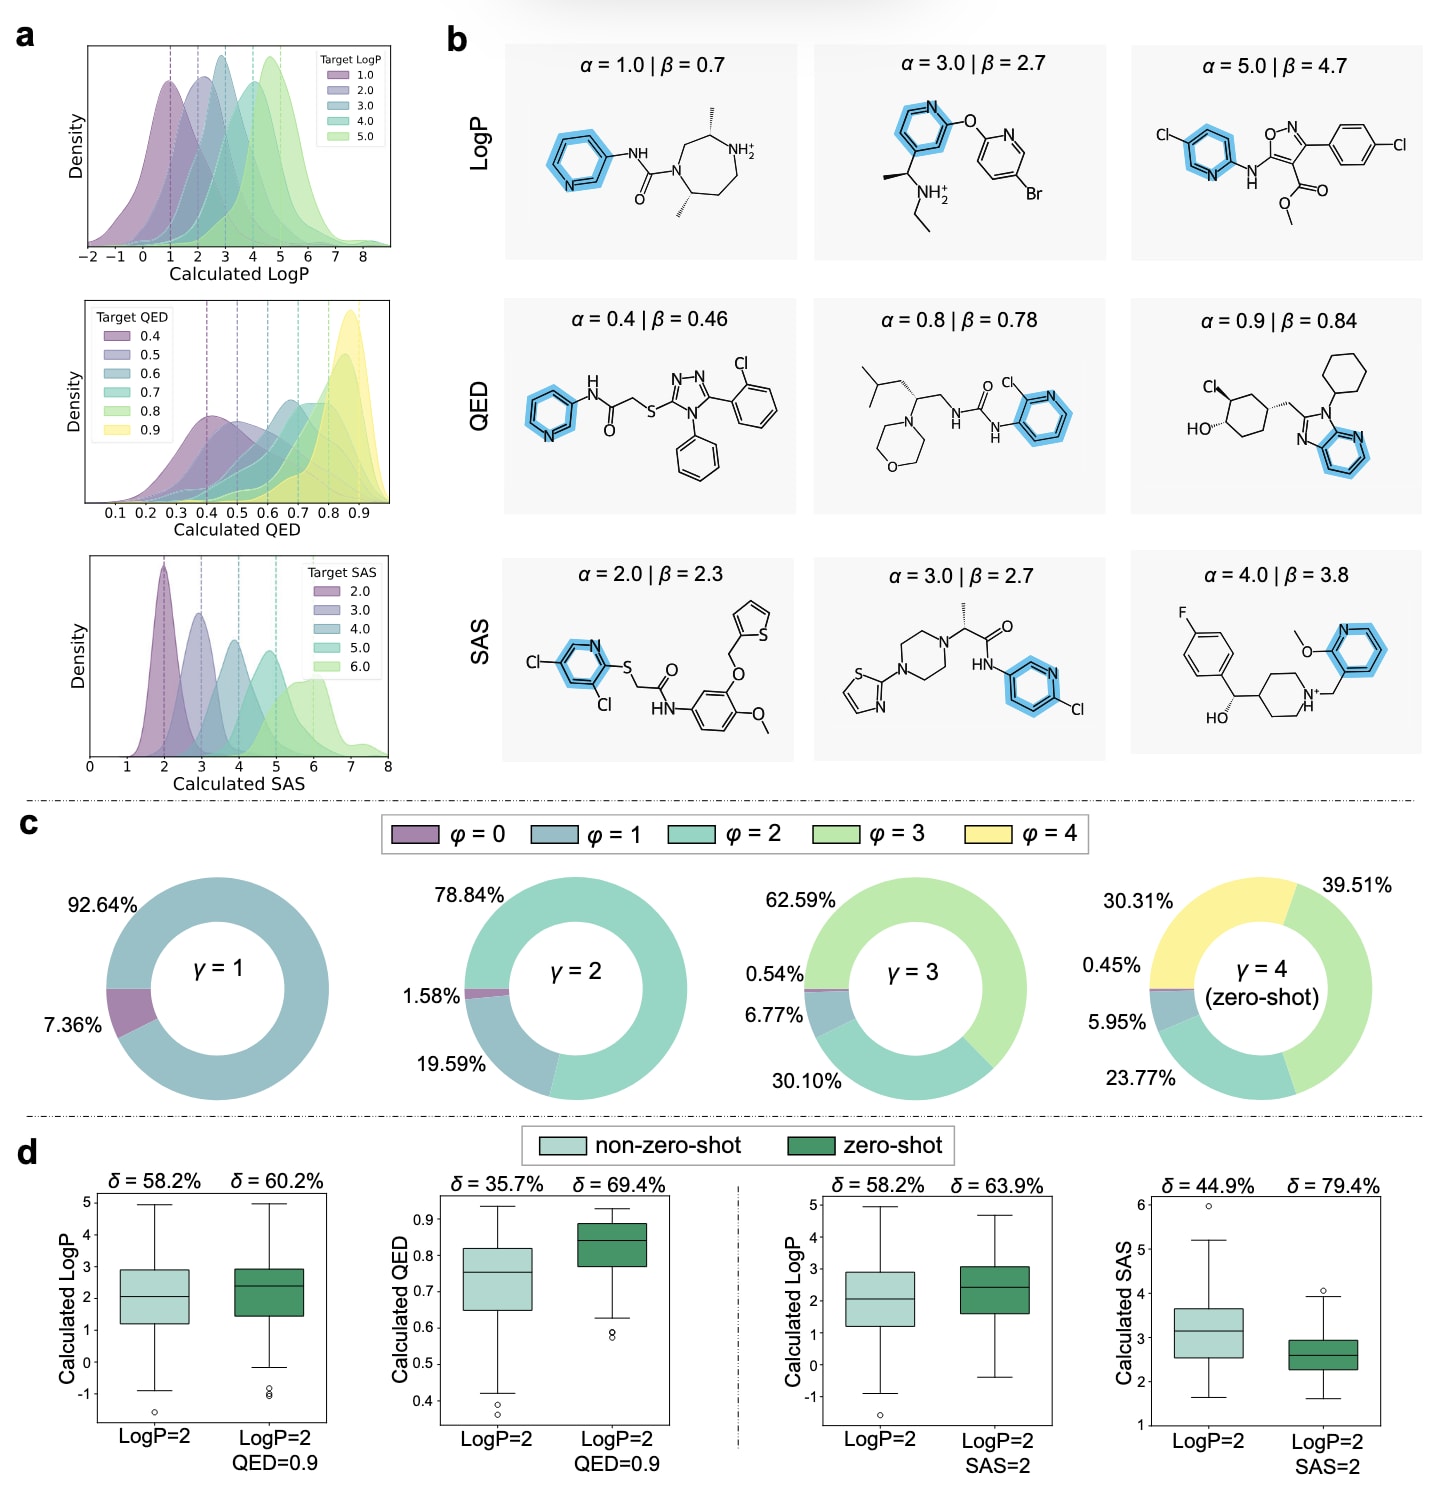
图4|HME 条件分子生成与零样本分子生成的定量分析。 a,单性质控制。密度图显示,由 RDKit 计算得到的生成分子的实际 LogP、QED 和 SAS 值集中分布在各自指定的目标值附近。b,片段–性质联合控制。生成分子均包含固定的吡啶(Pyridine)片段,并能够匹配不同的目标性质值(
2.10 多目标分子逆向设计
多目标分子逆向设计的目标,是生成能够同时满足多种约束条件的分子,这对于药物设计等应用至关重要。此前,条件分子生成已基于理化性质借助扩散模型进行探索,也有研究通过基于语法的形式化表示实现对结构片段的条件控制。HME 在此基础上进一步实现了性质与分子片段的联合条件生成。通过将统计上常见的分子片段表示为扩展 LLM 词表中的离散 Token,HME 能够在单一且灵活的自然语言提示中,同时指定目标理化性质和所需结构片段。
为验证这种多目标设计能力,作者系统评估了 HME 在同时满足多类约束条件下生成分子的能力,这些约束涵盖理化性质(LogP、QED、SAS)以及特定结构片段。如图3a–b所示,生成分子能够成功包含指定片段,同时其计算得到的性质值也与目标值高度接近。例如,图3b中的第 7 个案例显示,即使给定的两个条件片段本身类药性较低,其 QED 分别仅为 0.46 和 0.56,HME 仍能够生成最终 QED 高达 0.88 的分子,体现出其在复杂多目标化学设计空间中的探索能力。
为进一步验证条件控制的有效性,作者在测试集上生成了 6400 个分子,并对其相关指标进行了评估,结果如图4所示。图4a表明,生成分子的实际性质值分布能够稳定地与提示中给出的目标值保持一致,从而验证了单性质控制的有效性。例如,当目标设定为高类药性(QED = 0.9)或较高合成可及性(SAS = 2)时,生成分子的性质分布更加集中,说明模型能够在具有化学意义的性质区间内实现较为精准的控制。此外,定量分析还表明,模型能够生成具有类天然产物特征的分子,具体结果见补充说明10.1。
为更加严格地评估模型的性质控制能力,作者还在标准 QM9 多性质生成基准上进行了测试。结果显示,HME 与 EEGSDE、TextSMOG 和 JODO 等专用生成方法相比具有很强的竞争力,详细结果见补充说明10.2。
除性质控制外,HME 还能够有效实现分子片段条件控制。图4c前三个环形图分别展示了在指定 1、2 或 3 个片段作为控制条件时,生成分子成功包含这些片段的比例。完整包含全部指定片段的成功率分别达到 92.64%、78.84% 和 62.59%。这表明,尽管随着片段数量增加,任务难度显著提高,HME 仍保持了较好的生成性能。
进一步来看,当指定 3 个片段时,如果将“至少成功包含其中 2 个片段”也视为成功,则成功率可达到 92.69%。与此同时,随着控制片段数量增加,生成分子中完全不包含任何指定片段的比例迅速下降,分别为 7.36%、1.58% 和 0.54%。这些结果表明,HME 能够有效学习从指定片段到完整分子结构之间的映射关系。
2.11 零样本分子生成
借助自然语言条件表达的灵活性以及下一 Token 预测机制,HME 展现出显著的零样本(zero-shot)泛化能力。具体而言,在多目标分子逆向设计任务中,尽管训练数据最多只包含 3 个控制片段,HME 仍能够在指定 4 个片段的条件下生成目标分子。此外,虽然模型训练阶段仅针对单一性质条件进行控制,但仍能够有效泛化至多性质联合控制场景。
如图4c第 4 个子图所示,在指定 4 个控制片段(
此外,69.82% 的生成分子至少包含 3 个指定片段,高于
如图4d所示,作者进一步评估了 HME 对训练阶段未出现过的性质约束组合的泛化能力。由于模型训练时仅使用单性质控制条件,因此任何包含多个性质的提示都属于零样本任务。实验首先以非零样本的单性质提示 LogP = 2 作为基准,该取值因与口服生物利用度密切相关而被选用,并将其与两种零样本双性质提示进行比较。
在左侧两个子图中,在 LogP = 2 的基础上额外加入目标值为 QED = 0.9 的零样本约束后,模型对主要性质 LogP 的控制并未受到明显影响,同时 QED 的分布能够集中于其目标值附近。
在右侧两个子图中,当进一步引入目标值为 SAS = 2 的约束时,也观察到了类似结果。即模型仍能够保持对主要性质的控制,同时使新增的第二性质有效趋近目标值。
这些结果表明,HME 能够在不削弱主要性质控制能力的情况下,引入训练阶段未见过的第二性质约束,从而实现有效的零样本多性质条件分子生成。这种泛化能力有望提高药物设计过程中的分子探索效率,并扩大对庞大化学空间的有效搜索范围。
3 讨论
该研究提出了 HME,一种统一框架,旨在赋予 LLM 更加全面的化学理解能力,同时支持分子理解和分子设计。其核心思想是整合异质分子表示,包括 1D SMILES、2D 拓扑结构、3D 坐标以及统计得到的分子片段,从而为 LLM 提供更加完整的结构上下文。
在架构设计方面,HME 以 Query Learning 模块为核心,通过可学习适配机制有效连接专用分子编码器与 LLM 的嵌入空间。在生成任务中,进一步提出 CoF 机制,采用结构化的分层生成过程,在生成完整分子之前首先构建化学结构蓝图。
需要指出的是,尽管 CoF 采用分层生成形式,但其本质仍是建立在化学空间统计规律之上的结构蓝图构建工具,与 GPT-4 或 DeepSeek-R1 等推理模型中的抽象逻辑推理存在本质区别。CoF 并非进行符号逻辑推理,而是通过学习分子片段与原子结构之间的概率依赖关系来优化分子生成。
为推动该方向的研究,作者还构建并发布了大规模多条件分子设计数据集 MCMoD。广泛的实验结果表明,HME 在多类任务中均展现出较强性能。在分子理解任务中,其在分子描述生成和问答任务上的表现均超过了多个强基线模型;在条件分子生成任务中,HME 能够对多种理化性质进行精准控制,并能够对训练阶段未见过的约束组合实现较强的零样本泛化。此外,在具有较高挑战性的基于口袋的配体生成任务中,该方法能够有效利用蛋白质 3D 几何信息,并取得良好的生成效果。这些结果进一步说明,将丰富的多模态分子结构信息引入 LLM 对化学发现具有重要价值。
不过,尽管 HME 已能够生成满足特定约束条件的分子,实现真正意义上的从头药物设计(de novo drug design)仍然面临较大挑战。具体而言,虽然该框架能够在训练化学空间的边界区域进行一定程度的探索,但生成结构总体上仍更倾向于已有化学结构的渐进式衍生物,而不是早期先导发现中通常需要的显著骨架跃迁(scaffold hopping)。
因此,当前 HME 在先导化合物优化等需要严格满足结构约束的任务中具有较大应用潜力,但如果希望进一步拓展至更广泛的药物设计场景,仍需提升模型在较少约束条件下进行全新结构创新的能力。
此外,该研究目前尚未对分子动力学进行建模,而分子动力学对于理解蛋白质–配体相互作用及构象变化正变得越来越重要。后续研究计划将 HME 扩展至化学反应和分子动力学相关任务。同时,还计划在现有基于口袋的分子设计能力基础上,进一步探索药效团建模和先导化合物优化,从而拓展其在药物设计流程中的应用。