NC 2025|DataSAIL:避免信息泄漏的数据划分
在生物医学机器学习中,模型性能“看起来很高”,并不一定意味着真正具备可靠的泛化能力。一个常被忽视的问题是:训练集与测试集之间可能存在过高的分子、蛋白或序列相似性,从而造成隐性的信息泄漏,导致模型测试结果被系统性高估。今天介绍的 DataSAIL 正是针对这一问题提出的一套通用数据划分框架。该方法将“低泄漏数据划分”形式化为组合优化问题,并结合聚类与整数线性规划,在保证数据比例和类别分布的同时,尽可能降低不同数据子集之间的相似性。实验表明,DataSAIL 可同时处理一维和二维生物分子数据,并能构建更接近真实分布外场景的评估集,为分子性质预测、药物–靶标相互作用预测等任务提供更加严格、可信的模型评估方案。
获取详情及资源:
0 摘要
信息泄漏正日益成为生物医学机器学习研究中的重要问题。当模型训练过程中发生信息泄漏时,模型可能倾向于记忆训练数据,而非学习具有泛化能力的规律。这会导致性能指标被高估,无法真实反映模型在实际推理阶段的表现。
DataSAIL 是一个通用的 Python 软件包,旨在通过降低数据划分过程中的信息泄漏,为面向分布外(out-of-distribution,OOD)场景的生物数据机器学习模型提供更加真实可靠的性能评估。DataSAIL 将寻找低泄漏数据划分的问题形式化为组合优化问题。作者证明该问题属于 NP-hard 问题,并提出一种基于聚类与整数线性规划(integer linear programming,ILP)的可扩展启发式求解方法。
最后,通过一系列实证实验,作者展示了 DataSAIL 对生物医学机器学习模型评估结果的实际影响。
1 引言
监督式机器学习(machine learning,ML)是当前发展最快的研究领域之一,并持续推动计算机科学和生命科学多个方向取得进展。许多生物信息学任务都受益于 ML 模型,例如分子性质预测和药物–靶标相互作用预测。
为了使这些 ML 模型能够成功应用于真实场景,所报告的性能评估必须能够可靠反映模型在实际推理阶段的表现。如果用于模型评估的测试集无法代表实际推理时所面对的数据分布,模型可能在测试阶段表现出虚高的性能,从而影响其在真实应用中的部署。当模型在测试时利用了来自训练集的信息,而这些信息在实际推理阶段并不可获得时,就会出现这种性能失真现象,即信息泄漏(information leakage)或数据泄漏(data leakage)。近年来的研究表明,信息泄漏已经成为许多基于 ML 的研究领域中一个重要且普遍的问题,会导致生物医学机器学习研究乃至其他领域出现性能高估和过度乐观的结论。
最简单的信息泄漏形式,是同一样本同时出现在数据划分后的多个子集中。这类问题较容易控制,大多数常见的数据划分方法都会通过去除重复数据点来避免这一情况。另一类更隐蔽、也更难检测的信息泄漏,则可能发生在训练集与测试集之间的数据相似性,高于训练集与模型实际推理数据之间的相似性时。在这种情况下,ML 模型实际上是在与训练数据同分布(in-distribution)的测试数据上接受评估,而其预期应用场景却要求模型能够对分布外(out-of-distribution,OOD)数据进行可靠预测。因此,模型可能依赖基于相似性的“捷径”在测试集上取得良好表现,但这些捷径无法泛化到预期的真实应用场景。
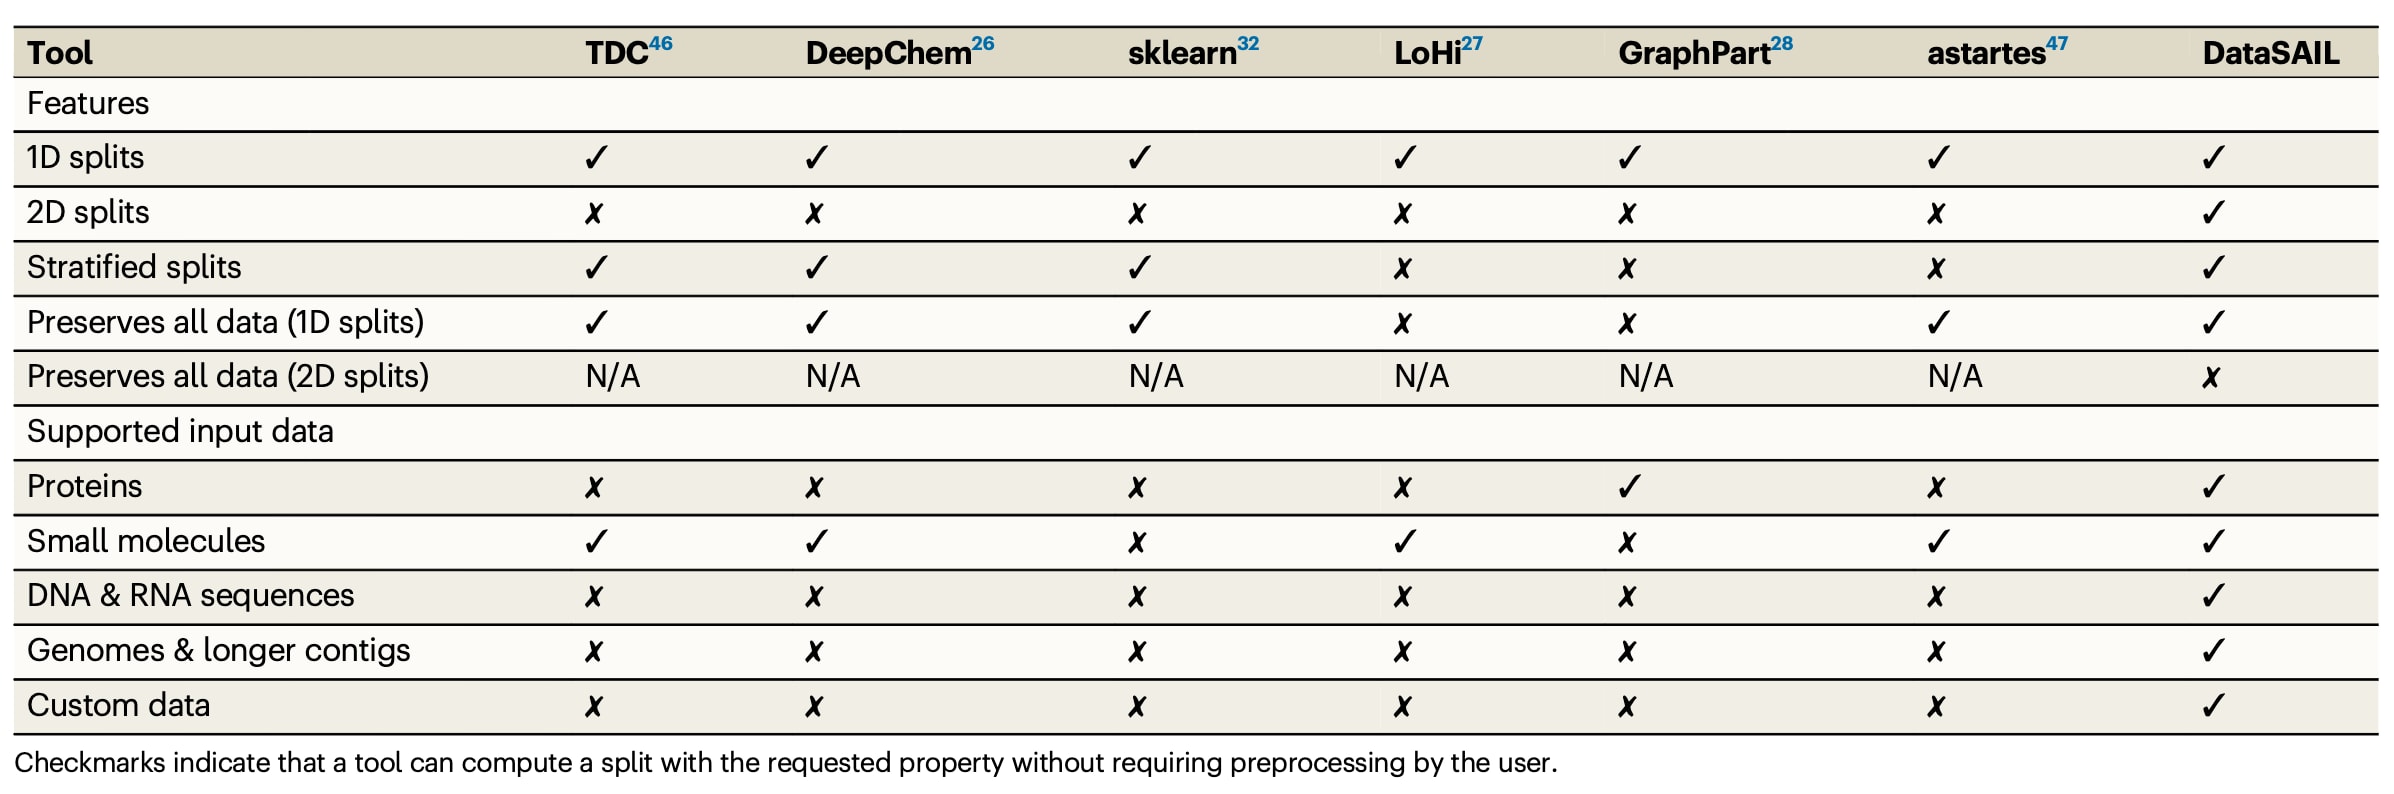
表1|不同数据划分工具和框架及其面向生化数据能力的概览
对于具有复杂依赖关系的生物分子数据而言,如果沿用 ML 领域常见的随机划分策略,将基准数据集随机分成训练集、验证集和测试集,就尤其容易陷入这一问题。例如,在根据蛋白质序列预测蛋白质–蛋白质相互作用(protein–protein interaction,PPI)的深度学习研究中,这类信息泄漏现象已被证明十分普遍。许多模型在原始论文采用的随机数据划分上表现优异,但当测试对象变为与训练数据低同源、更加接近“预测表征不足蛋白质 PPI”这一实际应用场景的蛋白质对时,其性能往往会下降至接近随机水平。
类似的问题也出现在错义变异有害性预测中。如果影响同一蛋白质的相似变异被分配到不同的数据子集中,ML 模型就可能利用蛋白质层面的捷径获得很高的测试性能。例如,模型甚至可以仅根据训练集中某一蛋白质对应变异的多数类别进行简单的蛋白质层面多数投票。这样的模型在面对注释稀疏蛋白质上的变异时往往泛化能力较差;对于在推理阶段同时出现有害和无害变异的蛋白质,还可能系统性地错误分类其中的少数类别变异。
该研究重点解决这样一类信息泄漏问题:模型预期部署于 OOD 数据,但评估却是在具有误导性的同分布数据上完成。为此,作者开发了 DataSAIL,一种用于将数据集划分为多个子集的算法框架和工具,使模型在 OOD 数据上的性能能够得到更加真实的估计。虽然此前已经针对特定生物分子 ML 任务构建了一些专门的数据集,例如用于 PPI 预测的 PINDER 和相应金标准数据集,以及用于蛋白质–配体相互作用预测的 PLINDER,但 DataSAIL 具有更强的通用性:只要能够为数据点定义相似性或距离度量,就可以用于划分任意类型的数据。
DataSAIL 将数据划分问题形式化为一个约束优化问题,并证明该问题属于 NP-hard 问题。在此基础上,作者开发了一个 Python 软件包,通过聚类和整数线性规划(integer linear programming,ILP)对该问题进行启发式求解。与现有用于降低信息泄漏的数据划分工具和算法相比,DataSAIL 能够自动处理由两种不同类型数据组成的异构数据集,并将分层划分(stratification)与相似性感知的数据划分相结合。此外,DataSAIL 的适用范围也更加广泛,可直接用于多种类型的分子数据。
最后,作者在一维和二维生物分子数据集上的多种 ML 模型中对 DataSAIL 进行了验证,结果表明,该方法能够有效降低训练数据与测试数据之间的信息泄漏。
2 结果
2.1 监督式机器学习中的数据划分
在监督式机器学习(ML)中,给定一个包含
其中,特征向量
使损失函数
最小。通常需要先从候选函数中选择一个假设空间
在开发监督式 ML 模型
- 训练集
:用于学习模型参数 ,即在固定假设空间 中选择具体的 ; - 验证集
:用于优化决定假设空间 结构的超参数,例如隐藏层数量,或控制优化策略的超参数,例如学习率和优化器; - 测试集
:用于评估训练完成后的模型在此前未见数据上的性能。
DataSAIL 同时适用于一维和二维数据集。
在一维数据集中,一个特征向量–输出值对
如果特征向量
值得注意的是,对于二维数据集,可以分别沿不同维度定义分子之间的相似性,例如分别在药物维度和靶标维度上计算相似性。根据数据划分过程中是否考虑由相似性引起的信息泄漏,以及数据集是一维还是二维,DataSAIL 定义了多种不同的数据划分任务:
- 基于身份的一维划分(identity-based one-dimensional splitting,I1);
- 基于身份的二维划分(identity-based two-dimensional splitting,I2);
- 基于相似性的一维划分(similarity-based one-dimensional splitting,S1);
- 基于相似性的二维划分(similarity-based two-dimensional splitting,S2);
- 随机相互作用划分(random interaction-based splitting,R)。
这些任务如图 1 所示。其中,基于身份的数据划分不考虑分子之间的相似性,而基于相似性的数据划分则显式考虑这种相似性。
在二维数据划分中,如果一对发生相互作用的分子被分配到不同的数据子集中,则某些相互作用无法在不产生信息泄漏的情况下被分配到任何一个子集。因此,在二维数据划分过程中,部分相互作用可能会被舍弃,对应图 1 中 I2 和 S2 面板里的白色方格。
2.2
该部分进一步提出
直观而言,
虽然该方法主要面向生物医学应用设计,但其问题定义具有通用性。只要能够为数据集中的数据点定义相似度或距离度量,就可以将其应用于任意类型的数据集。
该研究从理论上给出了适用于
更形式化地,设
数据点或聚类
例如,在药物–靶标相互作用任务中,
其中两种实体类型
如果
此外,每个数据点或聚类
对于基本数据点,总有
如果
对于每一种实体类型
并定义
分别表示类型为
此外,假设在
或者距离函数
已有研究曾从定性角度定义信息泄漏,也有研究将其定量表示为
不过,这一定义并不完整,因为它对于每个测试样本仅考虑最大的泄漏程度,同时忽略了验证集。
因此,DataSAIL 考虑一个映射
通过该映射将
在此基础上,将由映射
其中,
该泄漏函数
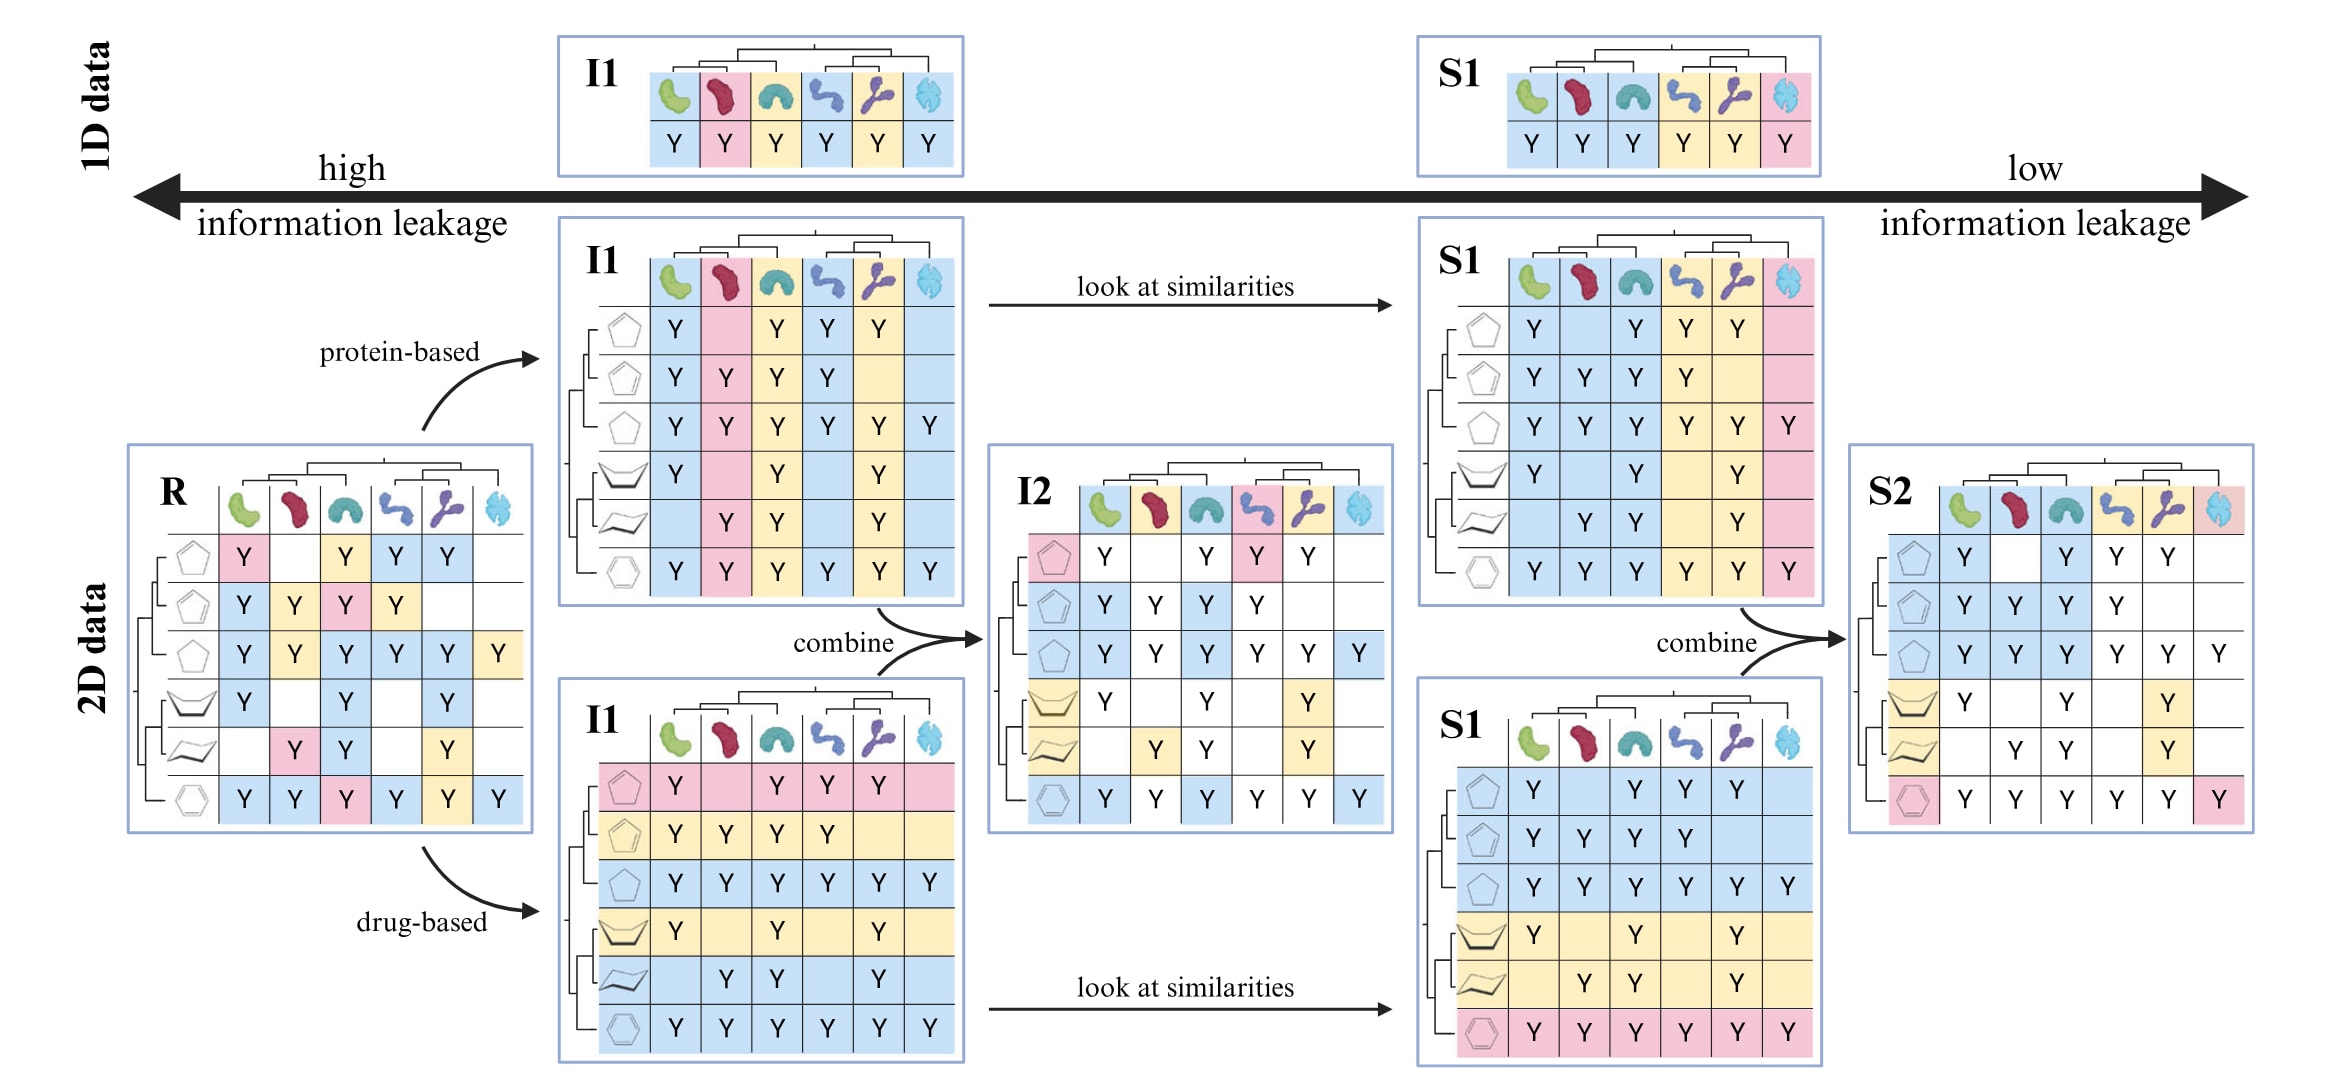
图1|一维和二维示例数据集的可视化 符号“Y”表示存在对应的测量值,矩阵旁的系统发育树用于展示样本之间的相似性。该图展示了所有数据划分任务及其相互关系。分配至训练集的样本以蓝色背景表示,验证集样本以黄色表示,测试集样本以红色表示;无法分配的单元格则保留为白色。
在典型的 ML 数据划分任务中,
分别对应
以及
因此,
设
为用户指定的第
例如,可以设定
分别对应
对于所有实体类型与数据子集的组合
第一组约束要求映射
范围内满足预设的数据划分比例:
对于满足
在许多 ML 应用中,数据元素
此时通常希望得到分层划分,使每一个类别
为此,进一步增加约束:
对于所有
均成立。其中,
表示属于实体类型
表示这类数据元素的总基数,而
表示允许的相对误差。
这里有两点值得注意。
第一,当
时,式(4)给出的约束能够推出式(3)的约束,因此当
时,可以省略式(3)。
第二,当没有类别信息时,即所有数据元素都属于同一个“虚拟类别”,例如
则式(4)和式(3)仅在
至此,
满足约束
定理 1。 对于所有
为了在这一计算复杂性限制下仍然能够获得低泄漏的数据划分,作者设计了一套启发式工作流程。首先,将单个数据点聚类为固定数量的簇;随后将这些聚类作为数据元素,求解一个固定规模的
约束数量为
当
在得到
首先,将每个聚类
定义
随后,仅当特征向量
时,才将特征向量–标签对
分配到第
例如,在药物–靶标相互作用预测中,特征向量
具体而言,如果某个药物被分配到训练集,而与之相互作用的蛋白质被分配到测试集,那么对应的
将不会被保留。通过这种方式,DataSAIL 避免由于二维数据中不同实体跨数据子集分配而引入额外的信息泄漏。
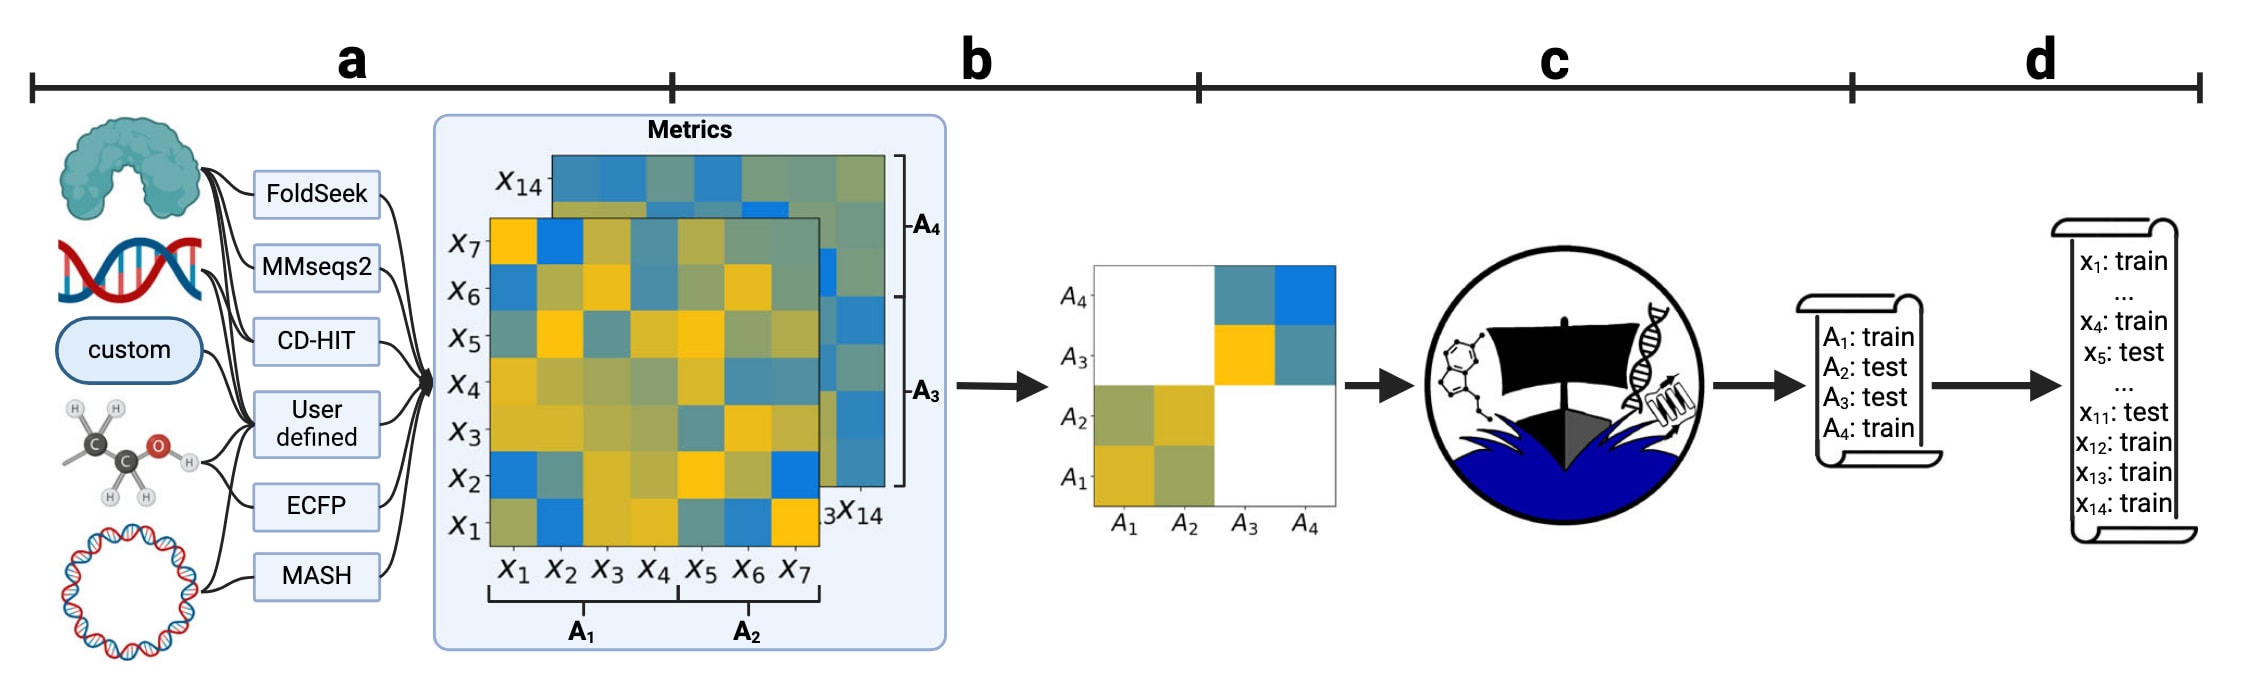
图2|DataSAIL 的工作流程示意图 输入可以是任意类型的数据,其中重点面向生化数据。DataSAIL 首先计算两两距离或相似性矩阵(a),并据此将数据划分为固定数量的聚类(b)。随后,利用现成的整数线性规划(ILP)求解器,将这些聚类划分为
2.3 生物分子数据集的划分
首先考察一维数据。作者在 DataSAIL 生成的随机划分和基于相似性的划分(S1),以及另外两种竞争方法生成的数据划分上,训练并测试了 4 种基线机器学习模型,包括随机森林(random forest,RF)、支持向量机(support vector machine,SVM)、梯度提升模型(XGB)和多层感知机(multilayer perceptron,MLP),以及用于分子性质预测的深度学习模型 D-MPNN。
实验采用 MoleculeNet 数据集集合中两个广泛使用的数据集:QM8 为回归任务,对应图 3 上半部分;Tox21 为分类任务,对应图 3 下半部分。补充图 1 进一步给出了其他竞争方法以及 MoleculeNet 中更多一维数据集上的结果。
正如预期,DataSAIL 能够实现训练样本与测试样本之间更充分的分离。尤其是在两个数据集上,DataSAIL 生成的数据划分在所有比较方法中均表现出最低的信息泄漏
总体而言,与随机划分相比,较小的
对于深度学习模型 D-MPNN,这一结果与其原始论文中的发现一致。原研究已经表明,与随机划分相比,D-MPNN 在基于骨架的数据划分上表现明显更差,而基于骨架的划分与 DataSAIL 的 S1 划分类似,同样依赖于分子结构相似性,具体结果见补充表 1。所有图中均展示了按照式(20)定义进行缩放后的
随后,作者进一步考察二维数据,并对 LPPDBBind 数据集进行划分。该数据集包含 15,477 种药物与 12,718 个蛋白质靶标之间的结合亲和力数据(图 4)。
作者将 DataSAIL 的 I2 和 S2 划分,与分别沿药物维度和靶标维度进行的 I1、S1 划分进行了比较,同时纳入 DeepChem 基于分子指纹的划分方法、LoHi 和 GraphPart。与其他划分算法的进一步比较见补充图 3 和补充图 4。
与一维数据的结果一致,DataSAIL 生成的数据划分始终具有较低的
另一个值得注意的现象是,对于所有测试的 ML 模型,DataSAIL 的 S2 划分均产生了显著低于其他所有数据划分方式的测试性能(图 4i)。这表明,当模型在推理阶段遇到的药物和蛋白质均与训练数据中的药物和蛋白质缺乏相似性时,当前测试的结合亲和力预测模型并不能实现良好的泛化。
据作者所知,DataSAIL 是目前唯一能够直接支持此类划分策略的工具,可用于评估模型在“药物和蛋白质两个维度均属于分布外”的场景下的泛化能力。
值得注意的是,将 DataSAIL 与蛋白质–配体数据集 PLINDER 中针对特定数据集人工构建的划分进行比较后发现,从
相比现有方法,DataSAIL 的另一项改进在于能够将分层划分与信息泄漏最小化结合起来。为了展示 DataSAIL 在这一场景下的效果,作者采用 Tox21 中的 SR-ARE 子任务进行实验。该数据集中包含 6,889 个活性小分子和 942 个非活性小分子。
在该实验中,DataSAIL 并不是与完全随机划分进行比较,而是与经典的、未考虑样本相似性的分层划分进行比较。作者进一步引入相似性感知机制,并观察其对数据划分的影响。结果表明,相应的 DataSAIL 划分能够显著减少信息泄漏(图 5)。
图 5c 右侧对
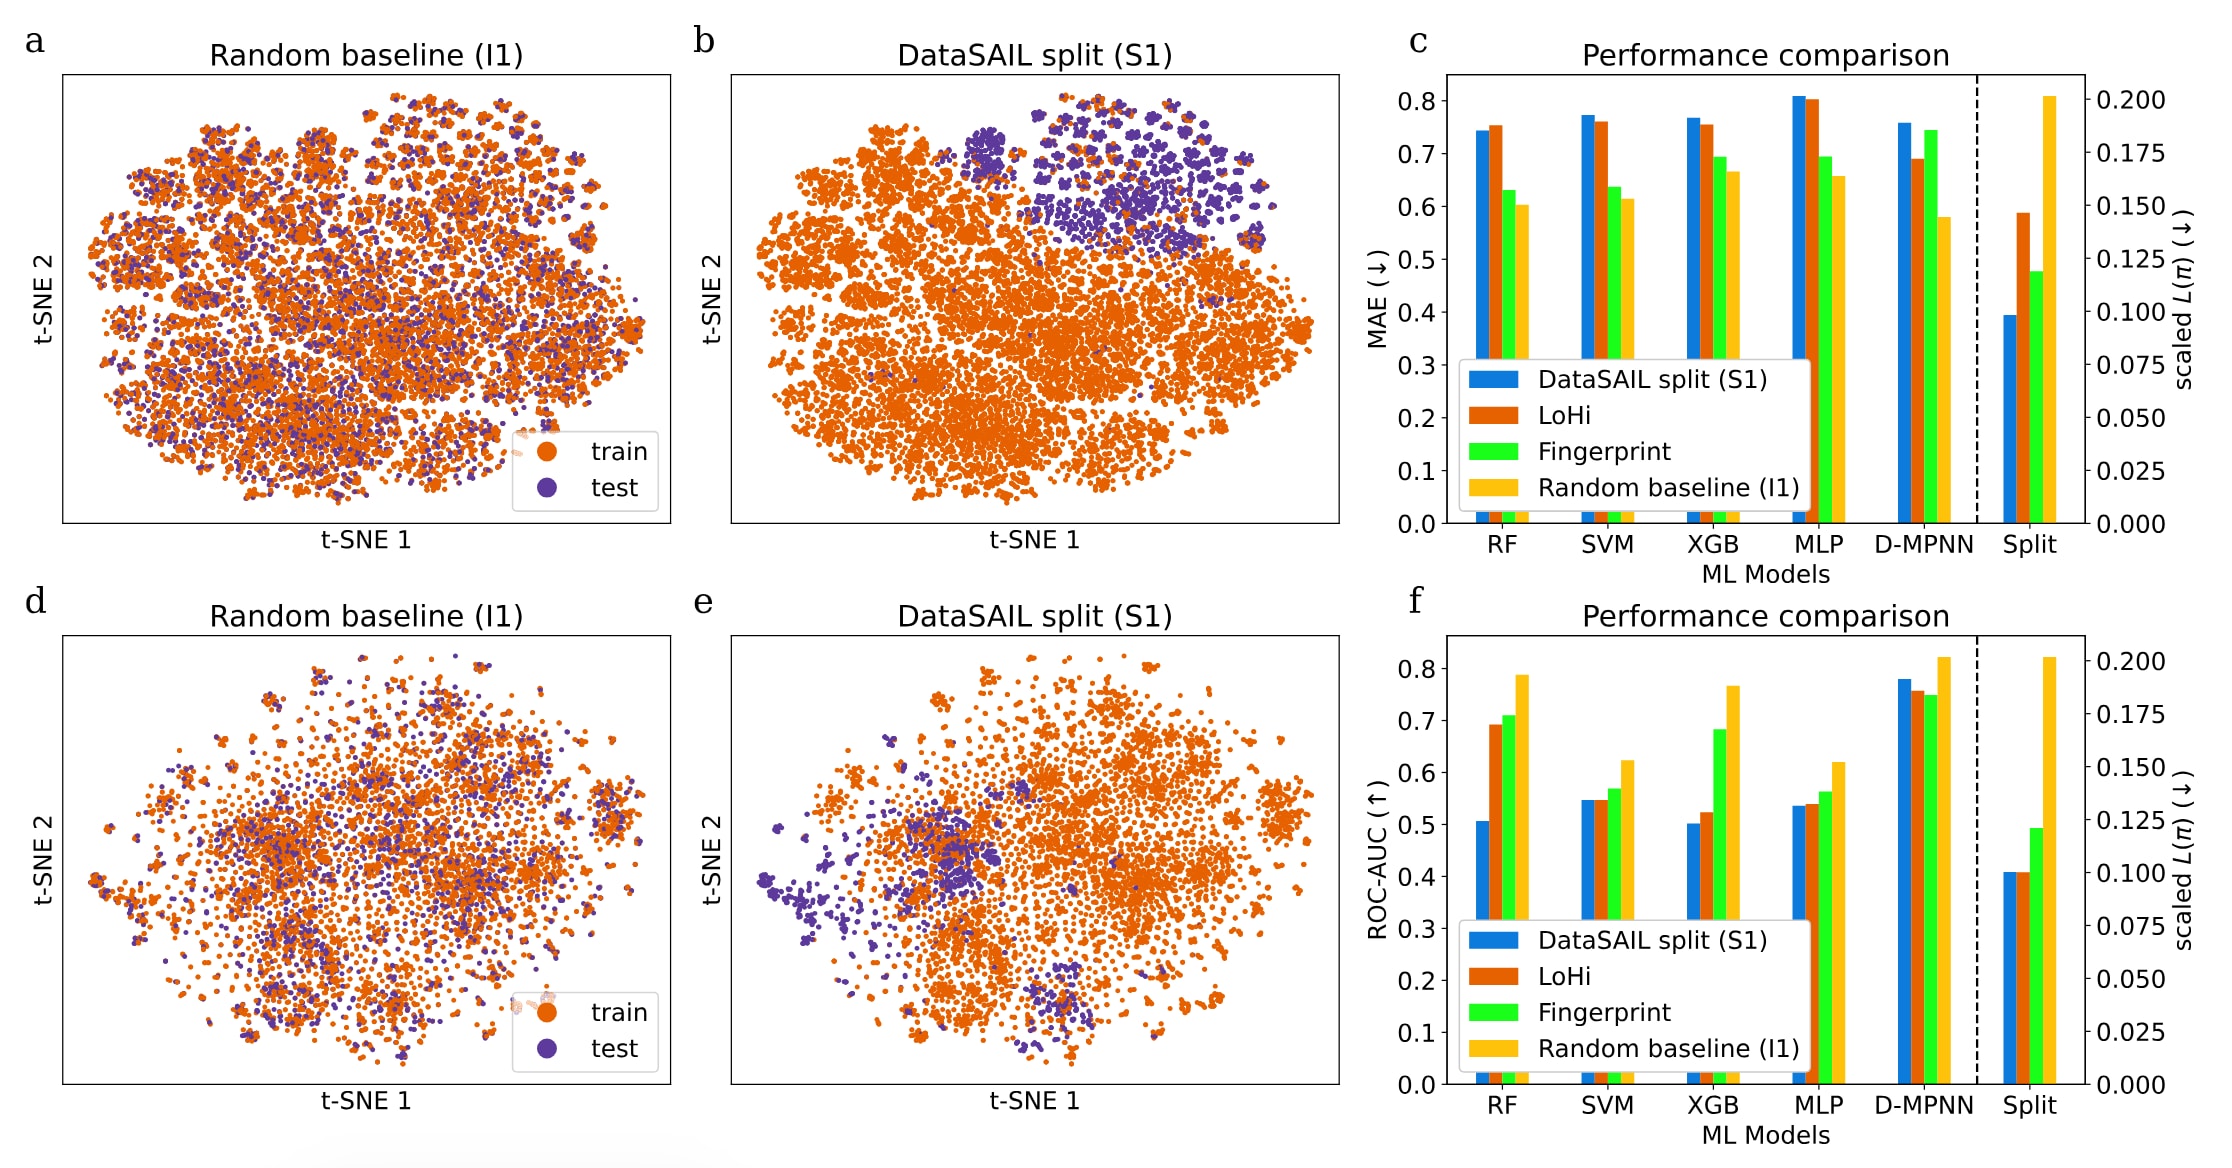
图3|一维数据集 QM8 和 Tox21 展示 MoleculeNet 基准数据集中的 QM8(a、c、e)和 Tox21(b、d、f)。a、d 展示随机划分的 t-SNE 嵌入结果,b、e 展示 DataSAIL 的 S1 划分结果。c、f 展示不同数据划分下的 ML 模型性能和信息泄漏程度,其中 QM8 采用平均绝对误差(mean absolute error,MAE;越低越好)进行评估,Tox21 采用受试者工作特征曲线下面积(ROC-AUC;越高越好)进行评估。
2.4 求解器、超参数及可扩展性的影响
DataSAIL 的一个重要参数是聚类数量
结果显示,当
图 6c 展示了允许的相对误差
结果表明,数据划分质量主要受
由于 MoleculeNet 包含多个规模、结构和相似性特征各不相同的数据集,作者进一步利用该基准测试 DataSAIL、LoHi 和 DeepChem 不同数据划分方法的运行时间(图 6d)。
正如预期,随着数据集规模增大,各种算法计算数据划分所需的时间均有所增加。虽然 DataSAIL 是所比较方法中运行速度最慢的算法,但其扩展性表现较为平稳,并且能够在合理时间内完成所有数据集的划分。相比之下,LoHi 在 MUV 数据集上运行 12 h 后仍未得到结果。
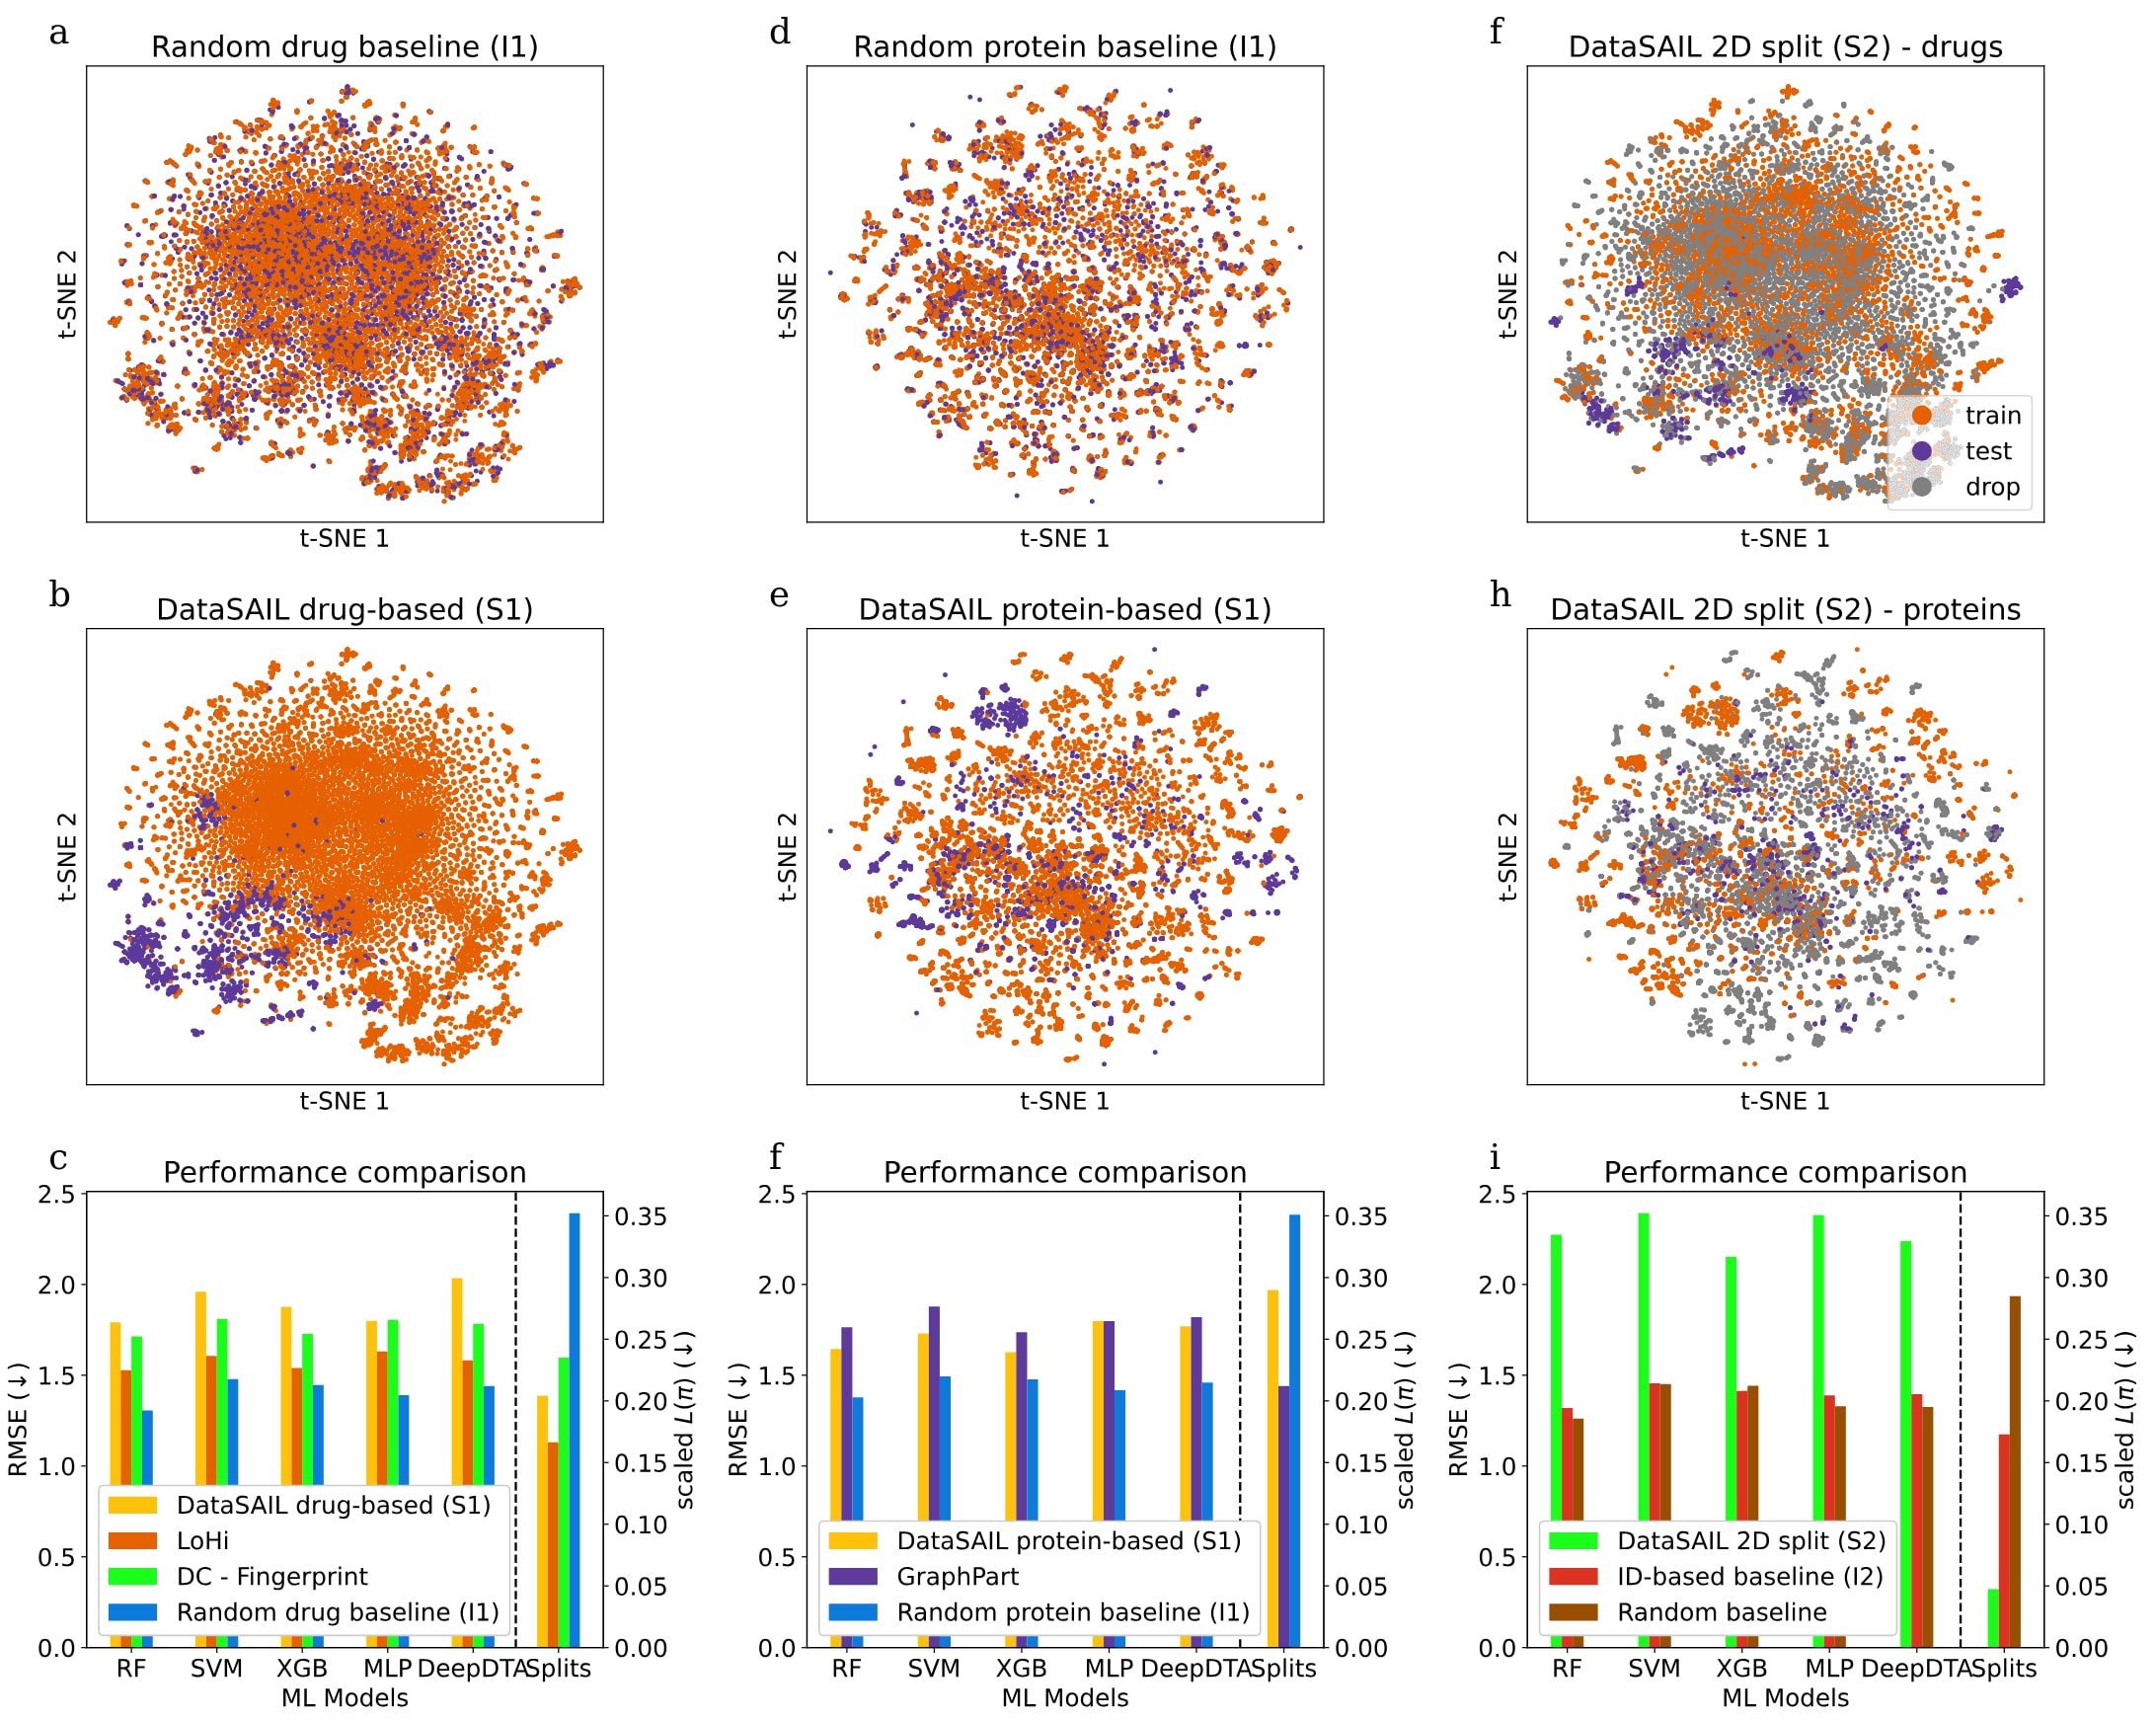
图4|二维数据集 LP-PDBBind a、d 展示随机划分(I1)的 t-SNE 嵌入结果,b、e 展示一维基于相似性的划分(S1),g、h 展示二维基于相似性的划分(S2)。其中,a、b、g 展示药物 ECFP4 指纹的 t-SNE 嵌入结果;d、e、h 展示蛋白质 ESM2-t12 嵌入的 t-SNE 可视化结果,灰色点表示在二维数据划分过程中必须舍弃的数据点。c、f、i 展示不同数据划分下的 ML 模型性能和信息泄漏程度,其中模型性能采用均方根误差(root mean squared error,RMSE;越低越好)进行评估。
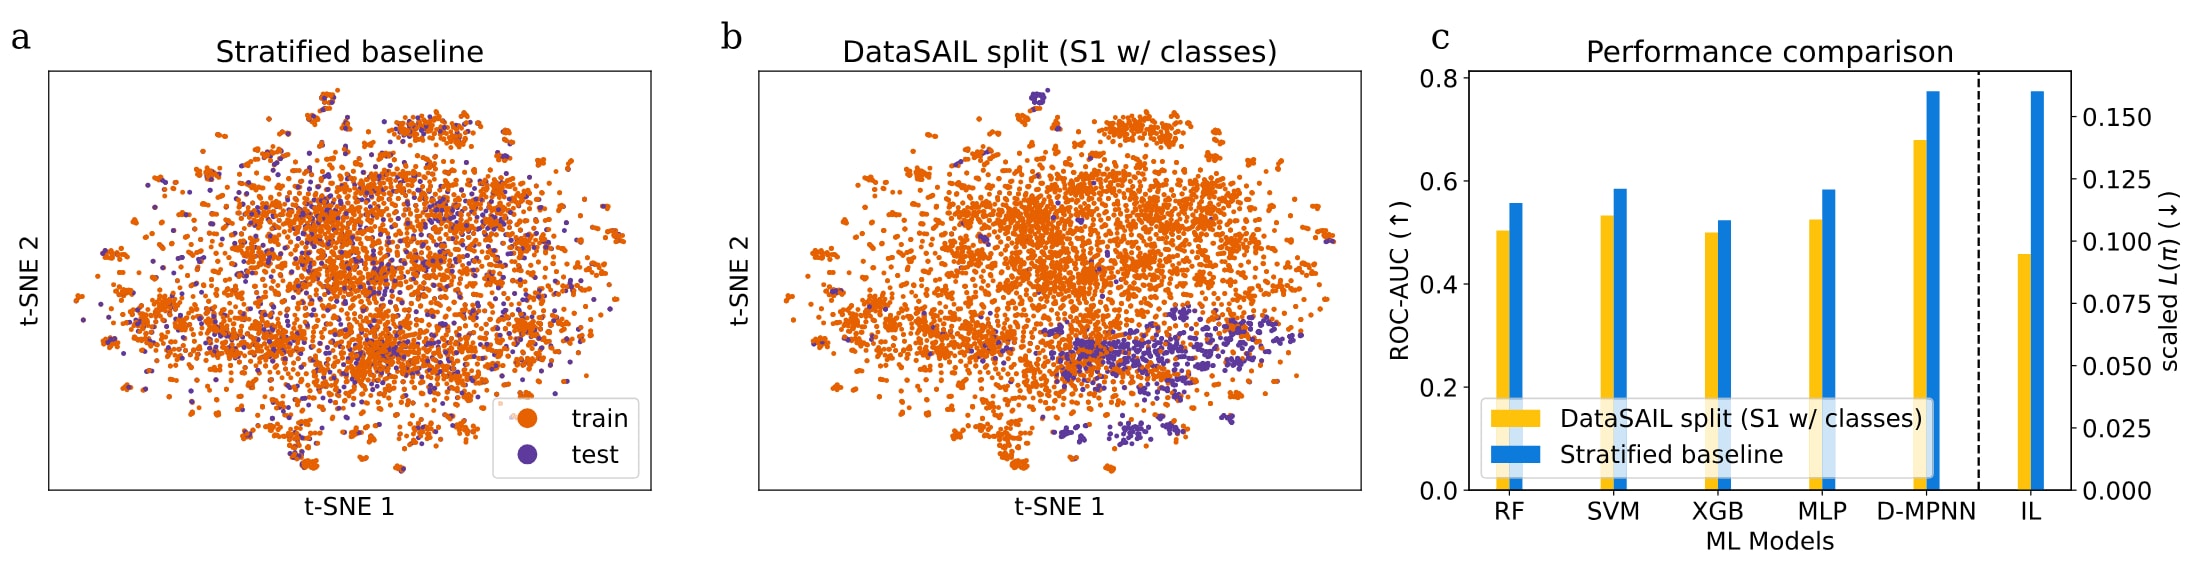
图5|结合分层策略的一维数据划分 采用 Tox21 中的 SR-ARE 靶标数据集,其中两个类别分别为活性和非活性小分子。a,随机分层划分的 t-SNE 嵌入结果;b,考虑样本相似性的分层划分结果;c,不同数据划分下的 ML 模型性能及信息泄漏程度。
3 讨论
相似性是一个经常被忽视的信息泄漏来源,尤其是在 ML 模型需要面对推理阶段数据分布发生偏移的场景中,这一问题尤为重要。该研究提出 DataSAIL,一套用于 ML 模型训练与测试数据划分的计算流程和工具,旨在最大限度减少由数据相似性引起的信息泄漏。与现有先进工具相比,DataSAIL 能够生成质量更高的分布外(OOD)数据划分。
作者首先对 DataSAIL 所对应的优化问题进行了形式化定义,证明该问题属于 NP-hard 问题,并提出了一种具有良好可扩展性的启发式求解策略。实证结果进一步表明,该方法能够在合理时间内生成高质量、低信息泄漏的数据划分,使 DataSAIL 成为一种适用范围广泛的数据划分工具。
DataSAIL 同时支持一维和二维数据,并可处理多种类型的生化数据,包括小分子、蛋白质序列、DNA 和 RNA 序列、基因组以及较长的 contig 序列。只要用户能够提供数据点之间的相似度或距离,该框架也可以较容易地扩展到其他类型的数据。
DataSAIL 当前实现仍存在一定局限。首先,虽然其理论框架适用于任意
[ R\leq2 ]
种实体类型。未来将进一步扩展 DataSAIL,使其能够处理任意维度的数据。
其次,在聚类步骤(图 2b)中,当前实现依赖谱聚类或凝聚层次聚类,尚不支持用户自定义聚类算法,而对于某些特定类型的数据,自定义聚类方法可能更加合适。
此外,尽管理论框架允许处理不同实体类型之间的相似性,但当前 DataSAIL 实现尚无法直接处理不同类型实体之间的相似性。
最后,对于二维数据,当前版本的 DataSAIL 在数据划分过程中可能会丢失部分特征向量–标签对。这种情况发生在一个特征向量所包含的两个基本数据点被分配到不同数据子集时。
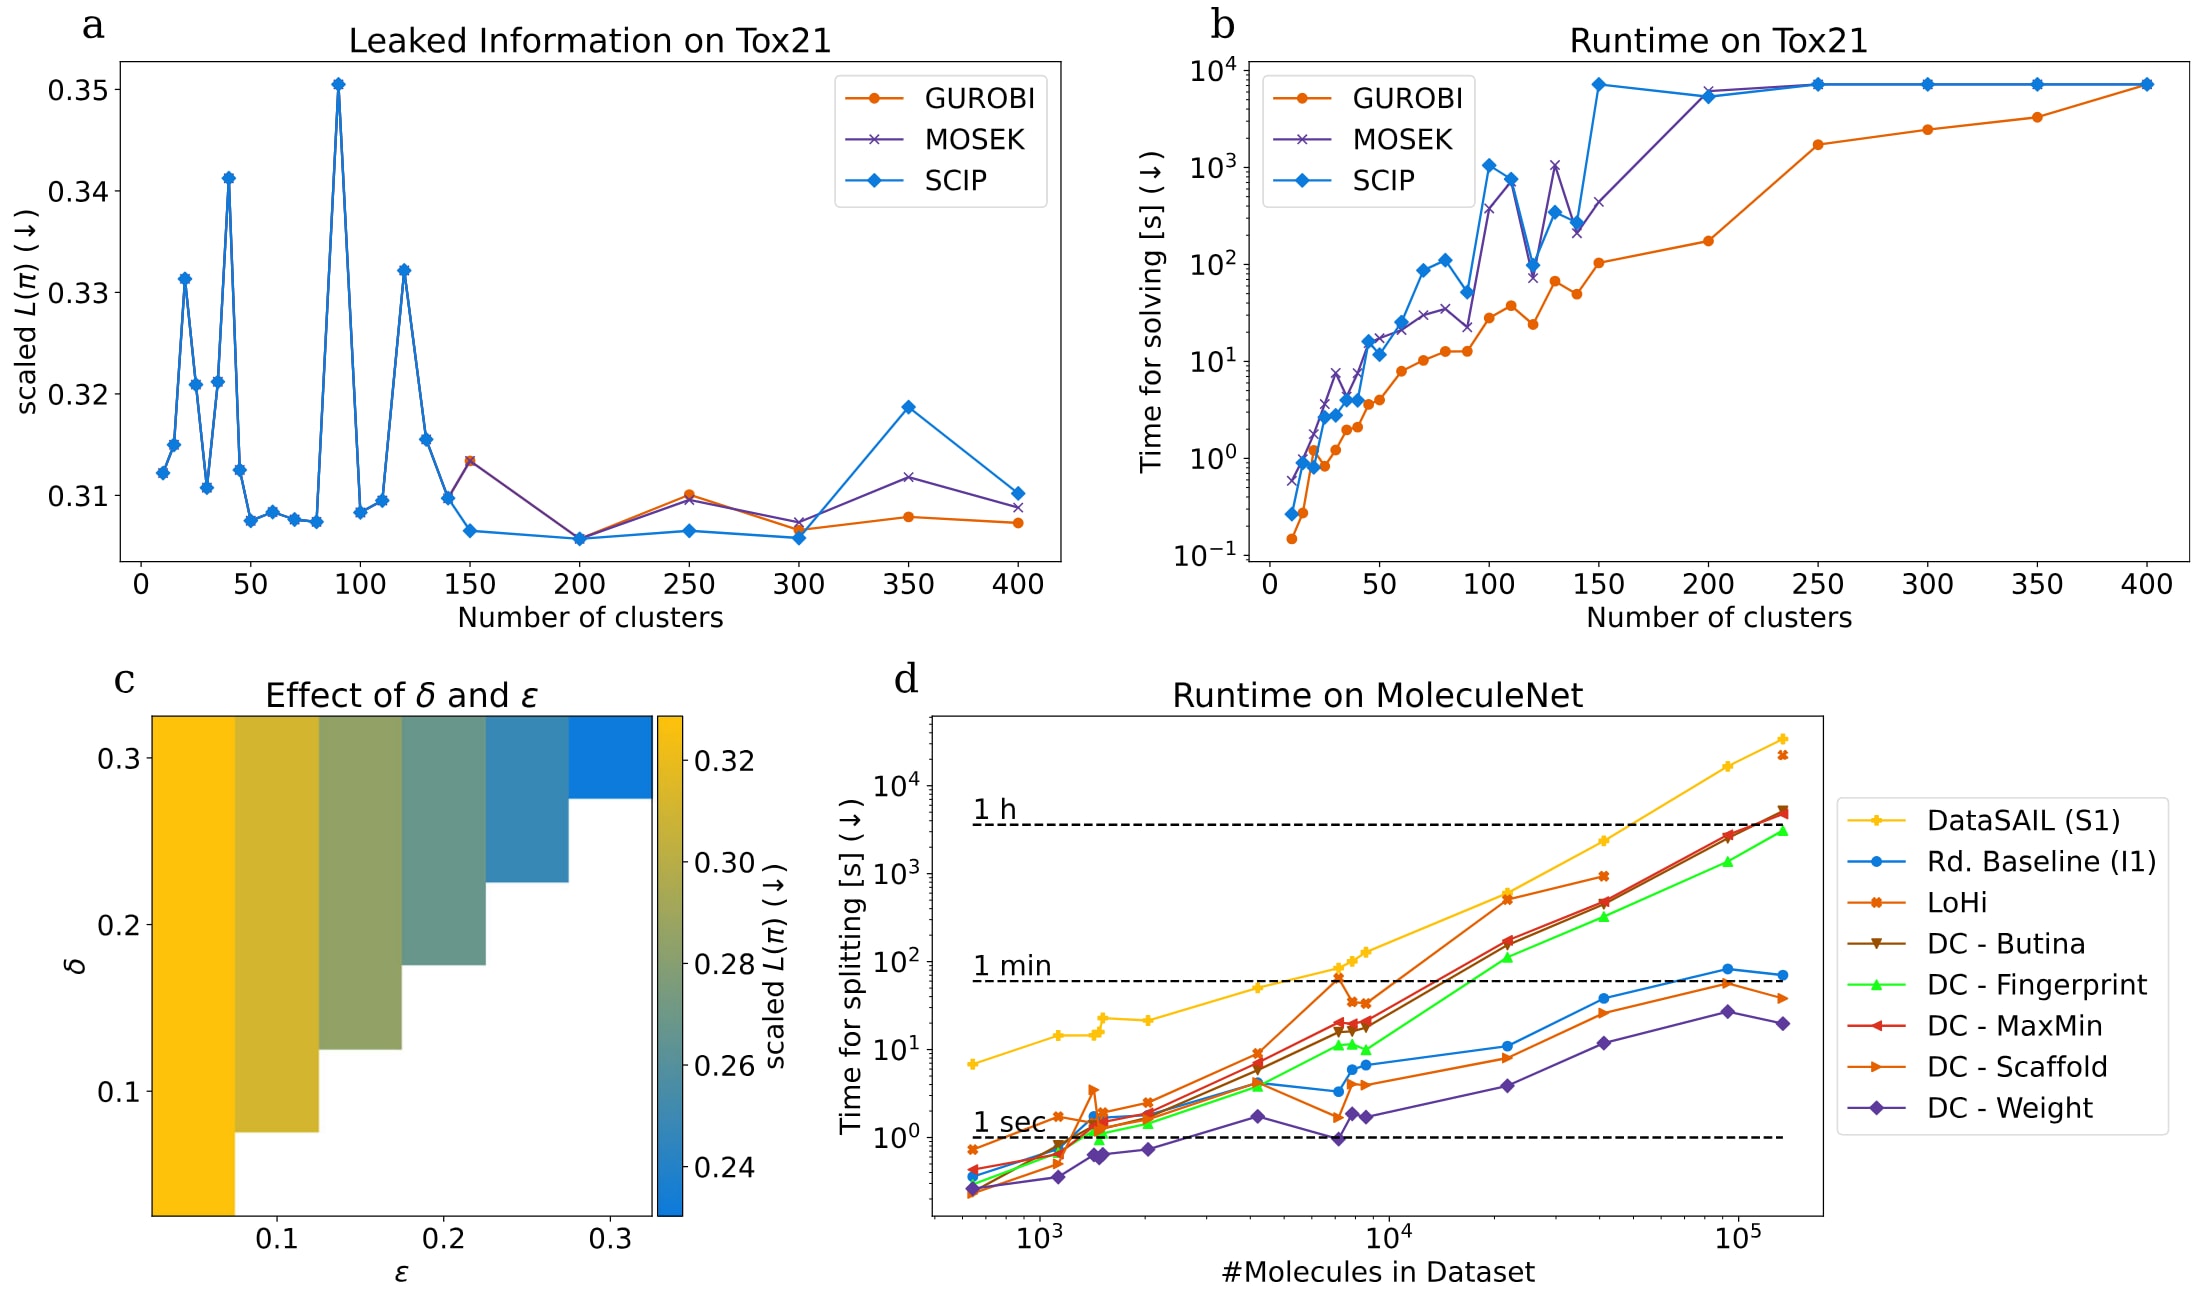
图6|消融实验与可扩展性基准测试 a,DataSAIL 数据划分质量随聚类数量
如果评估所使用的数据划分与模型预期的实际部署场景并不一致,也可能产生误导性的结果。尤其是,当推理阶段的数据预计会在用户所选择的相似性函数
因此,当使用 DataSAIL 为预期需要泛化到分布外(OOD)数据的 ML 模型构建评估数据集时,必须确保所选择的相似性函数
与此相关,所选择的相似性函数
在这种情况下,使用 DataSAIL 时必须加入式(4)中的分层约束,并根据响应变量定义类别