JACS 2026|FragNet:一种具有四级可解释性的分子性质预测图神经网络
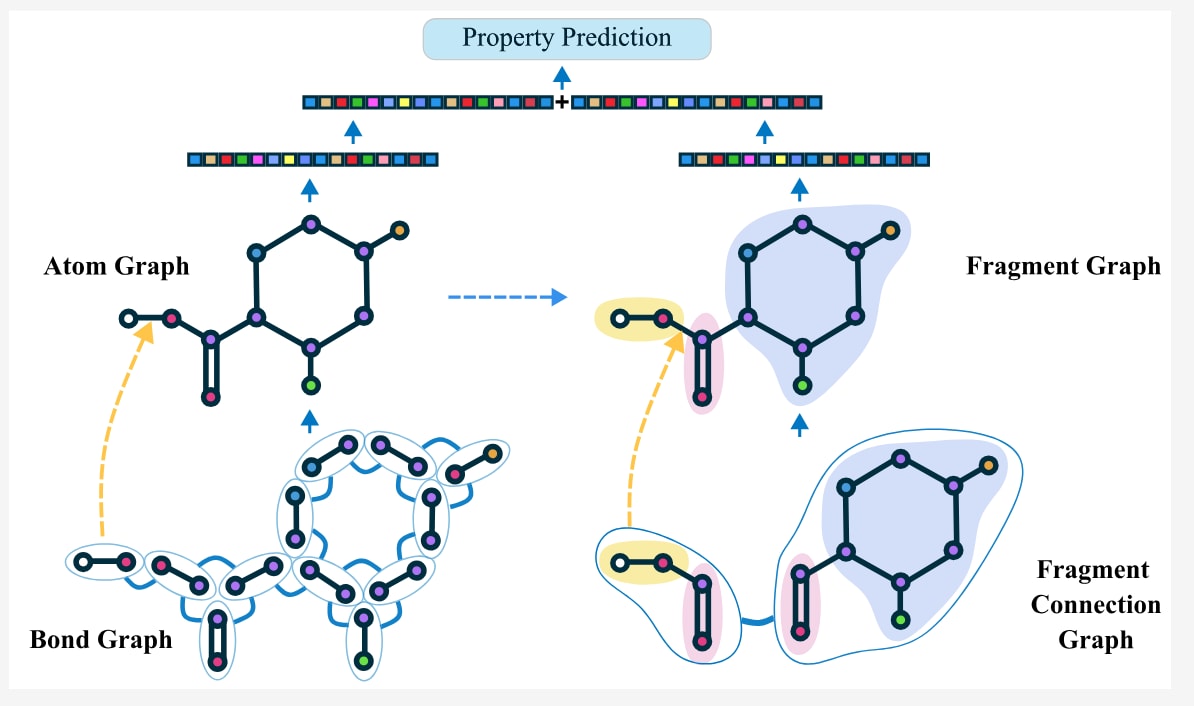
分子性质预测是药物发现、材料设计和化学研究中的核心任务,但现有模型往往难以同时兼顾预测精度与可解释性。FragNet 提出了一种具有多层级可解释能力的图神经网络框架,可同时从原子、化学键、分子片段及片段连接四个层面解析模型决策。与传统 GNN 不同,FragNet 还能显式建模非共价连接片段之间的相互作用,因此更适用于盐类、离子液体和分子复合体系。研究表明,FragNet 在 MoleculeNet 多项任务上获得了具有竞争力的预测性能,并可通过注意力权重与贡献值识别影响溶解度、亲脂性和药物响应的关键结构单元。该框架不仅提升了分子性质预测的透明度,也为基于片段的理性分子设计与结构–性质关系分析提供了新的工具。
获取详情及资源:
0 摘要
分子性质预测在药物开发、储能材料设计等众多现代科学领域中具有重要意义。尽管目前已有大量机器学习模型可用于分子性质预测,但能够同时兼顾高预测精度与良好可解释性的模型仍较为少见。该研究提出了一种图神经网络,其预测精度可与当前领先模型相媲美,同时能够从四个层级对分子子结构进行解释。该模型可识别哪些原子、化学键、分子片段以及片段之间的连接对特定分子性质的预测具有重要贡献。
其中,对片段间连接重要性的解析尤具价值,特别适用于包含无法通过常规化学键直接连接的子结构的分子。此外,该模型还能够量化特定片段对预测结果的影响,从而识别可能提升或降低目标性质数值的分子片段。这些可解释性特征有助于揭示模型学习到的分子结构与性质之间的内在关联,并从中获得具有科学意义的结构–性质关系认识。
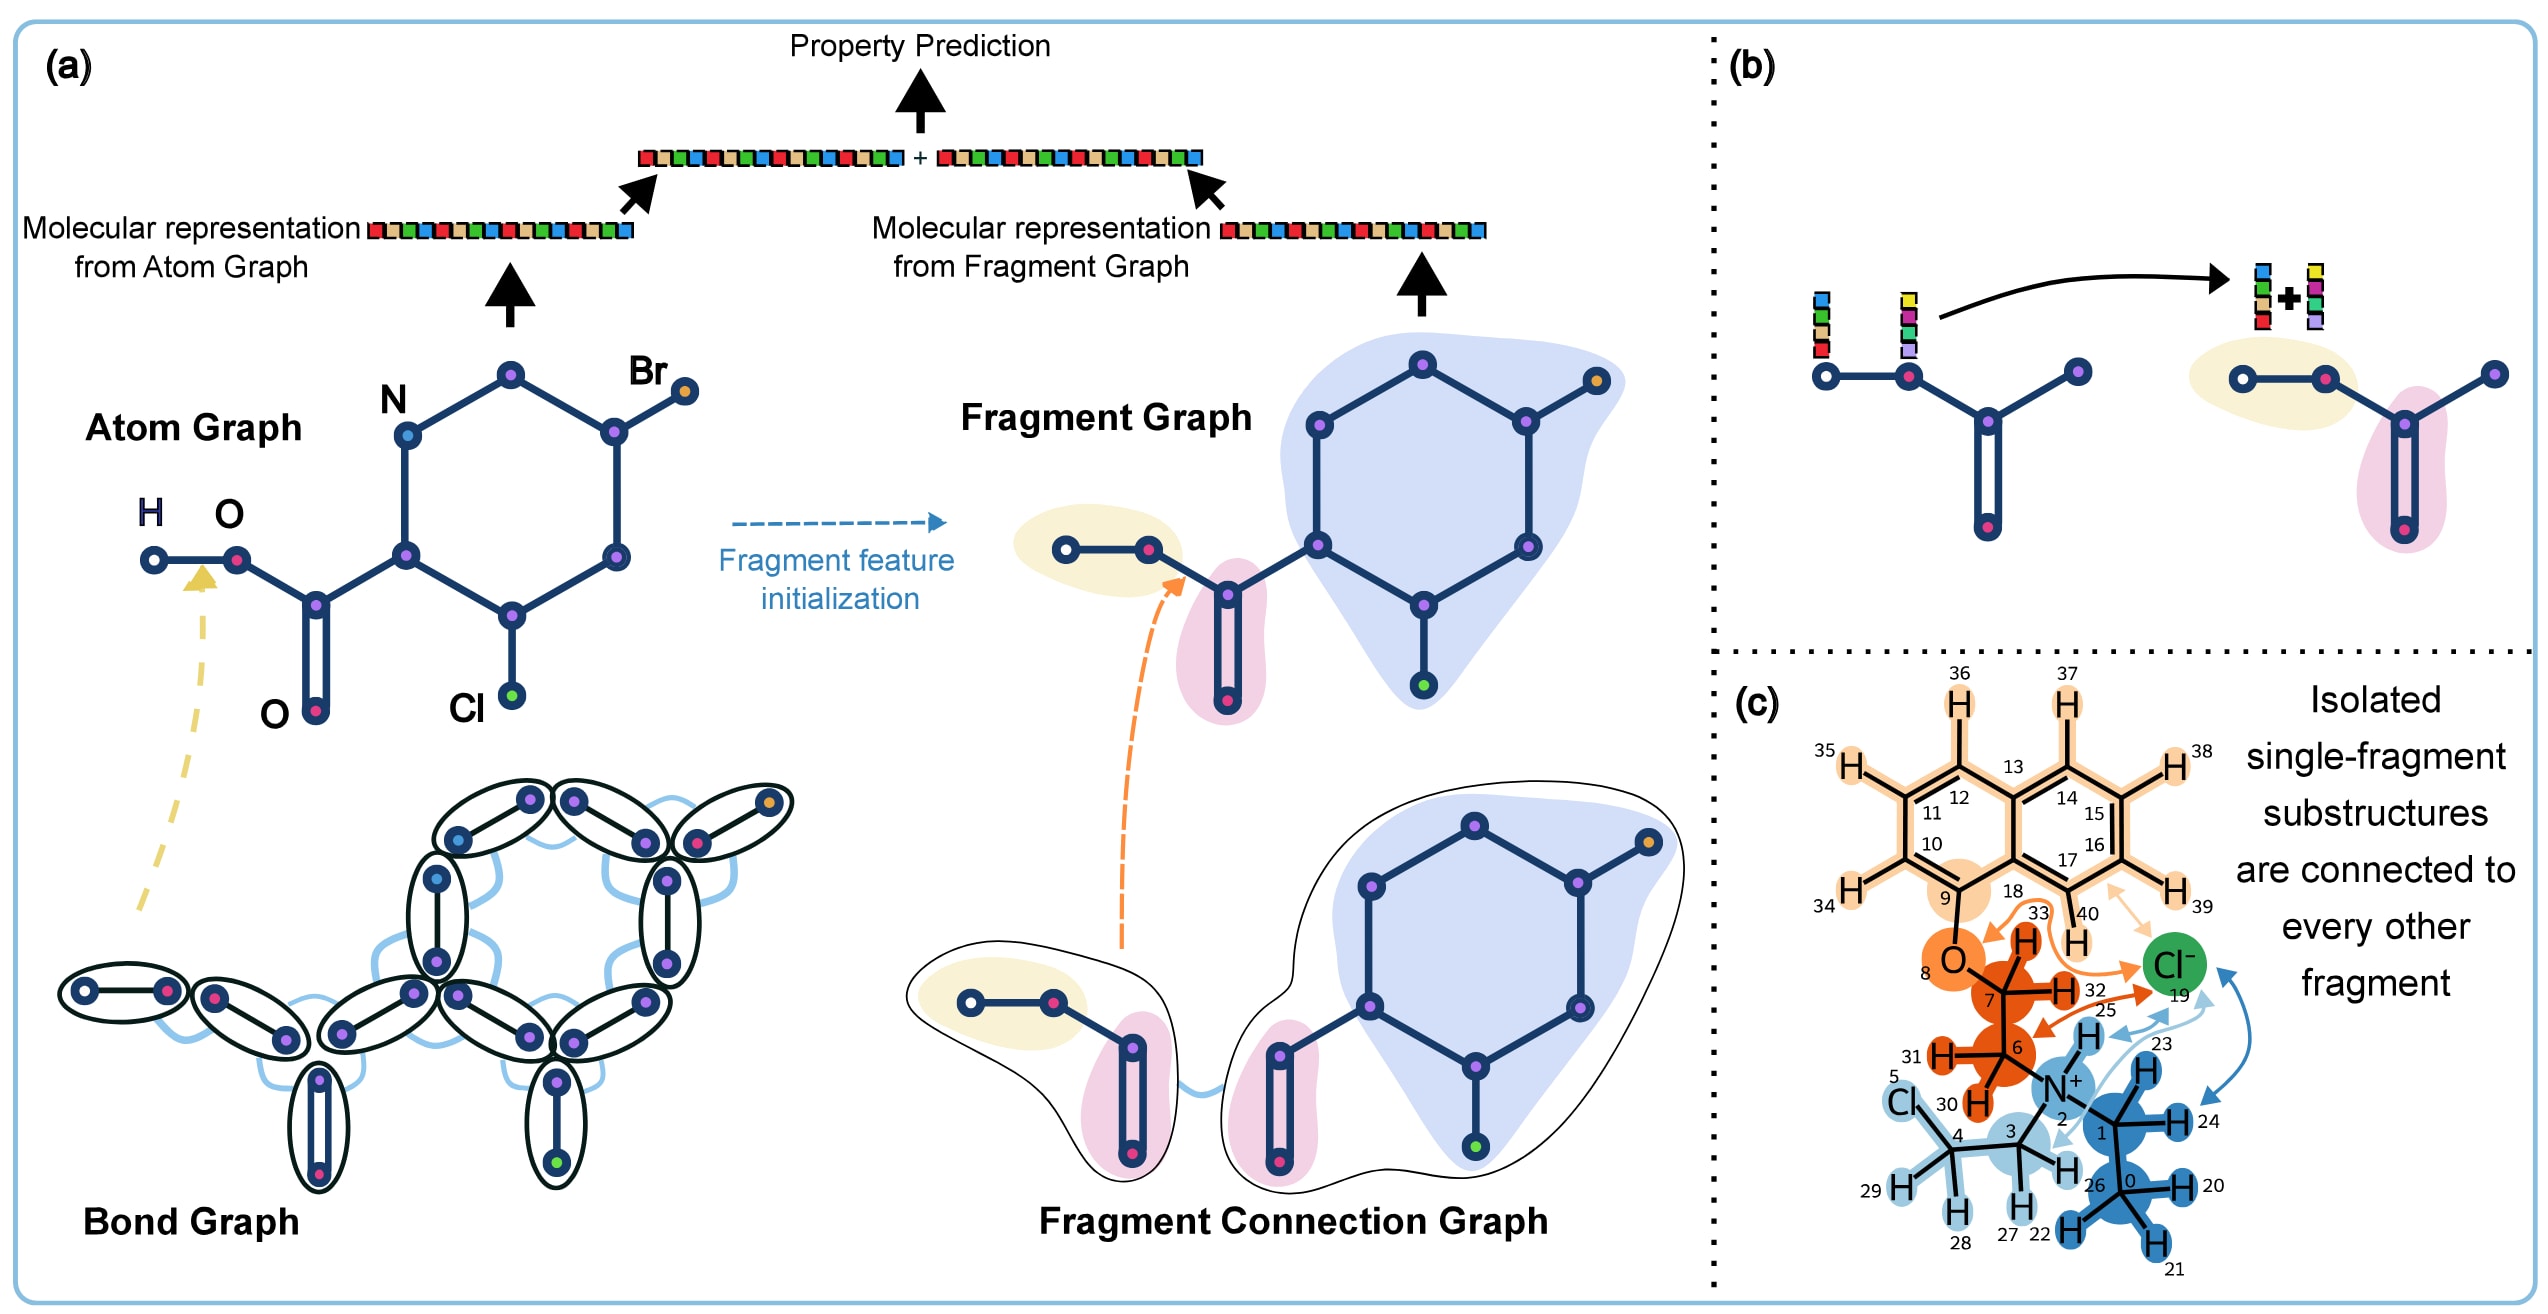
图1|FragNet 的模型架构与数据表示。 a,原子图和片段图的边特征分别通过化学键图和片段连接图进行学习。b,片段图中的初始片段特征由构成该片段的更新后原子特征求和得到。c,FragNet 在两个非共价键连接的子结构之间进行消息传递的示意图。对于化合物中每个由非共价作用连接的结构,其相邻片段之间同样建立片段–片段连接。
1 引言
分子性质预测是现代材料发现与设计中的关键环节,广泛应用于药物设计、储能材料开发、催化剂研究以及农用化学品等领域。尽管目前已有大量机器学习模型可用于此类任务,但高预测精度与良好可解释性之间往往存在权衡,而后者对于获得科学认识尤为重要。对于分子性质预测而言,模型可解释性能够帮助研究人员理解驱动预测结果的潜在因素。这种理解有助于提出新的科学假设、发现具有目标性质的新型材料,并加速分子设计过程。此外,可解释性还有助于认识模型的优势与局限,从而进一步改进模型。基于这些优势,可解释人工智能(Explainable Artificial Intelligence,XAI)近年来受到广泛关注,其核心目标是深入揭示模型产生预测结果的过程。
在相关文献中,“可解释性(interpretability)”与“可说明性(explainability)”通常被交替用于描述可解释人工智能。Brian 和 Cotton 将模型的可解释性定义为“观察者能够理解某项决策原因的程度”。**Nigam Shah 则将可解释性划分为三类:工程师可解释性、因果可解释性以及信任诱导型可解释性。**工程师可解释性侧重于理解 AI 模型如何获得输出结果,或模型内部如何运行;因果可解释性关注 AI 模型为何作出特定决策或预测;信任诱导型可解释性则强调增强用户对模型预测结果的信心。从本质上讲,一个具有可解释性或可说明性的模型,应能够使用户在一定程度上理解其内在的决策过程。
可解释模型可以按照多种方式进行分类。其中一种常见分类方法,是依据可解释机制是否直接整合进模型预测算法,将模型划分为内生可解释模型和外生可解释模型,即事后解释模型。外生可解释方法的一项重要优势在于,其能够应用于任意复杂模型,而不受具体模型架构限制。这类方法无需改变黑箱模型本身,即可分析其行为,因此尤其适用于复杂算法的验证以及提升用户对模型输出的信任。**SHAP(SHapley Additive exPlanations)和 LIME(Local Interpretable Model-agnostic Explanations)等解释方法已被广泛用于传统机器学习模型,通过为输入特征赋予重要性分数来解释预测结果。**SHAP 基于合作博弈论中的 Shapley 值计算各特征对预测结果的贡献,而 LIME 则在特定预测样本附近利用一个可解释的代理模型近似原模型的局部行为。
尽管这些方法在常规表格数据和图像数据中表现突出,但在基于图表示的分子数据中仍面临较大挑战。分子通常表示为由相互连接的原子和化学键构成的图结构,因此 SHAP 和 LIME 难以充分捕捉分子性质所特有的层级关系和复杂相互作用。相比之下,在对透明性和简洁性要求较高的领域,内生可解释模型通常更具优势。这类模型本身更容易理解和解释,其透明的决策过程在医疗、金融等关键应用领域尤其具有吸引力,因为这些场景要求用户能够直接理解并信任模型的决策。
目前,研究人员已基于多种分子表示形式开发内生可解释模型,包括 SMILES 字符串、分子指纹以及分子描述符等,不同表示方式对应不同的粒度与可解释能力。**然而,基于 SMILES token 的特征重要性或注意力权重通常难以全面反映具体分子结构单元的重要性,或者其结果本身不易进行化学解释。**此外,要为 SMILES 编码、分子描述符等不同分子表示构建统一的可解释机制也较为困难。
从结构本质来看,分子天然具有图结构特征,其中原子对应节点,化学键对应边。因此,图神经网络(Graph Neural Network,GNN)是表示分子的自然选择,能够有效捕捉分子内部的空间关系和连接模式。此前关于可解释 GNN 的研究已取得一系列重要进展,例如通过模型突出关键子结构,或生成注意力图以指示分子的哪些区域对预测贡献最大。AttentiveFP 和 MoGAT 能够提供原子层级的重要性评分;Wu 等则开发了片段层级的注意力机制,并将其可解释性验证扩展至 ESOL、Mutagenicity、hERG 和 BBBP 等多个数据集。在此基础上,FragNet 在统一的层级框架中进一步提供四个相互补充层级的可解释性,并采用骨架划分(scaffold splitting)在六个不同的 MoleculeNet 任务上进行了评估。
活性悬崖(activity cliffs)是评估 GNN 解释方法时尤具挑战性的场景之一,即结构高度相似的分子却表现出显著不同的生物活性。活性悬崖构成了对模型可解释能力的一项基础性检验,因为准确的解释必须能够识别导致性质显著变化的细微结构差异。近年来,针对这一问题已提出多种提高解释质量的方法,包括通过修改 GNN 架构获得更准确解释的 GNN Explanation Supervision(GNES)框架、引入子结构感知损失函数的方法,以及专门面向活性悬崖解释的 ACES GNN 方法。这些进展进一步表明,可解释模型需要能够可靠揭示结构–活性关系,尤其是在微小结构修饰即可引起显著性质变化的场景中。
尽管已有上述进展,当前方法仍存在明显局限。现有 GNN 模型通常未考虑不通过共价键相连的分子子结构之间的相互作用,例如盐类和配合物中的不同组成部分,而这类化合物在能源材料和药物领域均具有重要意义。此外,据作者所知,目前尚不存在能够在同一框架下同时从原子、化学键和分子片段层级进行解释的 GNN 模型,大多数方法仅聚焦于原子或分子片段。
针对这些问题,该研究提出了一种新的图神经网络架构 FragNet。FragNet 不仅能够获得与当前先进模型相当的预测精度,还能够从四个分子子结构层级进行解释,包括原子、化学键、分子片段以及片段之间的连接。其中,“片段”是指分子中的独立子结构,由一组原子及连接这些原子的共价键构成。FragNet 为不同类型的子结构分别构建图表示,从而能够识别在特定分子性质预测中起关键作用的原子、化学键、分子片段以及片段之间的连接。
通过构建基于片段的图,FragNet 可以在不通过共价键直接连接的片段之间进行消息传递。据作者所知,FragNet 是首个能够在统一框架下同时关注上述全部子结构层级的模型。此外,该方法还实现了一种定量评估分子片段对预测结果贡献的方法。结果表明,模型获得的注意力值和贡献值与已有化学认识具有良好一致性,从而增强了对模型预测过程的可信度。
通过显式建模片段之间的连接关系,FragNet 能够更完整地表示盐类、配合物等包含非普通共价键连接子结构的分子。该研究进一步通过多个分子性质预测任务的案例分析展示了模型多层级可解释机制的实用性,并利用模型的注意力权重和贡献值研究其决策过程。相关分析同时覆盖单个分子和聚合数据,从而能够识别驱动性质变化的关键分子子结构。
为进一步验证模型推理过程,该研究还开展了对比分析,将 FragNet 的片段贡献评分与基于密度泛函理论(Density Functional Theory,DFT)计算得到的静电表面势进行关联。最后,作者还发布了一个交互式浏览器应用,使上述可解释性方法能够更加便捷地应用于其他分子性质预测研究。对于不熟悉文中相关分子化学概念的读者,补充信息中还提供了简要介绍。
2 方法
2.1 模型
FragNet 基于消息传递图神经网络架构,通过四种不同的分子图表示对分子结构进行建模。模型所采用的图表示概览如图1所示。FragNet 的数据表示由四种图结构组成:原子图、化学键图、片段图以及片段连接图。
在原子图中,节点和边分别表示原子和共价键。在化学键图中,节点表示化学键,当两条化学键共享同一个原子时,在对应节点之间建立一条边。片段图则通过特定的分子碎片化策略,将分子拆分为若干子结构后构建。如果分子不是盐或配合物,则片段图中的边对应于片段拆分位置处的化学键。
该研究采用 BRICS 碎片化方法。BRICS 是一种基于规则的分子碎片化算法,根据逆合成分析得到的 16 类化学环境规则,在具有合成可及性的化学键处对分子进行切分。该算法识别能够通过常见合成反应重新连接的关键化学键,因此尤其适用于基于片段的分子设计和虚拟筛选。BRICS 通过识别特定的化学键环境,例如邻近杂原子的 C−C 键以及酰胺中的 N−C 键,并在这些位置进行切分,从而生成在结构上保持完整且具有明确化学意义的分子片段。
BRICS 碎片化具有较好的化学可解释性和计算效率,但也存在一定局限。由于其本质上依赖预定义规则,一些未匹配既定模式但实际合理的切分位点可能被遗漏。此外,对于高度官能团化的分子,BRICS 可能产生过度碎片化,或者生成尺寸差异较大的片段,进而导致片段分布不均衡。对于复杂天然产物或高度受限的环状体系,BRICS 也可能无法完整捕捉所有相关子结构特征。
FragNet 框架同样可以采用其他碎片化策略。例如,RECAP 使用较少的 11 条规则,通常生成尺寸更大的片段;Murcko 骨架则聚焦于分子的核心环系和连接基团,提供粒度更粗的分解方式。碎片化策略的选择可根据具体任务确定。例如,在分析核心结构–活性关系时,基于骨架的方法可能更加合适,而在建模可通过合成方式重新组合的分子片段时,BRICS 更具优势。FragNet 的模块化设计允许方便地替换不同的碎片化算法,从而使用户能够根据具体应用场景选择最合适的策略。
对于分子配合物,其中部分片段之间不存在常规共价键,FragNet 通过构建“虚拟”连接,使原本彼此分离的子结构之间能够进行消息传递。具体而言,模型会在由 BRICS 片段关联的片段之间建立虚拟连接。这些虚拟连接可以表示范德华力、氢键和静电相互作用等非共价相互作用。尽管这些相互作用不像共价键那样稳定持久,但在分子建模中同样具有实际意义和重要性。
如果一个分子无法进一步分解为片段,则将整个分子视为一个片段,并为其建立自连接。对于由多个彼此之间不存在共价键连接的子结构组成的分子,则将其中一个子结构中的每个片段与另一个子结构中的每个片段建立虚拟连接。
片段连接图将片段之间的连接表示为节点;当两个连接共享同一个片段时,在对应节点之间建立边。根据分子类型,这些片段连接可以对应常规化学键,也可以是虚拟连接。片段连接图的一项重要优势,是能够分析分子不同子结构之间的相互作用,尤其适用于两个子结构之间不存在常规共价键连接的情况。
虽然图 Transformer 架构理论上也能够通过注意力机制处理相互分离的子图,但 FragNet 的方法具有若干明显优势。首先,图 Transformer 通常生成稠密注意力矩阵,即每个节点都会关注所有其他节点,因此较难从中提取具有明确化学意义的特定相互作用。相比之下,FragNet 的片段连接图将片段间关系显式表示为边,并为这些边赋予可解释的注意力权重,因此能够直接展示哪些片段对之间具有更强的相互作用。其次,FragNet 中的虚拟连接依据化学原理有针对性地构建,例如片段空间邻近关系和离子对等,因此具有明确的化学基础;相比之下,图 Transformer 中不受约束的注意力机制缺乏这种直接的化学约束。
FragNet 在上述多种图表示之间采用层级化建模策略,即利用较低层级结构学习得到的表示,初始化后续更高层级图结构中的特征。模型首先从化学键图构建给定分子的表示。化学键图中的节点最初由化学键属性进行特征化,而边则利用键角进行特征化。所考虑的化学键属性包括键类型(单键、双键、三键和芳香键)、是否为共轭键、是否位于环中以及化学键的立体化学信息。
化学键图中的节点表示通过图注意力机制进行更新。化学键图第
[ h_{i,l}^{\mathrm{bond\ graph}} = \sum_{j\in N(i)} \alpha_{ij}^{\mathrm{bond\ graph}} W h_{j,l-1}^{\mathrm{bond\ graph}} ]
其中,
[ \alpha_{ij}^{\mathrm{bond\ graph}} = \frac{ \exp\left(\mathrm{LeakyReLU}(M_{ij})\right) }{ \sum_{k\in N(i)} \exp\left(\mathrm{LeakyReLU}(M_{ik})\right) } ]
其中,
[ M_{ij} = a^\mathrm{T} \left[ W h_i^{\mathrm{bond\ graph}} \Vert W h_j^{\mathrm{bond\ graph}} \Vert W_e e_{i,j} \right] ]
这里,
由于在化学键图中加入自连接会显著增加计算开销,因此模型不考虑自连接,
原子图的初始节点特征包括原子序数、隐式价态、形式电荷、自由基电子数、杂化类型、是否为芳香原子、是否位于环中、氢原子总数以及手性信息。与化学键图不同,原子图中的消息传递考虑自连接,即原子与自身之间的边。自连接的边特征初始化为与
[ h_{i,l}^{\mathrm{atom\ graph}} = \sum_{j\in N(i)} \alpha_{ij}^{\mathrm{atom\ graph}} W h_{j,l-1}^{\mathrm{atom\ graph}} ]
完成更新后,通过对原子图中所有原子特征向量求和,构建分子层级表示。
片段图按照类似方式进行更新。对于片段图的初始节点特征,将构成该片段的所有原子在原子图中得到的特征向量求和:
[ h_{i,l}^{\mathrm{fragment\ graph}} = \sum_{j\in A(i)} h_{j,l-1}^{\mathrm{atom\ graph}} ]
其中,
在对片段图执行图注意力计算之前,其边特征由片段连接图学习得到的节点特征进行初始化。基于更新后的片段图,可以进一步构建第二个分子层级表示。
最终的分子表示由原子图得到的分子表示与片段图得到的分子表示拼接而成。该表示随后可用于分子性质预测等下游任务。有关数据集和模型训练方法的更多细节见补充信息。
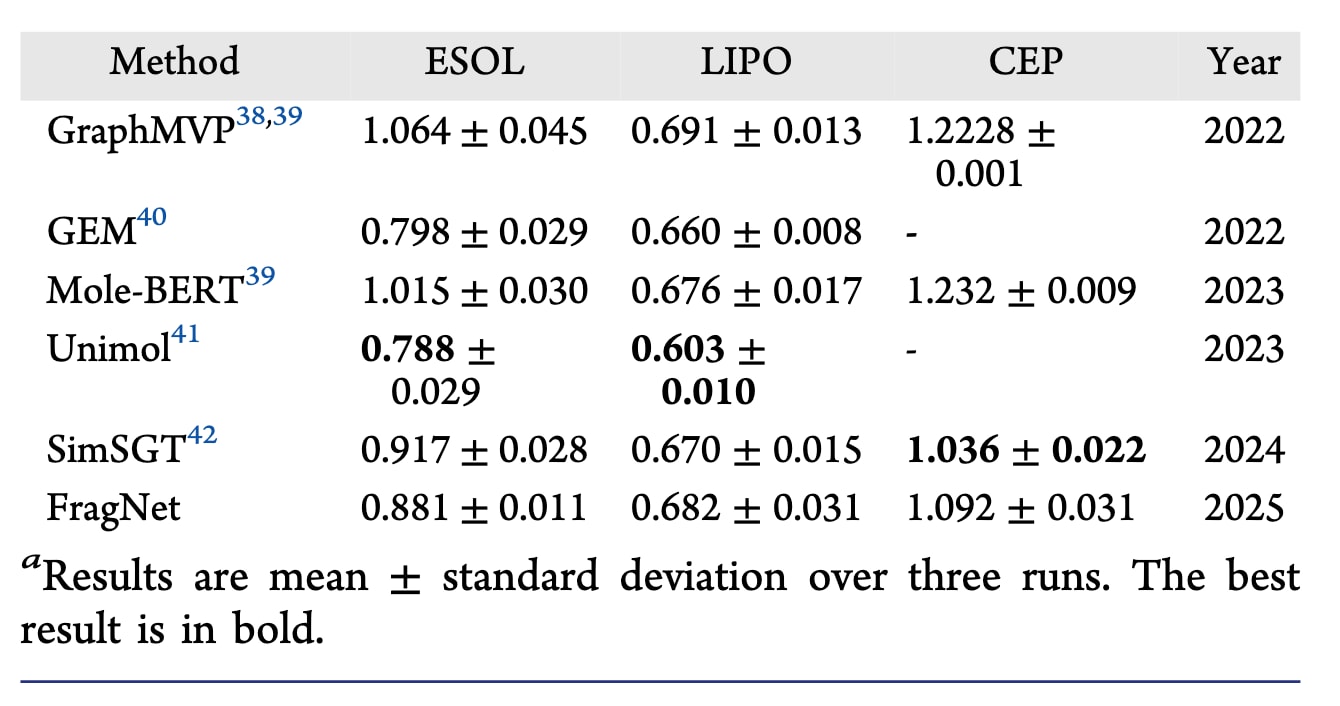
表1|MoleculeNet 回归任务上的模型性能,以 RMSE 衡量(数值越低越好)
3 结果
3.1 预测准确性
该研究在 MoleculeNet 基准中的多个分子性质预测任务上评估了 FragNet 的性能,包括 3 个回归任务和 3 个分类任务,涵盖化学、生物学和毒性等多种性质。在进行分子性质预测训练之前,模型首先通过补充信息中描述的一系列自监督任务进行预训练。
表1和表2给出了采用骨架划分(scaffold splitting)得到的 FragNet 预测结果。对于每个数据集,首先使用 3 个不同的随机种子,并根据验证集上的预测性能优化 FragNet 的超参数。随后,采用优化后的超参数和相同的 3 个随机种子对 FragNet 进行微调,并在表1和表2中报告测试集预测性能的均值和标准差。
该研究进一步将 FragNet 与近期具有代表性的先进基线方法进行了比较。结果表明,FragNet 在所有评估任务中均表现出具有竞争力的预测性能,与当前先进模型之间的差距保持在合理范围内;同时,在大多数基准任务上,FragNet 的性能优于 GraphMVP、Mole-BERT、MolFM 和 ReLMole 等多种已有方法。
表2|MoleculeNet 分类任务上的模型性能,以 AUC-ROC(%)衡量(数值越高越好)
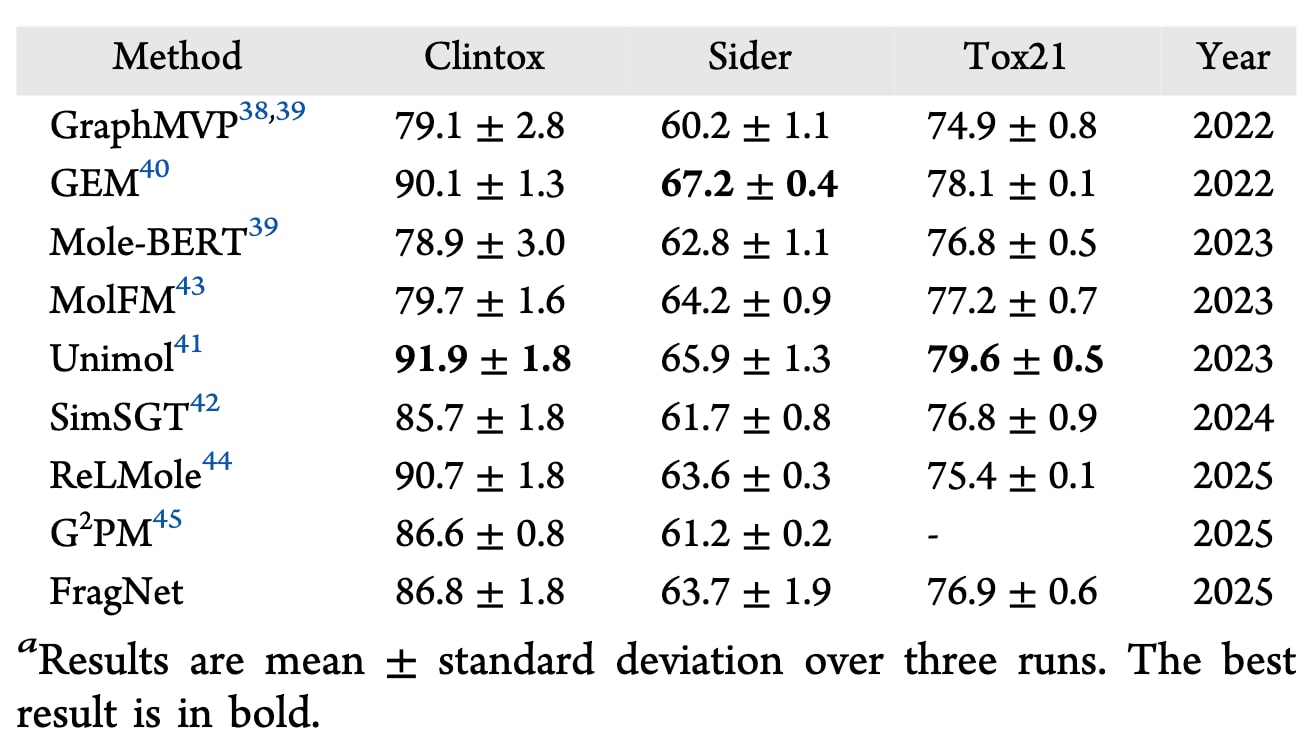
不过,对 FragNet 的性能评估需要结合其核心设计理念加以理解,即在保证预测性能的同时,优先实现模型可解释性的深度整合。尽管部分方法获得了更高的预测精度,例如 GEM 和 Uni-Mol 在回归任务中表现更优,Uni-Mol 在分类任务中也取得了更高性能,但 FragNet 的主要贡献在于证明:全面的多层级可解释性与具有竞争力的预测性能并非相互排斥。
在分子设计和药物发现等实际应用中,理解模型为何作出特定预测,往往比预测精度的有限提升更具价值。与单纯追求预测性能的先进模型不同,FragNet 提供了独特的可解释能力。这样的透明性能够支持合理的分子优化、促进科学假设的提出,并揭示黑箱模型难以提供的潜在机制信息。这些能力对于深化化学结构–性质关系的认识,以及加速实际应用中的分子设计循环具有重要意义。
此外,FragNet 与预测性能最高的基线模型之间还存在一个重要的实际差异,即预训练数据规模。Uni-Mol 和 GEM 分别使用约 2.09 亿和 2000 万个分子进行预训练,而 FragNet 仅使用了 200 万个分子。由于 FragNet 需要同时处理四种不同的图结构,在当前硬件条件下,将训练规模扩展至数百万乃至更大的分子数据集会带来显著的计算挑战。尽管预训练数据规模远小于上述模型,FragNet 仍取得了具有竞争力的预测性能,这表明其模型架构能够较为高效地学习与分子性质预测相关的分子表示。
3.2 可解释性
FragNet 的主要优势在于能够基于四类不同的分子子结构对预测结果进行解释。其独特之处在于,还能够分析包含非共价连接组分的分子,例如盐类和配合物。FragNet 主要通过两种机制实现这种细粒度解释:注意力权重(attention weights)和贡献值(contribution values)。
注意力权重来源于四种图表示各自对应的图注意力机制,可用于揭示模型在预测过程中重点关注的分子子结构。这些权重反映了模型在推理过程中赋予不同子结构的相对重要性,包括原子、化学键、分子片段以及片段之间的连接。较高的注意力权重意味着相应子结构对模型决策具有更显著的影响,可以视为模型计算过程中重点关注的结构区域。
不过,注意力权重也存在一定局限。由于其取值非负且不具有方向性,因此只能反映某一子结构的重要程度,却无法说明其对目标性质究竟产生正向还是负向影响。尽管如此,注意力权重仍非常适合用于识别关键结构特征、理解模型行为,并定位在分子设计过程中值得重点关注的分子区域。
相比之下,贡献值能够定量且有方向地描述各子结构对预测性质的具体影响。该指标旨在回答这样一个问题:“如果移除这一片段,模型预测的分子性质会发生怎样的变化?”如图2所示,其计算过程包括两个步骤:首先,对完整分子进行性质预测;随后,通过在预测过程中排除目标子结构对应的节点特征,对该子结构进行掩蔽,并再次进行预测。
如果掩蔽某一子结构后,预测的性质值低于完整分子的预测值,则该子结构被认为具有提升性质的作用。相反,如果掩蔽后预测值升高,则该子结构被认为具有降低性质的作用。其形式化定义为:
[ \mathrm{Contribution} = \mathrm{Property}{\mathrm{unmasked}} - \mathrm{Property}{\mathrm{masked}} ]
贡献值因此能够明确反映子结构作用的方向。正贡献值表明该子结构能够提高模型预测的性质,例如增强溶解度;负贡献值则表明该子结构会降低目标性质,例如降低生物活性。因此,贡献值尤其适用于基于片段的分子设计以及结构–活性关系(structure–activity relationship,SAR)分析。
注意力权重与贡献值提供了相互补充的两类解释视角。前者用于识别模型预测过程中哪些子结构最为重要,后者则进一步量化这些子结构对最终性质预测结果的具体影响。将二者结合,可以更全面地理解模型的决策过程,并为更加精准的分子设计提供依据。
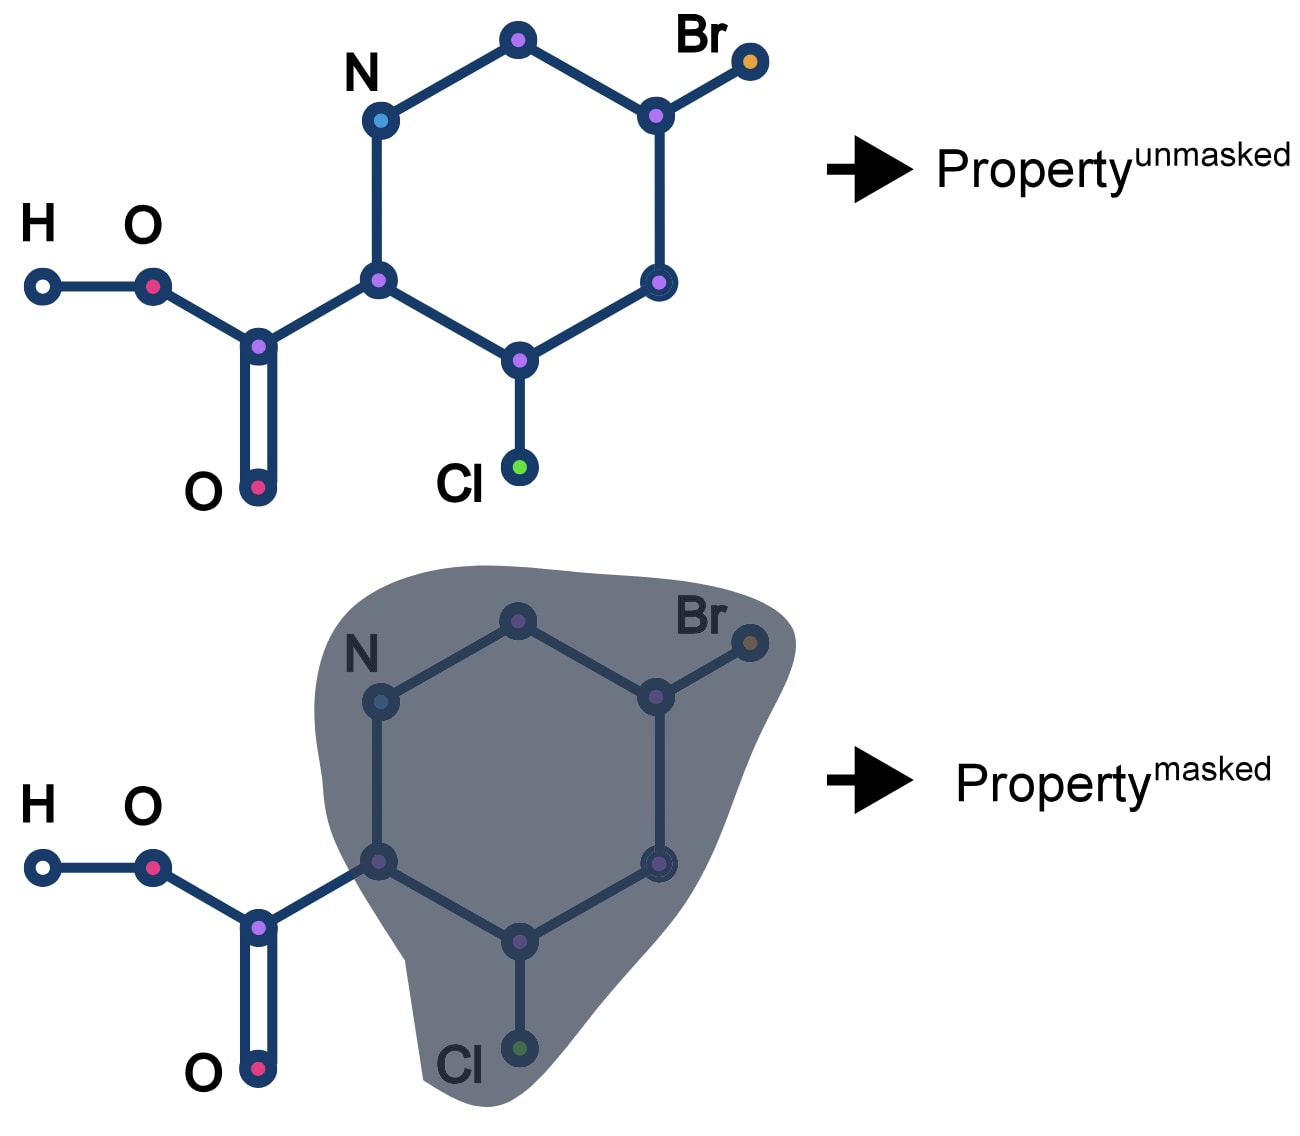
图2|贡献值计算过程示意图
3.3 注意力权重与贡献值之间的关系
需要指出的是,较高的注意力权重并不一定对应较大的贡献值。这种表面上的不一致主要源于分子体系本身的复杂性及其高度依赖结构环境的特征。某一片段可能由于在定义整体分子环境或介导片段间相互作用方面发挥关键作用,而获得较高的注意力权重;但如果其实际效应高度依赖邻近子结构的存在,那么该片段单独对应的贡献值仍可能较小。
相反,某些仅具有中等注意力权重的片段,也可能表现出较大的正向或负向贡献,并直接推动目标性质预测值向特定方向变化。这种现象类似于蛋白质–配体结合过程:某个残基可能对于维持结合口袋的结构完整性至关重要,即在结构环境中具有较高重要性,但其本身未必直接贡献显著的结合自由能。上述差异进一步说明,在解释模型时,需要结合分子内部整体关系与结构环境,同时考察注意力权重和贡献值。
3.4 分子设计中的实际使用建议
在合理分子设计中,建议将贡献值作为片段筛选和结构修饰的主要依据。若希望提高某一性质值,应优先关注具有较大正贡献的片段;若希望降低该性质值,则应重点考虑具有较大负贡献的片段。
注意力权重则更适合用于识别需要结合上下文谨慎修饰的片段。由于高注意力片段通常与整体分子环境或片段间相互作用密切相关,对其进行结构修改可能产生复杂的非加和效应,因此不能仅依据其局部贡献进行判断。
较优的分子设计策略应综合使用这两类指标:同时具有高注意力权重和较大正向或负向贡献的片段,是性质优化过程中最具影响力的候选修饰位点;而贡献值较大但注意力权重中等的片段,则通常更适合作为直接、相对明确的结构修饰目标。
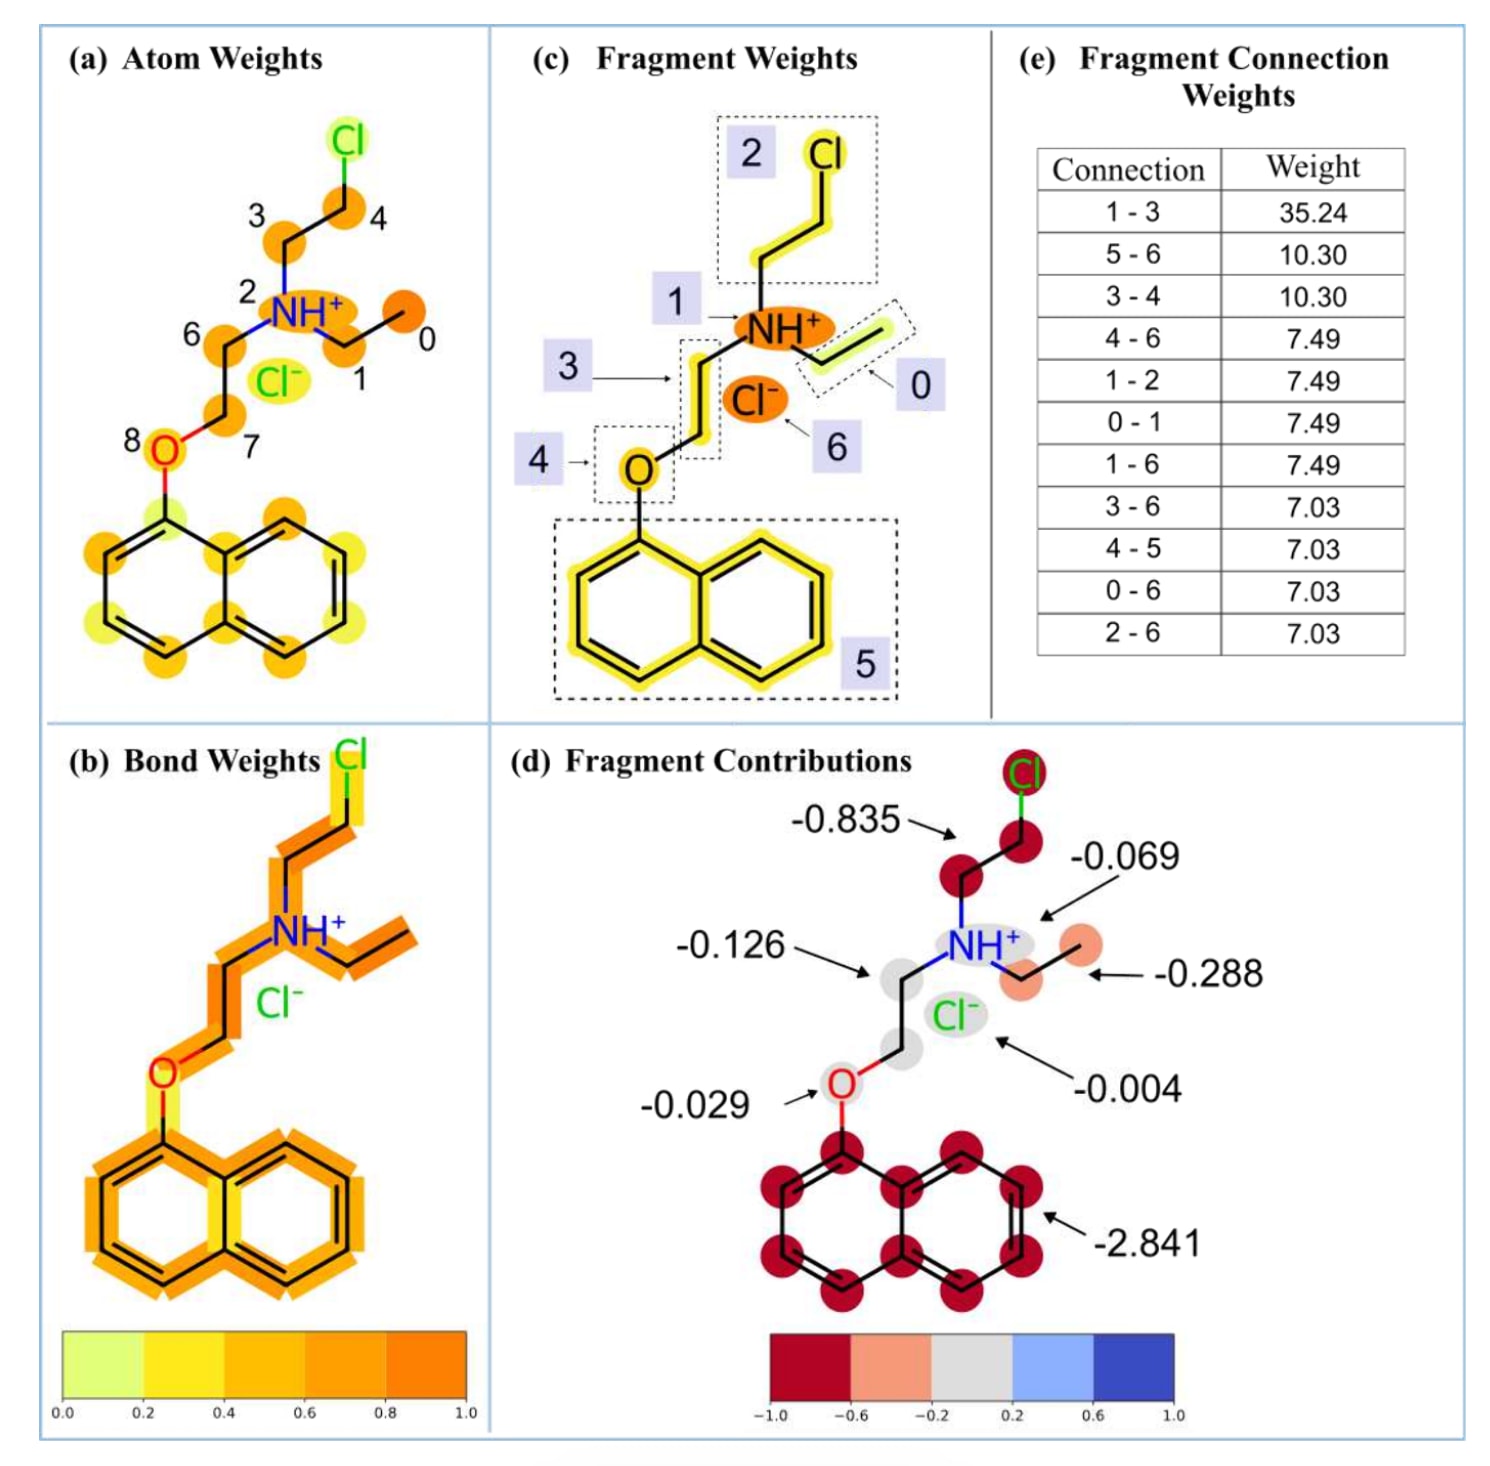
图3|FragNet 中不同类型的注意力权重与贡献值可视化。 以 CC[NH+](CCCl)CCOc1cccc2ccccc12.[Cl] 为例,a、b、c 分别展示原子、化学键和分子片段的注意力权重,d 展示片段贡献值。b 中的颜色条同时适用于原子、化学键和片段注意力权重。e 中的表格给出了片段连接的注意力权重。c 中蓝色方框内的数字表示片段索引,并与 e 中使用的片段编号相对应。
3.5 可解释性案例分析
首先选取一个代表性化合物展示 FragNet 的可解释能力。在后续章节中,进一步围绕溶解度、亲脂性和抗癌药物响应三个预测任务,分析注意力权重和贡献值能够提供的化学信息。以下讨论中,采用
图3展示了溶解度预测模型对 1-Naphthyloxyethylethyl-beta-chloroethylamine hydrochloride 得到的注意力权重和贡献值。其中,最大的原子注意力权重集中在带正电荷的氮原子 N(2) 附近。这一结果符合预期,因为该区域很可能与溶剂水分子发生最显著的相互作用。其次较大的注意力权重分布在芳香环中的 4 个原子以及醚氧 O(8) 上。醚氧具有较高注意力也较为合理,因为其可作为氢键受体与水分子发生相互作用。此外,醚氧还可以从相邻的
从化学键注意力权重来看,最大的权重出现在 C(0)−C(1)、C(3)−C(4) 和 C(6)−C(7) 三条化学键上。这些化学键均有一个原子与 N(2)
此外,由于片段 3 与醚氧相连,电子也可能通过 C(6)−C(7) 向双环体系流动。醚基既可以表现出吸电子效应,也可以表现出供电子效应。在该分子中,醚氧可能从片段 3 吸引电子,同时向双环体系提供电子。C(6)−C(7) 键具有较大的注意力权重,可能反映了这种较为复杂的电子流动特征,因为该化学键位于两个具有吸电子作用的中心,即 O(8) 和 N(2) 之间。
从片段注意力来看,包含 N
此外,Cl
图3d进一步展示了不同分子片段的贡献值,用于反映各子结构对预测性质的作用方向。根据片段贡献值可以发现,双环体系具有最显著的疏水性,其贡献值高度为负,表明该结构会明显降低模型预测的溶解度。其次较为疏水的是片段 2 和片段 0。这两个片段的疏水性可能主要来源于其对 N
相对而言,Cl
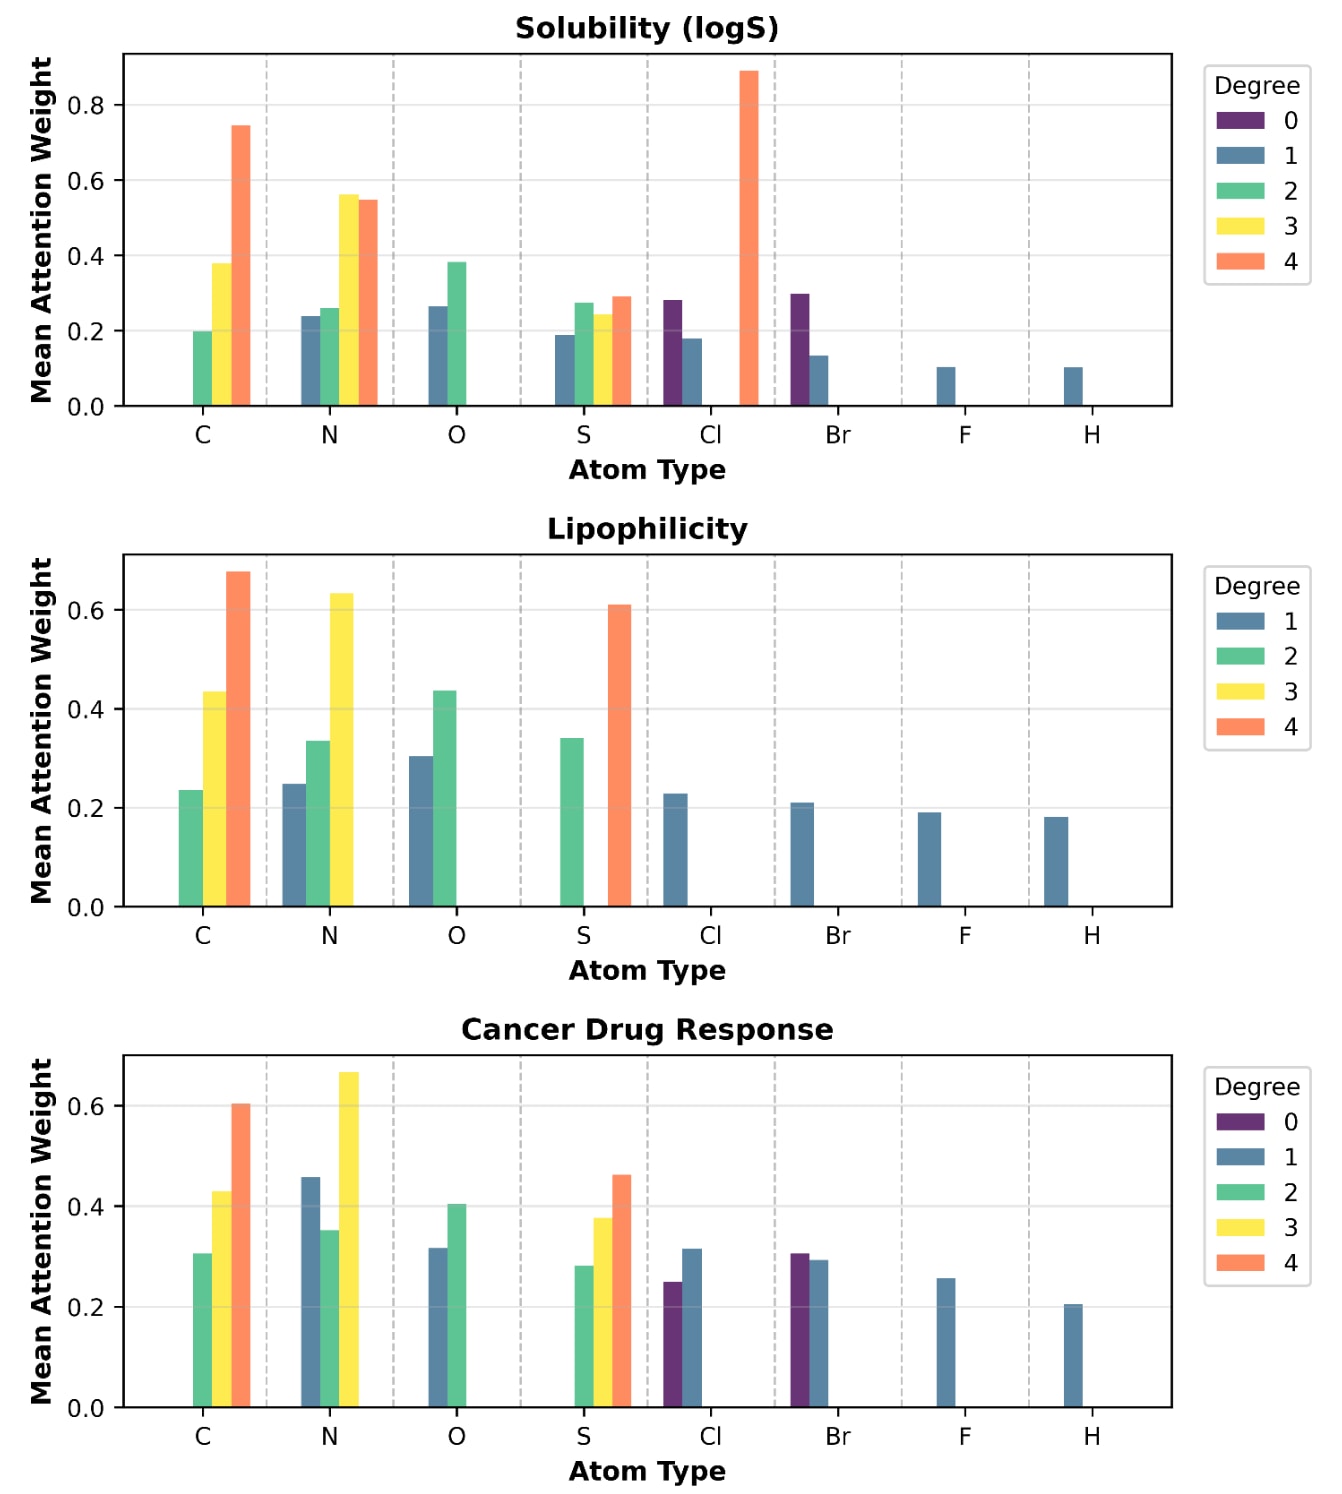
图4|常见原子类型的平均注意力权重。 基于溶解度、亲脂性和抗癌药物响应预测中绝对误差小于 0.1 的样本计算。较高的注意力权重表示模型在进行预测时更加重视相应原子。误差棒表示所分析分子之间的标准差。
3.6 子结构分析
为揭示影响溶解度、亲脂性和抗癌药物响应(cancer drug response,CDR)的关键结构因素,该研究对具有显著影响的分子子结构进行了定量分析。相关研究所使用数据集的详细信息见补充信息中的数据部分。
在分析过程中,首先对数据集进行筛选,仅保留绝对预测误差较低的样本,从而重点关注模型能够准确捕捉结构–性质关系的情况,并提高所学习权重的可解释性。随后,识别数据集中反复出现的分子子结构,其范围涵盖官能团乃至单个原子,并在所有高置信度预测样本中计算这些子结构的平均注意力权重和贡献值。
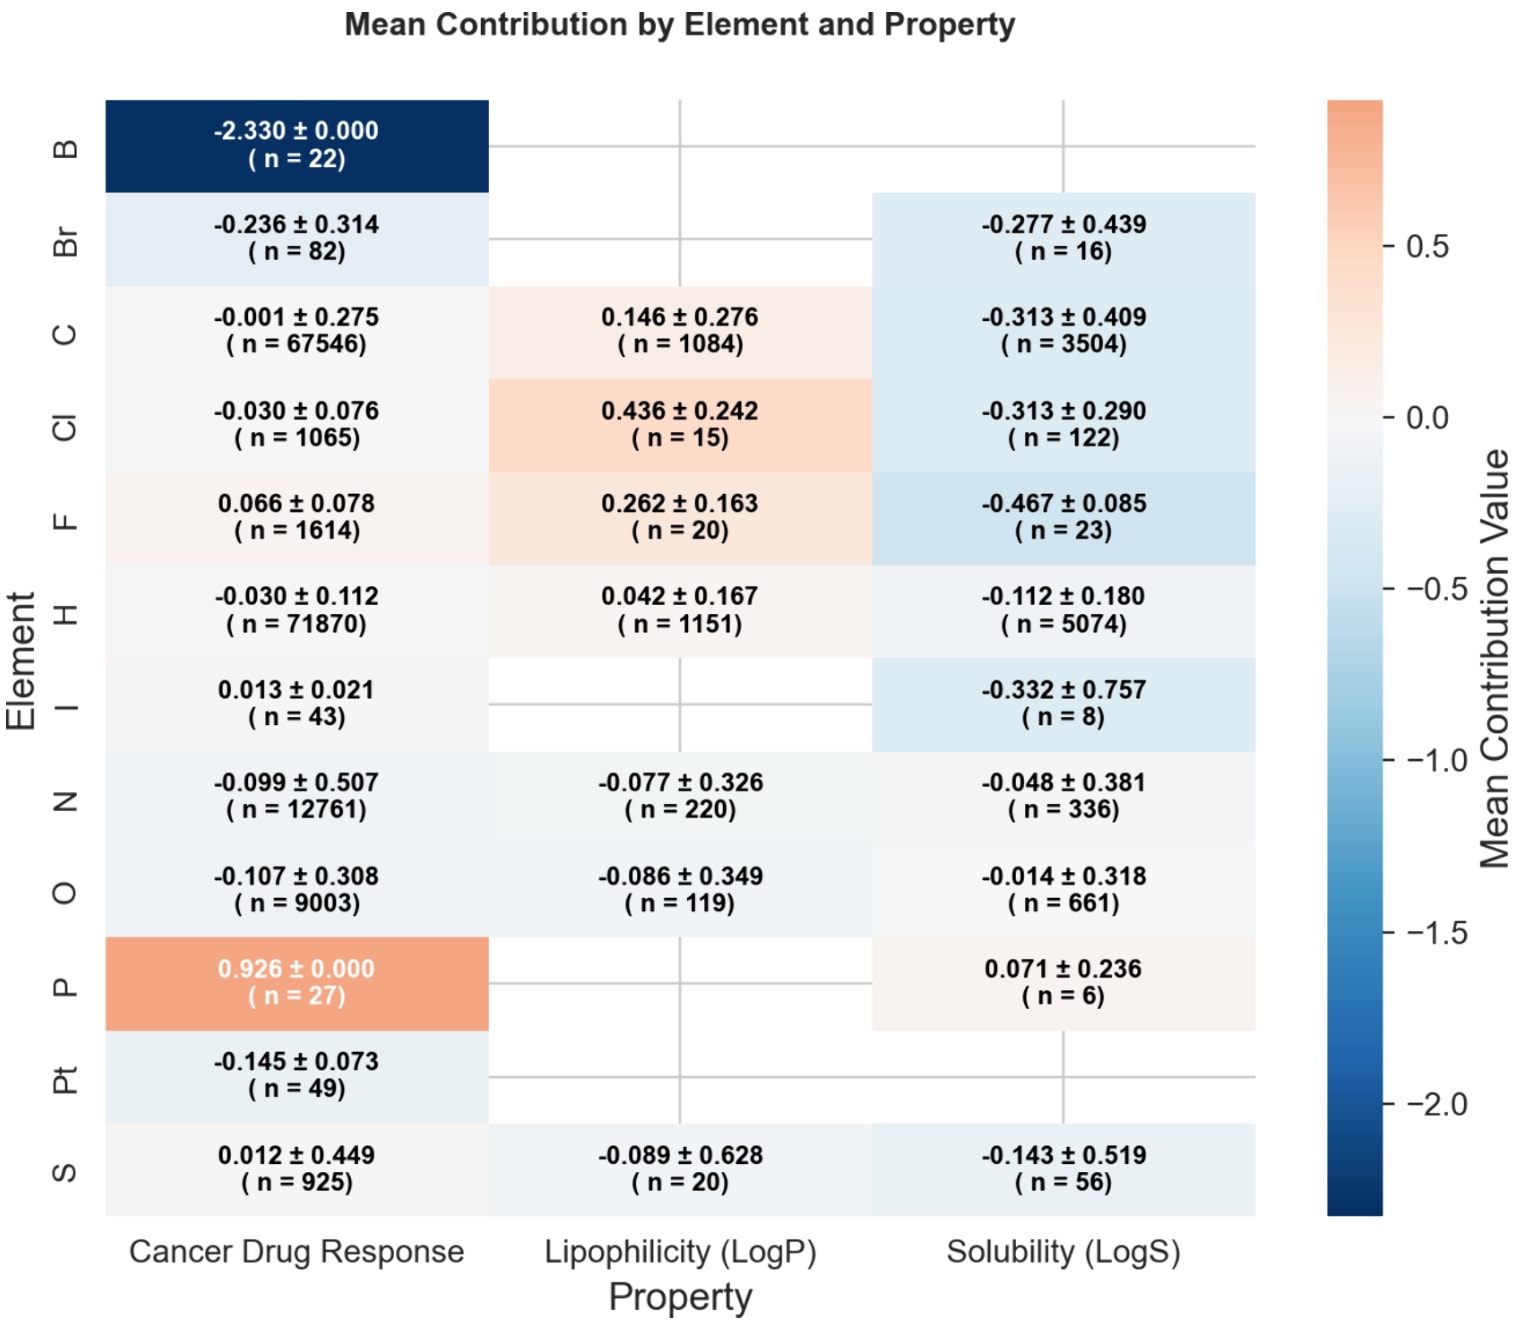
图5|不同元素及分子性质对应的平均原子贡献值及统计信息。 每个单元格给出平均贡献值 ± 标准差,括号内为样本数量
3.7 原子层级可解释性
3.7.1 原子注意力权重
对原子注意力权重的分析表明,模型对不同原子的关注程度同时受到原子元素类型及其局部连接情况,即原子度(degree)的显著影响。如图4所示,将最常见的原子类型按照原子度进行分组后可以发现,在溶解度、亲脂性和抗癌药物响应三个预测任务中均呈现出一致趋势:连接程度较高的碳原子和氮原子通常获得更高的注意力权重。
例如,季碳和叔氮均被赋予较高的重要性,表明模型能够优先关注分子骨架中具有重要结构作用的原子。不同预测终点均呈现类似规律,提示模型可能捕捉到了与分子复杂程度和支化特征相关的基本理化规律。
在三个数据集中,原子度与注意力权重之间均表现出较强的正相关关系,Pearson 相关系数
这些分析表明,FragNet 会将更高的结构复杂性、更高的饱和程度以及芳香性与更高的预测重要性相关联。
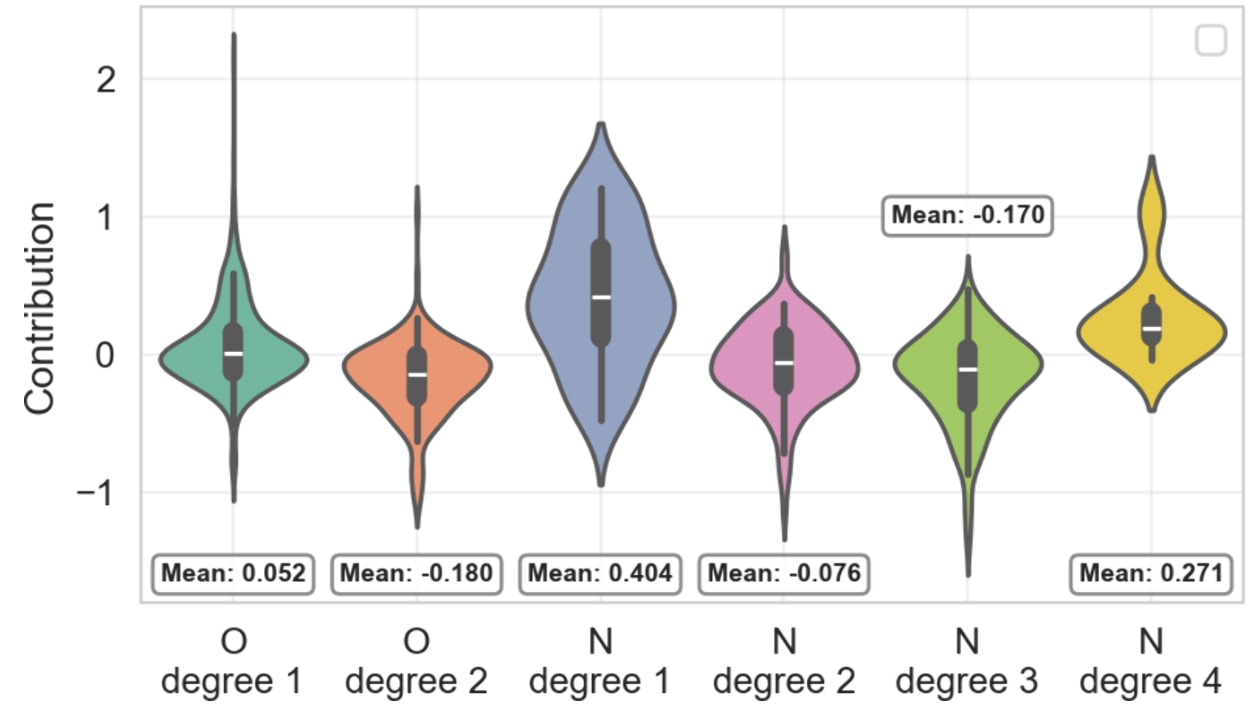
图6|水溶解度预测中按原子度(成键原子数)分组的氧原子和氮原子贡献值分布。
3.7.2 原子贡献分析
为直接量化单个原子对模型输出的影响,该研究进一步计算了原子层级的贡献值。某一原子的贡献定义为完整分子的预测值与在计算过程中掩蔽该原子后所得预测值之间的差值。正贡献值表示该原子的存在会提高目标性质的预测值,而负贡献值则表示其会降低预测值。相关结果如图5所示。
对于水溶解度,原子贡献分析总体上与已有理化规律一致。氟原子(平均贡献值为
值得注意的是,尽管氧和氮通常能够参与氢键形成,但其平均贡献值却略微为负,分别为
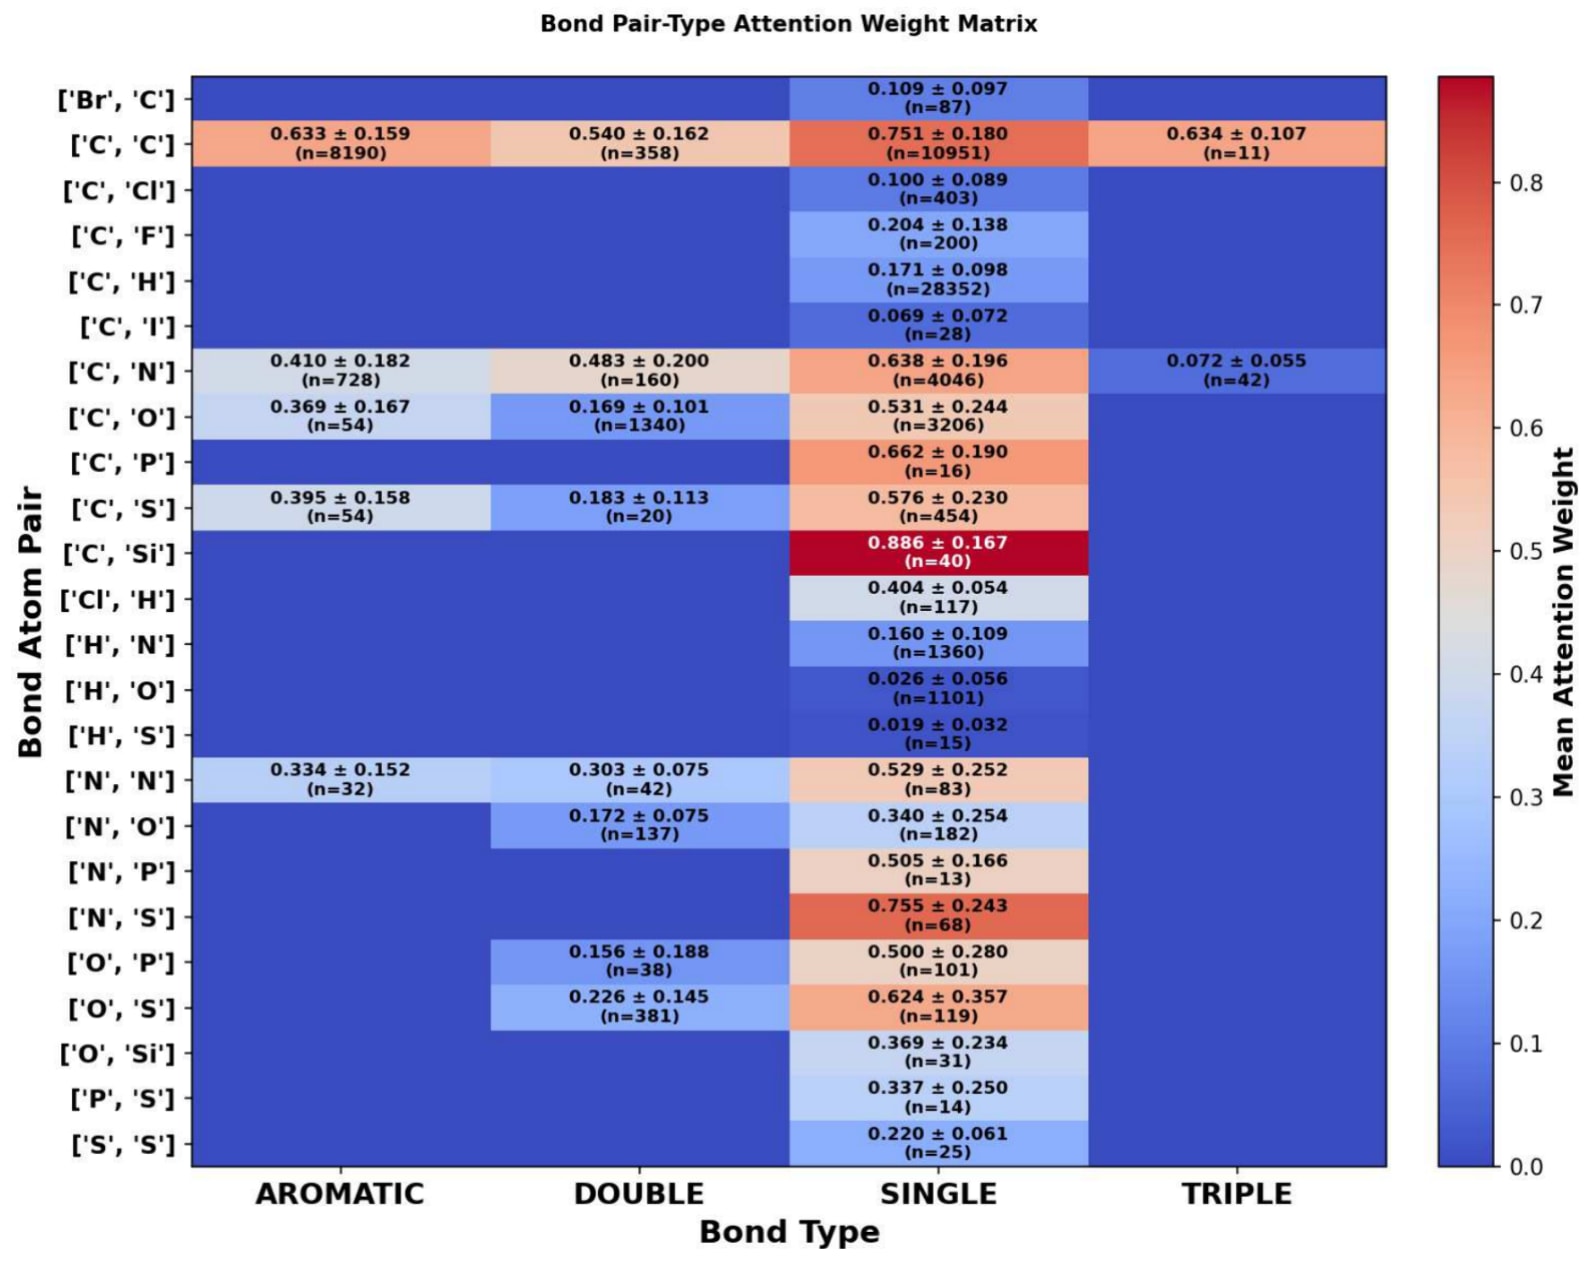
图7|常见化学键类型在溶解度预测中的平均注意力权重。 基于绝对预测误差小于 0.1 的样本计算;每种化学键类型所分析的化学键数量以
对于氧原子,原子度为 1 的氧,例如羰基氧和羟基氧,平均贡献值为
氮原子也表现出类似的结构环境依赖性。原子度为 1 的氮,例如腈基中的氮,以及原子度为 4 的季铵型带电氮,均明显促进溶解度,平均贡献值分别为
对于亲脂性,原子贡献模式与化学直觉高度一致。卤素原子和碳原子均表现出明显的正贡献,其中 Cl 为
抗癌药物响应的原子贡献模式则更加复杂,并具有明显的数据集依赖性。磷原子的平均贡献值高达
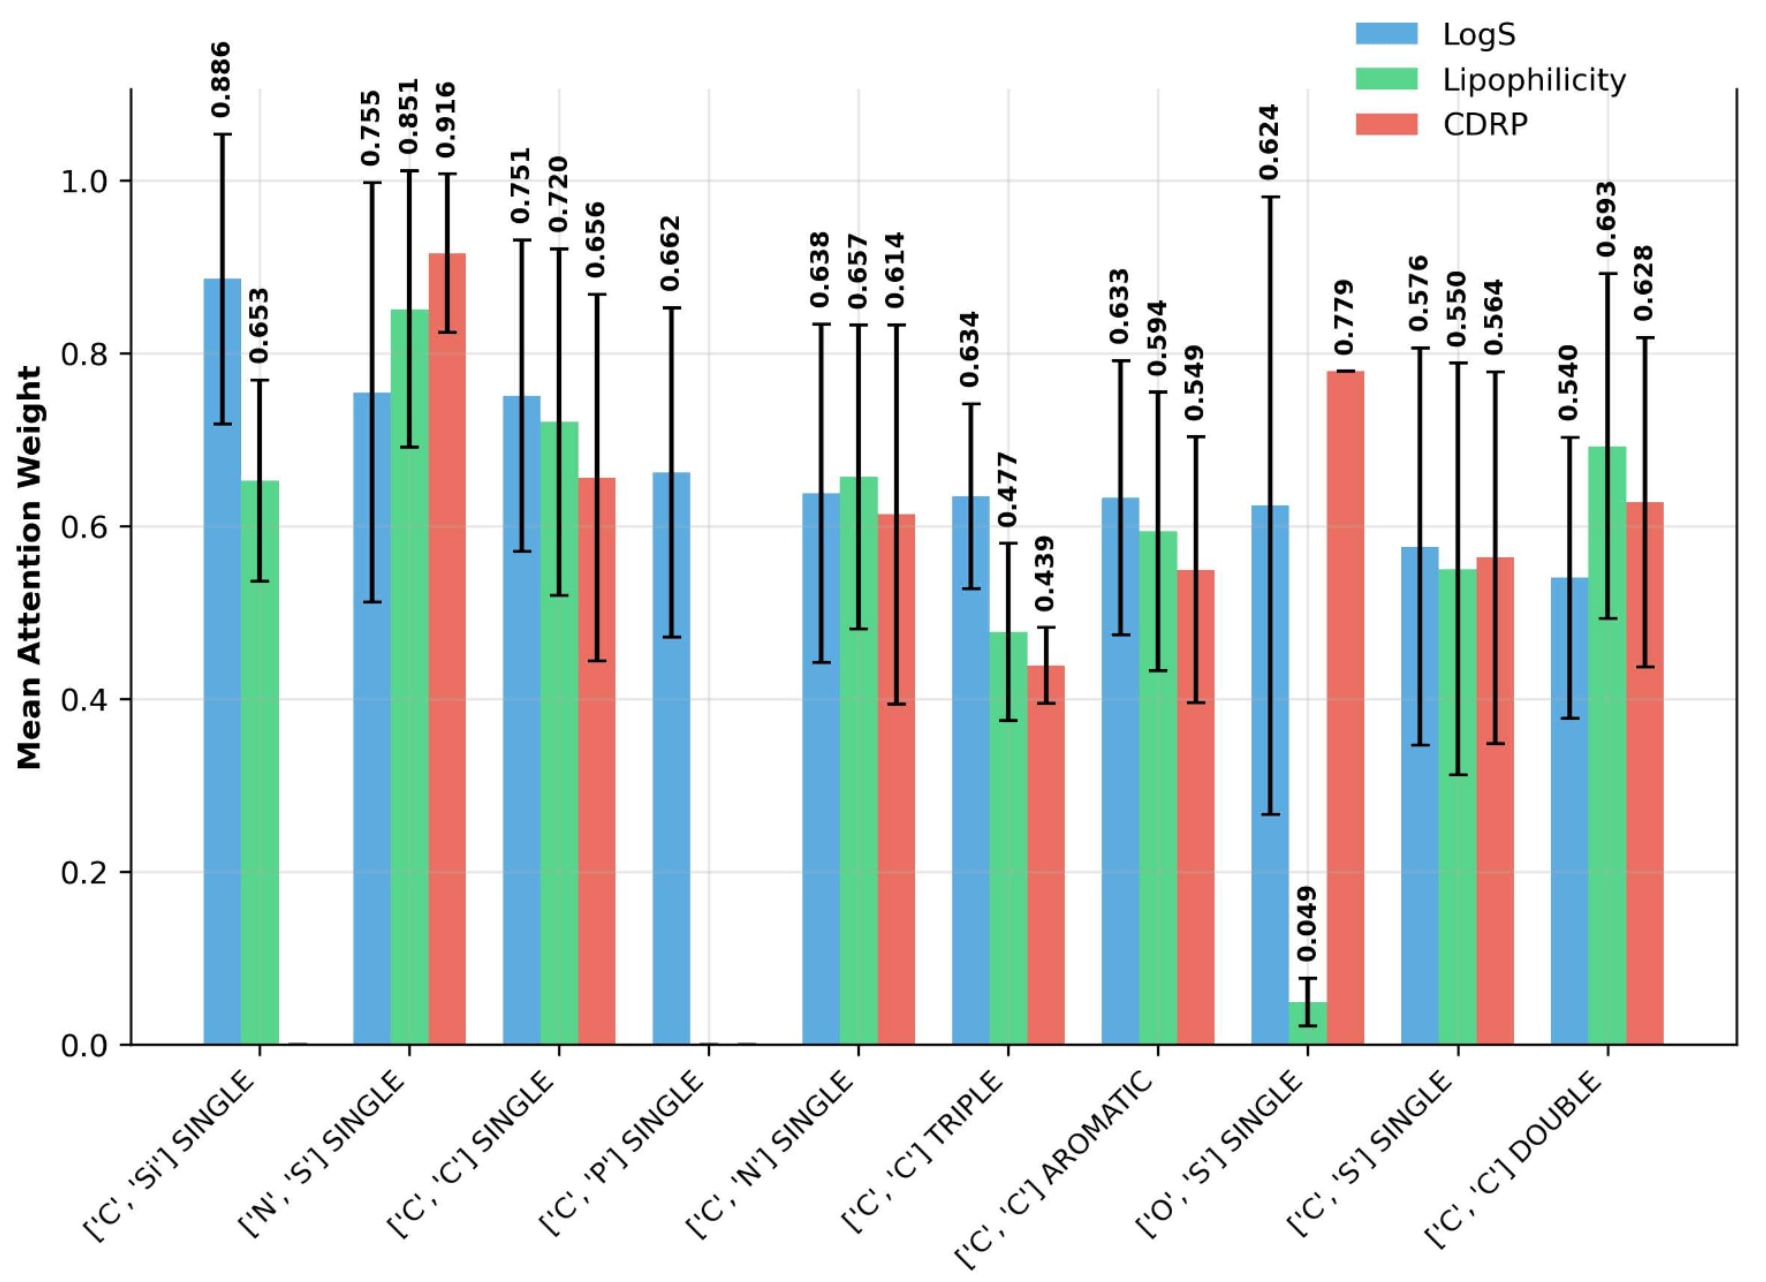
图8|常见化学键类型的平均注意力权重。 基于绝对预测误差小于 0.1 的样本计算。C−C 键和 C−N 键在三种分子性质预测任务中均持续获得较高的注意力权重,反映了其作为分子主要结构骨架的重要性。误差棒表示标准差。
3.8 化学键层级可解释性
3.8.1 化学键注意力权重
对化学键层级注意力权重的分析揭示了模型对不同化学键类型的关注模式(图7、图8)。在三个预测任务中,芳香键均获得了最高的注意力权重,其平均值分别为:溶解度预测
模型在溶解度预测中对芳香体系的偏重还体现在环结构上。如图 S8 所示,环内化学键的平均注意力权重为
对于溶解度预测,化学键是否具有共轭性也是影响模型注意力的重要因素。参与离域
进一步分析键级发现,在溶解度预测中,具有分数键级的化学键,例如芳香体系中典型的
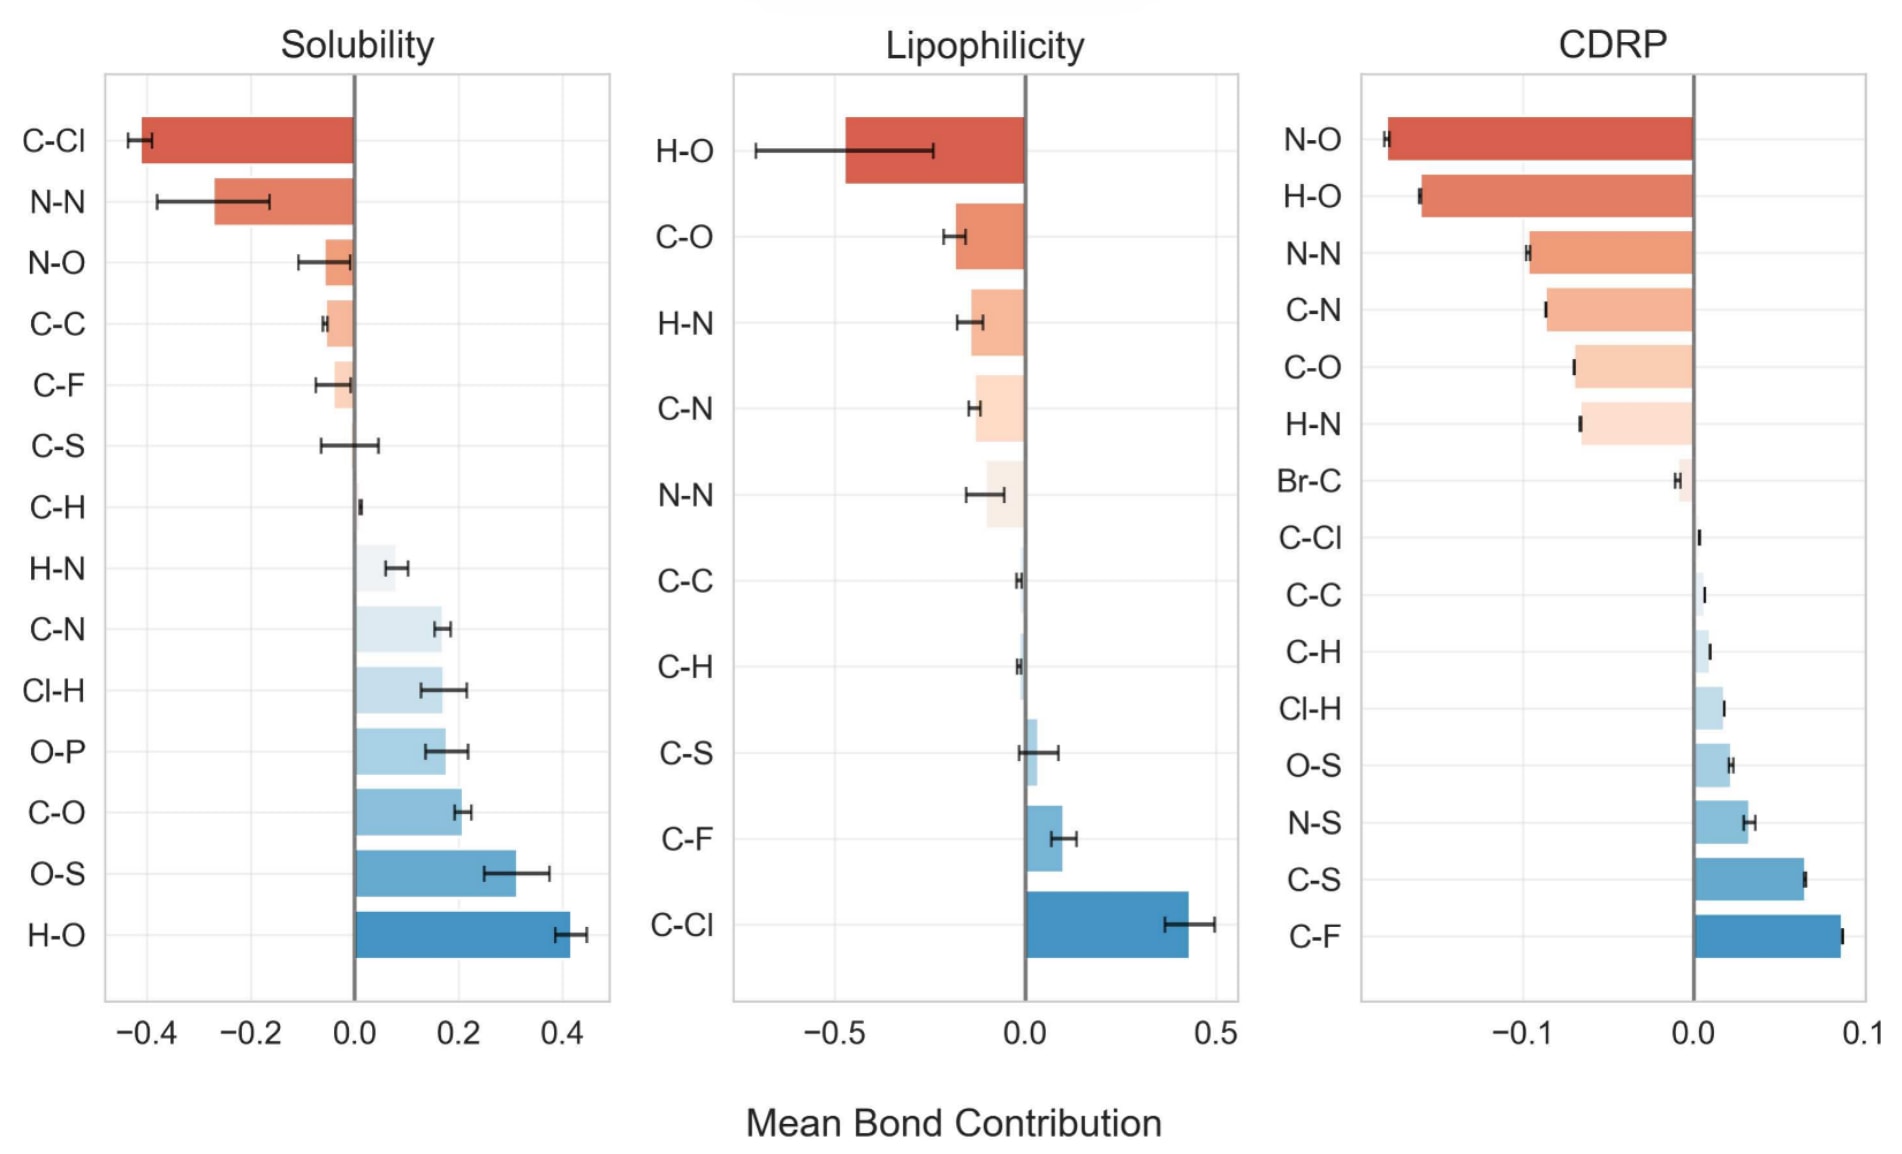
图9|三种分子性质中不同化学键类别的平均贡献值。 左,水溶解度预测中,极性化学键提高预测值,而含卤素化学键降低预测值;中,亲脂性预测中呈现相反趋势;右,抗癌药物响应预测中的影响相对较弱。这些结果从定量层面验证了基本的物理化学规律。误差棒表示标准差。
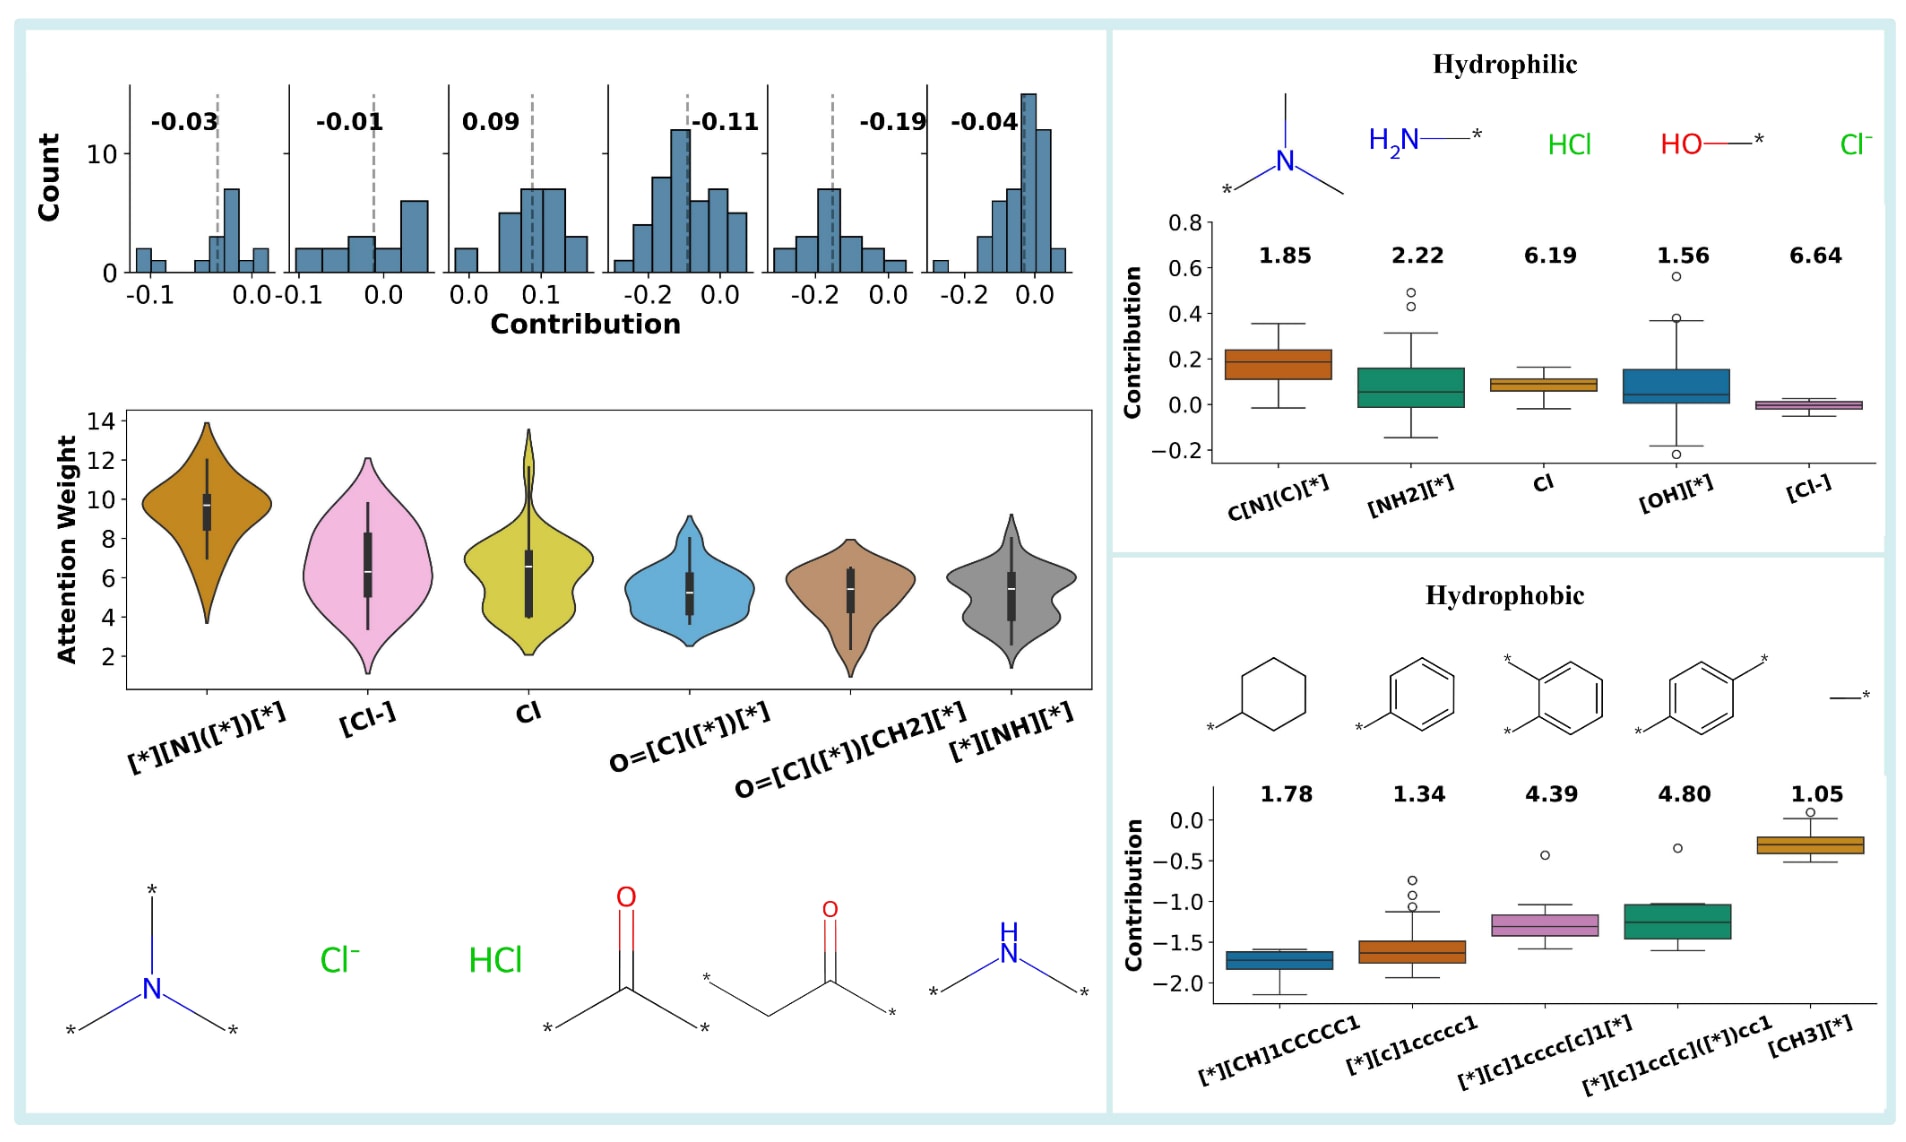
图10|水溶解度预测中的关键分子片段分析。 左,模型高关注片段的注意力权重及其对应贡献值分布的小提琴图;较高的注意力权重表示模型在预测过程中更加关注该片段,而贡献值用于量化该片段对预测溶解度的具体影响。右,平均贡献值最高的正贡献片段(上)和负贡献片段(下),分别对应模型预测会提高或降低水溶解度的结构基序。每个片段结构上方标注其平均注意力权重。
3.8.2 化学键贡献分析
为定量评估特定化学键对预测结果的方向性影响,该研究进一步计算了化学键贡献值,即在计算过程中掩蔽某一化学键后,模型预测值相对于完整分子的变化。
图9展示了三类预测任务中最常见化学键类型的平均贡献值。结果表明,不同性质对应的化学键贡献呈现出系统性且具有明确性质依赖的规律,并与基本化学原理总体一致。
对于溶解度,含氧化学键(C−O 和 H−O)以及含氮化学键(C−N 和 H−N)持续表现出正贡献,而碳–卤素键(C−Cl、C−F 和 C−Br)则表现出负贡献。对于亲脂性,这一趋势明显反转,即卤素键呈正贡献,而极性化学键呈负贡献。抗癌药物响应任务中的贡献模式则更加复杂,且整体效应幅度较小,这与生物活性受多种因素共同影响的特点相符。
进一步将单独的化学键类型归并为三类:极性键(C−O、C−N、H−O、H−N)、非极性键(C−C、C−H)和卤素键(C−F、C−Cl、C−Br、C−I),可以观察到更加系统且符合化学直觉的趋势(图 S9)。
对于水溶解度,极性键的平均贡献值为
对于亲脂性,上述趋势则发生反转:卤素键表现出较强的正贡献,平均贡献值为
抗癌药物响应中的化学键贡献则更为复杂。卤素键表现出中等程度的正效应,平均贡献值为
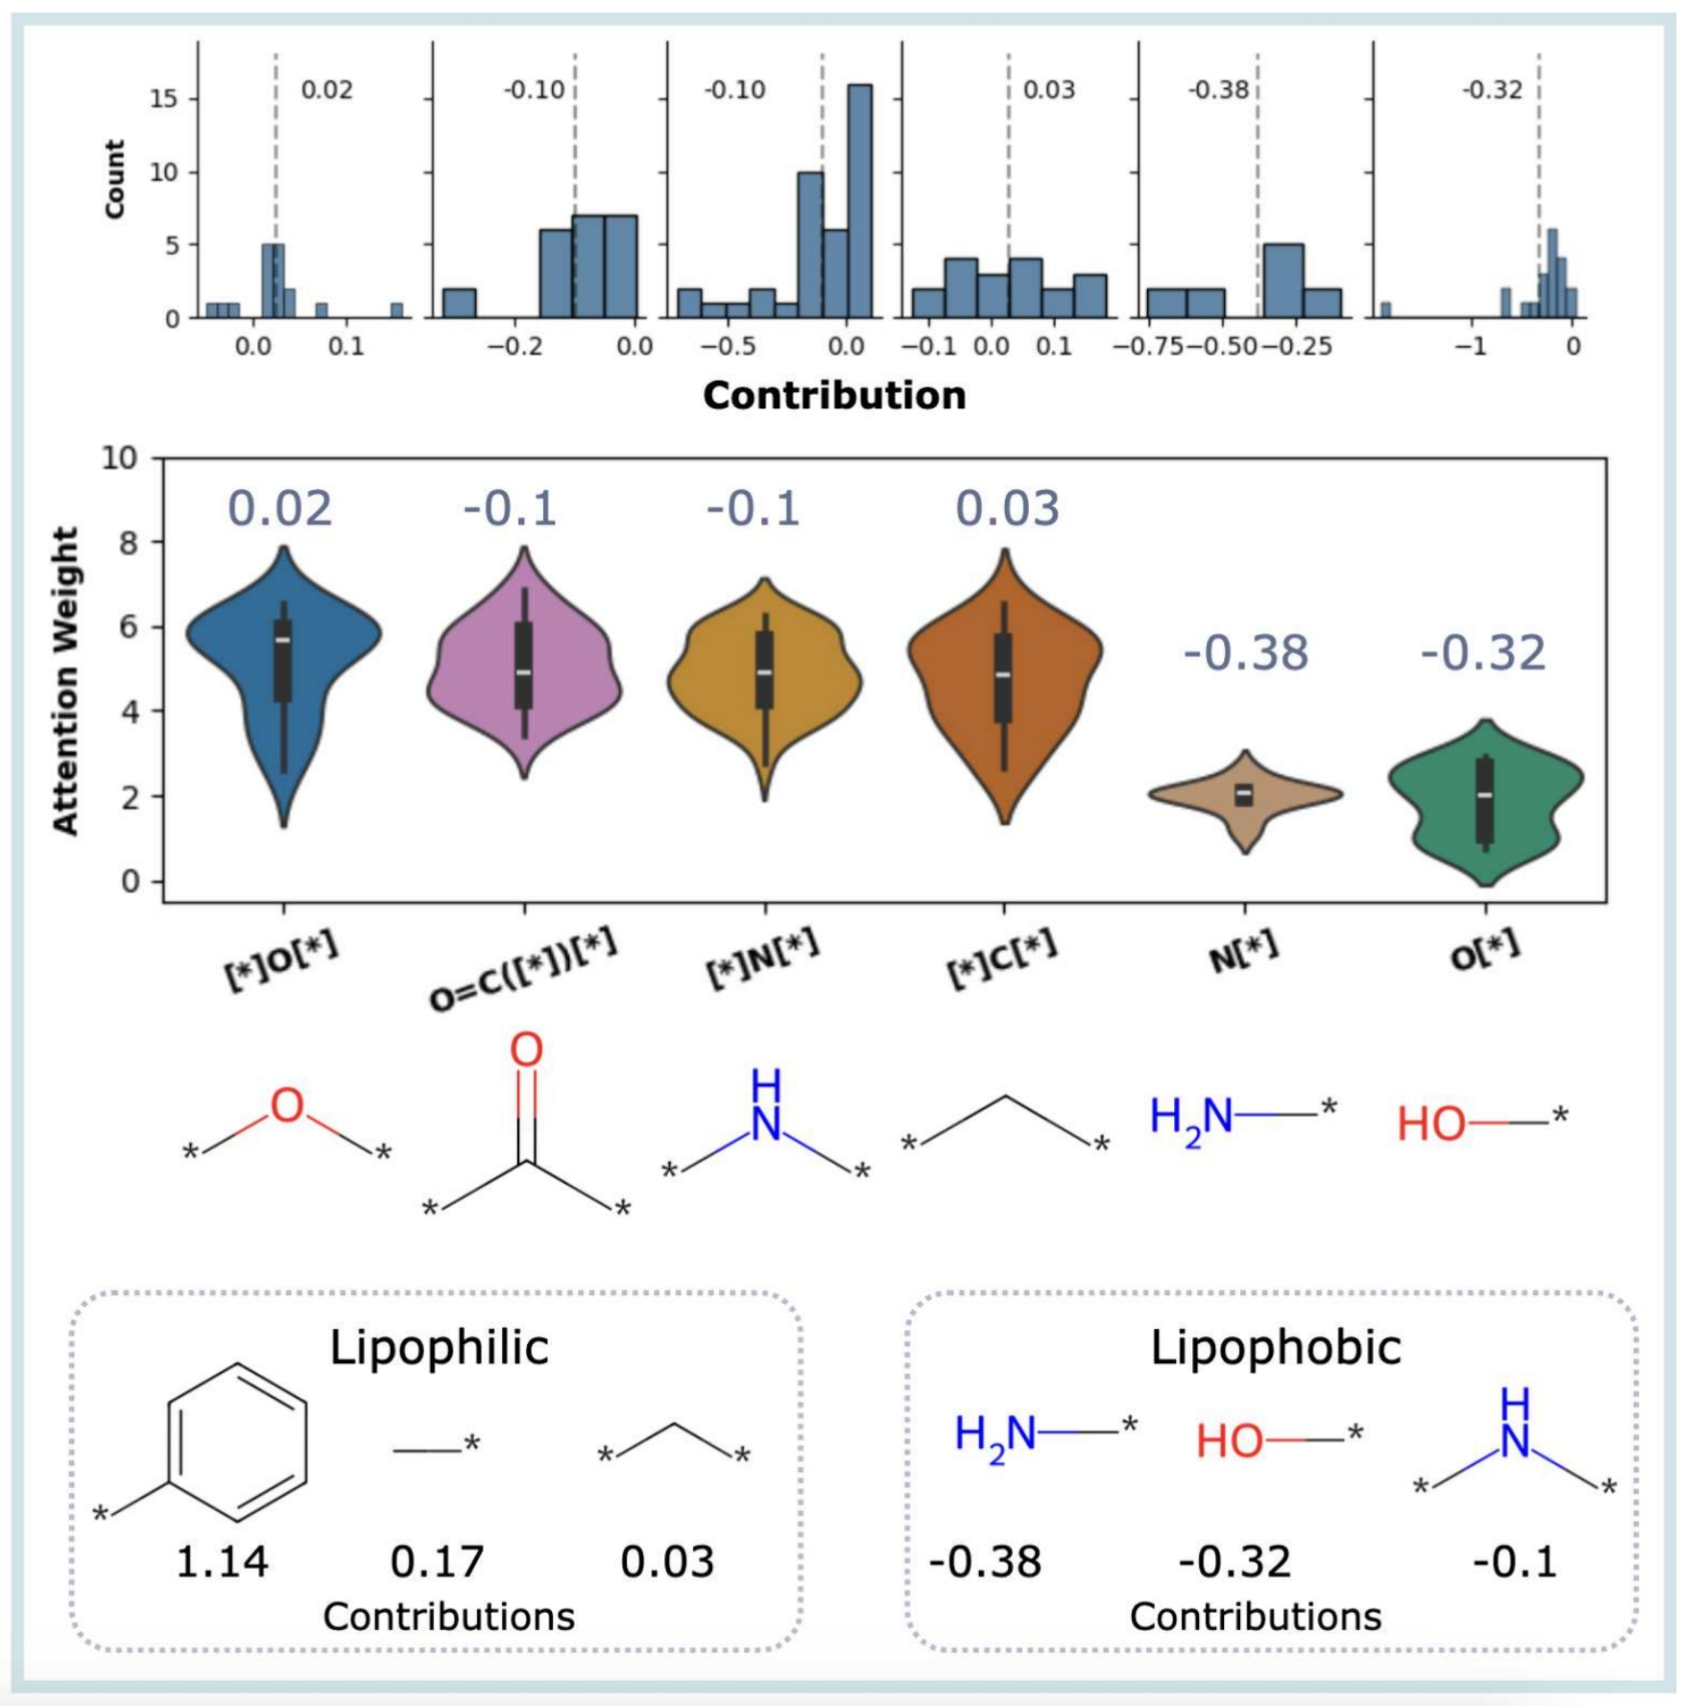
图11|亲脂性预测中的关键分子片段分析。 图中展示了模型识别出的关键片段及片段–片段连接。各结构均标注其平均注意力权重及对应贡献值,用于说明模型重点关注哪些片段,以及这些片段被预测为提高亲脂性(正贡献)还是降低亲脂性(负贡献)。
3.9 片段层级可解释性
为理解更大尺度、且具有完整化学意义的官能团对分子性质的影响,该研究进一步将分析扩展至片段层级。通过这种方式,可以基于可识别的化学结构基序解释分子性质。
对于水溶解度,片段贡献值与已有化学规律高度一致(图10)。含氮片段,例如 [*]N([*])[*],以及含氧片段,例如 −OH,均被识别为关键亲水性基序,并同时表现出较高的注意力权重和正贡献值。值得注意的是,模型表现出明显的上下文感知能力。例如,羰基片段 O=C([*])[*] 的平均贡献值整体为负,但进一步的细粒度分析表明,当羰基邻接 −OH 或 −NH2 基团,即形成羧酸或酰胺结构时,其贡献会转为明显的正值(图 S10);相反,当羰基与疏水性环系相连时,其贡献仍保持为负(图 S11)。这种上下文依赖性说明,模型学习到的并非简单的官能团加和效应,而是能够识别更大尺度官能团组合所产生的整体性质。与预期一致,疏水性片段,尤其是芳香环,持续表现出负贡献。
对于亲脂性,则观察到相反趋势,即疏水性片段提高预测值,而极性片段降低预测值(图11)。
对抗癌药物响应预测(Cancer Drug Response Prediction,CDRP)模型的分析进一步识别出多种药物分子中常见的关键结构基序(图12)。高注意力片段包括氨基(−NH2、−NR2)、羰基(C=O)、醚基(−O−)、羟基(−OH)以及芳香环等。这些均属于经典的药效团特征,对调控溶解度、稳定性和靶标识别等性质具有重要作用。
尽管此处讨论的片段在药物响应预测中均表现为负贡献,但更广泛的贡献值分布(图 S12)表明,数据集中同样存在具有正贡献的片段。这里重点展示负贡献片段,是因为分析仅纳入至少出现在 10 个不同药物分子中的片段,以保证统计可靠性。作为对照,图 S13 展示了将筛选阈值降低至至少出现在 3 个不同药物分子中时的结果,其中包括对药物响应预测具有正贡献的片段。
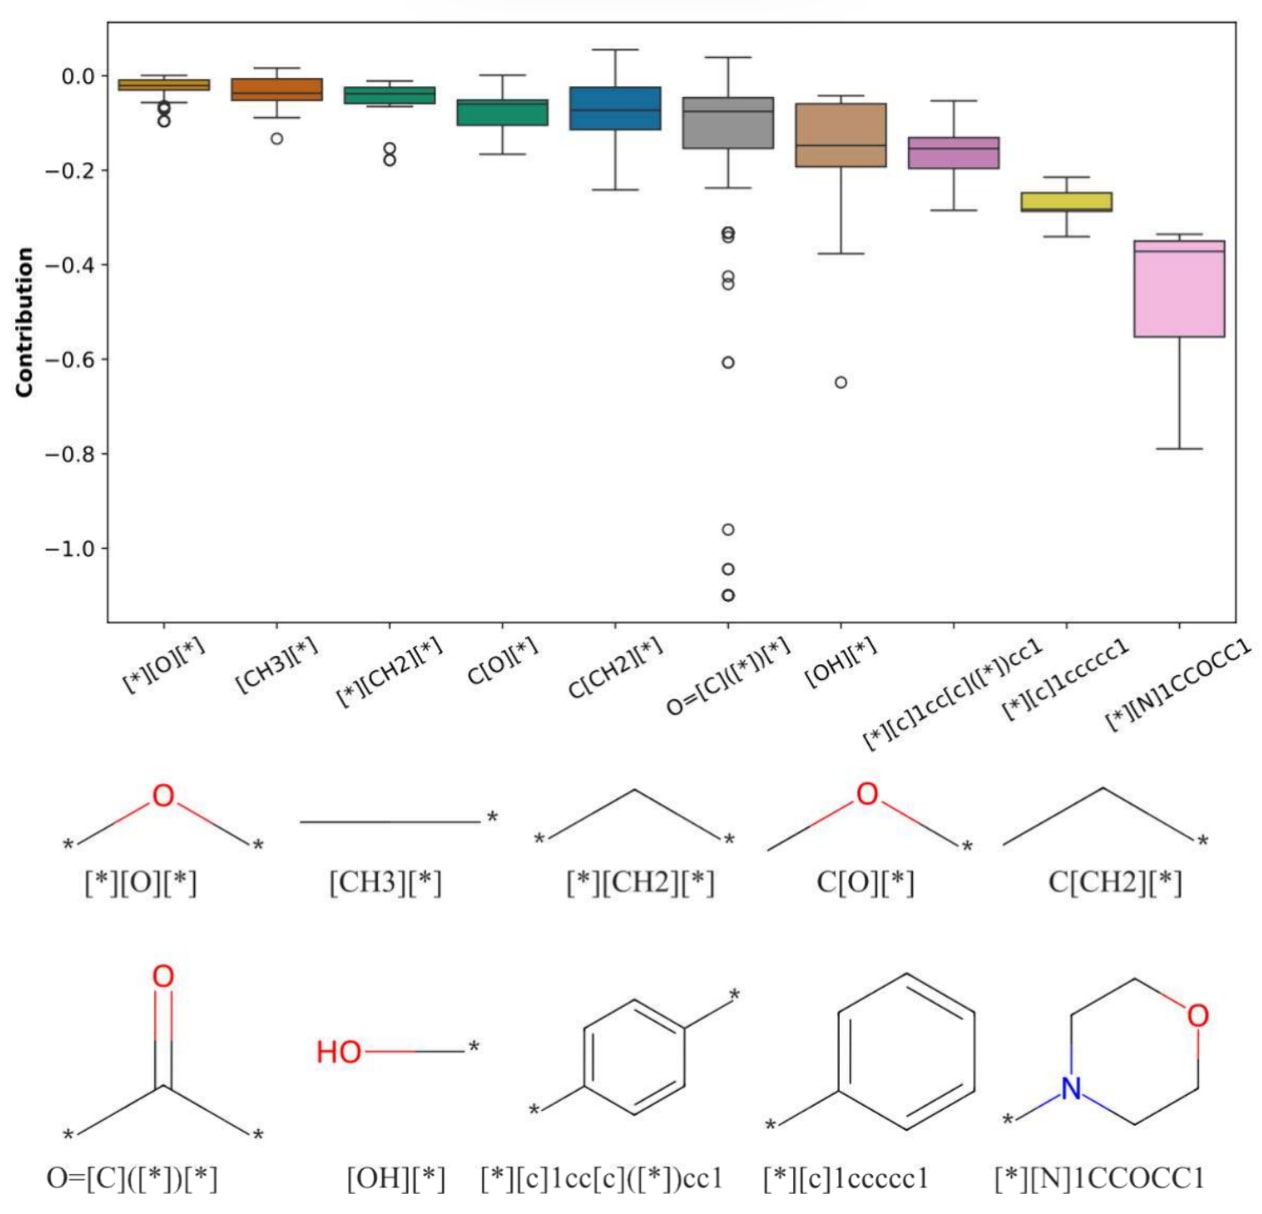
图12|抗癌药物响应(CDR)预测中贡献值最大和最小的分子片段。 展示至少出现在 10 个不同分子中的片段,其中分别列出贡献值最高的 5 个片段和贡献值最低的 5 个片段。
在同一 BRCA 细胞系上测试的 4 种药物案例进一步展示了该贡献分析方法的实际价值(图13)。其中,3 种具有较高响应值的药物(
此外,该研究还开展了活性悬崖分析,以评估模型的注意力权重和贡献值能否正确识别高度相似分子之间导致溶解度差异的关键结构因素。首先,利用 Morgan 指纹筛选 Tanimoto 相似度大于
对于每一对分子,片段被系统划分为三类:1)仅存在于分子 1 中的片段;2)仅存在于分子 2 中的片段;3)两个分子共有的片段。通过这种分类,可以针对性分析导致性质差异的结构特征。分别对两个分子中的特异片段贡献值求和,并计算两者之间的差值
为进一步分离差异片段的影响,研究采用了严格筛选标准,仅保留共有片段贡献差异不超过
随后,将
如图14所示,两项指标均支持上述假设:模型在方向判断上的一致率达到 95.7%,且
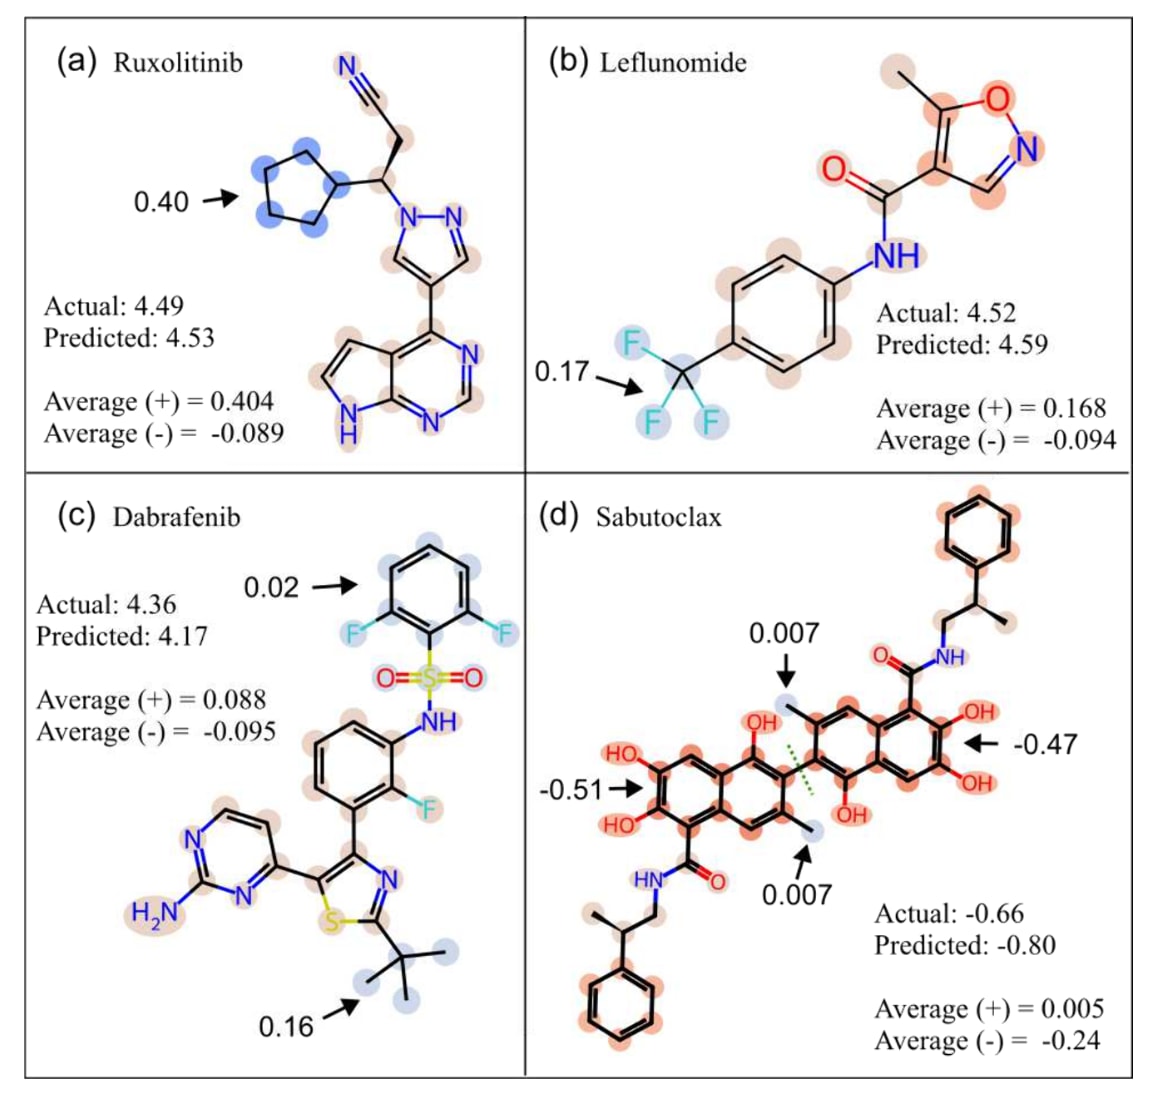
图13|具有较高和较低药物响应值的药物片段贡献值。 Average (+) 和 Average (−) 分别表示每个分子中正片段贡献值与负片段贡献值的平均值。
3.10 片段连接层级可解释性
FragNet 的一项主要创新,是能够获得片段之间相互作用对应的注意力权重和贡献值,尤其适用于片段之间不存在共价键连接的情况。
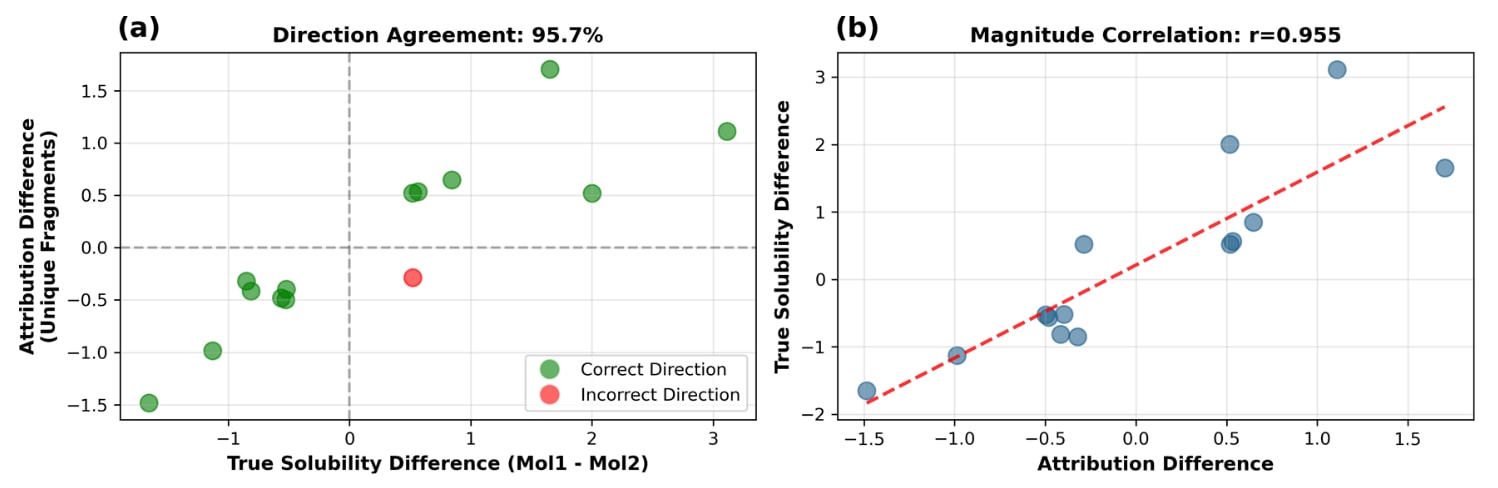
图14|基于活性悬崖分析对模型解释正确性进行定量验证。 a,相似分子对中片段贡献差异与溶解度差异的方向一致性;b,片段贡献差异幅度与溶解度差异之间的相关性。
3.10.1 片段连接权重
片段连接权重分析表明,模型对于不同分子性质具有明显不同的片段相互作用偏好(图15)。
对于水溶解度,最具影响力的片段连接主要涉及羰基 O=[C]([*])[*] 与含氧片段 [*][O][*] 以及含氮片段 [*][NH][*] 之间的相互作用,其平均权重分别为
相比之下,在亲脂性预测中,模型更加关注烷基链片段 [*][CH2][*] 与含氧片段 [*][O][*]、含氮片段 [*][NH][*] 之间的连接,其平均权重分别为
对于抗癌药物响应预测(CDRP)数据集,模型则表现出对杂环芳香体系的明显偏好。尤其是嘌呤样片段 [*][c]1cc2ncn[c]([*])c2c[c]1[*] 与氨基片段 [*][NH][*] 之间的连接,其平均权重达到最高的
上述片段连接模式进一步为结构–性质关系提供了潜在机制层面的解释。对于溶解度预测,羰基与杂原子片段连接的重要性凸显了极性表面积和氢键能力的关键作用。这类相互作用在多个分子中持续获得较高权重,提示其可能是反映溶剂化能的重要结构指标。
对于亲脂性,模型重点关注烷基片段与杂原子片段之间的连接,反映了膜分配过程中疏水作用与亲水作用之间的微妙平衡。对于 CDRP,结果则突出显示了特定药效团结构的重要性,尤其是广泛存在于生物活性化合物中的含氮杂环。模型赋予嘌呤–氨基连接较高权重,提示这些子结构可能构成癌细胞增殖与存活相关生物靶标识别过程中的关键结构单元。
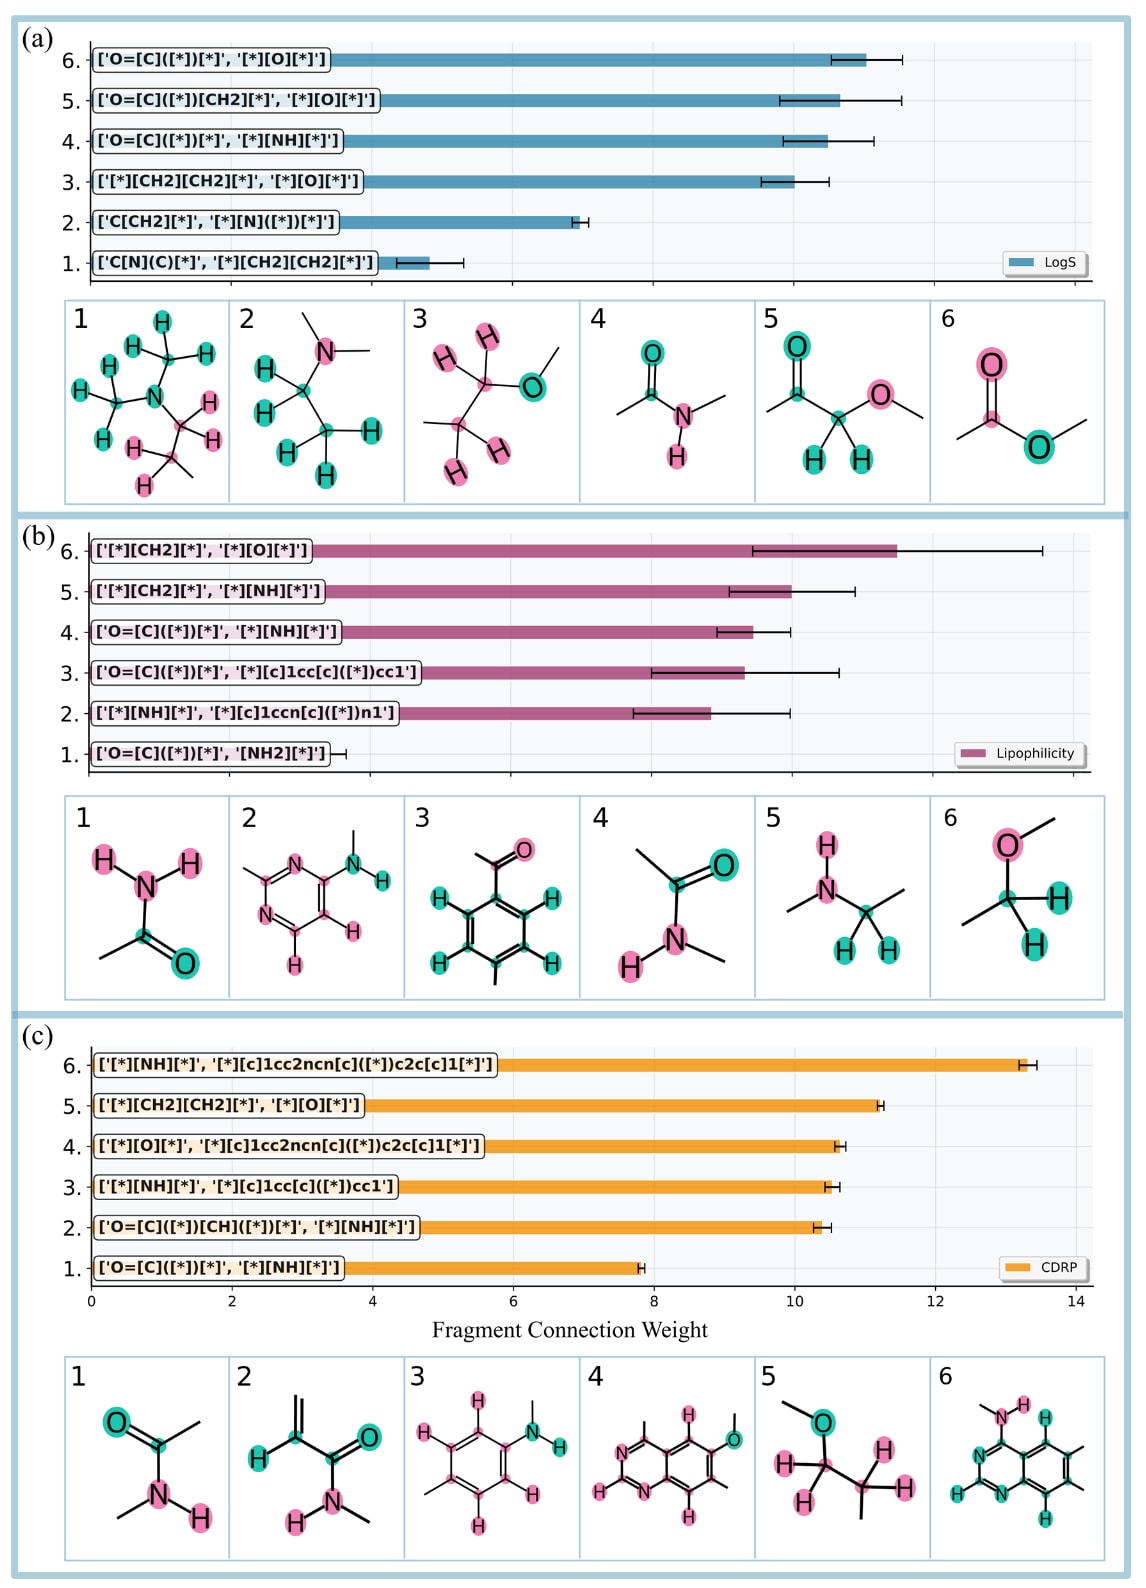
图15|溶解度、亲脂性和抗癌药物响应预测中的高权重片段连接。 误差棒表示平均值标准误(SEM)。三个柱状图共用同一横坐标轴。各类片段连接的代表性示例见图 S14。
3.10.2 片段连接贡献分析
在溶解度预测任务中,片段连接贡献值具有较大的、且具有明确化学意义的变化范围,从
贡献值的分布呈现出清晰规律:阴离子–片段相互作用的平均贡献值为
相比之下,抗癌药物响应数据集中的片段连接贡献值几乎为零,平均贡献仅为
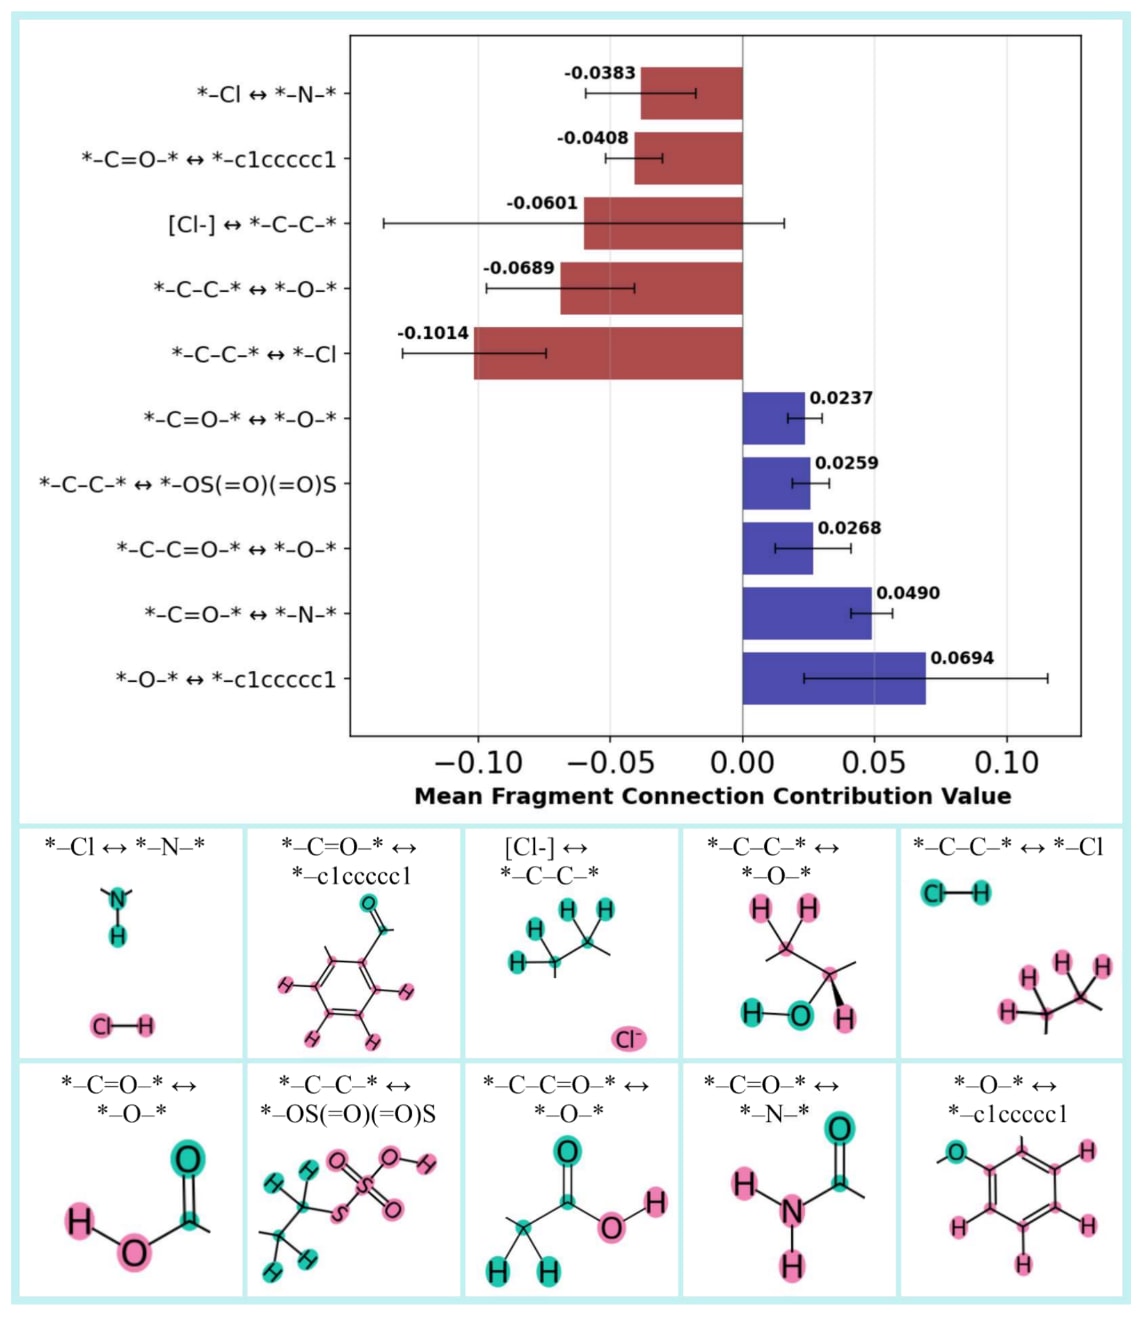
图16|溶解度数据集中的片段连接贡献值。 为保证统计可靠性,仅纳入至少出现在 4 个分子中的片段连接。误差棒表示平均值标准误(SEM)。
溶解度与抗癌药物响应任务在片段连接贡献幅度上的显著差异,体现了两类性质对于片段连接层级结构变化的本质不同响应。这一观察对药物设计具有实际意义:由于溶解度对特定离子相互作用高度敏感,因此盐型选择对于优化溶解度尤为重要;但类似结构调整对生物活性预测的影响可能非常有限,因为后者主要受到更复杂的系统性因素驱动。这种差异也有助于解释药物开发中的常见现象,即同一种活性药物成分的不同盐型可能表现出显著不同的溶解度,但仍保持相近的治疗效果。
对于溶解度预测,涉及酚羟基的片段连接,即 O ↔ 苯环,其贡献值为
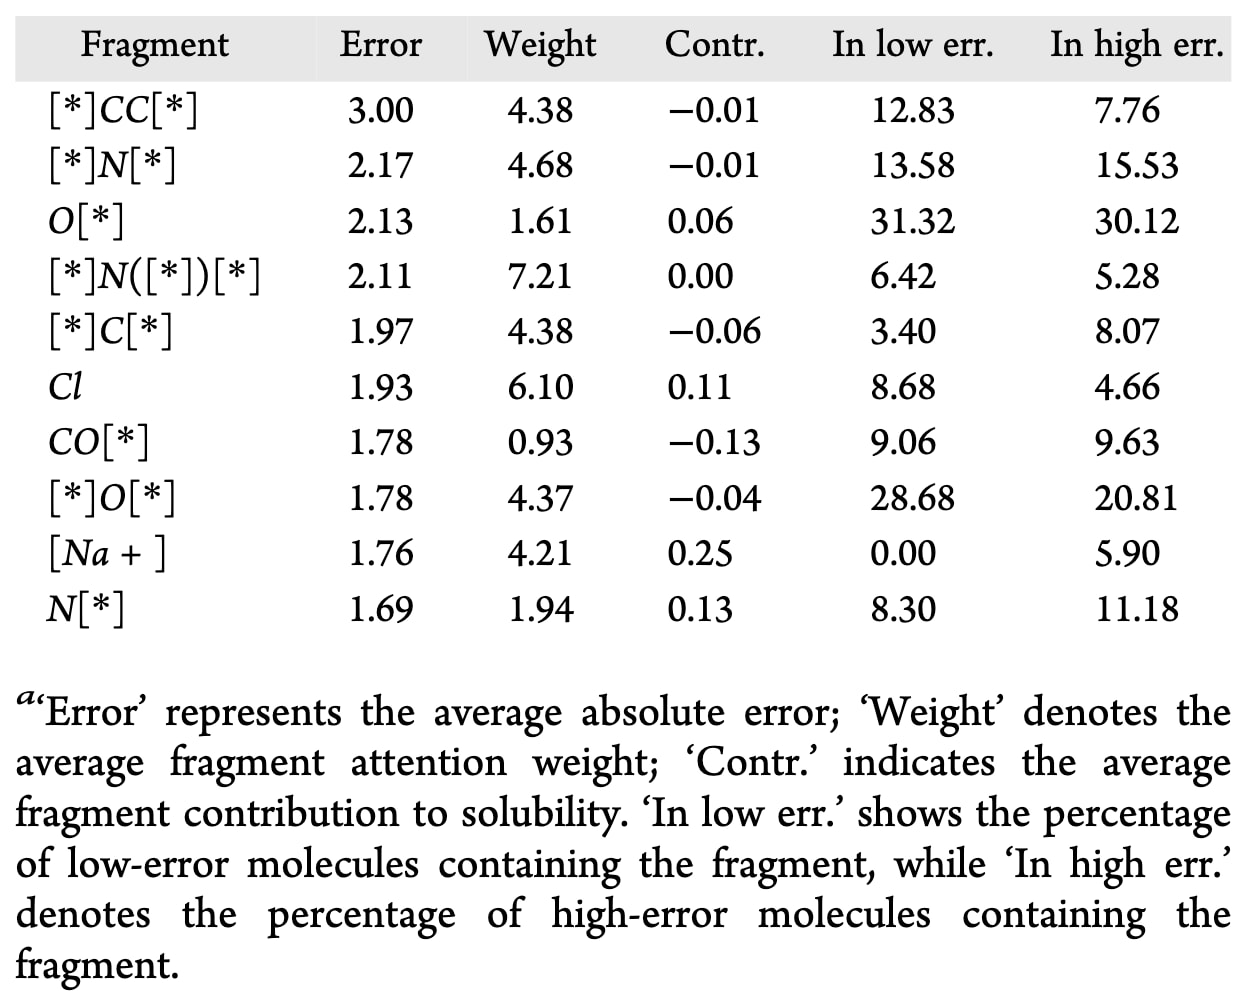
表3|高预测误差化合物中识别出的分子片段
模型还准确捕捉到了酚 > 醇 > 烷烃的溶解度促进趋势,并能够有效区分有利于溶解的极性官能团与阻碍溶解的疏水结构。溶解度数据集中片段连接贡献值的方差约为亲脂性预测中的 16 倍,进一步表明溶解度对局部结构变化更加敏感,并且更依赖具体的片段层级相互作用。亲脂性预测的相关结果见图 S16。
预测贡献值与已有化学知识之间的高度一致性,进一步验证了 FragNet 的机制可解释性及其在合理分子设计中的应用价值,尤其适用于通过针对性官能团修饰优化水溶解度。
部分片段连接具有较大的平均值标准误(SEM),表明其贡献值在不同分子环境中存在较大变化。这种变化具有明确的化学意义,也进一步强调了分子上下文对片段相互作用的重要影响。例如,O ↔ 苯环连接的贡献值具有较大波动,因为酚基对溶解度的影响会受到周围分子环境、取代模式以及其他官能团存在情况的显著影响。
类似地,烷基–羟基连接也表现出较大的误差范围,这可能源于亲水性 OH 基团与不同长度疏水性烷基链之间的竞争效应。这些差异进一步说明,片段贡献并不是固定不变的普适常数,而是高度依赖具体分子环境,这与真实的化学行为相一致。
由于抗癌药物响应对应的片段连接贡献值过于微小,因此未进一步分析该性质下的片段连接贡献。
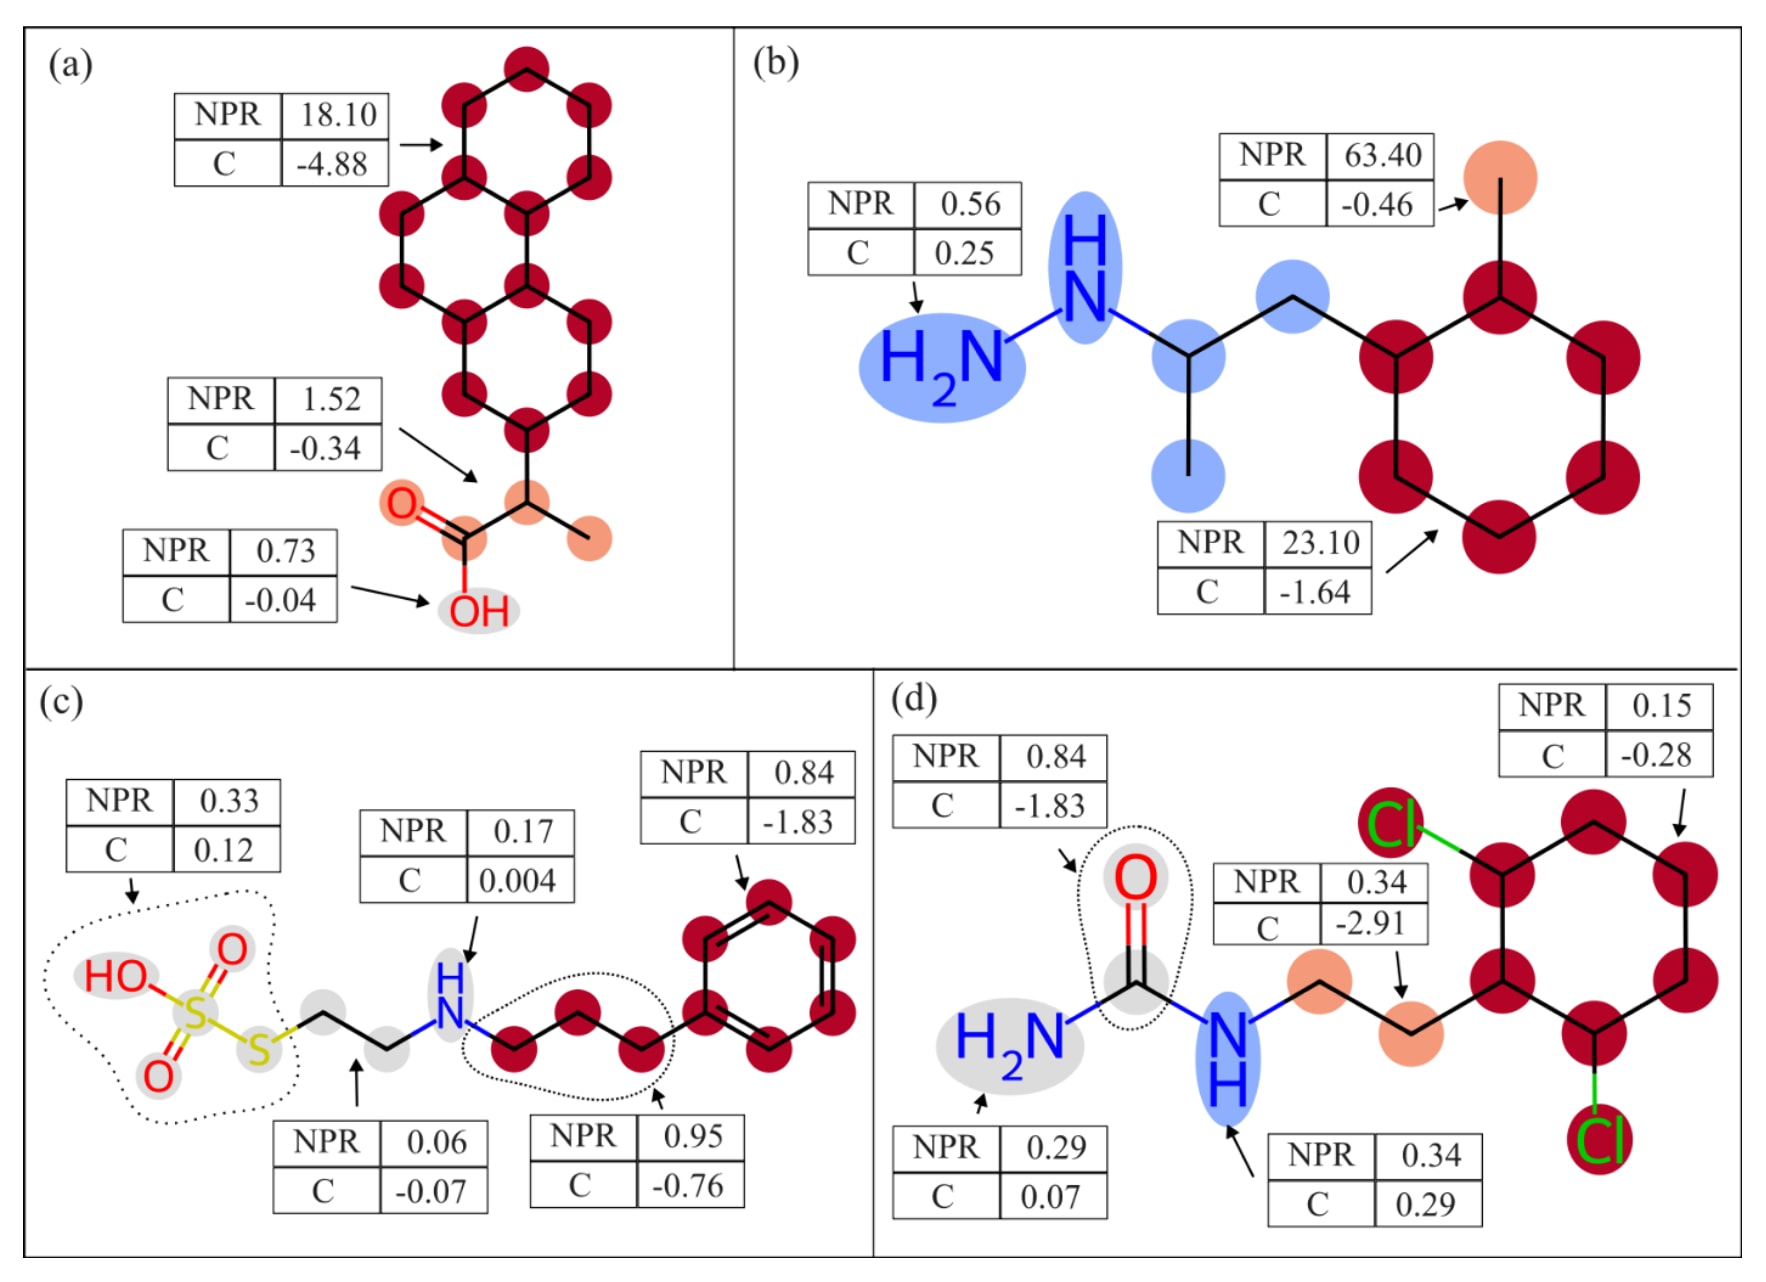
图17|分子片段的非极性/极性面积比(NPR)与贡献值(C)。 与亲水性片段相比,高疏水性片段通常具有更高的非极性比例。
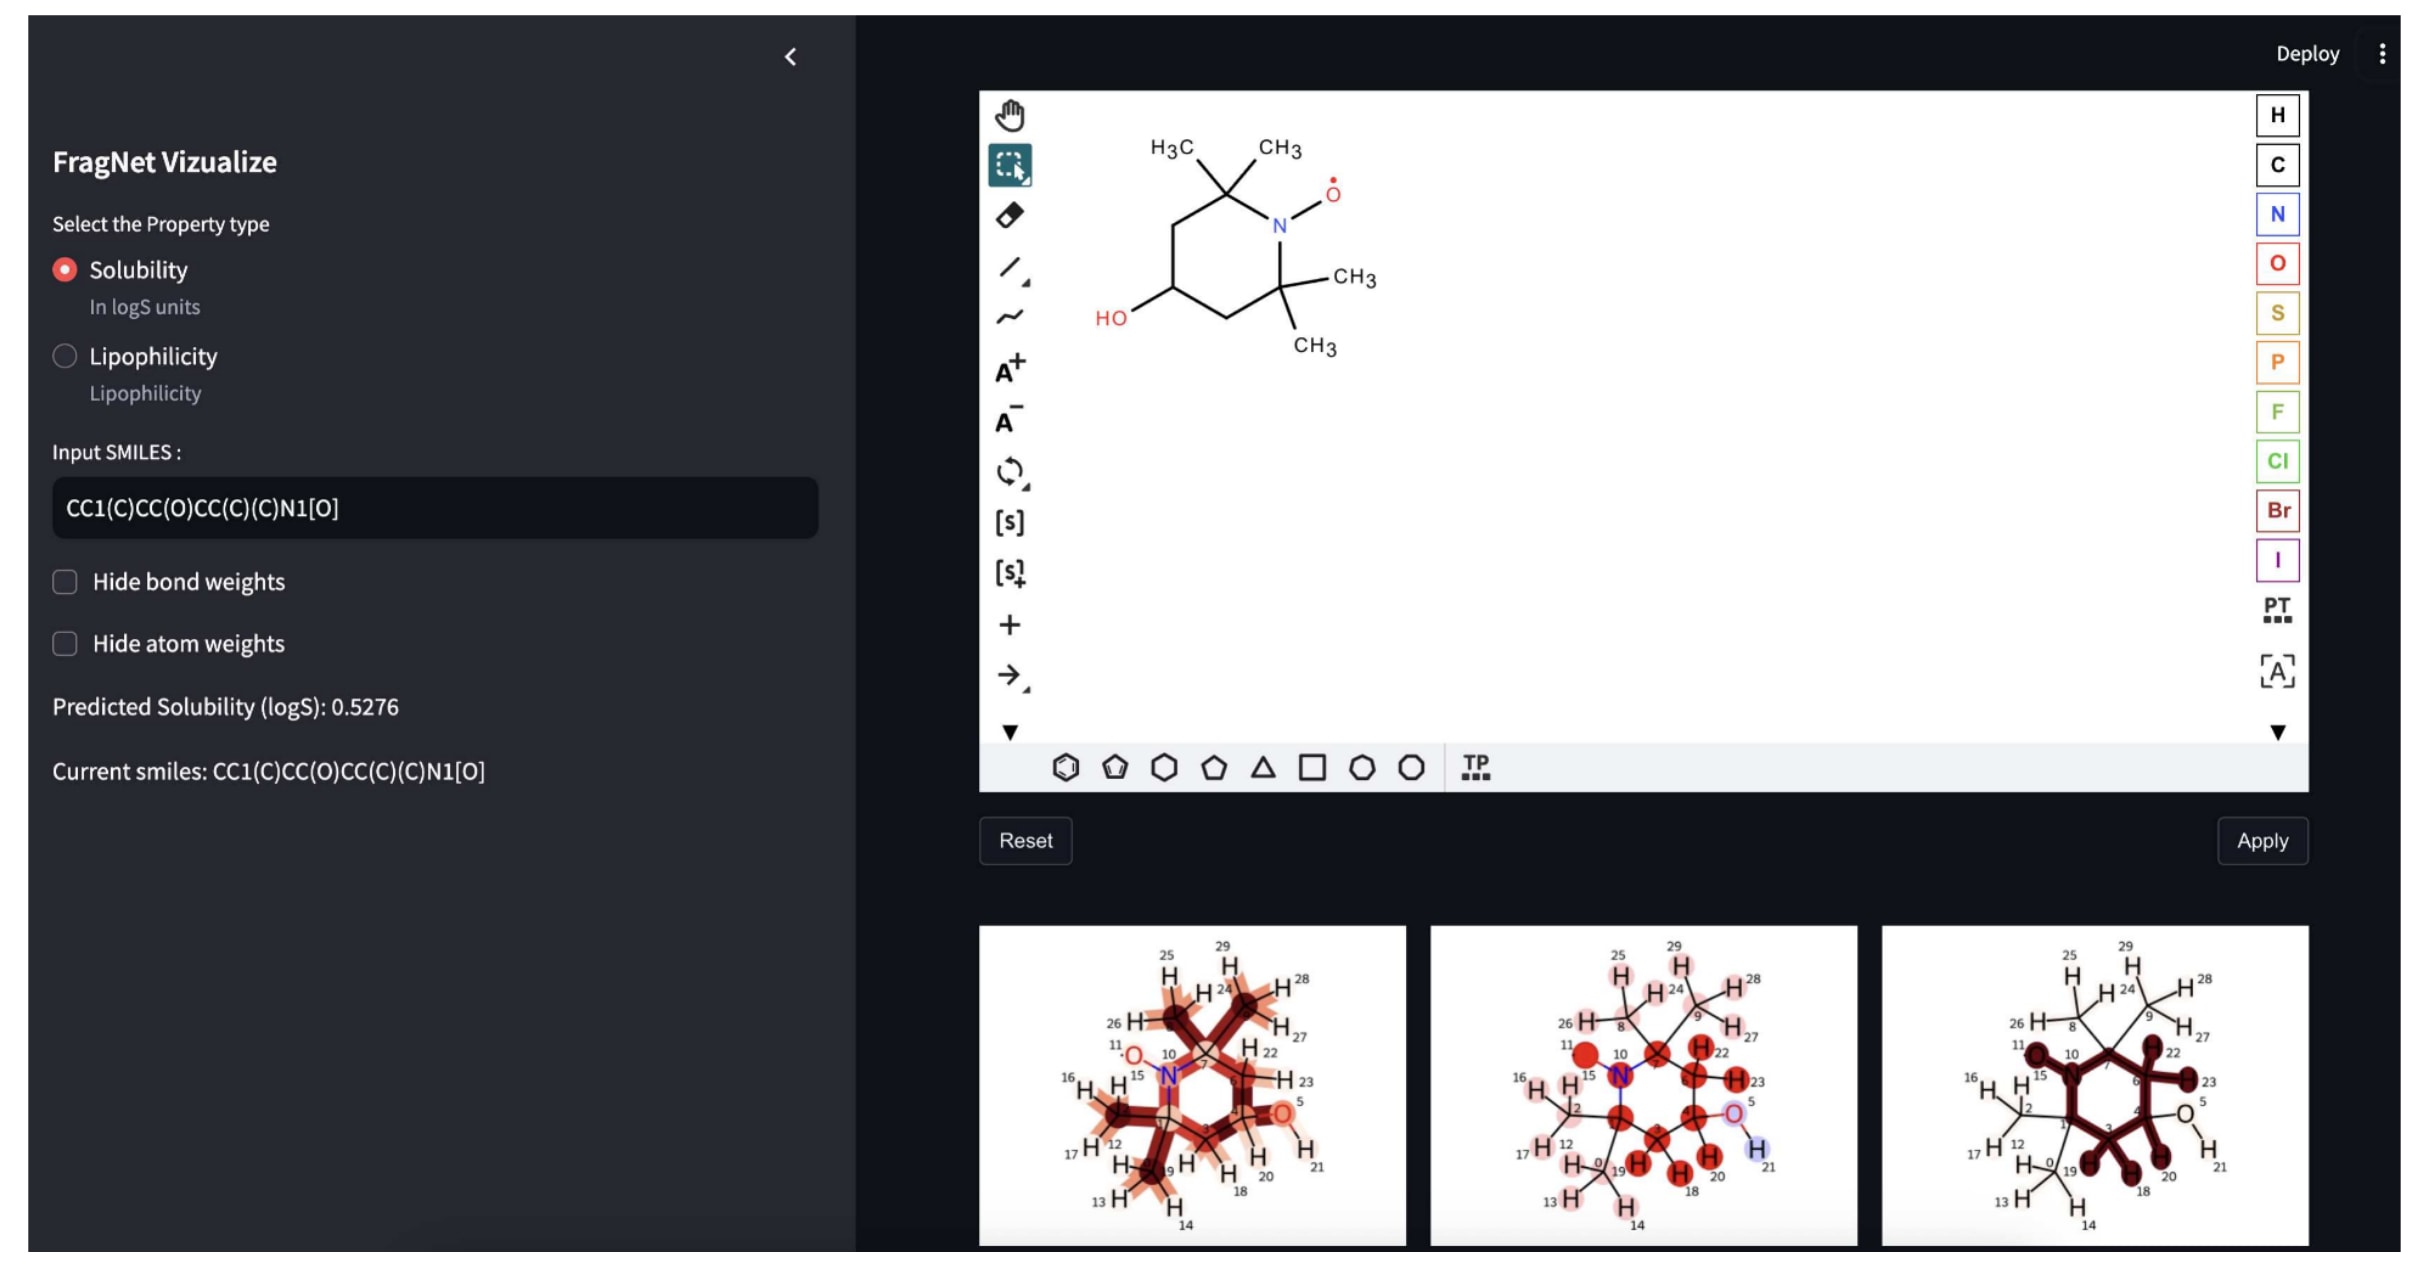
图18|交互式应用程序界面。
3.11 其他分析
3.11.1 预测不准确分子中的片段
为识别模型难以准确预测的分子片段,该研究首先选取预测误差最大的前 20% 分子,并计算这些分子中各片段的注意力权重和贡献值。随后,根据分子所包含的片段进行分类,并分别计算各片段组对应的平均预测误差、片段权重和片段贡献值。
表3按照相关分子平均预测误差的大小,对高误差分子中出现的片段进行了排序,并列出了平均误差最大的 10 类片段。为进一步筛选具有较高模型关注度的结构,仅考虑平均权重不低于 4 的片段。满足这一条件的片段包括 [*]CC[*]、[*]N[*]、[*]N([*])[*]、[*]C[*]、Cl、[*]O[*] 和 [Na+]。
值得注意的是,其中部分片段同样存在于预测准确度较高的分子中。为进一步识别主要出现在高误差分子中的片段,研究分别计算了每种片段在低误差组和高误差组分子中的出现比例。其中,低误差分子指“片段层级可解释性”部分中预测误差小于 0.1 的分子;高误差分子则指本节所定义的预测误差最大的前 20% 分子。相关结果分别列于表3的“In low err.”和“In high err.”两列。
分析结果显示,[Na+] 仅出现在高误差分子中。因此,含 [Na+] 的化合物可被视为 FragNet 当前较难准确预测的一类分子。这一发现提示,有必要进一步分析导致此类预测误差的具体原因,并针对含钠离子体系改进模型,以提升其预测性能。
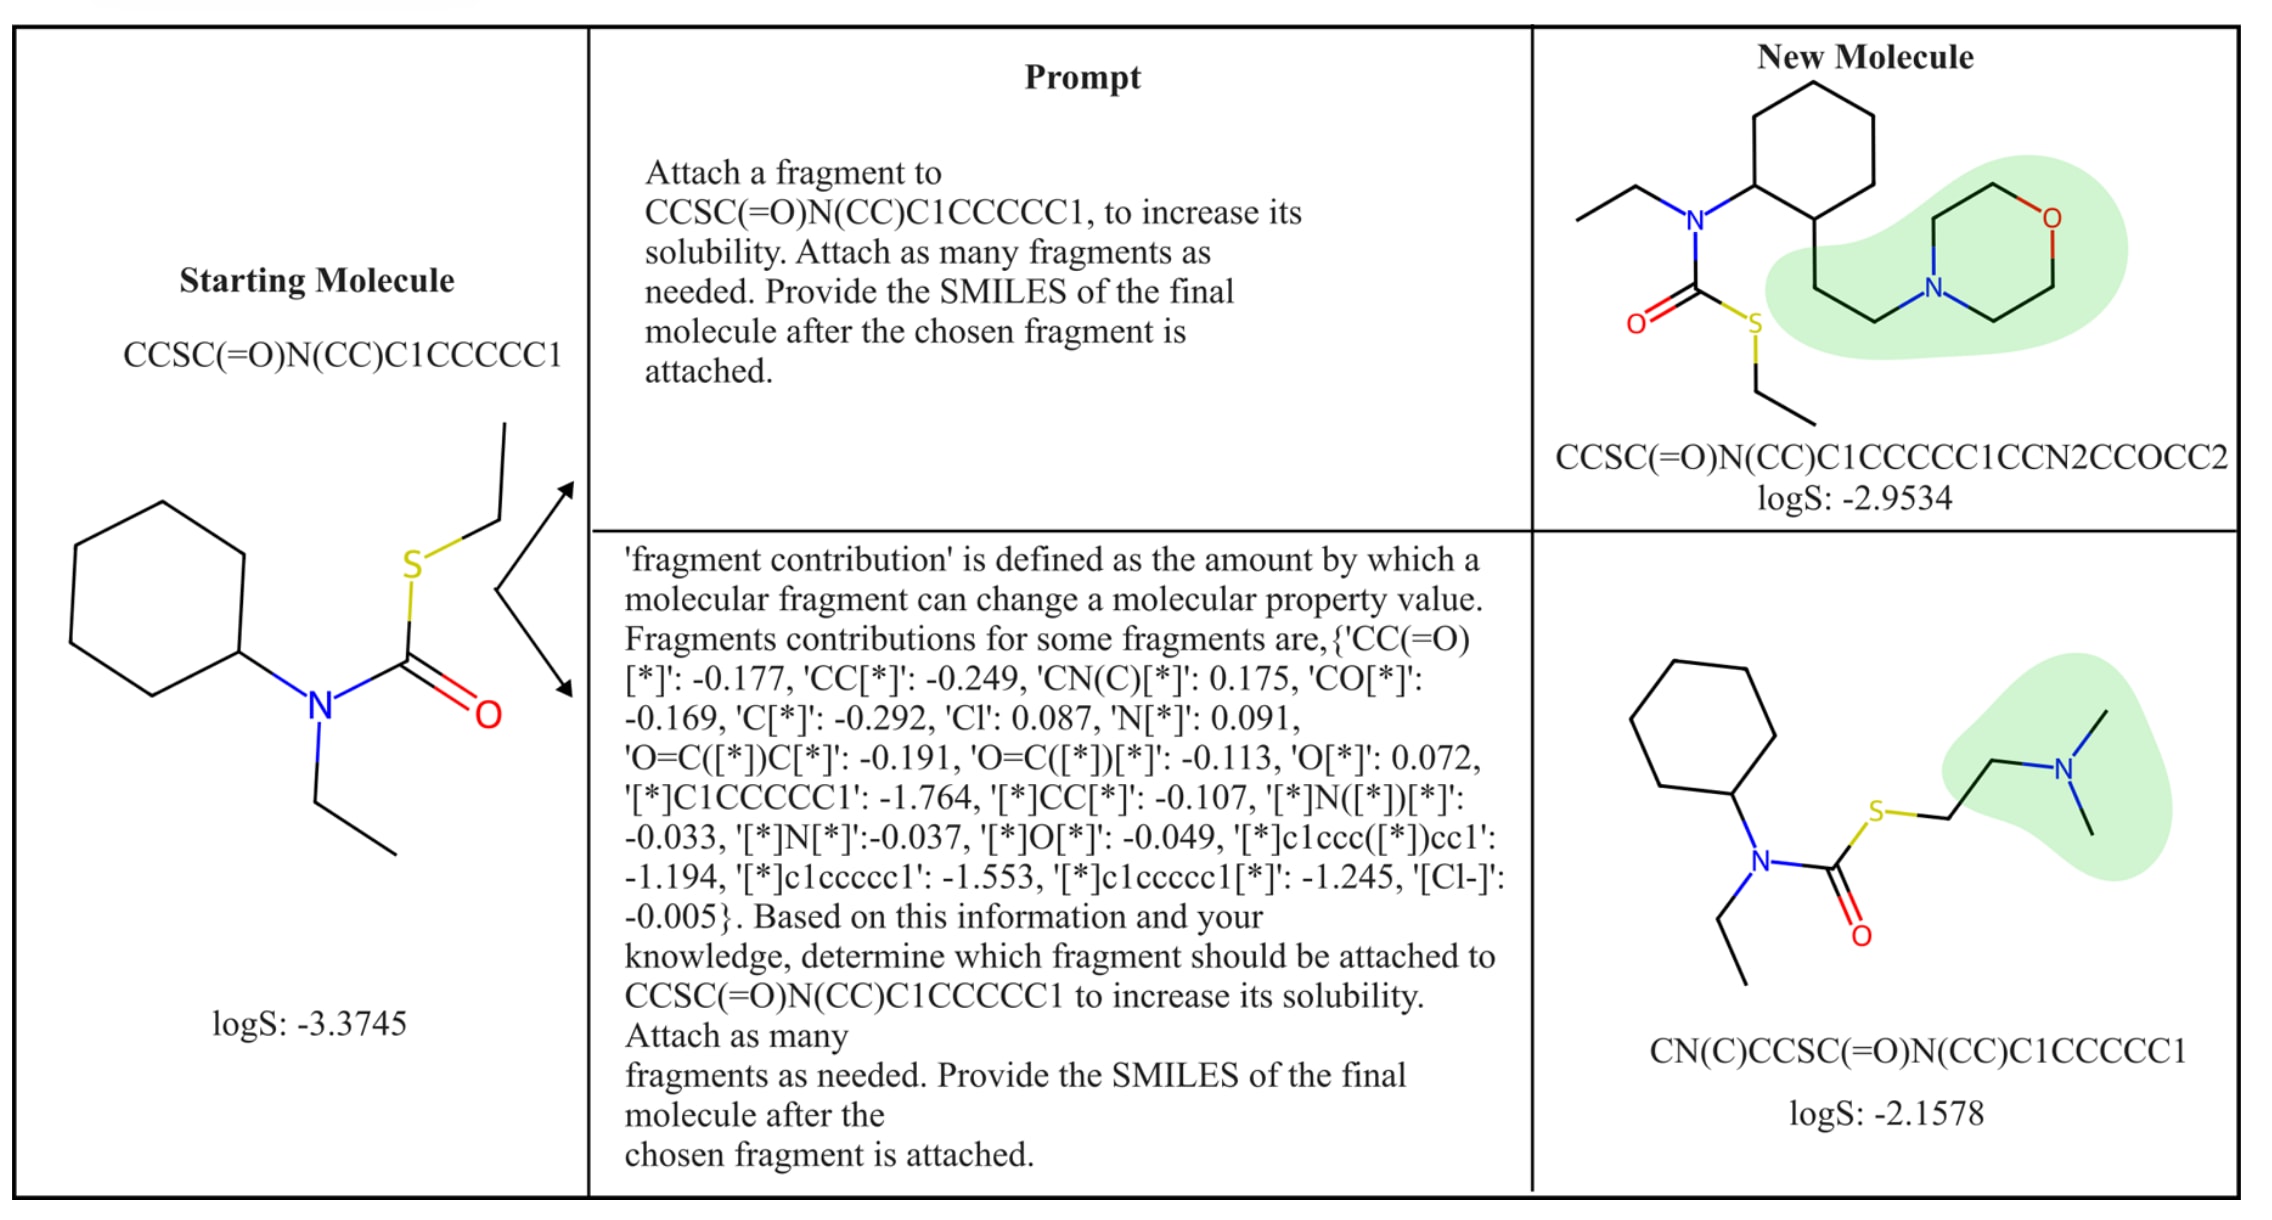
图19|结合或不结合 FragNet 贡献值数据提示 Claude 3.5 Sonnet,以生成溶解度更高的分子。 LLM 修改后分子中新引入的片段以绿色标示。
3.12 基于密度泛函理论(DFT)计算的验证
为进一步评估 FragNet 的可解释性,该研究采用密度泛函理论(Density Functional Theory,DFT)计算了模型能够高精度预测其溶解度的分子的静电表面势。DFT 计算的具体细节见补充信息。
研究将静电表面势绝对值大于 10 的区域定义为极性区域,而将静电表面势绝对值小于 10 的区域定义为非极性区域。随后,针对每个分子的各个片段,计算非极性区域面积与极性区域面积之比(nonpolar-to-polar area ratio,NPR)。较大的 NPR 表明相应片段的预期极性较低。因此,理论上具有较高 NPR 的片段应表现出较小或负向的贡献值。
如图17所示,在部分分子中确实观察到了这一趋势,而且在高度疏水的分子中尤为明显。具体而言,当分子的总 NPR 大于 1 时,其平均片段贡献值为
3.13 交互式浏览器应用
该研究还公开了一套基于网页浏览器的应用程序代码,用户可在其中编辑分子,并观察不同子结构对应的注意力权重如何发生变化(图18)。该工具主要面向教学以及小规模分子设计应用。
该应用支持采用 BRICS、Murcko 以及 BRICS+Murcko 三种碎片化策略对分子进行片段划分。目前,用户可以可视化原子、化学键和分子片段的注意力权重,以及片段贡献值。此外,应用还能够展示子结构权重以及子结构–子结构连接权重。
4 未来工作
FragNet 后续发展的一个重要方向,是在模型架构中进一步引入三维(3D)结构信息和构象柔性。这一扩展对于蛋白质–配体结合亲和力、膜通透性,以及由特定几何约束或空间位阻效应主导的分子性质建模尤其重要。
近年来,大语言模型(Large Language Model,LLM)与可解释人工智能的结合,为生成更加自然、易理解的模型解释提供了新的途径。LLM 与检索增强生成(Retrieval-Augmented Generation,RAG)、工具调用等技术结合后,可以利用大规模知识资源生成具有丰富上下文且逻辑连贯的解释。未来可进一步将 FragNet 的可解释机制与 LLM 及视觉语言模型(Vision Language Model,VLM)结合,从而生成兼具科学严谨性和易理解性的模型解释。
此外,FragNet 还可以与 LLM 结合,用于分子性质优化流程。如图19所示,FragNet 预测得到的片段贡献值可以作为提示信息输入 LLM,引导其设计具有更优目标性质的分子。
5 结论
该研究开发了一种新的图神经网络(Graph Neural Network,GNN)架构 FragNet,可从原子、化学键、分子片段以及片段连接四个层级对模型预测进行解释。据作者所知,FragNet 是首个能够在非共价连接片段之间进行消息传递的 GNN 架构,因此能够为盐类和离子液体提供更加完整的分子表示。
FragNet 的预测精度与当前先进模型总体相当。通过片段掩蔽策略,模型能够识别哪些分子片段会提高或降低目标性质,这一能力尤其适用于分子设计。基于已有化学规律的分析表明,FragNet 能够正确关注对溶解度、亲脂性和药物响应影响显著的分子片段,从而验证了该模型架构的有效性和可解释性。
FragNet 的代码已公开发布,同时还提供了基于网页的交互式应用,用户可以编辑分子,并可视化不同子结构对应的注意力权重。