Nat. Biotechnol. 2026|以实验亲和力和可开发性为基准的盲法前瞻性计算机抗体发现评测
今天介绍的是发表在 Nature Biotechnology(Nat. Biotechnol.) 上的一项抗体计算设计基准研究——《A blinded, prospective benchmark of in silico antibody discovery anchored to experimental affinity and developability》。近年来,AI 驱动的抗体设计方法快速发展,但多数工作仍主要依赖回顾性数据评估,缺乏统一、盲法且具有实验验证的前瞻性比较。该研究发起 AIntibody Challenge,汇集 29 家机构提交的 511 条 AI 设计或预测抗体,并围绕亲和力成熟、HCDR3 聚类内亲和力排序以及库外 CDR 设计三项任务展开测试。所有候选抗体均合成为完整 IgG,并通过 SPR、KinExA 及多项可开发性实验进行统一验证,为评估当前 AI 抗体设计的真实能力、优势与局限提供了一个难得的实验基准。
获取详情及资源:
- 📄 论文: https://doi.org/10.1038/s41587-026-03238-6
- 💻 代码: https://github.com/AurekaBio/Aureka-AIntibody-Challenges
0 摘要
经过实验验证的前瞻性盲测基准,对于区分计算抗体设计领域中真正具有持续价值的进展与过度宣传至关重要。AIntibody 是一项受蛋白质结构预测关键评估(CASP)启发的挑战赛,共收集来自 29 个机构的 511 个由人工智能设计或预测的抗体,并围绕三项任务进行测试:基于第一阶段测序结果开展计算机辅助亲和力成熟;在筛选结果中的重链互补决定区 3(HCDR3)聚类内部进行亲和力排序;以及针对未包含在筛选结果中的蛋白质开展 CDR 设计。
通过多种实验方法进行验证后发现,部分团队能够设计出亲和力低于 100 pM、同时具有良好可开发性的抗体。然而,这类成功案例仍然较少,而且并不能稳定迁移到不同任务中。对于亲和力成熟后的抗体,模型整体表现较好。
相比之下,在基于 HCDR3 聚类的数据集中预测高亲和力克隆时,除一个模型外,其余方法的表现均低于随机挑选克隆。对于库外抗体设计,不同方法之间的性能波动很大,许多方法甚至未能超过标准筛选流程。
AIntibody 挑战表明,人工智能已经能够在特定且具有明确生物学约束的场景中有效优化抗体;与此同时,该基准也揭示出当前方法仍存在若干关键短板,包括亲和力预测、受抗体文库启发的抗体设计,以及跨任务泛化能力不足等问题。
1 引言
在计算生物学领域,基准测试对于区分真正具有持续价值的方法进展与缺乏独立实验验证的研究主张至关重要。当前瞻性、盲法评测与实验测量结果直接挂钩时,不仅能够建立统一的评价标准,还可以暴露方法的局限性,并推动模型和算法持续迭代改进。蛋白质结构预测关键评估(Critical Assessment of Structure Prediction,CASP)为这一评价模式树立了典范,并最终促成 AlphaFold 在 CASP XIII 中取得突破性进展,以及随后证明其接近实验精度的预测能力能够泛化至评测集之外。CASP 在多轮评测中覆盖了数百个不同类型的蛋白质靶标,并采用独立的组织和管理机制。类似的基准挑战还包括 D3R、SAMPL、Adaptyv 和 CACHE。
尽管计算抗体设计研究近年来发展迅速,目前大多数性能基准仍主要依赖回顾性分析,缺少进一步的实验验证。此前已有研究指出,这种评价方式限制了外部验证,也使该领域真正的先进水平难以被准确判断。因此,盲法、前瞻性评估应成为开展有效性能评价的重要前提。随着计算抗体设计方法数量不断增加,尤其是大量方法首先以未经同行评议的预印本和技术报告形式发布,这一问题变得更加突出。
为弥补这一缺口,研究团队发起了 AIntibody 挑战赛。AIntibody 借鉴了 CASP 前瞻性、盲法评测的理念,但二者仍存在重要区别。例如,AIntibody 首轮评测仅针对一个抗原,由当前报告结果的同一研究联盟组织,并且其盲法主要依赖组织者诚信,而非通过信息学机制进行技术性隔离。因此,AIntibody 更适合作为建立 CASP 级别抗体发现基准体系的第一步,后续评测仍需进一步解决这些结构性局限。
通过将评价结果直接锚定于实验测定的亲和力和可开发性,AIntibody 以及近期其他类似工作,例如不局限于抗体的 Adaptyv EGFR binder competition,为该领域提供了更加贴近实际的性能检验,同时也公开了相关测序数据集,为后续开展比较性基准研究提供基础。
与蛋白质结构预测主要寻求单一几何结构解不同,治疗性抗体工程本质上属于多参数优化问题,而且这些性质最终只能通过实验进行可靠评估。除亲和力和结合动力学外,还需要考虑一系列通常归为“可开发性(developability)”的性质,包括表达水平、熔解温度(
与互联网文本不同,氨基酸序列并不是一种能够直接从表面“读懂”功能的语言。仅凭抗体序列,人类无法在缺乏额外实验的情况下准确推断其功能和药理学性质。此外,抗体序列数据本身具有明显偏倚,在大规模数据集中,大多数位点出现频率最高的残基通常对应种系序列。主要例外是重链和轻链的第三互补决定区(CDR3),这些区域由 V(D)J 重排、随机核苷酸插入或缺失以及体细胞高频突变共同产生。
这与自然语言存在一个重要区别:在抗体序列中,统计上最常见的“token”往往并不是提高亲和力的最优选择。因此,抗体模型的训练数据必须依赖成本高昂且耗时的实验测定,而无法像文本或图像模型那样利用海量、可由人类直接标注和解释的数据。要准确预测抗体亲和力变化,可能需要比目前规模高出数个数量级、且具有高度多样性的实验数据。
遗憾的是,这类抗体发现数据往往分散在不同机构内部,并受到知识产权限制,而且通常缺乏机器可读格式。尽管已有大量工作致力于构建公共数据资源,目前公开抗体数据集的规模仍然相对有限,同时在数据组成上存在明显偏倚。
AIntibody 被设计为一项前瞻性、盲法评测。所有设计得到的抗体序列均被合成为完整 IgG,并由独立实验室在统一实验流程下进行测试,包括采用高通量表面等离子体共振(high-throughput surface plasmon resonance,HT-SPR)和 KinExA 测定亲和力,以及利用标准化的五项实验体系评价抗体可开发性。与回顾性研究不同,这种设计可以在完全一致的实验条件下直接比较不同计算建模策略的输出结果。
其中,两项挑战——亲和力成熟和命中抗体识别——直接对应当前抗体发现与优化流程,而第三项任务则代表一种受限形式的从头抗体设计。其核心问题是:在提供实验测序数据的情况下,能否通过修改 CDR 或不同 CDR 组合,进一步设计出性能更优的抗体?
首届 AIntibody 挑战选择 SARS-CoV-2 受体结合域(receptor-binding domain,RBD)作为抗原。RBD 是目前研究最充分的蛋白质之一,具有极为丰富的结构和序列数据,因此有利于最大程度提高计算方法成功的可能性。为进一步降低计算设计难度,该挑战提供的测序数据集在深度和信息丰富度方面均高于常规抗体发现流程相应阶段通常能够获得的数据;此外,第二项和第三项挑战还额外提供了实验测定的亲和力数据,而这些信息通常只有在实际研发流程更后期才能获得。
因此,这些结果更适合被视为当前计算方法在该类靶标上的能力上限,而不能作为其能够在任意抗原或任意数据条件下实现通用性能的证据。
2 结果
AIntibody 挑战共设置了三项任务。
第一项任务为亲和力成熟。研究者获得一次亲和力成熟筛选最终分选产物的测序数据,其中序列多样性分别位于 LCDR1 + LCDR2、LCDR3 以及 HCDR1 + HCDR2 区域。在此基础上,要求生成具有高亲和力和良好可开发性的抗体序列。设计过程中仅允许修改 HCDR1、HCDR2 以及 LCDR1–LCDR3,不允许修改 HCDR3 或抗体框架区。
第二项任务为高亲和力抗体预测。研究者获得经过 HCDR3 聚类的筛选结果测序数据,需要在三个已确定的 HCDR3 聚类中,分别识别出亲和力最高且具有良好可开发性的抗体序列。
第三项任务为库外 CDR 设计。研究者获得第二个数据集的完整筛选结果,并需要通过修改 CDR、但保持框架区不变的方式,生成未出现在原始数据集中的高亲和力、可开发抗体序列。
下文分别给出了三项挑战的具体结果。除挑战获胜者外,所有参与机构均使用匿名挑战编号(masked ID)表示。ProBioGen 是一个例外,该机构同意公开身份,具体原因将在后文说明。对于某些在一项挑战中获胜、但在其他挑战中未取得成功的算法,也公开了其身份,以便进一步分析不同任务之间的跨挑战表现。
不同机构和提交方案所采用的计算方法,在“方法”部分对获胜方案进行了简要介绍,其余方法详见补充说明。所有挑战中的提交结果均按照“paper ID”进行区分,并与对照组、亲和力测定结果和可开发性评价结果一并汇总于补充数据中。
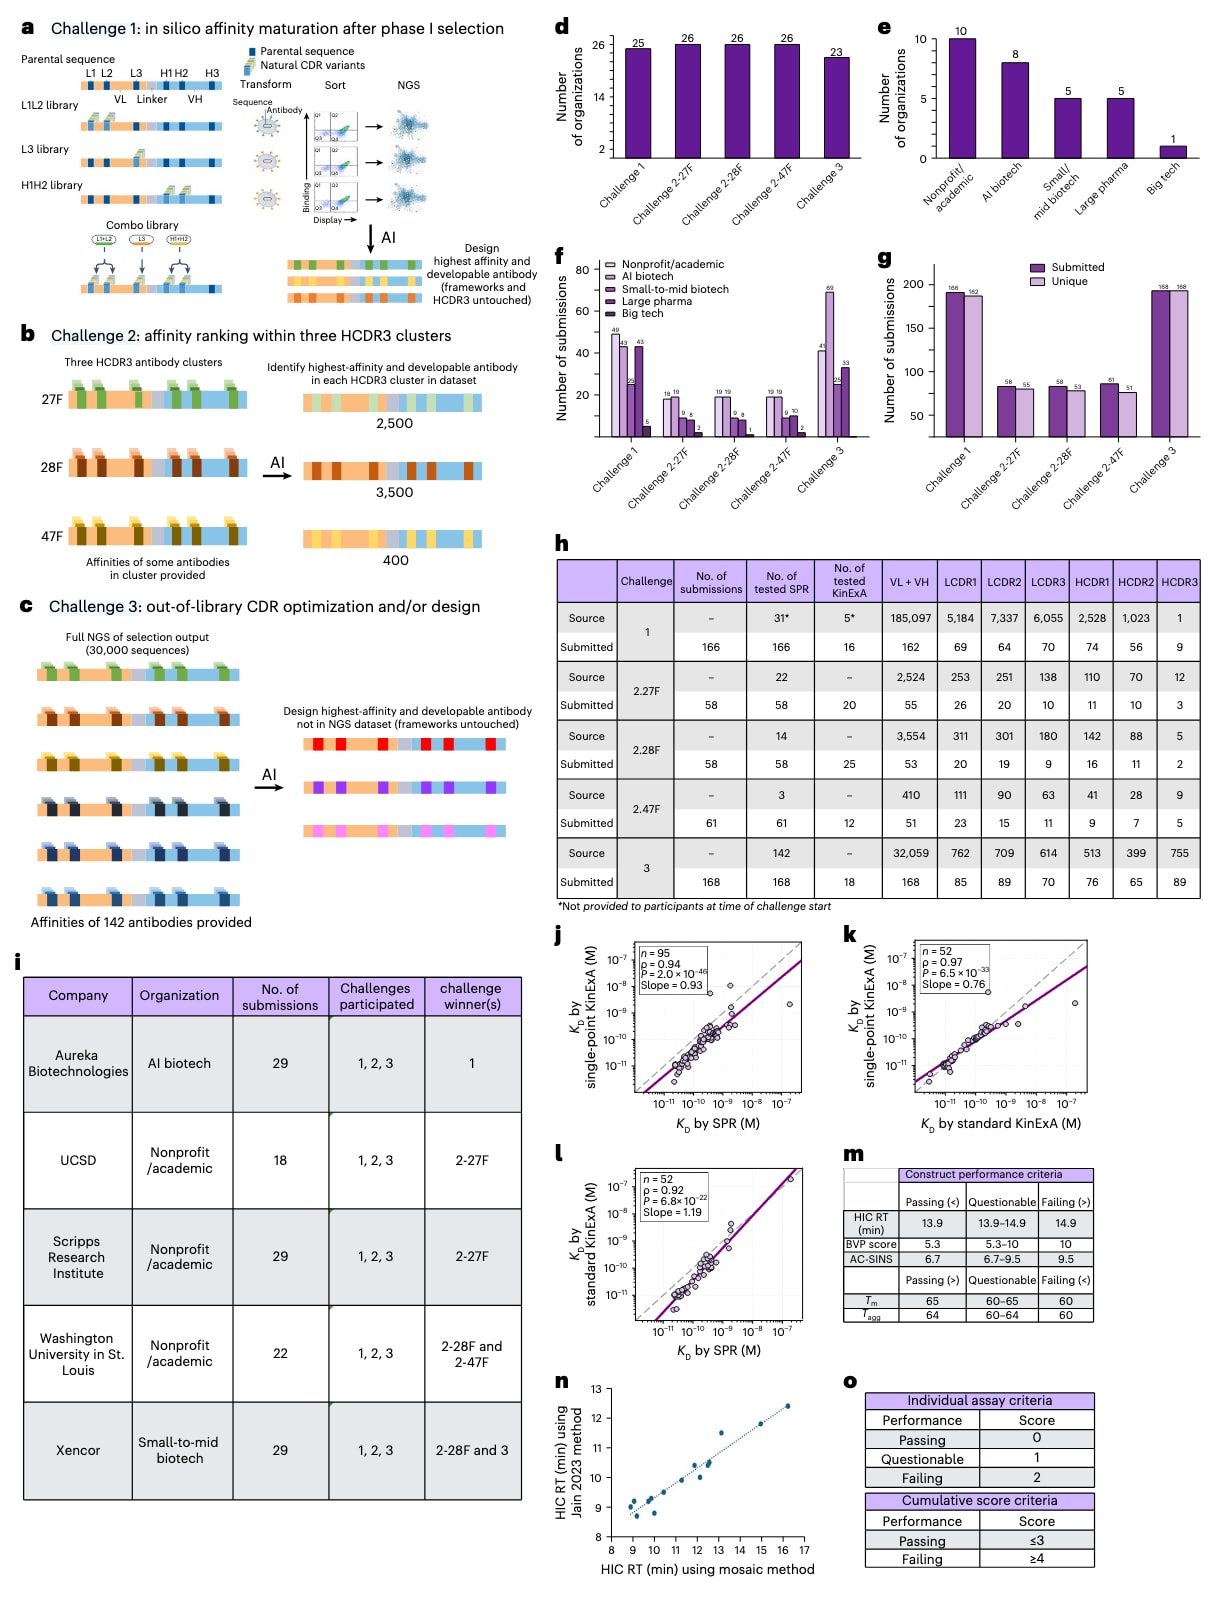
图1|整体提交情况。 a–c,三项挑战的总体流程示意图:a,挑战 1——第一阶段筛选后的计算机辅助亲和力成熟(设计与优化);b,挑战 2——基于三个 HCDR3 聚类的亲和力排序(预测);c,库外 CDR 优化和/或设计(设计与优化)。d,29 家参与机构在三项挑战中的分布,包括:(1)计算机辅助亲和力成熟;(2)聚类约束下的亲和力排序;(3)从头库外 CDR 设计。e,按照机构类型对参与者进行分类,包括学术或非营利实验室(
图1d显示了各项挑战中参与机构的数量。图1e进一步按照机构类型对参与者进行分类,图1f则展示了全部 511 条抗体序列提交结果在不同挑战和机构类型之间的分布。其中,AI 生物技术公司在挑战 3 中提交的序列数量最多。
在挑战 1,即亲和力成熟任务中,有 2.5% 的可变轻链–可变重链(VL–VH)氨基酸序列被两个或多个团队独立提交,说明不同方法之间的设计结果总体上很少发生趋同。
最高的序列重复率出现在预测任务中,约为 5%–16%。这一现象与该任务本身的搜索空间受到限制有关,因为每个 HCDR3 聚类仅包含 410–3,554 条候选序列。
相比之下,在库外 CDR 设计任务,即挑战 3 中,没有出现完全相同的提交序列(图1g)。这一结果与该任务极大的可设计序列空间相符,同时也可能反映了不同算法之间的差异、生成式采样本身的随机性,或者二者共同作用的结果。
图1h汇总了各项挑战中提交序列的总数、采用表面等离子体共振(SPR)和动力学排除实验(KinExA)进行测试的序列数量,以及不同区域对应的唯一氨基酸序列数量。部分提交结果由于未遵守挑战公告中规定的规则而被取消资格。
图1i概括展示了五个子竞赛的获胜结果,具体内容将在后文进一步介绍。其中,预测类挑战产生了多个获胜者。
需要指出的是,尽管构建这些数据集时采用的是单链可变片段(single-chain variable fragment,scFv)形式,但最终抗体均以完整 IgG 形式进行表达和实验测试。
2.1 检测方法一致性与可开发性评价框架
所有提交的 IgG 首先采用表面等离子体共振(SPR)进行亲和力测定,随后对亲和力最高的抗体进一步采用单点 KinExA 进行排序,并使用标准 KinExA 进行测定。结果显示,SPR 与单点 KinExA 之间具有较强的排序相关性(
虽然最终获胜序列主要依据亲和力确定,但同时还必须达到规定的可开发性阈值。每个抗体均接受五项可开发性检测,包括亲和捕获自相互作用纳米颗粒光谱(affinity-capture self-interaction nanoparticle spectroscopy,AC-SINS)、杆状病毒颗粒(baculovirus particle,BVP)多反应性检测、疏水相互作用色谱(hydrophobic interaction chromatography,HIC)保留、熔解温度(
根据临床阶段参考抗体的指标范围,每项检测分别赋予通过(0 分)、存疑(1 分)或失败(2 分)的评分。随后将五项检测的得分相加:综合评分
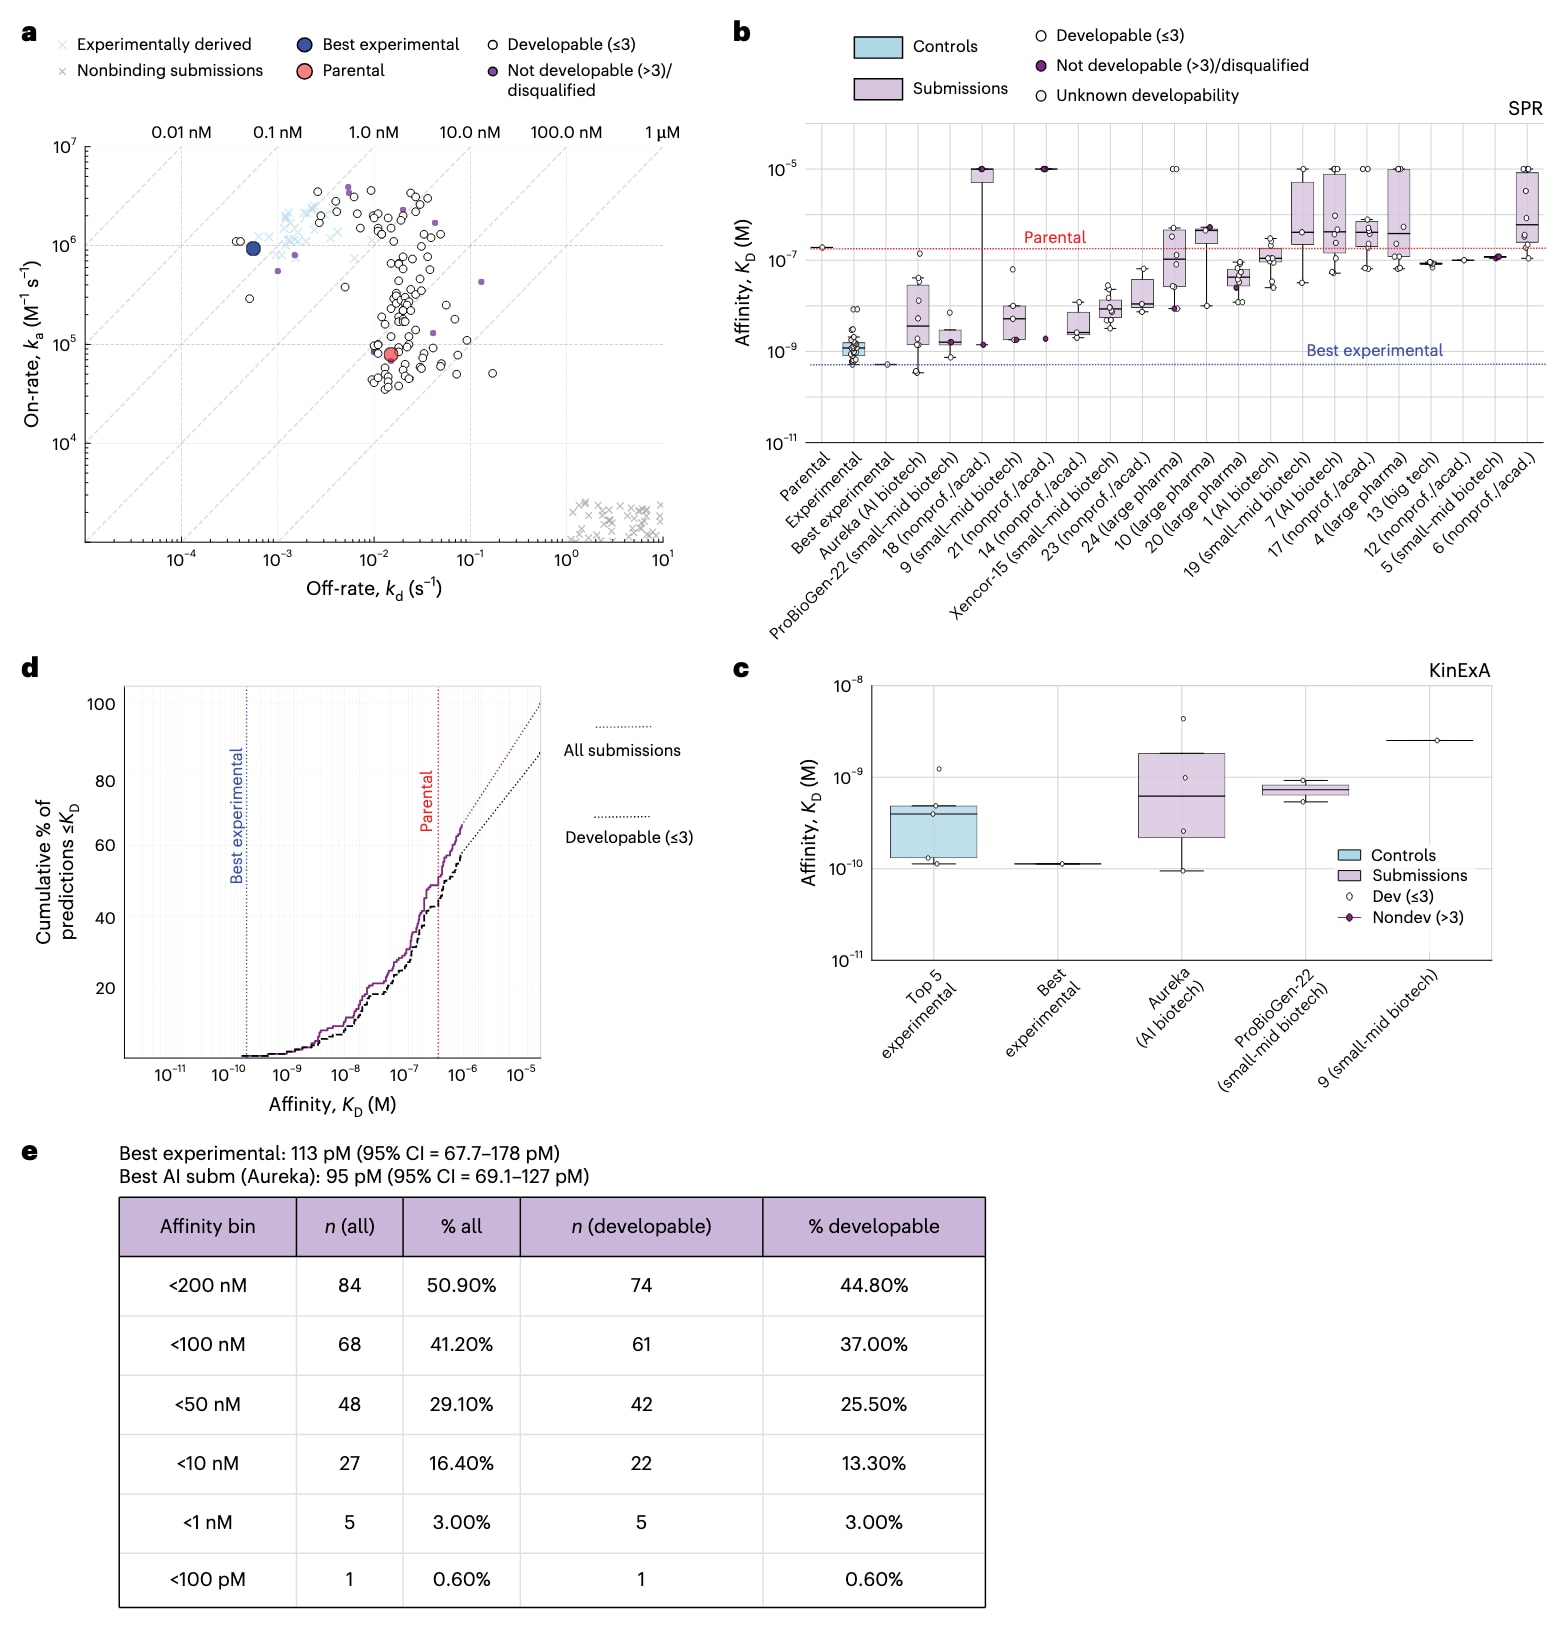
图2|亲和力成熟挑战及获胜方法概览。 a,挑战 1 中所有 AI 提交抗体序列的 SPR 等亲和力图,横纵坐标分别对应结合速率和解离速率。各数据点按可开发性状态着色:通过(
2.2 挑战 1:第一阶段筛选后的计算机辅助亲和力成熟
该任务的目标是在不损害可开发性的前提下,对一株识别 SARS-CoV-2 RBD 的亲本抗体进行计算机辅助亲和力成熟。所提供的数据来自已发表亲和力成熟流程的第一阶段:通过酵母展示,从 HCDR1、HCDR2、LCDR1、LCDR2 和 CDR3 文库中筛选得到亲和力改善的抗体 CDR 序列,并获得相应测序数据(图1a)。除亲本抗体外,参与者没有获得其他抗体的亲和力数据。
所有 AI 设计抗体首先通过 SPR 测定亲和力,相应的等亲和力图见图2a。图中同时标出了亲本抗体、实验亲和力成熟抗体以及最佳实验抗体的亲和力,并区分了满足可开发性标准(评分
所有 AI 抗体的 SPR 亲和力以箱线图结合抖动散点图的形式展示于图2b。不同机构按照其最佳设计抗体的亲和力排序,并与实验获得的抗体进行比较。总体来看,AI 抗体的亲和力分布,例如四分位距(interquartile range,IQR),明显逊于实验获得的抗体,但最佳计算设计抗体的 SPR 亲和力达到 340 pM,而最佳实验抗体为 517 pM。
前五名实验抗体的 KinExA 亲和力范围为 113–1,230 pM,其中 113 pM 抗体的 95% 置信区间为 67.7–178 pM;前五名 AI 抗体的 KinExA 亲和力范围为 95–984 pM,其中 95 pM 抗体的 95% 置信区间为 69.1–127 pM。二者的 95% 置信区间存在重叠,说明这些亲和力数值在统计上无法区分。
图2d展示了所有设计抗体以及其中可开发抗体的累积亲和力分布,亲和力分别采用 SPR 或 KinExA 测定,图中的垂直线表示亲本抗体和最佳实验抗体的亲和力。图2e进一步给出了更详细的结果,显示大多数设计抗体的亲和力均优于亲本抗体,同时能够满足可开发性要求。前五名实验抗体和 AI 抗体也均具有良好的可开发性。
六个 CDR 的序列 logo 对亲本抗体、高亲和力结合抗体、低亲和力结合抗体和不结合抗体进行了比较。最高亲和力抗体中出现了若干特定序列基序,例如 LCDR1 第 6 位的酪氨酸和 LCDR3 第 8 位的色氨酸,提示关键残基替换可能显著提高亲和力。基于所提供的数据,部分 AI 算法能够识别这些关键替换,并将其纳入有效设计中。
最终排名前十的设计首先按照 KinExA 亲和力排序,其次按照 SPR 亲和力排序,并按照匿名 ID 给出完整排名。因可开发性较差或未遵守挑战规则而被取消资格的提交结果仍保留在列表中,但不参与正式排名。
为评估生成序列的新颖性,进一步计算了排名前 20 家机构最佳提交序列相对于亲本抗体和实验数据集中序列的 Levenshtein 距离(LD)。其中,Aureka 的获胜序列具有较高的新颖性:将全部 CDR 串联后,与亲本抗体相比存在 19 个残基替换,与实验数据集中任意序列相比至少存在 12 个替换。其他表现较好的设计则相对保守,与亲本抗体的串联 CDR 距离为 2–15 个替换,与实验数据集中序列的距离为 1–9 个替换。
此外,还构建了一个 CDR 共识序列,即分别从各 CDR 文库的分选群体中选取每个位点出现频率最高的残基。与这一共识序列比较后发现,ProBioGen 的一个提交序列(ID 22)在全部六个 CDR 上与共识序列完全一致(LD = 0)。该序列在 KinExA 评估中总体排名第三,亲和力为 540 pM,并获得了 0 分的最佳可开发性评分。ProBioGen 表示,其方法并非基于 AI,而本质上是根据测序数据构建共识序列。这一结果说明,即使不使用机器学习,仅通过对筛选数据进行统计分析,也足以在挑战 1 中获得性能领先的抗体设计。
在来自 25 家机构的 165 个提交序列中,共有 118 个(71.5%)能够结合 RBD,47 个(28.5%)为不结合抗体。其中,22 个(13.3%)达到个位数 nM 亲和力,5 个(3.0%)达到亚纳摩尔亲和力,1 个(0.6%)达到低于 100 pM 的亲和力。总体有 86.1% 的提交通过可开发性评价,中位综合评分为 1;13.9% 因可开发性评分
最终,Aureka 的获胜抗体达到 95 pM 亲和力,相比亲本抗体提高约 2,000 倍。该获胜方案的具体方法见扩展数据图 1e 和补充说明 2。
2.3 挑战 2:三个 HCDR3 聚类内的亲和力排序
该预测任务的目标是在三个 HCDR3 聚类(27F、28F 和 47F)中,分别识别亲和力最高且具有良好可开发性的抗体。三个聚类均由共享或相似 HCDR3 的抗体组成,来源于一个半合成抗体文库的 RBD 结合筛选结果。该文库将与种系匹配的天然和突变 CDR 嵌入具有良好可开发性的治疗性抗体骨架中,并提前去除具有潜在序列风险的设计。三个聚类分别包含 2,524 条(27F)、3,554 条(28F)和 410 条(47F)唯一序列,在 CDR 区域具有不同程度的序列多样性,同时表现出不同的可开发性特征。
挑战赛向参与者提供了部分抗体的亲和力数据,其中 27F、28F 和 47F 聚类分别提供 22、14 和 3 个抗体的亲和力信息。这些已知序列中包括“聚类对照(cluster control)”,即各聚类中丰度最高的序列。该序列通常能够结合靶标,但并不一定具有最高亲和力。
对各团队预测的抗体首先采用 SPR 测定亲和力。结果显示,27F 聚类中许多提交抗体相较于聚类对照具有更慢的解离速率,而结合速率总体相近;28F 聚类的性能改善则更多表现为结合速率提高;47F 聚类整体改善较小,仅少数提交序列表现出明显优势。虽然三个聚类的对照抗体均具有
针对每个聚类,按照亲和力由强到弱对排名前 20 家机构的提交结果进行箱线图和抖动散点图展示,并分别比较 SPR 和 KinExA 结果与对应聚类对照。结果表明,在单个 HCDR3 聚类内部准确预测高亲和力且具有良好可开发性的抗体仍然具有较大挑战,其中 28F 聚类尤为困难。同时,这些结果再次表明,HCDR3 聚类本身与可开发性具有较强关联。
此前研究表明,聚类对照通常能够结合靶标,但并不一定是聚类中最佳抗体,随机挑选的克隆中约有 30% 可以获得更高亲和力。在该挑战中,27F、28F 和 47F 聚类中分别只有 10.3%、13.8% 和 9.8% 的提交序列亲和力优于聚类对照。
其中,27F 聚类最佳预测抗体的亲和力达到 9.2 pM,相比聚类对照的 36.6 pM 提高 4.0 倍;47F 聚类取得最大幅度提升,最佳预测抗体亲和力达到 50 pM,相比聚类对照的 378 pM 提高 7.6 倍;28F 聚类的改善则相对有限,最佳结果为 101 pM,相比聚类对照的 177 pM 仅提高 1.8 倍。每个聚类均进一步给出了亲和力排名最高的预测结果,同时标注因可开发性不足或违反序列规则而被取消资格的提交。
进一步比较排名靠前的预测序列与聚类对照之间的 Levenshtein 距离(LD)。在 27F 聚类中,获胜预测来自加州大学圣地亚哥分校(UCSD)和 Scripps,两者使用了与聚类对照完全相同的 HCDR3,而串联所有 CDR 后仅相差 1 个氨基酸替换。虽然该 HCDR3 聚类中还存在另外两种 HCDR3,但所有排名靠前的提交均选择了聚类对照对应的 HCDR3。
相比之下,28F 聚类的两家并列获胜团队采用了不同策略。Xencor 预测了一条与聚类对照差异较大的序列,其串联 CDR 的 LD 为 12,HCDR3 的 LD 为 4;WashU 的预测则更加接近丰度最高的克隆,串联 CDR 的 LD 为 2,HCDR3 的 LD 为 0。
在 47F 聚类中,唯一获胜者 WashU 预测了一条高度不同的序列,相比聚类对照,其串联 CDR 的 LD 达到 26,HCDR3 的 LD 为 8,明显超出了其他较保守预测的序列差异范围。
值得注意的是,除一种 AI 预测策略外,其余方法在识别高亲和力抗体方面均不如随机挑选。所有 AI 提交中仅有 9.8%–13.8% 的序列优于聚类对照,而各获胜团队对应的比例为 11%–50%;相比之下,随机挑选克隆中有 39% 能够优于聚类对照。对于大多数参与者而言,使用 AI 模型选择抗体反而不如“选择丰度最高克隆,再额外随机挑选若干克隆”这一简单基线策略。
在所有团队中,仅 WashU 的 D.H.F. 实验室整体超过随机选择基线,其成功率为 50%,而随机基线为 39%。此外,没有任何一个获胜算法能够在所有 HCDR3 聚类中都保持良好的预测性能,说明当前 AI 亲和力预测方法的跨聚类泛化能力仍然有限。
对于 27F 聚类,共有 26 家机构提交 58 条序列,其中 57 条(98.3%)能够结合 RBD,1 条(1.7%)不结合。共有 12 条(20.7%)达到个位数 nM 亲和力,44 条(75.9%)达到亚纳摩尔亲和力,14 条(24.1%)达到低于 100 pM 的亲和力。79.3% 的提交通过可开发性评价,中位评分为 2;20.7% 因可开发性评分
对于 28F 聚类,同样有 26 家机构提交 58 条序列,其中 57 条(98.3%)能够结合 RBD,1 条(1.7%)不结合。共有 10 条(17.2%)达到个位数 nM 亲和力,44 条(75.9%)达到亚纳摩尔亲和力,2 条(3.4%)达到低于 100 pM 的亲和力。41.4% 的提交因可开发性较差而被取消资格,判定标准为可开发性评分
对于 47F 聚类,共有 26 家机构提交 61 条序列,其中 59 条(96.7%)能够结合 RBD,2 条(3.3%)不结合。共有 19 条(31.1%)达到个位数 nM 亲和力,17 条(27.9%)达到亚纳摩尔亲和力,1 条(1.6%)达到低于 100 pM 的亲和力。所有提交序列均通过可开发性评价,中位评分为 1。最终,WashU 的获胜抗体达到 50 pM 亲和力,相比聚类对照提高 7.6 倍。
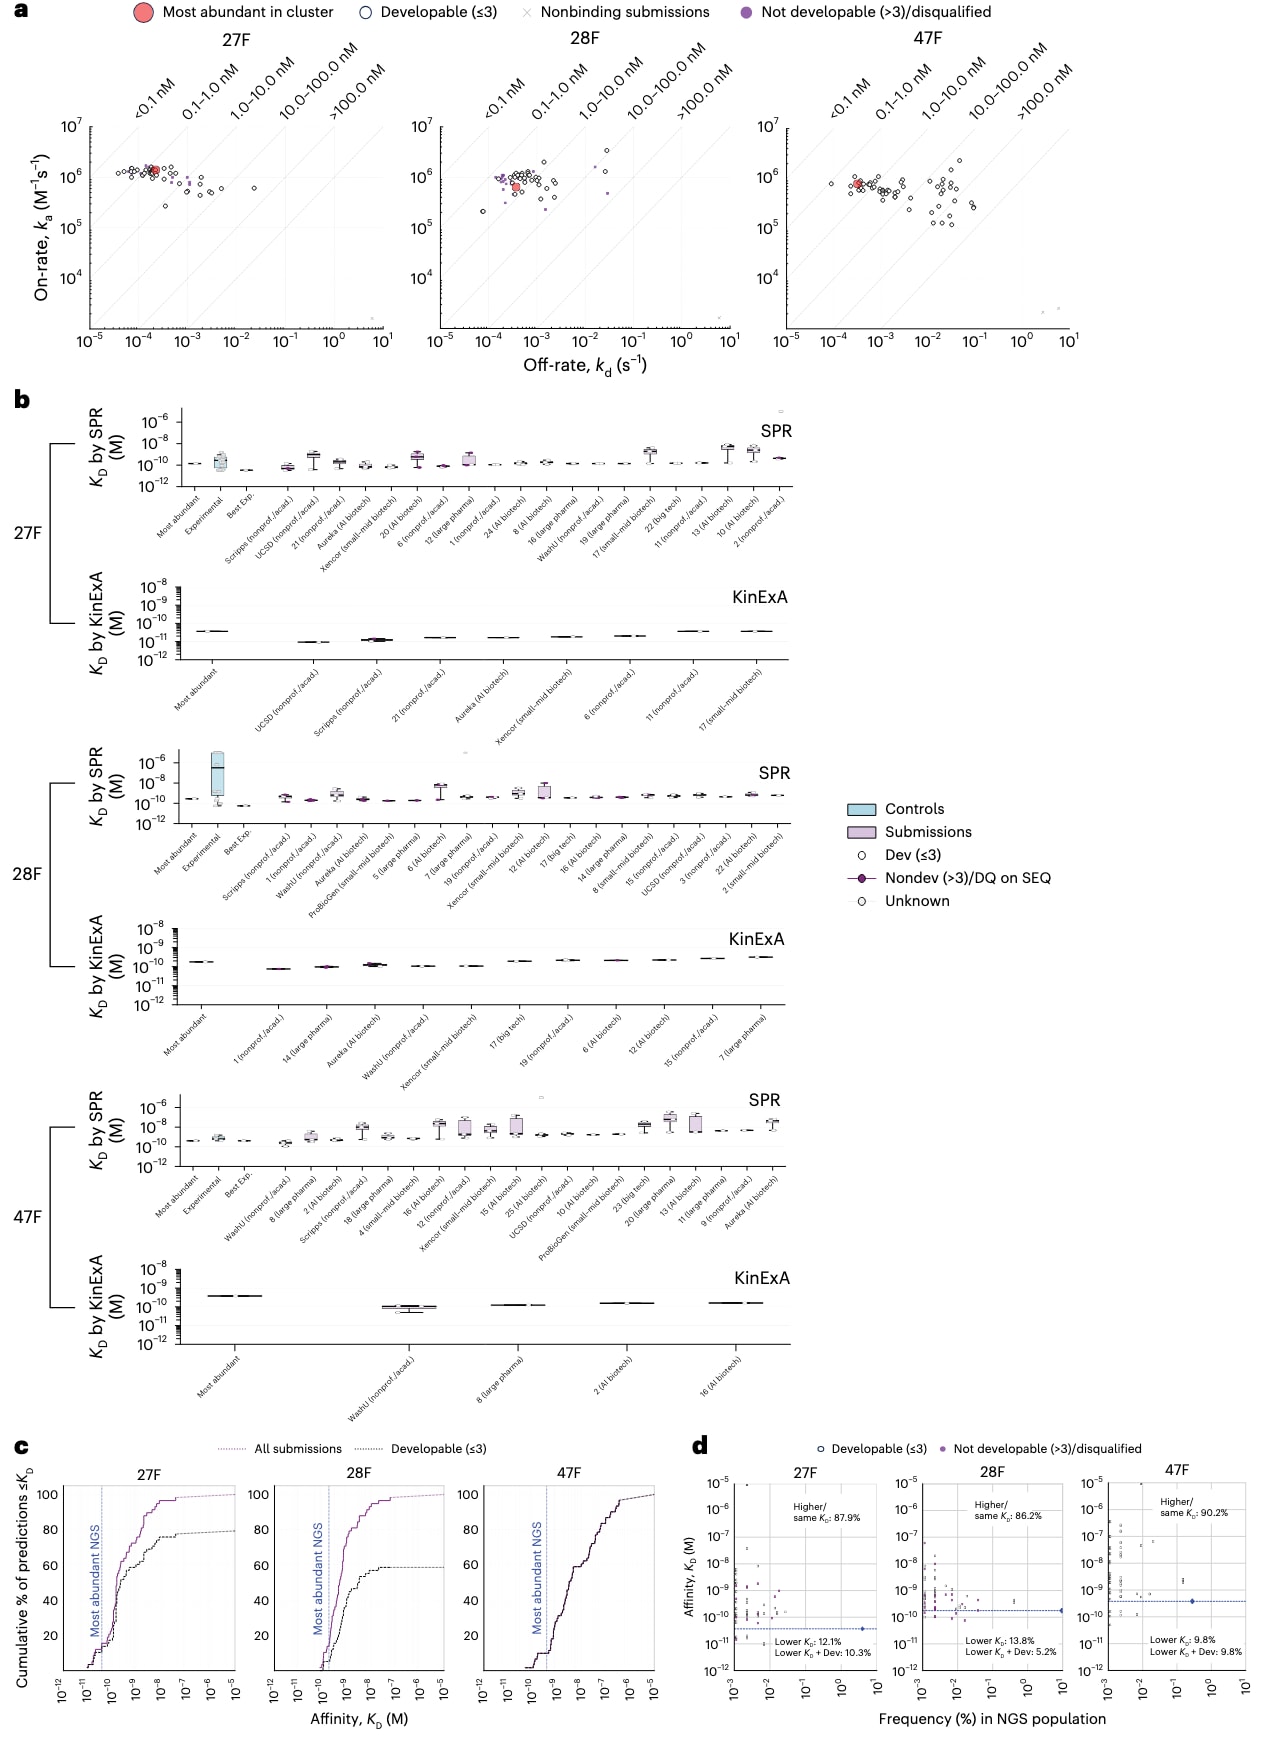
图3|聚类预测挑战概览。 a,三个 HCDR3 聚类中预测序列的等亲和力图:27F(左)、28F(中)和 47F(右)。每幅图均以对应聚类的实验对照为中心,即测序结果中丰度最高的克隆(红色)。各数据点按照综合可开发性评分着色:通过(
2.4 挑战 3:库外 CDR 优化和/或设计
在该任务中,各团队使用数据集 2 和数据集 3 中全部 32,059 条唯一序列(图1c),并结合已提供的 142 个抗体的亲和力数据(图1h),通过设计新的 CDR 或不同 CDR 组合,在不修改框架区的前提下生成高亲和力且具有良好可开发性的抗体。
图4a展示了所有提交抗体的 SPR 等亲和力图,并与此前研究中实验获得的抗体以及挑战 2 中预测的抗体进行比较。总体来看,AI 设计抗体中的不结合序列明显更多;即使对于能够结合的抗体,其亲和力也通常弱于实验获得的抗体。不过,仍有 33.9% 的提交序列达到亚纳摩尔亲和力,其中约 65%,即全部提交的 22.0%,同时满足可开发性要求。
在全部提交结果中,53.6% 的抗体既能够结合靶标(
图4b给出了不同机构全部提交抗体的平均 SPR 亲和力,图4c则展示了从中筛选出的少量高 SPR 亲和力抗体的 KinExA 测定结果。KinExA 测得的亲和力比对应的 SPR 结果高 2.2–9.0 倍。结合 KinExA 或 SPR 中测得的最佳亲和力构建的累积
最佳实验抗体的 KinExA 亲和力为 9.2 pM。共有 2 条提交序列,占总数的 2.4%,获得了更高的亲和力,分别达到 2.9 pM 和 3.1 pM;另外 4 条序列的亲和力与最佳实验抗体相当,为 8.7–9.6 pM。然而,在这些最高亲和力抗体中,仅有 1 条,占全部提交的 1.2%,满足综合可开发性标准,即评分
需要注意的是,该抗体无法从 HIC 色谱柱中洗脱。按照常规治疗性抗体开发标准,这类结果通常足以构成淘汰条件。此外,该抗体还表现出相对较低的比活性,并存在协同结合现象,其正 Hill 系数为 1.41。由于该挑战采用的综合评分体系将总分
获胜序列与所提供数据集中最接近序列的串联 CDR Levenshtein 距离为 5,即存在 5 个氨基酸替换(图4g)。其余排名前五的获胜序列与最近实验序列之间仅相差 1–3 个残基。与实验数据中任意序列相差
总体而言,共有 23 家机构提交 168 条序列,其中 117 条(69.6%)能够结合 RBD,51 条(30.4%)为不结合抗体。共有 22 条(13.1%)达到个位数 nM 亲和力,57 条(33.9%)达到亚纳摩尔亲和力,24 条(14.3%)达到低于 100 pM 的亲和力。71.4% 的提交通过可开发性评价,中位评分为 2;28.6% 因可开发性评分
最终获胜的库外设计抗体达到 2.9 pM 的亲和力,其具体方法见扩展数据图 4a–d,更多细节见补充说明 6。
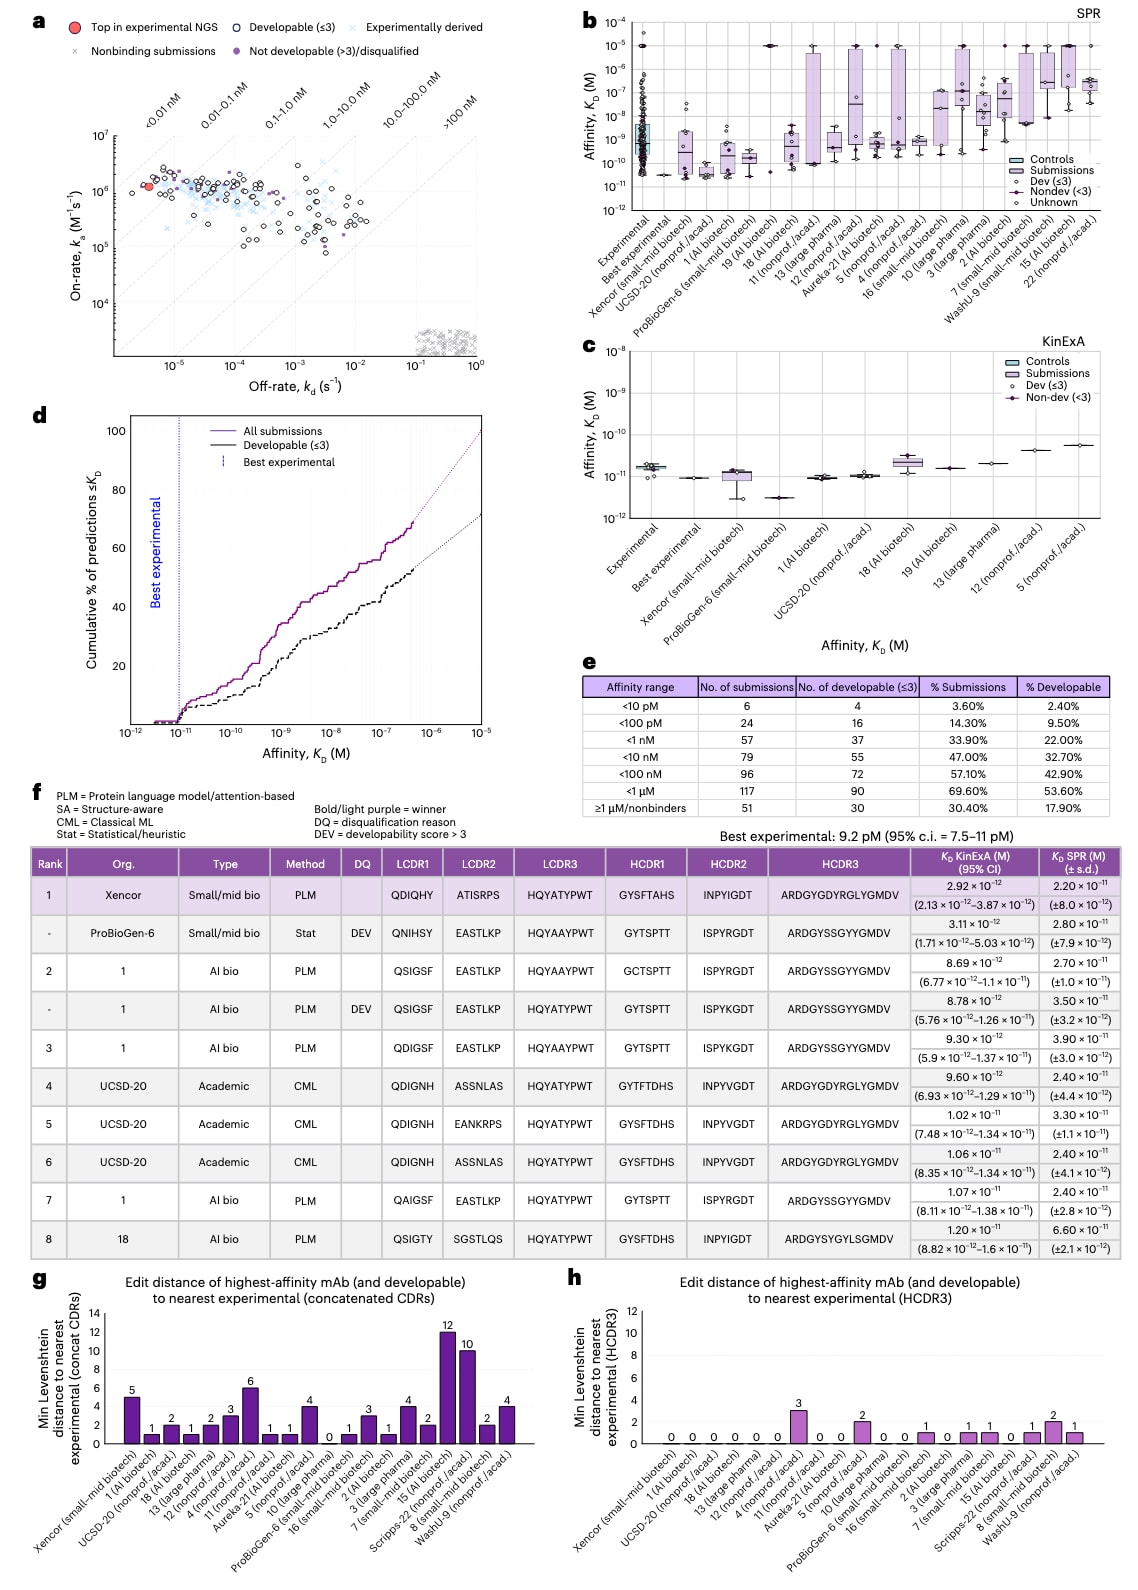
图4|库外 CDR 设计挑战概览。 a,库外设计抗体的等亲和力图,并与所提供数据集中的实验基准抗体进行比较。浅蓝色“×”表示实验抗体,红色表示实验获得的最佳亲和力。提交序列的数据点按照可开发性评分着色:通过(
2.5 计算方法类别分析
针对每项挑战,将各参与机构采用的方法划分为四类,并另设一类未公开方法(图5a):
- 统计或启发式基线方法,例如 ProBioGen 的共识序列分析;
- 经典机器学习方法,包括基于人工设计特征的建模流程,以及不使用注意力机制或预训练的简单神经网络,例如挑战 2 中 UCSD 采用的高斯过程回归,以及长短期记忆网络和基于树模型的分析流程;
- 基于注意力机制或预训练蛋白质语言模型(protein language model,PLM)的方法,包括 ESM-2、ft-ESM、AbLang、BALM、AntiBERTy、自定义自监督抗体语言模型(如 WashU 的 AlignNet)以及专有抗体大语言模型(LLM);
- 结构感知方法,即显式利用三维结构信息的方法,包括 AlphaFold(AF)或 AlphaFold 3(AF3)、ProteinMPNN、AntiFold、RFdiffusion 和 Pairformer 等。
如果某个机构在同一项挑战中组合使用多种方法,则会同时计入相应的多个类别。大多数多类别方案将 PLM 或注意力机制与结构信息结合,例如 Aureka 和 Scripps;另有两个机构将经典机器学习与结构方法结合,但均未进入各项挑战的获胜者行列。其在所有挑战中的最佳机构排名不高于第 6 名,在挑战 3 中的最佳提交总体排名为第 12。被归入第 3 类但未归入第 4 类的机构,主要使用基于序列的 PLM,在推理阶段并未显式进行三维结构预测。
需要注意的是,即使属于同一方法类别,不同方案在模型骨干、预测头和候选筛选逻辑等方面仍存在较大差异。因此,图5主要反映不同方法类别的总体趋势,而不能视为严格控制变量条件下的直接比较。
从方法类别来看(图5b),不同挑战的获胜方法并不相同。挑战 1 由 Aureka 获胜,其方法结合了 PLM、注意力机制与结构信息;27F 聚类中,采用经典机器学习的 UCSD 与 Scripps 并列第一;28F 聚类中,使用自定义 Transformer 的 WashU 与采用 PLM 的 Xencor 并列第一;47F 聚类由 WashU 获胜;挑战 3 则由采用 PLM 的 Xencor 获胜。
值得注意的是,ProBioGen 使用的共识序列基线方法在全部六个 CDR 上均与该文库对应的共识序列完全一致,并在挑战 1 中以 540 pM 的 KinExA 亲和力排名第三,同时未出现任何可开发性问题。这表明,在特定数据条件下,简单的统计基线方法同样能够取得很强的性能。
跨挑战排名结果(图5c)进一步表明,每个公开方法的团队至少都存在一项挑战,其最佳提交明显落后于领先方法,说明目前尚未出现能够在不同抗体设计与预测任务中稳定保持领先性能的通用方法。
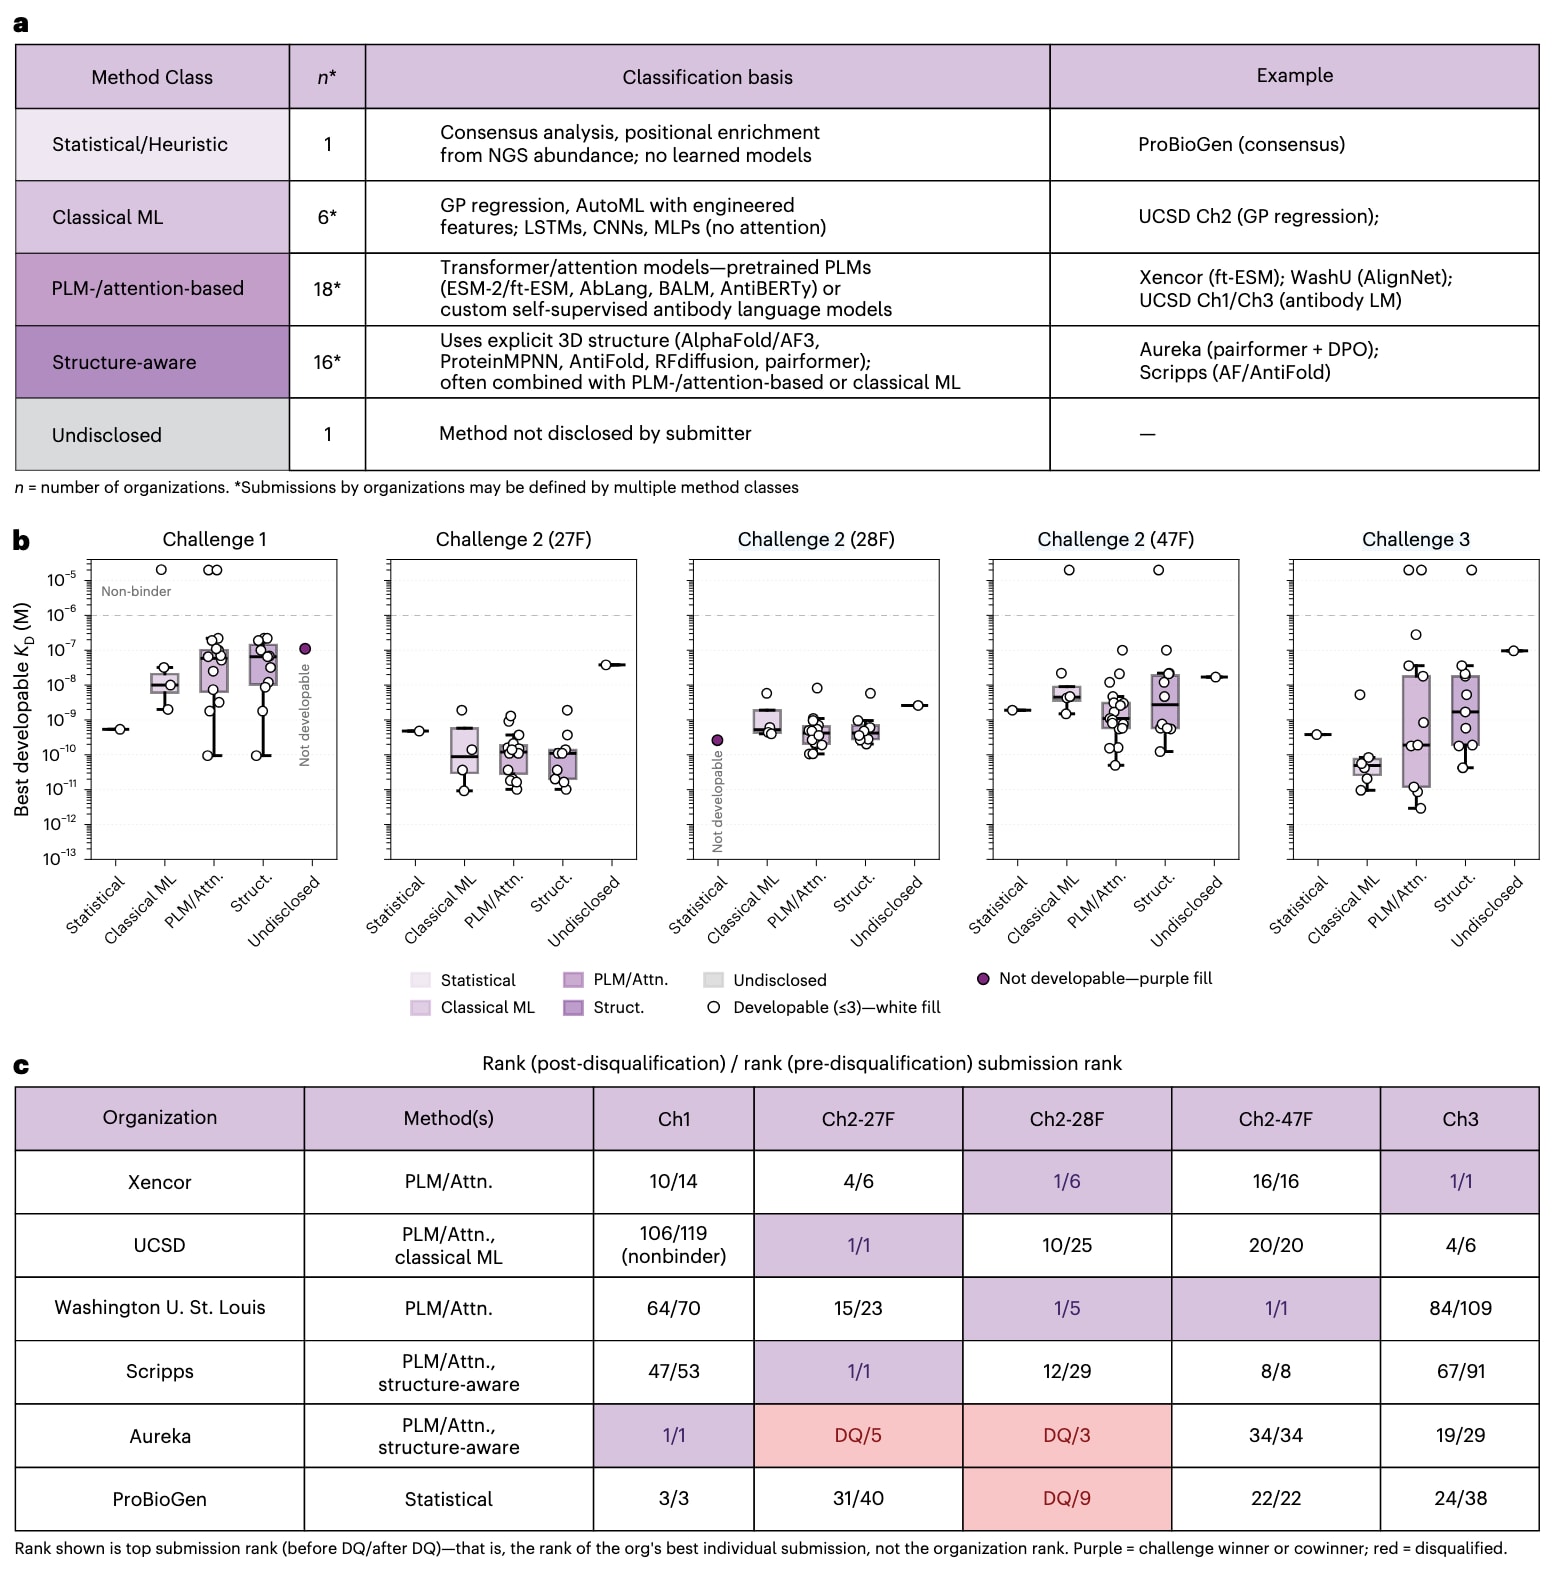
图5|计算方法分类及跨挑战表现。 a,将计算方法划分为四类,并另设未公开方法组,同时给出各类别的定义特征及对应的唯一机构数量。共涉及 29 家机构;如果某机构在不同挑战中采用不同方法,或在同一挑战中组合使用多种方法,则会计入所有适用类别。b,按照方法类别展示各机构在挑战 1、挑战 2 的 27F、28F 和 47F 聚类以及挑战 3 中获得的最佳可开发抗体亲和力(
3 讨论
这项前瞻性、盲法研究基于实验结果,对截至 2025 年第一季度的计算抗体发现能力给出了较为客观的评估。所有提交结果均采用统一的高通量 SPR、正交 KinExA 以及由既往研究改编的五项可开发性检测体系进行评价(图1m–o),从而尽可能减少回顾性研究中的评价差异,直接、独立且相对无偏地比较不同算法的实际性能。
考虑到当前 AI 在抗体发现中的真实价值仍存在较大不确定性,AIntibody 挑战在设计上有意提高了计算方法取得成功的可能性:选择研究极为充分的 SARS-CoV-2 RBD 作为靶标,并提供包含大量亲和力信息的高质量深度测序数据。三项挑战分别对应抗体发现流程中的不同环节,包括亲和力成熟(图1a、图2)、HCDR3 聚类约束下的命中扩展与排序(图1b、图3),以及受文库启发的 CDR 设计(图1c、图4)。这些环节如果能够获得稳定可靠的计算预测,都有望显著提升抗体发现效率。不过,三项任务中只有挑战 1 使用了接近常规实验条件下产生的测序数据;挑战 2 和挑战 3 则额外提供了大量通常只有在研发后期才能获得的亲和力数据。
AI 最明确的应用价值体现在挑战 1 的先导抗体优化中。约 13% 的提交序列相较亲本抗体获得了至少 20 倍的亲和力提升,即亲和力达到
如果 Aureka 的模型能够广泛泛化并可实际部署,那么其有望将实验周期缩短约 2–3 周,以一次计算设计取代实验组合文库筛选。这与已有研究中“在具有足够突变多样性的数据条件下,深度学习能够驱动抗体优化”的结论一致。值得注意的是,一个完全不使用 AI、仅基于统计共识序列的方法也取得了接近的结果,亲和力达到 538 pM。虽然表现最好的几个计算模型总体命中率仍低于实验组合文库经荧光激活分选后接近 100% 的成功率,但如果只需合成并测试 10–20 条设计序列,仍有较大概率找到具有实用价值的高亲和力变体。
与亲和力成熟不同,挑战 2 评估的是异质 HCDR3 聚类内部的命中扩展与亲和力排序。与挑战 1 不同,该任务提供了相当数量的已知抗体亲和力数据。各聚类中丰度最高的克隆通常能够结合靶标,但很少具有最高亲和力。AI 模型能够以较高比例识别出结合抗体,即
除 WashU 外,即使是获胜算法,其表现也低于随机挑选,成功比例仅为 11%–25%,而随机基线为 39%。WashU 是唯一超过随机基线的方法,成功率为 50%。此外,没有任何一个获胜方法能够在所有聚类上都保持有效,这进一步限制了实际应用价值。HCDR3 所带来的生物物理性质风险也增加了任务难度。尽管所使用文库已经针对可开发性进行了优化,但 28F 聚类中较高的失败比例与 47F 聚类中的良好表现形成鲜明对比,再次说明 HCDR3 对抗体可开发性具有关键影响,同时也体现了计算预测这一性质的困难。总体而言,除 WashU 外,其余 AI 方法在聚类内部寻找性能更优抗体时甚至不如随机挑选,而 WashU 在 27F 聚类中同样未取得有效结果。
挑战 3 的结果差异更大。按照预先公布的规则,Xencor 设计的 2.9 pM 抗体获得第一名,但其前述严重可开发性缺陷意味着,该抗体在真实临床开发流程中很可能会被淘汰。排名第二的可开发抗体亲和力为 8.69 pM,与最佳实验抗体 9.2 pM 在统计上无显著差异。共有 16 条抗体(9.5%)达到
与此同时,挑战 3 中有 30.4% 的提交为不结合抗体,另有 16% 虽然能够结合但不具备可开发性,两者合计占全部提交的 46.4%。对于大多数机构而言,其提交抗体的亲和力分布非常宽,既包括完全不结合的序列,也包括不同亲和力水平的结合抗体(图4b)。只有 6 家机构的提交结果集中在 100 倍亲和力范围内,其中 3 家进一步控制在 10 倍范围内,并至少获得一条亚纳摩尔设计。
不同任务之间以及同一任务内部如此不均衡的表现,说明当前计算抗体设计同时存在“追求极端最佳结果”与“保持稳定一致性能”之间的策略张力,也反映了各团队所采用算法的高度多样性。很多模型实际上针对特定数据条件进行了高度定制,例如分别针对局部上位性或异质候选排序。因此,在极具挑战性的靶标上,一次性的偶然成功也许仍具有价值,即使其中包含较强随机性;但对于工业抗体研发流程而言,更重要的是能够稳定产生可制造、可开发的先导抗体。
这些结果并不支持“一种模型解决所有任务”的思路,而更倾向于一种组合式策略,即根据具体任务和可获得的数据类型,有针对性地选择不同算法。一些获胜团队在多个挑战中使用了相同算法,但跨任务表现总体并不稳定。
从方法类别来看(图5),不同任务中的最佳方法类型也不相同。挑战 1,即文库内亲和力优化,由 Aureka 的 PLM 与结构信息结合方案获胜,而 ProBioGen 的简单共识序列基线按照 KinExA 排名第三,超过大多数 AI 设计结果。挑战 2 的三个聚类没有出现统一的方法类别获胜,成功方法分别来自经典机器学习、自定义 Transformer,以及 PLM 与结构感知方法的组合。这提示局部表位特征或具体聚类本身的特殊性,可能比方法类别更决定实际排序效果。挑战 3 的库外设计则由 Xencor 的 PLM 方法获胜,这与预训练语言模型在超出原始文库序列空间时可以提供更广泛序列先验的特点一致。
总体而言,PLM 和基于注意力机制的方法,包括自监督抗体语言模型和专有抗体大语言模型,在新序列生成等特定场景中表现更好;在文库内设计中,与结构信息结合后也能够发挥作用。这些结果提示,不同方法应与具体任务相匹配:文库内亲和力优化可考虑共识或统计方法,新序列设计更适合 PLM,而聚类级排序可能需要集成模型或针对任务专门优化的方法。
挑战 1 中一个简单的统计共识方法在不使用机器学习的情况下超过了大多数 AI 设计,这为该领域建立了一个重要基线。共识工程此前已经用于提高抗体和蛋白质稳定性,也曾用于从头构建具有功能的荧光蛋白,但用于抗体亲和力成熟的报道非常少,这可能是因为共识方法依赖足够大规模的数据集。随着未来用于 AI 训练的数据集规模进一步扩大,共识抗体与 AI 生成抗体之间的性能比较将具有重要意义。
编辑距离分析进一步揭示,不同设计约束下生成策略存在明显差异。在挑战 1 中,设计范围仅限于 LCDR1–LCDR3、HCDR1 和 HCDR2,HCDR3 保持固定,获胜模型表现出较为激进的序列探索能力,其生成结果与实验序列池之间可相差超过 12 个残基。
相比之下,挑战 3 虽然没有类似设计限制,但所有获胜方案最终都采用了实验数据中已经存在的 HCDR3 序列,即 HCDR3 的 LD 为 0,而创新主要集中在周围 CDR 的保守修改,仅发生 1–5 个残基替换。与这两类设计任务不同,挑战 2 本质上属于预测基准。
在 27F 聚类中,所有高亲和力克隆都共享优势 HCDR3,因此找到高亲和力 HCDR3 本身并不困难。UCSD 和 Scripps 的获胜预测与丰度最高克隆相比,仅在 HCDR2 中相差 1 个残基。28F 聚类中,WashU 和 Xencor 采取了明显不同的策略:WashU 的预测只比最高丰度克隆多 2 个残基变化,且保留相同的优势 HCDR3 基序;Xencor 则在全部 CDR 中偏离 12 个残基,并选择了一个比优势 HCDR3 低约 105 倍丰度的变体。47F 聚类中,WashU 的获胜序列相较最高丰度克隆在六个 CDR 上累计相差 26 个残基,并采用了该聚类中两个 HCDR3 基序里丰度较低的一个。
这些少数偏离最高丰度序列仍能取得优异结果的案例,说明模型具备一定能力识别偏离群体中心的适应度峰值。但对已有序列基序的明显依赖,也引出了一个关键问题:这种能力能否迁移到数据稀缺场景。特别是,挑战 2 和挑战 3 提供了大量亲和力数据,而这并不符合典型早期抗体发现项目的实际情况,因为亲和力通常是在筛选后期才进行系统测定。未来有必要仅基于测序数据重新测试这些成功算法,验证其在缺少亲和力数据时能否保持与挑战 1 类似的表现。
除这一策略性问题外,挑战 3 还暴露了基准设计本身的一个重要缺陷。排名第一的抗体无法从 HIC 保留柱中洗脱,但仍因综合评分体系允许高亲和力抵消单项严重生物物理缺陷而最终获胜。为了使计算评价标准更加符合治疗性抗体开发实际,未来基准将引入更严格的关键 go/no-go 判定标准,一旦出现严重风险信号即可直接取消资格。
还需要指出的是,一些公开宣称具有较强计算抗体设计能力的知名团队并未参加此次挑战。未参与可能有多种合理原因,例如对盲法机制的担忧、方法披露要求或时间限制等。更广泛的参与将有助于提高基准的代表性。此类盲法前瞻性基准也为机构及其投资者直接了解自身算法相对于其他方法的真实水平提供了重要途径。
此次挑战的盲法主要依赖组织者诚信,并未通过信息学手段进行严格隔离,这也是部分团队选择不参与的合理原因。下一届 AIntibody 挑战将对此进行改进。方法细节披露要求同样可能降低部分机构的参与意愿,因为许多企业确实受到商业秘密和知识产权保护要求的限制。
这次 AIntibody 挑战的数据和实验结果均向社区开放,以便其他研究者测试自己的模型并与参赛算法进行比较。一个值得注意的现象是,所有获胜者中只有 Aureka 将自身定位为 AI 公司。其余获胜者包括学术团队 Scripps、UCSD 和 WashU,以及中型生物技术公司 Xencor。Xencor 虽然具有丰富的抗体研发经验,但并不强调 AI 专长,却利用两种不同算法分别赢得一个聚类挑战和库外 CDR 设计挑战。这说明该领域目前仍然具有较高开放性,并非只有拥有巨大资本和计算资源的机构才能取得领先结果。
AI 扩展针对特定靶标的抗体集合是否真正有价值,最终取决于新增抗体本身的性质。如果 AI 设计抗体能够在保持相同或相近表位的情况下,进一步提高实验筛选所得抗体的亲和力,那么正如该研究中部分结果所示,AI 已经能够在抗体发现流程中提供实际价值。同样,如果 AI 能够将不可开发抗体改造成可开发版本,或者设计出针对现有实验抗体集合中尚未覆盖表位的抗体,也将进一步提高 AI 在抗体发现流程中的应用价值。
总体而言,当提供深度、靶向且高质量的数据时,表现最好的 AI 算法已经能够在亲和力成熟任务中产生实际价值,并且对于部分 HCDR3,例如 WashU 的结果,也可以用于命中扩展:在已知 HCDR3 聚类中识别潜在高亲和力结合抗体,并设计针对相应靶标的库外抗体。
未来仍需回答一个关键问题:针对每个新靶标,算法是否始终需要如此丰富的数据,甚至包括实验亲和力信息;还是能够利用这些深度数据训练出可迁移到数据稀缺场景的模型,从而真正从“优化”迈向“发现”。这一问题将成为 2026 年下一届 AIntibody 挑战的重点。下一届评测将包括两类竞赛:第一类是在靶标公布后,允许采用体内、体外或计算方法等任意发现策略生成高亲和力抗体;第二类则与这次挑战类似,提供测序数据,但不再提供亲和力信息。