Nat. Commun. 2025 | OmniMol: 从超图视角统一且可解释地学习不完美标注数据中的分子表示
今天介绍的是发表在 Nature Communications 上的一项研究工作。真实药物研发数据常存在标签稀疏、缺失和类别失衡,不同分子性质之间的关联也难以被传统单任务或多头模型充分利用。针对这一问题,提出了统一且可解释的多任务分子表示学习框架OmniMol,将分子与性质组织为超图,并结合任务元信息编码器、任务路由专家混合网络和具备手性意识的SE(3)编码器。OmniMol在52项ADMET-P预测任务中的47项达到领先水平,还能学习构象松弛、识别性质关联,并给出与药物化学知识一致的原子注意力。该框架为整合分散的分子性质数据、提高预测可靠性以及辅助真实结构-活性关系优化提供了新思路。
获取详情及资源:
0 摘要
分子表示学习可通过预测化学性质加速药物研发,但不同数据集中的不完美标注给模型设计和可解释性带来了挑战。分子及其对应性质被表述为超图,从中提取性质之间、分子到性质以及分子之间三类关键关系,并据此构建统一且可解释的多任务分子表示学习框架OmniMol。
OmniMol整合任务相关元信息编码器和任务路由专家混合骨干网络t-MoE,用于捕捉性质间的相关性并生成任务自适应输出。为学习分子之间共享的底层物理规律,还设计了面向物理对称性的SE(3)编码器,并结合平衡构象监督、递归几何更新和尺度不变消息传递,实现基于学习的构象松弛。结果显示,OmniMol在分子性质预测中达到先进水平,在手性感知任务中取得领先表现;同时能够解释三类关系,并在实际应用中展现出有效性。
1 引言
药物研发需要经过严格的多阶段临床试验,以确保安全性和有效性,因此成本高昂且周期漫长。已有估计显示,将一种新药推向市场所需的研发成本约为1.61亿美元至45亿美元以上。近年来,数据驱动的人工智能计算方法,尤其是分子表示学习,在量子层级化学性质预测方面表现出突出能力。大规模预训练和几何辅助监督带来的进展,为类药分子的临床前筛选提供了高效且风险更低的替代方案,有望减少传统分子合成和湿实验负担,缩短药物研发周期。对吸收、分布、代谢、排泄、毒性及理化性质,即ADMET-P性质进行早期评估,还可降低研发成本以及副作用和毒性风险。
尽管ADMETlab 2.0、admetSAR 2.0和HelixADMET等先进模型已经出现,ADMET预测仍面临泛化性、鲁棒性以及复杂药物化学、药代动力学和毒理学知识理解能力不足等问题。现有分子表示方法多围绕物理信息表征和复杂消息传递架构展开,通常依赖组织良好、分子数量庞大且目标性质统一的数据集,例如包含超过2.64亿个催化体系的OC20、包含340万个分子的PCQM4MV2,以及包含13.4万个稳定小分子的QM9。真实场景中的分子与性质数据却往往并不完整。
设全部分子的集合为
当至少存在一个性质满足
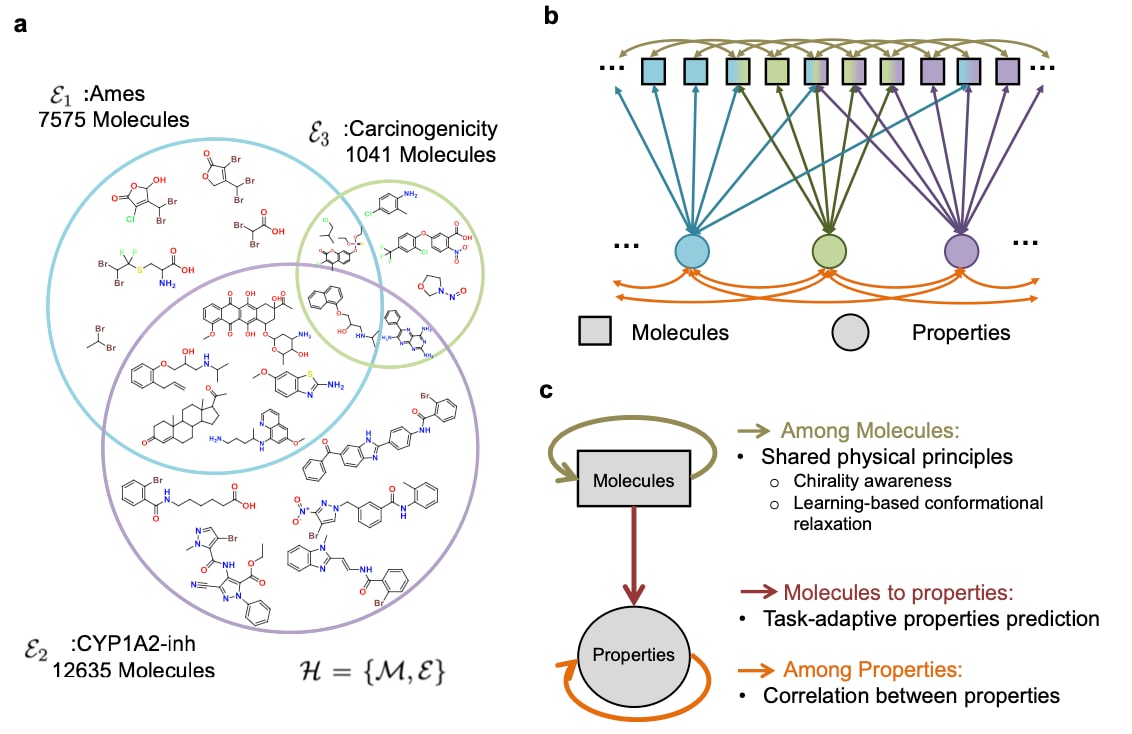
图1|OmniMol与超图的概念 a. 不完美标注分子与ADMET-P性质之间的超图关系。超图
不完美标注首先会增加模型设计难度。最直接的方案是为每种性质训练一个任务专属模型,但不同性质通常包含可共享的信息,联合学习有助于扩大有效数据规模并理解任务关系。例如,Ames致突变性与致癌性高度相关,而且部分分子重叠。现有ADMET-P方法因此常采用多任务范式:共享分子特征提取器,再为不同性质配置独立预测头。这类结构虽然能提取分子间的共同特征,却难以充分捕捉性质间关系,还会因部分标签而产生训练同步问题。任务专属模型和多头模型的模型数或预测头数量也会随性质数量线性增长。
不完美标注还会限制可解释性。在先导化合物发现与优化阶段,结构-活性关系分析不仅要求准确预测,还需要说明预测依据,以验证结果可靠性并形成可操作的药物化学见解。可信模型应理解所有分子共享且与任务无关的基础物理规律,这通常需要大量数据。整合分散的分子-性质数据可显著扩大训练规模,同时使模型在预测时具备任务自适应能力,并学习不同性质间的相关性。
为此,分子与性质被显式封装为超图
在Graphormer结构基础上构建的OmniMol利用专门编码器将任务元信息转换为任务嵌入,再将其与t-MoE骨干结合,从而识别可解释的性质相关性并生成任务自适应输出。该端到端架构可合并任意可用的分子-性质对,在数据规模增大时获得更全面的知识,同时规避多头模型的同步困难,并保持与任务数量无关的
为学习分子间共享的物理规律,OmniMol进一步加入SE(3)编码器,使模型能够直接从分子构象感知手性,无需人工设计特征。平衡构象监督、递归几何更新和分子尺度不变消息传递则使其可作为带有启发式原子间势的学习式构象松弛方法。以ADMET-P预测为主要评测任务时,OmniMol在52项任务中的47项达到先进水平,在手性感知任务中取得最佳表现,并对三类超图关系均展现出可解释行为。
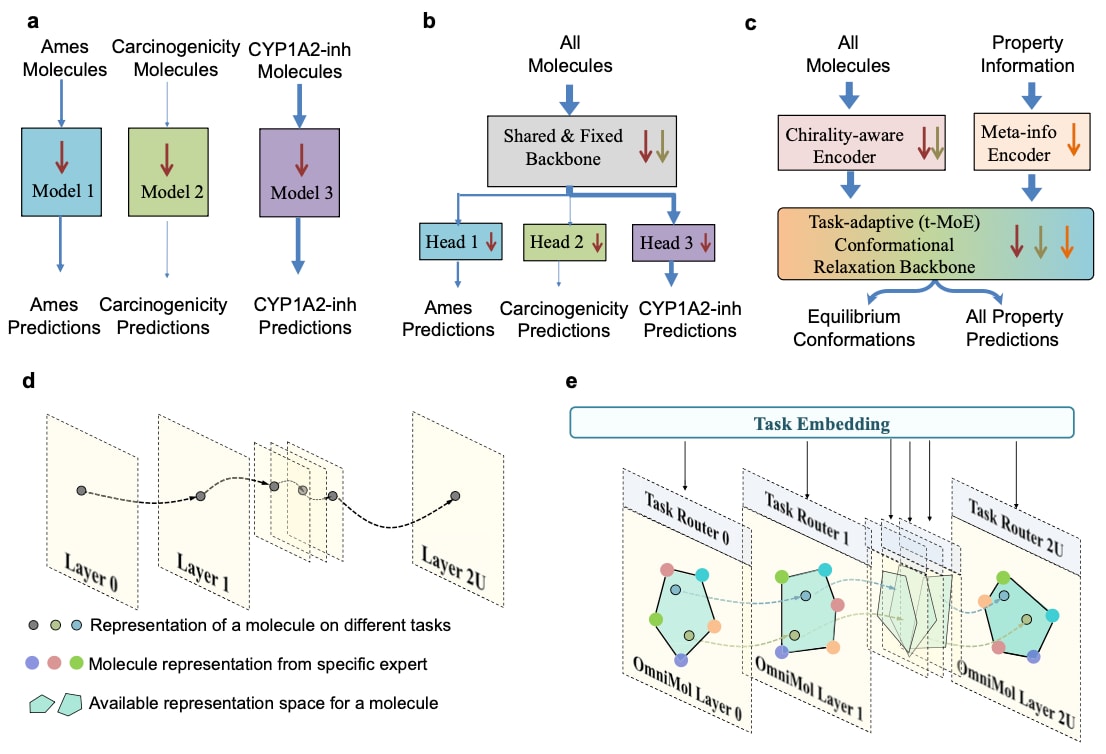
图2|OmniMol骨干网络与任务路由专家混合架构 a. 为每种性质建立任务专属模型。b. 采用共享分子特征提取器和性质专属预测头的多任务训练范式。c. OmniMol整合专门编码器与任务路由专家混合骨干。d、e. OmniMol与任务无关固定骨干的比较:固定骨干以同一种方式处理同一分子的表示,而任务自适应骨干可依据任务嵌入,将同一分子的表示路由到多个专家输出的不同凸组合,从而显著扩大可用表示空间.
2 结果
2.1 OmniMol增强分子表示能力
ADMET-P预测被用作不完美标注数据的代表性任务。评测数据来自ADMETLab 2.0,约含25万对分子与ADMET-P性质,覆盖40项分类任务和12项回归任务。然而,这25万个分子-性质对仅对应约9万个独特分子,其中64.4%的分子只有一个性质标签,只有53个分子带有30个以上性质标签。这与面向统一性质、标注完整的大规模基准数据形成鲜明对比,也体现了药物发现数据在标签规模与分布上的不平衡。
OmniMol通过任务元信息编码器与t-MoE模块处理稀疏、部分缺失和不平衡标签,并通过物理信息架构学习分子之间共享的规律。相比任务专属模型和多头模型,这一设计能够同时理解分子之间、性质之间以及分子到性质的关系,从而改善性质预测。
评测严格采用ADMETLab 2.0的8:1:1随机划分。分类任务以ROC曲线下面积、准确率和MCC衡量,回归任务采用决定系数
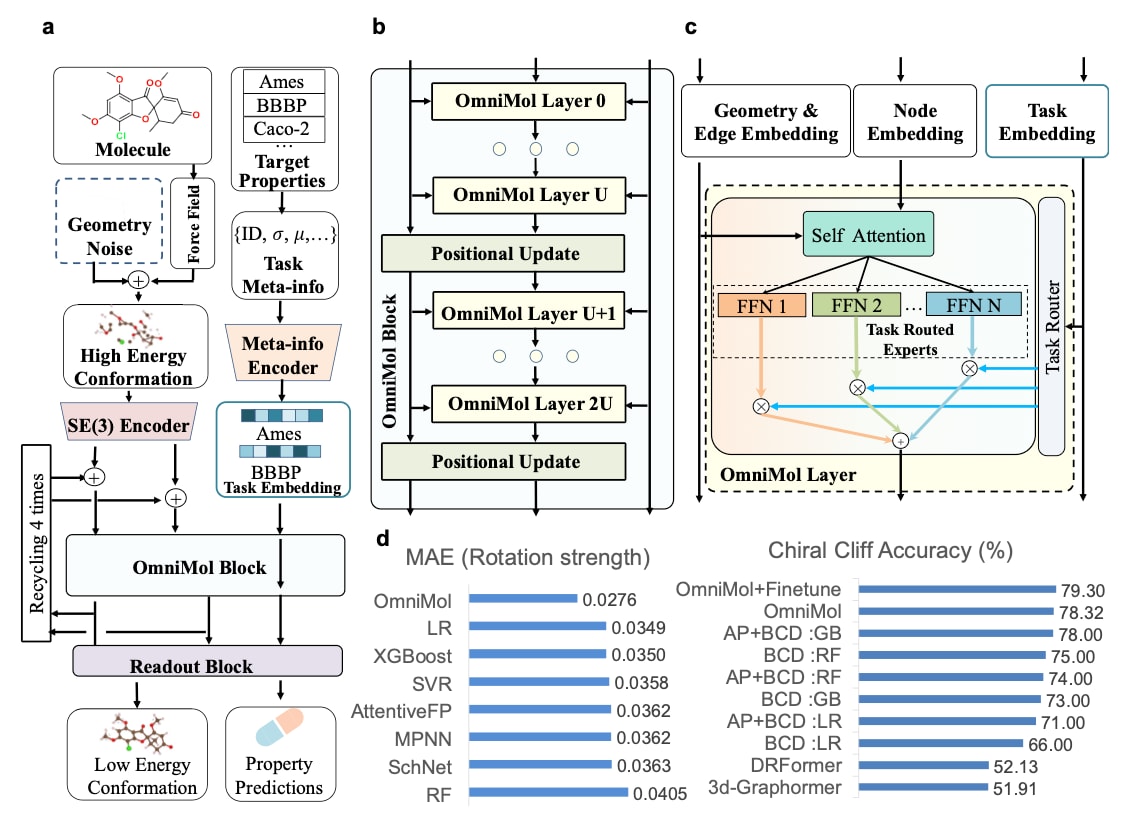
图3|OmniMol的主要架构及手性感知任务表现 a. OmniMol整体架构。b. 核心OmniMol模块由多个OmniMol层组成,中间穿插位置更新模块。c. 每个OmniMol层包含任务路由专家混合层,以实现任务自适应。d. OmniMol在手性感知任务中超过既有方法。FFN表示前馈神经网络,MAE表示平均绝对误差,
表1|OmniMol预测ADMET-P性质的表现
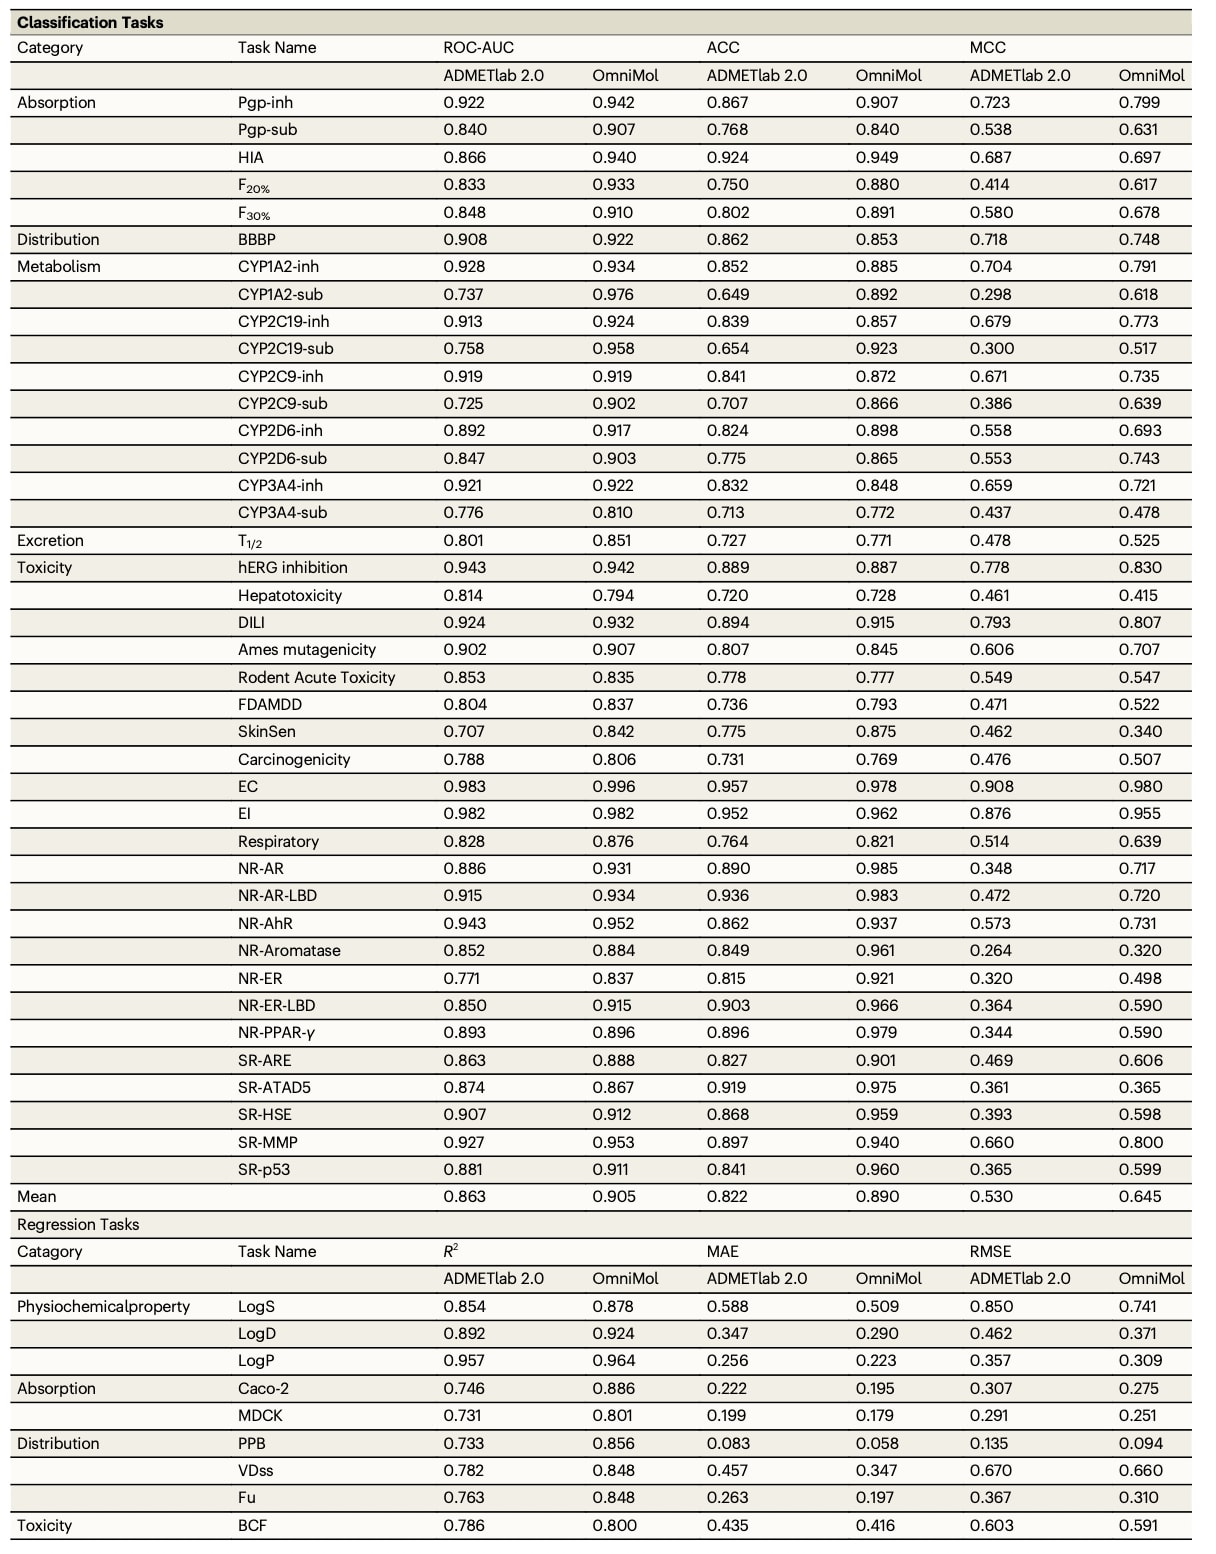
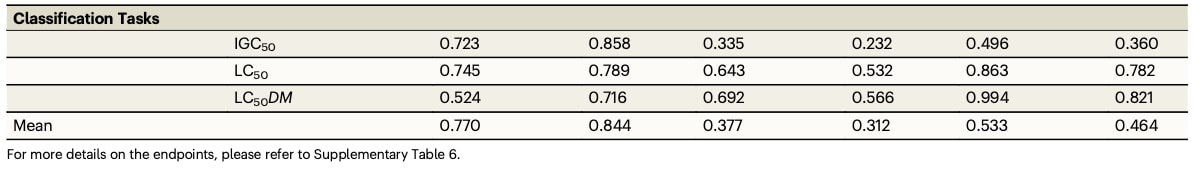
2.2 手性感知能力
手性是分子中的基础物理对称性。对映体具有相同的化学组成和原子连接,却可能因镜像结构而呈现完全不同的疗效与毒理特征。例如,沙利度胺的R型对映体具有镇静作用,而S型与严重出生缺陷相关;瑞德西韦也只有一种对映体能够抑制冠状病毒的RNA依赖性RNA聚合酶。因此,可靠的分子表示必须识别反射导致的手性差异。
仅编码原子间距离的模型通常具备E(3)等变性,保留旋转、反射和平移对称,却无法区分镜像分子。要识别手性,节点表示需要满足SE(3)等变性,性质预测需满足SE(3)不变性,并编码至少涉及四个原子的几何特征。OmniMol中的手性感知编码器正是为反射敏感性而设计。
第一项实验从PubChem汇集了13.1万个含至少一个手性中心且重原子数不超过12的分子SMILES,形成45182对对映体。对其中仅含一个手性中心的31270对分子按CIP规则分类,并以80:20划分训练集与测试集。OmniMol的R/S手性预测准确率达到96.78%,明显高于DRFormer接近随机猜测的50%。
第二项任务预测需要量子化学计算的旋光强度。采用完整的45182对对映体,以时变密度泛函理论计算旋光强度作为回归目标,并按80:10:10划分数据。OmniMol的MAE相较基线最佳结果降低21.03%,说明仅依据分子构型即可有效预测量子层级性质。
第三项任务评估手性对结合亲和力的影响。在手性悬崖数据集上,OmniMol识别显著手性结合亲和力差异的准确率为78.3%,经ADMET-P数据微调后提高至79.3%,与依赖精细手性描述符的最佳方法相当;3d-Graphormer和DRFormer则仅达到51.9%和52.1%。这些结果验证了OmniMol在药物候选筛选中的手性感知能力。
2.3 基于学习的构象松弛
由原子间势决定的分子动力学表征对于理解结合环境中的复杂相互作用十分关键,也是分子间共享、可用于增强解释性的知识。OmniMol并不直接拟合原子力或势能面,而是借鉴原子间势的物理思想,以启发式构象松弛算法预测低能分子构象。
具体而言,模型从通过Merck分子力场获得的平衡构象出发,加入三维高斯几何噪声以构造高能构象,再利用与图级性质预测头并行的几何预测头,递归地引导分子趋向低能平衡状态。显式递归几何更新和分子尺度不变消息传递增强了对构象松弛动力学的模拟,也使不同尺寸分子的更新更加可靠。
对递归OmniMol模块的中间几何进行可视化后发现,高能构象能够有效松弛。系统能量稳定下降,而几何MAE并不单调变化,说明模型并非简单地在噪声构象与平衡构象之间插值。即使中间结果未必在几何上更接近平衡状态,学习到的原子相互作用仍会迭代地把原子导向低能构象。无需显式计算原子间力即可预测能量更有利的构象,表明OmniMol学习到了可跨任务、跨样本共享的启发式原子间势。
2.4 面向任务关系的ADMET-P自适应预测
任务元信息编码器能够识别性质之间的内在联系。t-MoE依据任务嵌入为不同任务分配专门专家,使模型不再以固定方式处理所有性质,而是为每个目标学习合适的参数组合。相关任务会在同一分子上形成相似的注意力分布。
对所有任务嵌入进行UMAP降维后,六类ADMET-P性质在表示空间中形成清晰簇群,回归任务和分类任务也呈现可辨别的分布。细看代谢性质可见,细胞色素P450底物任务与其抑制剂任务处于不同位置。DILI与人肝毒性、Ames与致癌性、眼刺激与眼腐蚀等高度相关任务则自动聚集在邻近区域,尽管模型并未接收这些先验关系。这说明元信息编码器能够发现并编码性质预测任务间的内在联系。
进一步比较两组ADMET-P端点时,同一分子会根据目标任务获得不同的节点注意力。对于甲硝唑,Ames与致癌性任务形成相似注意力模式,模型聚焦于可能诱发基因突变或癌变的硝基;在CYP1A2和CYP3A4抑制任务中,则更关注可能影响CYP450的含氮杂芳环。对于丙卡巴肼,肼基对成药性存在广泛不利影响,因此在多项任务中均获得较高注意力。结果显示,OmniMol既能利用任务间的共性知识,又能随目标性质调整节点注意力。
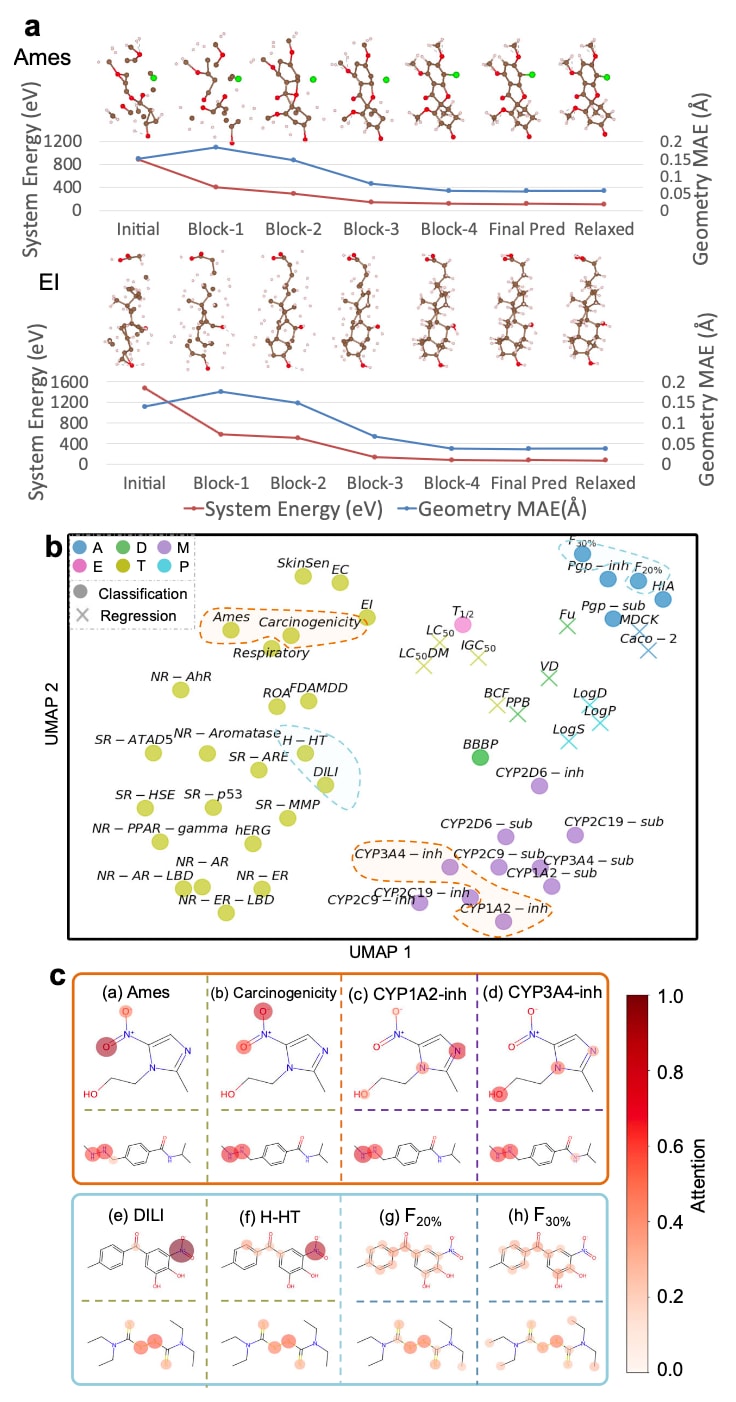
图4|OmniMol行为分析 a. 中间几何可视化显示,OmniMol可表现为启发式原子间势,帮助分子达到低能构象。b. UMAP可视化显示模型能够识别任务关系,将不同ADMET-P性质有效分类,并使相关端点位于邻近位置;不同颜色表示吸收、分布等ADMET-P大类,虚线圈出的任务具有药理关联。c. OmniMol会根据具体性质预测任务自适应地分配不同注意力模式。MAE表示平均绝对误差,UMAP表示统一流形逼近与投影,ADMET-P表示吸收、分布、代谢、排泄、毒性和理化性质.
2.5 可解释注意力的对比验证
为验证可解释性和化学推理能力,针对八种ADMET-P端点分析了节点级注意力。OmniMol的注意力机制与既有药物化学知识一致,并能生成与专用单任务模型相当甚至更优的解释。在hERG抑制预测中,模型能够识别叔胺、氨基和极性基团等已知相关结构特征,其模式与BayeshERG等专用模型高度接近。进行急性毒性评估时,OmniMol与VenomPred 2.0均突出偶氮基和磷酸酯等已知毒性基团。多数端点比较表现出高度或中度相似性,说明无需显式特征工程也能识别具有化学意义的结构。
与依赖指纹、子结构或理化性质等预计算描述符的专用模型不同,OmniMol直接处理由SMILES生成的三维构象,并通过学习得到的嵌入和注意力自主识别任务相关官能团。节点级注意力可让模型聚焦于决定特定性质的关键基团,同时减少对无关片段的过度关注,缓解简单求和式图级表示在分子尺寸和复杂度变化时的不足。该方法既遵循既有化学规律,又保留学习新结构-性质关系的灵活性。
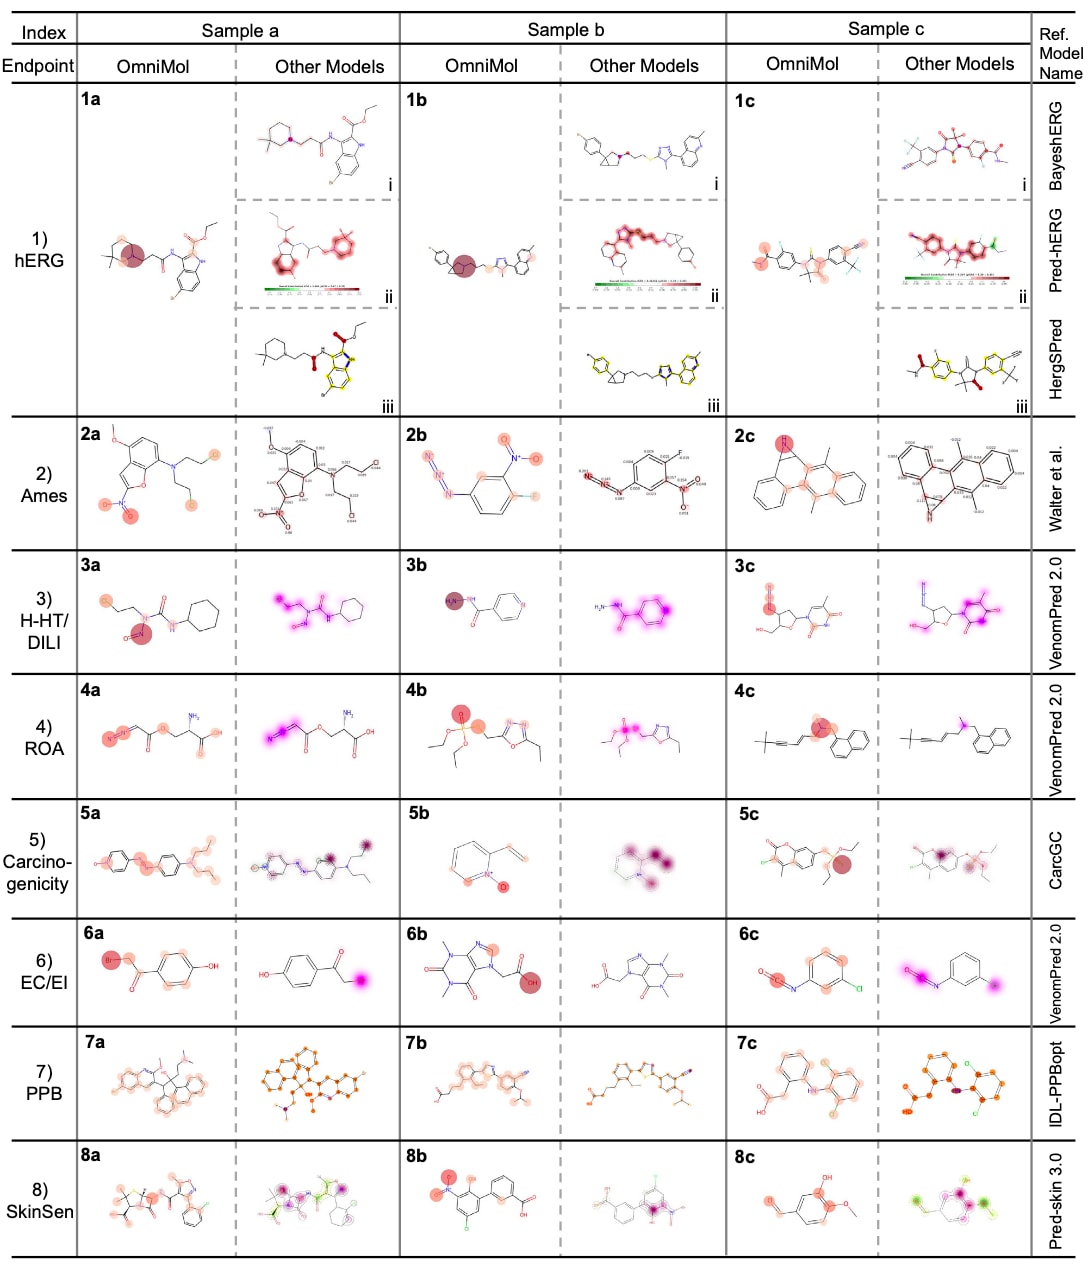
图5|OmniMol与专用模型的原子注意力分布比较 每个端点选取三个代表性分子,展示OmniMol识别任务相关结构特征的能力。颜色越深表示注意力越高。端点包括hERG抑制、Ames致突变性、人肝毒性与药物性肝损伤、大鼠口服急性毒性、致癌性、眼腐蚀与眼刺激、血浆蛋白结合以及皮肤致敏.
2.6 真实结构-活性关系研究中的实用性
为检验分子优化中的实际用途,围绕四项关键ADMET性质开展了结构-活性关系分析。除化合物11a和12b外,所选化合物均未包含在训练数据中。四类端点上的注意力分布都与已发表的结构-活性关系结论一致,即使结构变化十分细微:优化前分子中与目标端点相关的基团通常获得较高注意力,而优化后对应基团的注意力会降低或消失。
在hERG抑制案例中,OmniMol准确识别了碱性中心和分子刚性相关关键位点。优化前分子10a和11a的环连接处叔胺获得较高注意力;优化后的10b和11b在相应位置注意力显著下降或消失,这与降低hERG抑制的已知策略一致。模型还识别出影响MDCK-MDR1外排比的细微原子级变化,该指标是判断分子是否为P-糖蛋白底物的重要标准。相比之下,部分专用模型在优化前后几乎给出相同注意力分布。
这些结果表明,OmniMol能适应多种结构修饰,并在不同性质优化场景中保持一致的化学推理。其能力不仅体现为ADMET性质预测准确,还包括对实际结构-活性关系中细微结构变化的识别,因此具有辅助药物研发性质优化的潜力。
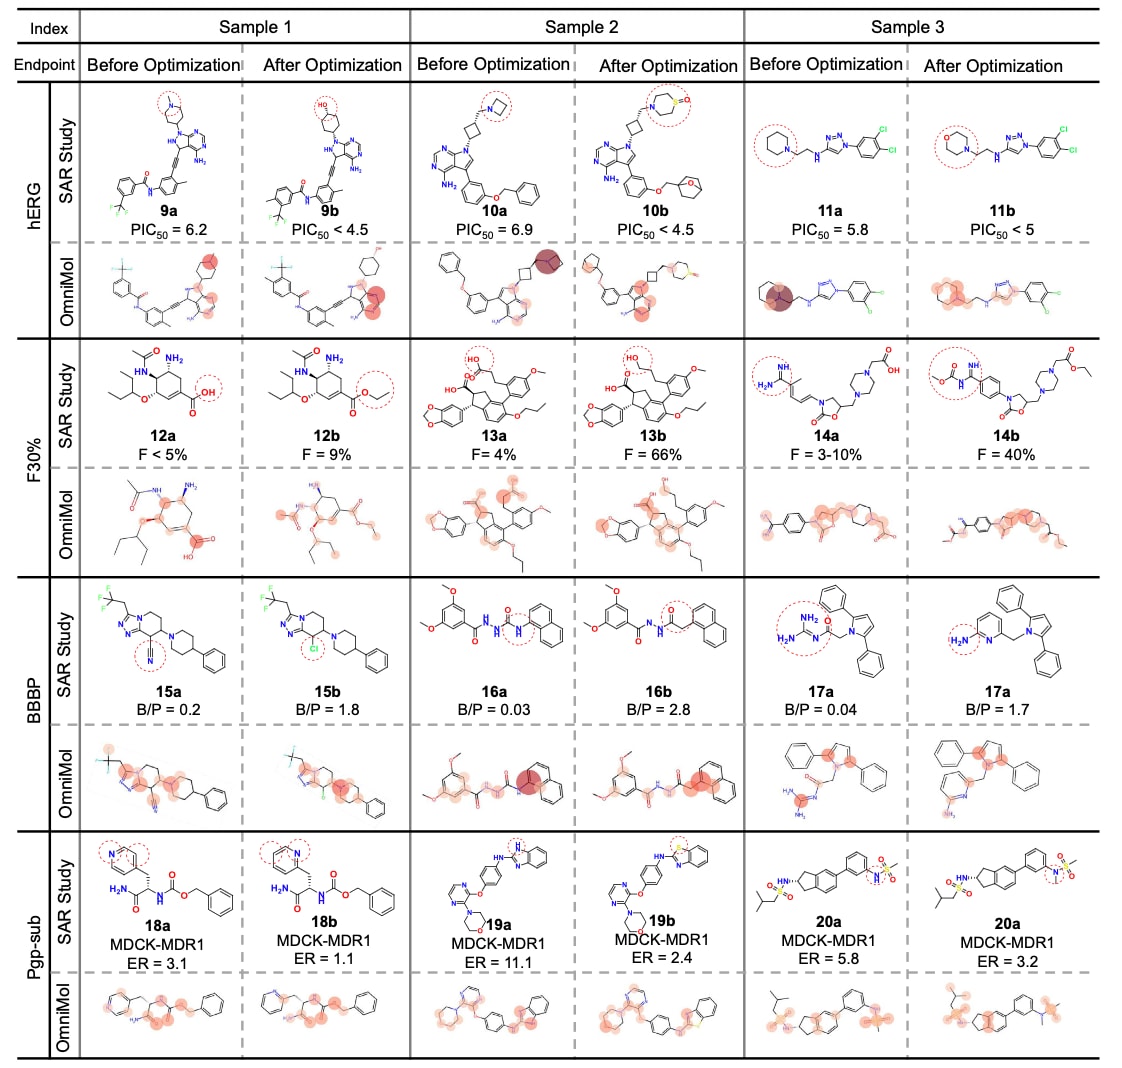
图6|真实案例中的OmniMol结构-活性关系分析 OmniMol能够识别四项关键ADMET-P性质优化所涉及的结构特征。颜色越深表示注意力越高,红圈标出关键修饰位点。pIC50表示换算为摩尔浓度后IC50的负对数,F表示口服生物利用度,B/P表示脑-血浆浓度比,MDCK-MDR1表示Madin-Darby犬肾细胞-多药耐药蛋白1,ER表示外排比,hERG指hERG抑制,F30%表示30%口服生物利用度,BBBP表示血脑屏障通透性,Pgp-sub表示P-糖蛋白底物.
3 讨论
OmniMol从超图视角刻画真实不完美标注数据中分子之间、分子到性质以及性质之间的复杂关系。ADMET-P任务验证了其处理稀疏、部分缺失和不平衡标签的能力,并体现出较强的预测表现、手性敏感性以及三类关系上的可解释性。
该框架的意义并不局限于药物研发中的ADMET-P评估。由于任意可用的分子-性质对都可被整合进统一端到端架构,数据规模增加能够带来更全面的知识,从而为跨异构数据集的通用分子表示学习以及基础物理机制提取奠定基础。
UMAP可视化表明,学习到的任务元嵌入超越了原始数据统计关系,既能编码ADMET-P类别等显式联系,也能识别人肝毒性与药物性肝损伤等隐式生物学联系,同时保留回归与分类任务的结构差异。这为任务间知识迁移提供了依据。
在八项ADMET-P任务上,与专用模型的比较显示OmniMol能够产生有意义且可解释的注意力分布。专用模型往往依赖预定义理化描述符和子结构指纹,而OmniMol从SMILES及三维构象出发,并借助不同数据集之间的超图拓扑联系学习药物化学模式。模型能准确识别影响目标性质的关键基团和子结构,在真实案例中与既有知识高度吻合。
四项ADMET-P任务的多个结构-活性关系优化案例进一步显示,模型会对优化前分子中的不利基团分配高注意力,并在优化后降低或消除对应位点的注意力。即使优化前后的分子变化很小,仍表现出良好的适应性、实用性和泛化性,突破了固定基团识别的限制,并显示出参与临床前高成本结构-活性关系优化的潜力。
OmniMol仍存在数据适用范围方面的限制。分类任务的训练标签为二元值,因此无法准确预测这些任务的实际实验数值。当前验证属于回顾性评估,仍需前瞻性实验进一步确认实际价值。框架目前主要面向小型类药分子,未来可扩展至更复杂的数据和任务,例如小分子的HOMO-LUMO能隙、催化体系的吸附能以及生物分子的力场预测,甚至可能推广到更大尺度的工业模拟系统。
总体而言,OmniMol在分子性质预测方面体现出较强的适应性、可解释性和泛化能力,不仅在传统ADMET-P任务上保持可靠准确度,也为分子与材料科学中的更广泛应用提供了统一框架。通过进一步扩展数据类型和物理性质,该框架有望发展为兼顾模拟驱动ADMET-P评估和物理信息生成模型的综合工具。