NMI 2026 | JMM: 以“陌生度”拓展分子深度学习的化学空间边界
今天介绍的这项工作来自 Nature Machine Intelligence 。该研究聚焦分子机器学习在训练化学空间之外泛化能力不足的问题。现有模型通常能够准确预测与训练数据相似的化合物,但面对结构新颖的生物活性分子时,预测性能与可靠性往往明显下降,限制了其在新分子发现中的实际应用。该文章提出了一种联合分子模型JMM,将分子性质预测与分子结构重构整合到统一框架中,并根据模型重构输入分子的难度定义“陌生度”指标,用于衡量待测分子偏离训练化学空间的程度。通过30多个生物活性数据集的系统分析,结果表明,“陌生度”不仅能够有效识别分布外分子,还可以用于评估分类模型在不同化学空间中的预测性能。进一步针对两个具有临床意义的激酶开展虚拟筛选与湿实验验证,最终发现了7种具有低微摩尔活性、且与训练分子结构相似度较低的化合物。该方法为判断分子模型的适用域和预测可信度提供了新的依据,也为AI辅助发现结构多样的新型活性分子提供了具有实际价值的解决方案。
获取详情及资源:
0 摘要
分子机器学习模型往往难以泛化至训练数据覆盖范围之外的化学空间,从而限制了其对结构新颖生物活性分子进行可靠预测的能力。为提升机器学习突破训练化学空间“边缘”的能力,提出了一种将分子性质预测与分子重构相结合的联合建模方法。该方法进一步引入了基于重构的“陌生度”(unfamiliarity)指标,用于估计模型的泛化能力。通过对30多个生物活性数据集开展系统分析,结果表明,陌生度不仅能够有效识别分布外分子,还可以作为预测分类器性能的可靠指标。即使大规模分子库中存在显著的分布偏移,陌生度仍能提供稳健且具有实际意义的分子层面信息,而这些信息通常会被传统方法忽略。最后,针对两个具有临床意义的激酶,在湿实验中验证了基于陌生度的分子筛选策略,并发现了7种具有低微摩尔效力、且与训练分子相似度较低的化合物。结果表明,陌生度能够将机器学习的适用范围拓展至已探索化学空间的边缘之外,从而推动多样化、结构新颖分子的发现。
1 引言
分子机器学习正在药物早期发现中得到迅速应用。其中一个关键目标是在一个或多个药理靶点上识别新的生物活性分子,即“命中化合物”。在这一背景下,发现结构新颖的命中化合物对于满足尚未解决的治疗需求、确保商业可行性以及克服耐药性至关重要。然而,超越训练分子的结构特征,例如识别新的生物活性分子核心,对机器学习模型构成了重大挑战,因为模型在应用于分布外(out-of-distribution,OOD)分子时往往表现不佳。对于分子这类离散数据而言,这一问题尤为突出,因为它们很容易偏离模型训练期间学习到的数据分布。与此同时,具有高质量实验标注且结构多样的分子数据十分稀缺,生化实验的高成本和长周期进一步加剧了这一问题。因此,训练集通常仅包含数百个分子,而用于筛选的分子库可能包含数十亿种已存在但模型此前从未见过的化合物。由此产生的分布偏移,使利用机器学习发现结构新颖的命中化合物成为一项极具挑战性的任务。在这种情况下,量化模型在已探索化学空间“边缘”之外的预测可靠性具有重要潜力。
如何确保前瞻性命中化合物筛选中的预测可靠性,一直是该领域的重要研究方向。一种成熟的方法是定义适用域,即通过设定分子与训练数据相似度的阈值,划定能够进行可靠预测的化学空间。然而,这种方法未利用模型实际学习到的信息,并且由于依赖结构相似性,会限制结构新颖分子的发现。另一种广泛采用的方法是进行不确定性估计,即利用模型的预测置信度,通常通过概率建模技术实现。原则上,不确定性估计允许将结构新颖的分子纳入筛选,但模型在面对分布外样本时仍可能给出过度自信的预测。因此,如何对分布外分子作出可靠预测,仍是药物发现中分子机器学习面临的核心挑战之一。
为更有效地利用深度学习探索化学空间的“边缘”,同时评估分布外分子的预测可靠性,引入了生成式深度学习在从头分子设计中的最新进展,尤其是自编码器。自编码器可以将分子结构编码到低维潜在空间中,随后再将其解码并重构为原始形式。通过联合分子建模,同时训练深度学习模型执行分子性质预测任务,例如生物活性预测,以及输入分子重构任务。整个过程采用半监督学习方式,即同时利用有标注和无标注的分子数据进行学习。
这种联合学习方法不同于以往将自监督学习任务用于生成化学或提升预测性能的常见做法,而是直接利用分子重构能力作为分布外估计的代理指标。其核心假设是,重构效果较差的分子对模型而言更加陌生,说明它们更可能位于训练数据所学习分布之外。在此基础上,引入了“陌生度”(unfamiliarity)指标,用于表征模型对分子的重构能力,并量化该分子偏离训练分布的程度。
在涵盖33个具有实验标注的分子数据集的系统分析中,陌生度不仅能够稳健地表征分子分布偏移,还与分类器性能表现出较强相关性。陌生度识别结构多样且具有生物活性分子的能力进一步通过湿实验得到验证,并在两个激酶靶点上发现了多种具有低微摩尔活性的化合物。
总体而言,分子陌生度为估计模型泛化能力提供了一种具有明确依据的方法,即使存在分子分布偏移,仍能够用于评估模型表现。该方法为预测可靠性估计提供了新的视角,并可作为适用域和不确定性估计等既有方法的补充,从而更加准确、充分地指导结构新颖分子的发现。
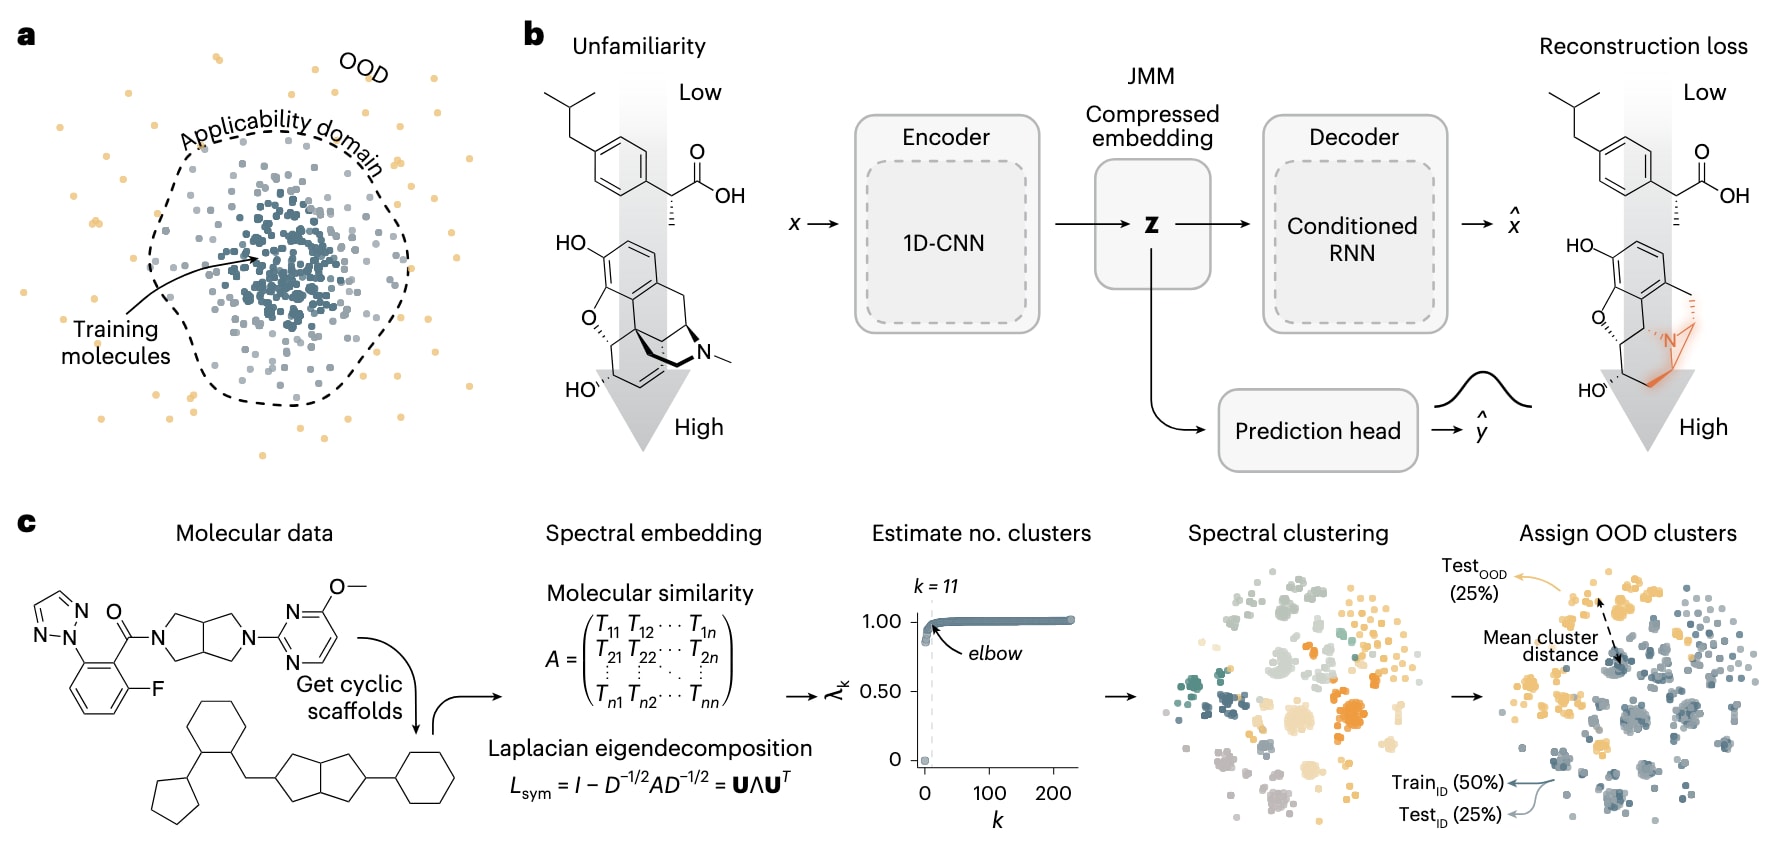
图1|通过联合建模估计分子数据的陌生度。 a,适用域的概念示意图。化学空间中接近训练数据的分子位于模型的适用域内;位于该边界之外的分子则被视为分布外(OOD)分子。 b,JMM的架构通过分子的重构损失来估计该分子对模型而言有多“陌生”。 c,通过谱聚类将分子数据划分为分布内和分布外两组,从而人为引入分子分布偏移。图中展示的是食欲素受体2(Orexin receptor 2,OX2R)数据集的结果。CNN,卷积神经网络。RNN,循环神经网络。
2 结果
下文将详细介绍联合分子模型(joint molecular model,JMM),定义陌生度指标,并展示其量化分子分布偏移的能力。随后,将分子性质预测与分布偏移联系起来,并利用这种关系估计预测可靠性。最后,在虚拟筛选案例中应用陌生度指标对候选分子进行优先级排序,并通过湿实验完成验证。
2.1 陌生度与联合分子建模
JMM基于半监督自编码器构建,并借鉴了分子生成建模领域的经典工作。首先,使用简化分子线性输入规范(Simplified Molecular Input Line Entry System,SMILES)字符串表示分子,以文本形式编码分子拓扑结构以及原子和化学键类型。随后,利用一维卷积神经网络将SMILES字符串编码为压缩的潜在向量
编码器—解码器首先在ChEMBL约120万个未标注分子结构上进行预训练,该数据规模足以使模型学习SMILES字符串的“语法”。随后,利用各个带标注分子对模型进行微调,并将相同的潜在表示
分子重构性能通过重构损失进行量化。该损失定义为SMILES字符串中所有词元负对数似然损失的总和,并按照SMILES词元长度进行归一化:
其中,
根据重构损失,可进一步得到陌生度指标
陌生度指标取决于词表大小
2.2 检测分子分布偏移
为考察陌生度评分能否反映分子分布偏移,收集了33个具有实验标注的数据集,涵盖不同的生物学性质和数据规模。随后,将各数据集划分为分布内分子和分布外分子。首先,基于分子环状骨架进行谱聚类,其中环状骨架是指不含环外取代基的核心环系,以确保结构相似的分子被稳定地划分至同一聚类。根据各数据集中的聚类距离,将距离最远的若干聚类作为分布外测试集
为确认
- 扩展连接指纹(extended connectivity fingerprints,ECFP)相似性。ECFP用于表征以原子为中心的子结构,在分子环状骨架上计算,并使用Tanimoto系数量化相似性。
- 结构核心重叠程度。通过计算分子图之间最大公共子结构(maximum common substructure,MCS)所占比例进行量化。
- 药效团相似性。基于Chemically Advanced Template Search(CATS)描述符计算,并使用余弦相似度进行量化。
在所有相似性指标下,
为评估这种分布偏移对预测性能的影响,使用分子描述符训练了三种成熟的分子性质预测模型,包括结合ECFP的随机森林(random forest,RF)和多层感知机(multilayer perceptron,MLP),以及结合CATS药效团描述符的随机森林。通过平衡准确率进行评估时,这些基线模型在
在建立基线后,进一步评估了JMM在各数据集上的分类性能。JMM在
无论是否使用重构解码器训练JMM,模型的分类性能均未发生显著变化,其中
随后,对训练数据中具有充分结构表征的分子是否比“陌生”的分布外分子更容易被JMM重构进行了验证。针对每个训练完成的JMM,分别计算对应
陌生度差异并非由SMILES字符串长度或复杂程度、分支数量、分子图复杂度、分子量或官能团数量等因素造成。结果说明,模型重构分子的能力主要取决于分子与训练数据分布的接近程度,而不是分子本身的复杂性。
在
2.3 陌生度与生物活性预测
由于分子重构与分子性质预测依赖相同的潜在表示,因此进一步评估了陌生度
- 与训练集分子的相似性(数据驱动):通过平均药效团相似性、环状骨架相似性或分子核心重叠程度进行衡量。
- 嵌入距离(模型驱动):定义为分子嵌入向量
与训练集中已学习嵌入表示之间的平均Mahalanobis距离。 - 预测不确定性(模型驱动):基于分类器的近似贝叶斯建模进行估计。
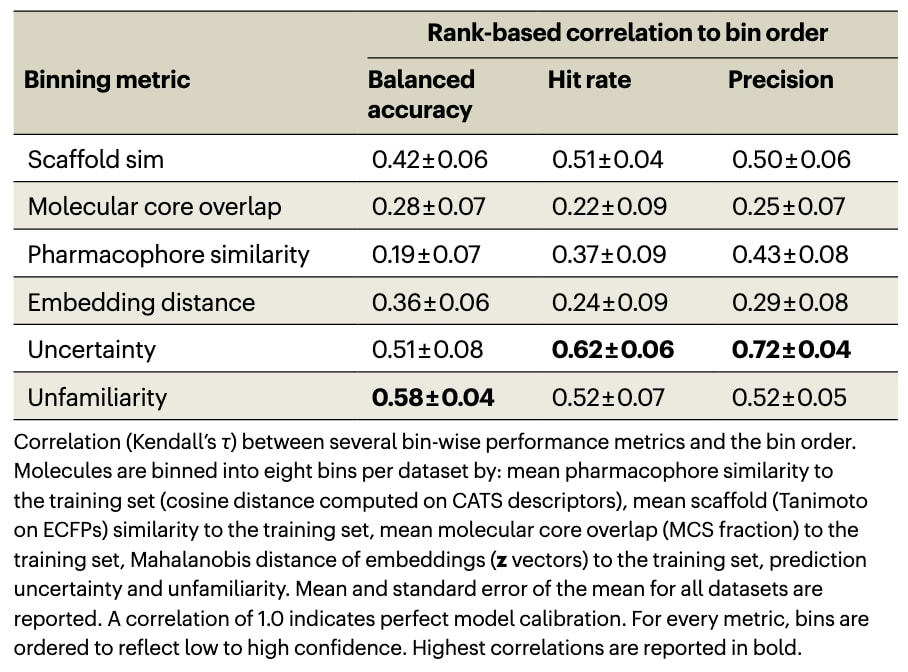
结果表明,在平衡准确率、命中率和精确率等指标下,所有测试的可靠性度量均能够在一定程度上反映模型的预测性能。预测不确定性和陌生度与模型性能之间表现出中等至较强的相关性。换言之,在数据集层面,当预测不确定性或陌生度较高时,模型更容易产生错误的生物活性预测;而对于这两项指标较低的分子,模型通常能够作出较为准确的预测。
值得注意的是,陌生度与预测不确定性这两项指标本身几乎不存在明显相关性,Spearman相关系数为
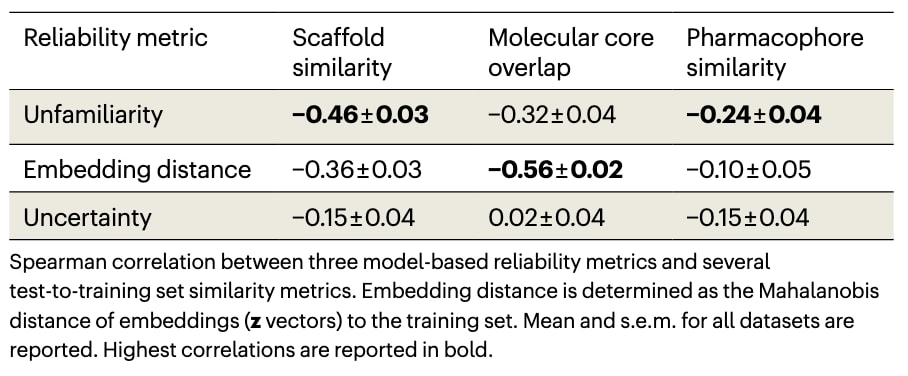
总体而言,“模型驱动”的可靠性指标优于所有“数据驱动”方法。后者主要依赖预先定义的分子描述符和相似性度量计算待测分子与训练集之间的距离。结果说明,模型能够从训练数据中提取仅凭预定义分子相似性指标难以充分表征的信息。
有趣的是,尽管陌生度和嵌入距离都能够反映JMM学习到的部分结构相似性信息,但陌生度在衡量预测可靠性方面明显优于分子嵌入与训练集嵌入之间的距离。换言之,与分类器直接使用的内部嵌入表示相比,模型根据内部表示重构分子的能力能够为预测可靠性提供更多信息。这说明,从嵌入表示重构分子不仅有助于评估预测可靠性,也能够反映嵌入表示本身的质量。相关结果进一步证实,简单的嵌入距离指标难以捕捉影响特定任务结果的“化学细微差异”,而嵌入表示的质量更适合通过下游任务进行评估,而不是仅根据其与训练集嵌入表示的接近程度进行判断。
此外,结果进一步揭示了嵌入距离、陌生度和预测不确定性之间的差异。陌生度和预测不确定性均能够独立地与模型性能相关,但预测不确定性与分子的结构性质并不存在较强联系。相比之下,陌生度能够同时反映分子相似性和预测性能。换言之,嵌入距离主要反映
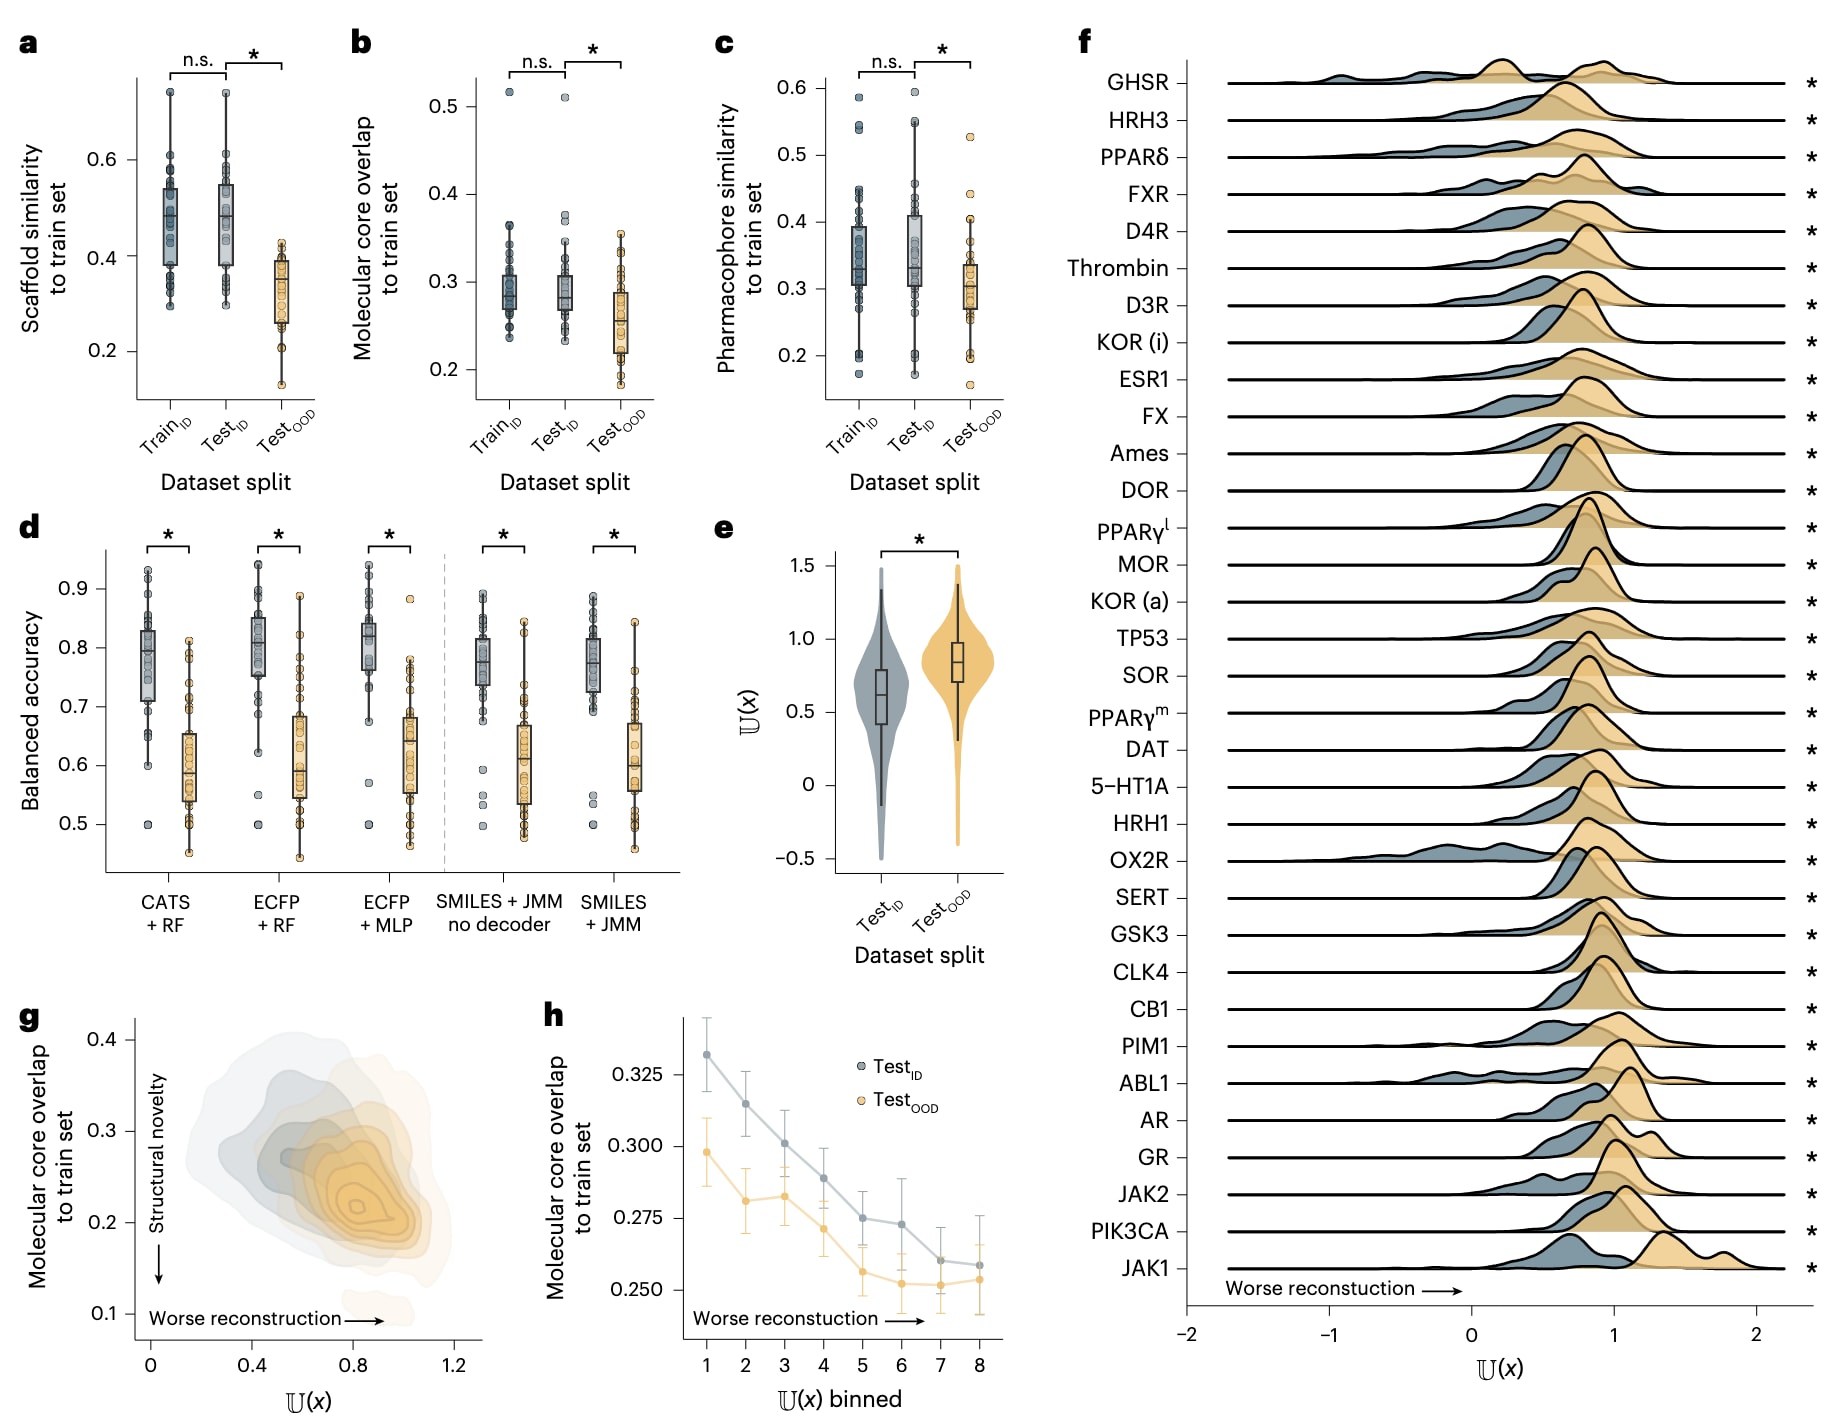
图2| 使用陌生度评分检测人为引入的分子分布偏移。 a,标注数据集中各数据划分相对于其训练集的平均骨架相似性(
表1|可靠性指标与训练集相似性的相关性
2.4 虚拟命中化合物筛选
为进一步探索陌生度在化学空间导航中的作用,将分析扩展至大规模筛选库,以模拟更接近实际应用的虚拟筛选场景。尽管这些分子库缺少活性标注,因而无法直接评估模型性能,但其包含规模更大、结构更加多样的分子集合,可能呈现出此前较小测试集中未能观察到的分布差异。
从Asinex、Specs和Enamine三个可靠的商业筛选库中整合了约140万个分子,并使用全部33个训练完成的模型进行推理。筛选分子与训练集之间的结构重叠程度甚至低于
在这一大规模分子库中,预测不确定性与分子相对于训练数据的结构相似性几乎不存在直接相关性,Spearman相关系数为
在整个分子库以及单个蛋白质靶点层面,预测不确定性与陌生度均表现出明显不同的分布特征。以丝氨酸/苏氨酸蛋白激酶PIM1为例,高陌生度分子通常具有较为异常或偏离常见生物活性化学空间的结构;低陌生度分子则更常呈现生物活性分子的典型特征,例如类固醇结构和已知生物活性核心。在PIM1相关分子中,低陌生度分子还包含嘧啶酮核心等经典药效团。
陌生度与药物相似性的定量估计值之间不存在明显相关性,Spearman相关系数为
表2|可靠性指标与模型性能的相关性
2.5 前瞻性虚拟筛选
为在真实条件下前瞻性验证所提出的方法,对一个包含约18万个类药分子的商业化合物库进行了筛选,以寻找两个具有药理学意义的激酶靶点PIM1和细胞周期蛋白依赖性激酶1(cyclin-dependent kinase 1,CDK1)的抑制剂。值得注意的是,CDK1数据未用于其他分析,因此可作为完全独立的测试案例。
针对每个靶点,利用全部可用数据分别训练JMM,其中PIM1包含1443个训练分子,CDK1包含312个训练分子,随后对整个筛选库进行生物活性预测。分子按照其与所谓“乌托邦点”的距离进行排序。乌托邦点是同时平衡多个目标的几何最优点。以预测生物活性
- 高
、高 和低 。 - 高
、低 和低 。 - 高
、低 和高 。
为减少筛选分子与训练数据之间以及候选分子彼此之间的结构重叠,排除了与训练集或其他已选分子的ECFP Tanimoto系数不低于0.70的化合物,从而进一步增加模型在训练分布之外进行预测的难度。
最终优先筛选出的60个分子均与对应训练集具有较大的结构距离。PIM1候选分子与训练集的最大ECFP Tanimoto系数为
随后,对每个靶点活性最高的6个化合物进行进一步表征,以测定剂量—反应曲线及相应的半数抑制浓度
对于CDK1,整体抑制作用相对较弱,这可能与其训练集仅包含312个分子有关。只有化合物40获得了完整的剂量—反应曲线,并表现出部分抑制,其
总体而言,此次筛选中PIM1的命中率约为17%,即30个化合物中有5个表现出明确的剂量—反应抑制;CDK1的命中率约为7%,即30个化合物中有2个表现出明确抑制,同时还发现了若干弱活性化合物。这些命中率高于传统激酶筛选通常报道的0.1%至5%。值得注意的是,所有命中化合物与训练分子的最大子结构相似度均低于38%,该相似度通过ECFP Tanimoto系数衡量,并且这些化合物均完全通过前瞻性的机器学习引导筛选获得。
由于每种策略测试的化合物数量有限,且未采用完整的
尽管这些前瞻性结果仍属初步验证,但已提供了实际证据,表明该方法能够发现结构新颖的生物活性分子,同时支持将陌生度作为分布偏移条件下探索化学空间的一项有效指标。
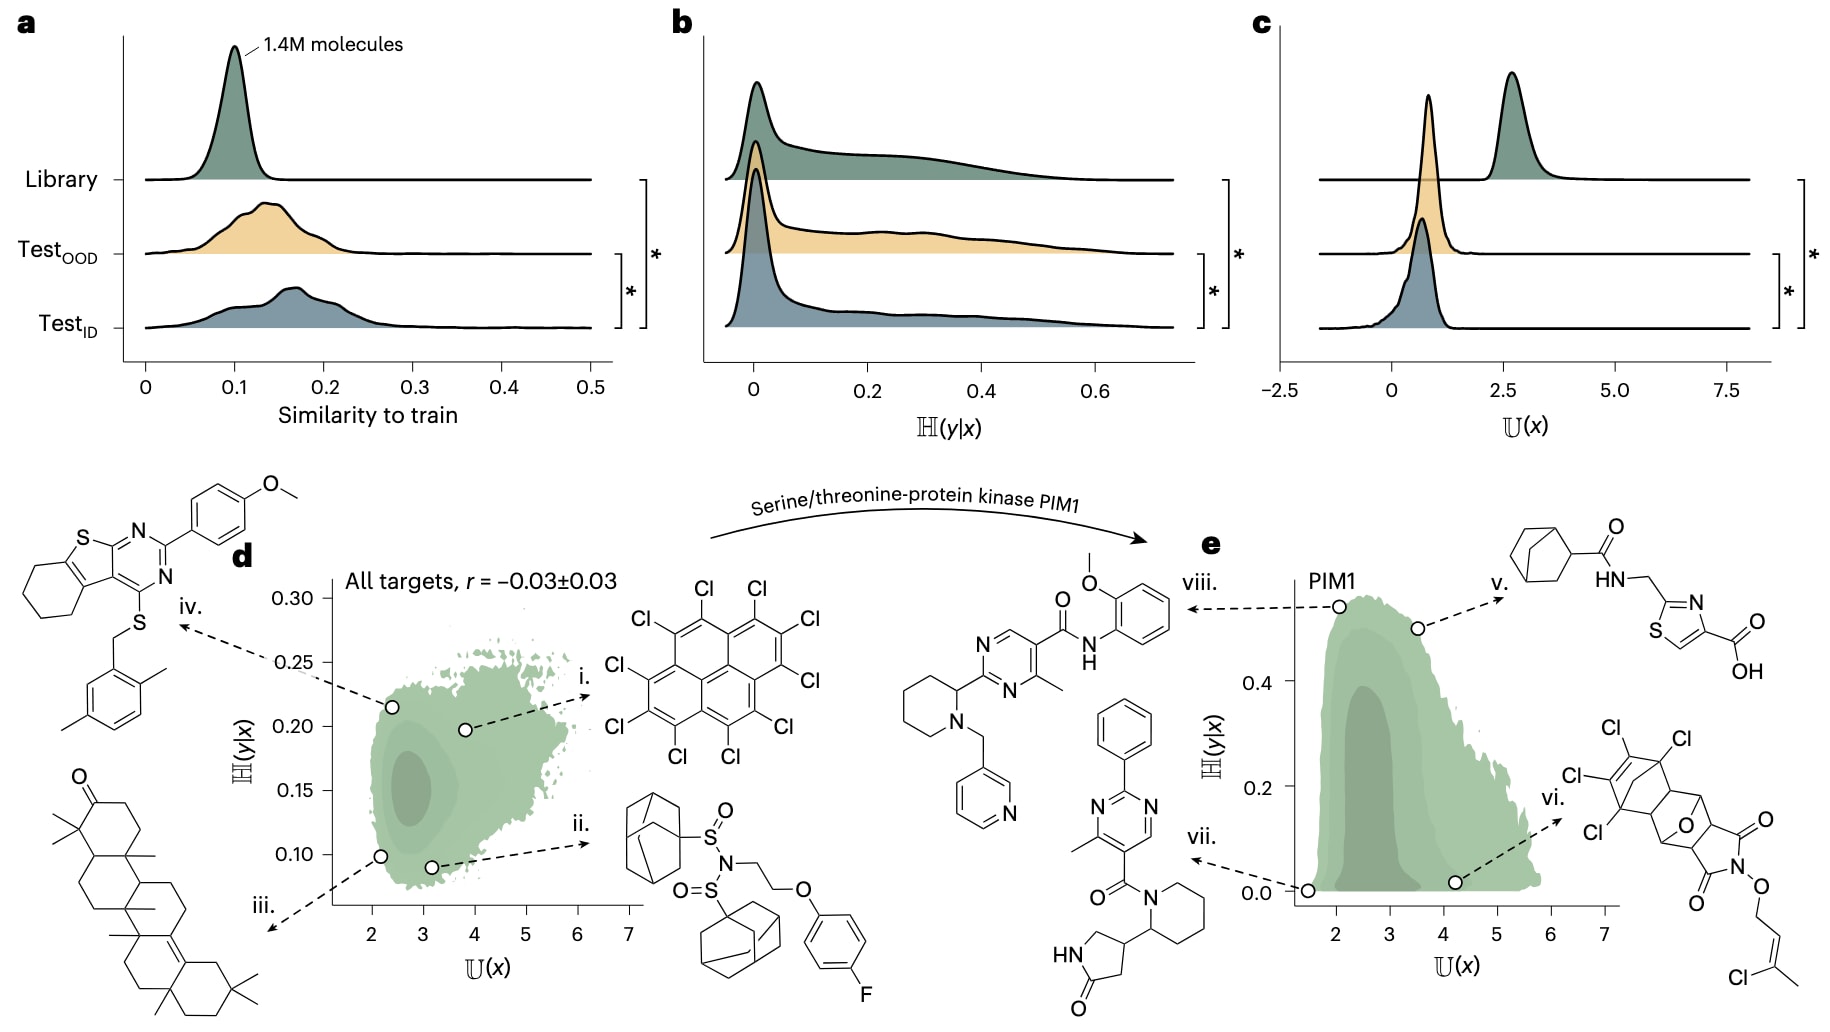
图3|对140万种商业可获得分子进行虚拟筛选。 所有模型导出的评分均表示10折Monte Carlo交叉验证的平均值(验证集样本占10%)。 a,相对于各自训练集,
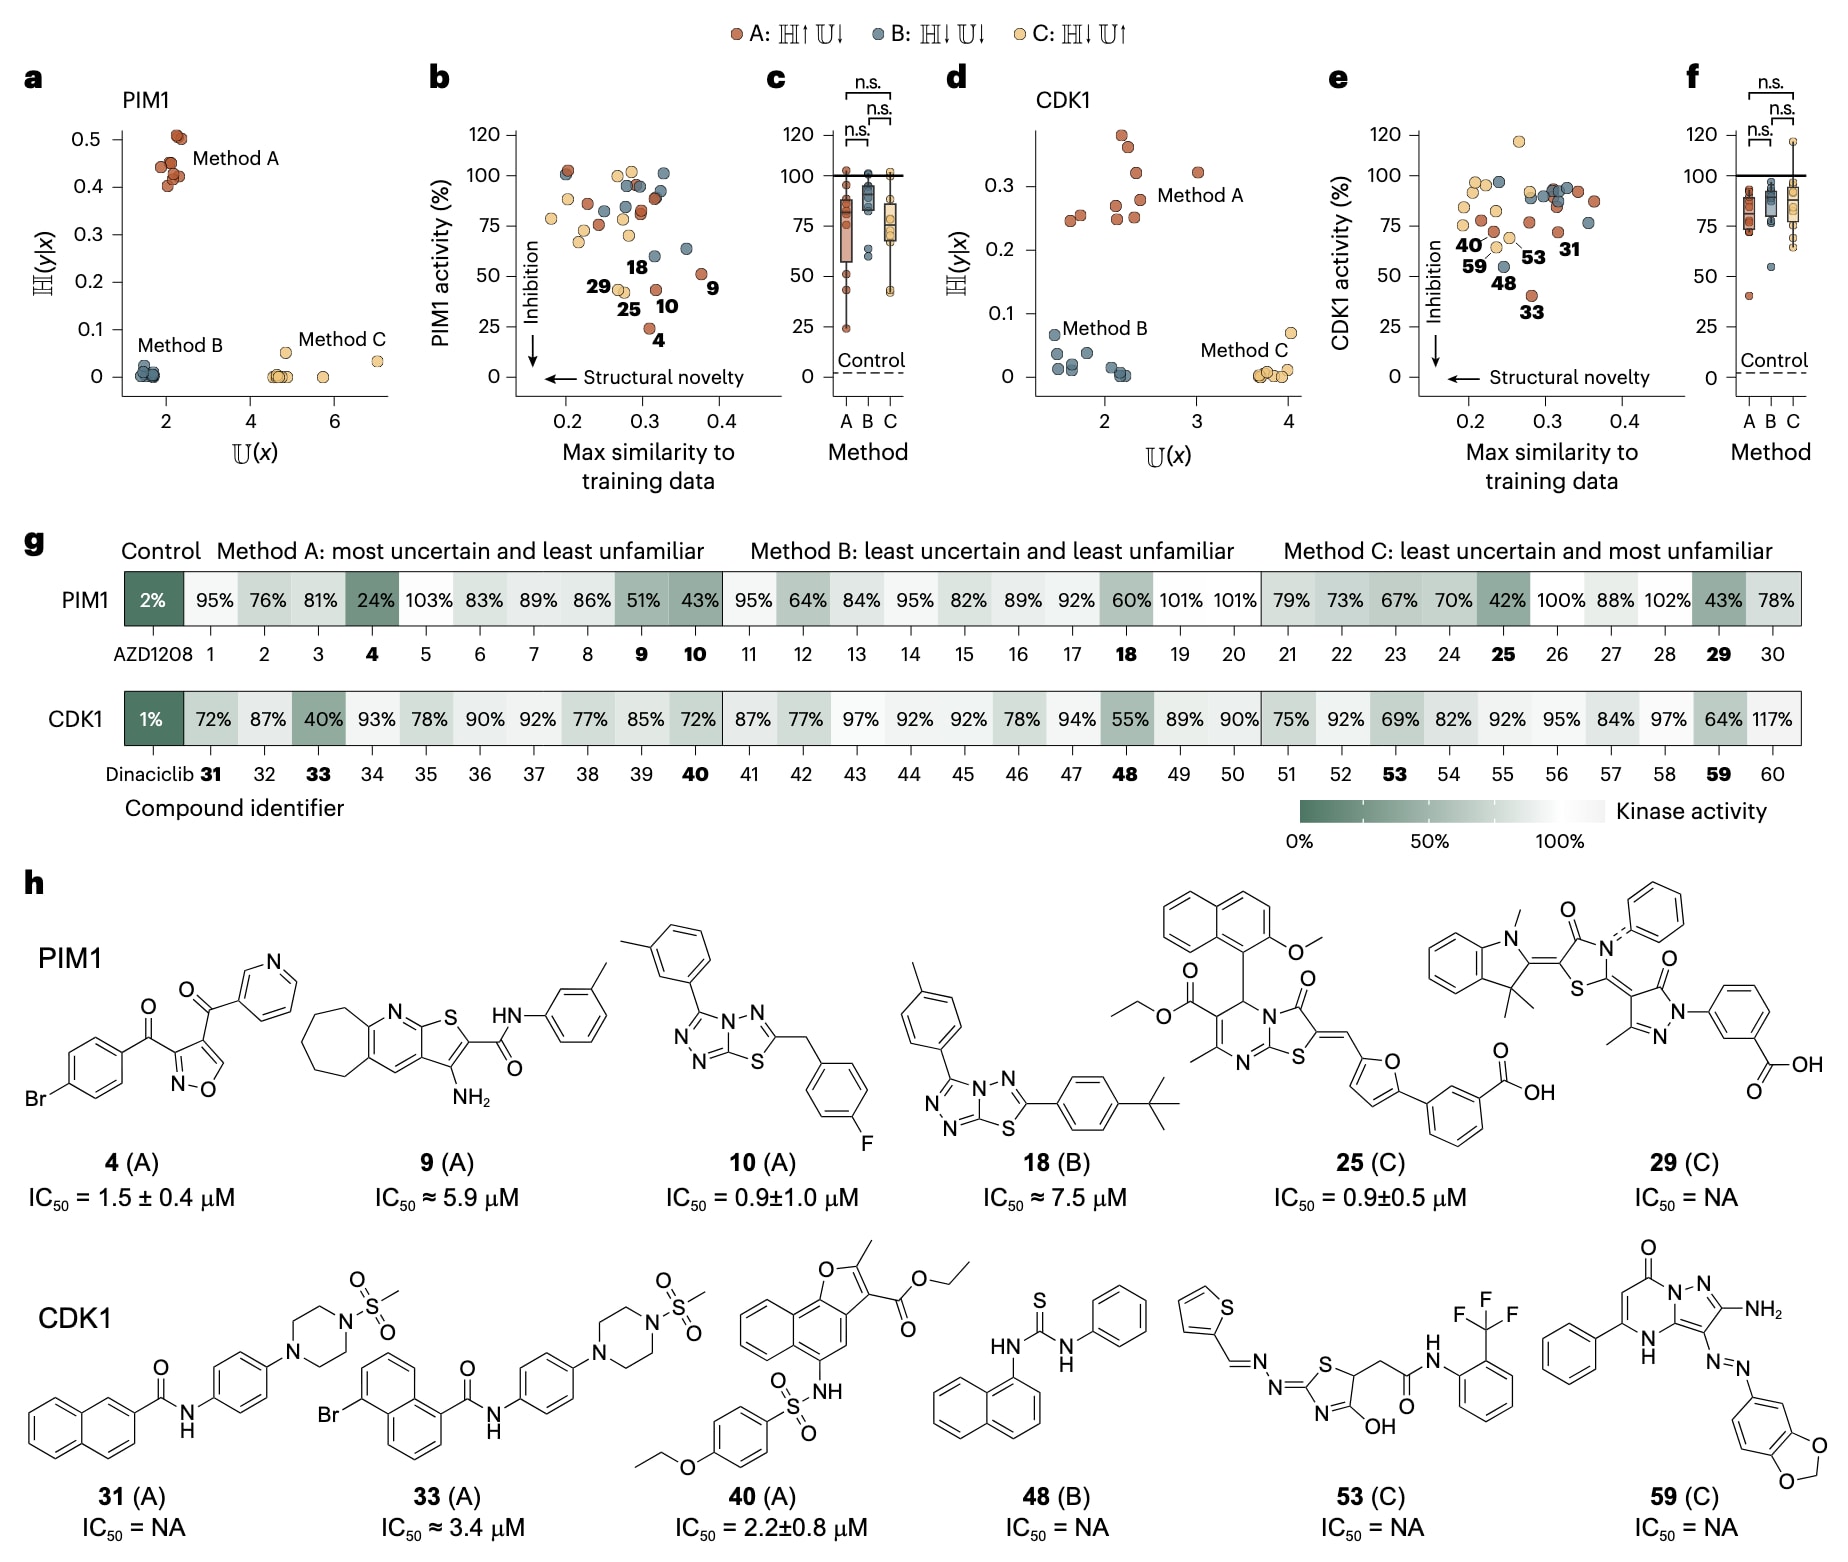
图4| PIM1和CDK1的实验筛选。 化合物筛选基于10折Monte Carlo交叉验证所得的平均陌生度评分和不确定性估计(验证集样本占10%)。除阳性对照化合物(AZD1208和dinaciclib)外,所有激酶活性测定结果均表示3次技术重复的平均值。 a,采用三种不确定性与陌生度组合策略,从约18万个化合物组成的分子库中筛选出10个最有前景的PIM1抑制剂:A,最高不确定性且最低陌生度;B,最低不确定性且最低陌生度;C,最低不确定性且最高陌生度。 b,在
3 讨论
引入了“陌生度”这一指标,用于表征分子与深度学习模型所学习数据分布之间的距离。陌生度通过联合建模方法计算,该方法同时执行分子重构与性质预测任务。通过衡量模型重构此前未见分子时产生的误差,陌生度能够量化分子分布偏移。结果表明,当模型应用于新分子时,陌生度是评估预测可靠性的一项稳定且有效的指标。作为分类预测可靠性指标,陌生度与通过近似贝叶斯建模估计的预测不确定性具有相近的信息价值,但两者彼此独立。与预测不确定性不同,陌生度还能够反映分子与模型所学习数据分布之间的结构距离。尤其是在大规模虚拟筛选中,面对明显的分布偏移时,陌生度提供的分子层面信息远比不确定性估计更加具有实际意义。陌生度与预测不确定性在可靠性评估中的互补性,进一步体现了陌生度在分子机器学习中的应用价值。
前瞻性验证进一步说明,陌生度可以有效补充基于不确定性的分子优先级排序。尽管训练集规模较小,且每个靶点仅筛选了少量化合物,仍发现了多种具有低微摩尔活性的分子。相比之下,当模型在训练数据支持范围之外运行时,预测不确定性似乎无法有效反映模型性能。这说明,结合陌生度进行分子筛选,有望更加充分且精确地探索化学空间,并为发现新的候选分子提供更多机会。
相关结果支持采用陌生度替代传统基于相似性的适用域定义方法。此外,陌生度有望揭示通过分子相似性方法无法检测,或被不确定性方法低估的分布偏移,因此适合用于大规模分子库筛选。更重要的是,陌生度分布能够揭示模型已学习数据分布中的空缺,因此可用于指导强化学习应用,也可超越“一次性”虚拟筛选,扩展至主动学习等迭代策略,以辅助确定后续需要获取的分子。
总体而言,联合建模的优势不仅体现在从头分子设计中,也体现在对结构—活性关系的刻画方面。联合建模与陌生度所提供的信息,有望推动更可靠、泛化能力更强的模型发展,从而以更高的可信度和精确性加速探索化学空间中的新区域。