Science 2026|基于深度学习的 RNA 假结从头设计
RNA 分子能够形成复杂的二级与三维结构,并参与翻译、病毒复制、核酶催化和基因调控等关键生命过程。然而,相比蛋白质设计,RNA 从头设计长期受限于三维结构预测精度不足,尤其是具有复杂拓扑的假结结构。近期,一项发表于 Science 的研究借助 Eterna OpenKnot 挑战,系统比较了深度学习方法与资深人类设计者在 RNA 假结设计中的表现。研究发现,在 RNet 化学图谱基础模型的辅助下,MPNN、gRNAde 和 Struct2SeQ 等 AI 方法能够高精度设计此前未见的天然及人工假结,并在 57 个目标上达到与人类设计者相当的水平。SHAPE、补偿性突变和冷冻电镜进一步证实,AI 设计不仅能够准确恢复目标二级结构,还可形成包含非典型经典三级相互作用的全新三维折叠。这项工作表明,高精度 RNA 三维结构预测或许并非复杂 RNA 从头设计的必要前提。
获取详情及资源:
0 摘要
长期以来,RNA 设计受到三维(3D)结构预测精度有限的制约。该研究表明,借助当前深度学习工具,通过准确从头设计假结二级结构,可以生成复杂的 RNA 结构。在一项包含 57 个 RNA 假结的 Eterna 竞赛中,生成式人工智能(AI)方法在解决大多数盲测挑战时达到了经验丰富的人类设计者水平。设计结果通过单核苷酸分辨率化学图谱、补偿性突变分析和冷冻电镜进行评估。
AI 生成的 RNA 分子不仅具有准确的二级结构,还能够形成高度有序的三维折叠,并由设计过程中未显式建模的非经典三级相互作用加以稳定。该设计过程由一个基于既往化学图谱数据训练的 RNet 基础模型提供指导。结果表明,部分具有较高难度的 RNA 设计任务可能无需首先解决 RNA 三维结构预测问题,即可实现有效设计。
1 引言
复杂 RNA 结构参与多种基础生物学过程,包括翻译、病毒复制,以及近年来不断发展的生物技术和药物应用。在人类专家开展 RNA 设计的开创性工作基础上,近年来 RNA 结构设计能力持续提升,应用范围已从 mRNA 疫苗扩展至核酶和复杂的 RNA 折纸结构。然而,这些工作仍主要局限于简单 RNA 二级结构的设计、已知 RNA 结构的重新设计,或利用少量经过充分表征的经典三级结构基元进行组装。
基于深度学习的方法已经能够设计出与已表征 RNA 结构相似、但序列差异显著的 RNA 分子。然而,对于此前未知结构的从头设计,尽管这一任务在蛋白质领域已较为常规,但在 RNA 领域尚未实现。RNA 设计的发展长期受到 RNA 二级和经典三级结构预测精度不足的限制,尤其是在合成 RNA 分子中更为突出,因为这类分子通常缺乏具有进化相关性的序列和结构信息。
假结(pseudoknot)是一类复杂的 RNA 二级结构,其茎环区域中的核苷酸可与该茎之外的环区形成碱基配对。越来越多的天然假结被发现可作为核酶、核糖开关和核糖体移码信号发挥功能,这些功能通常依赖具有明确定义茎区的复杂三维(3D)拓扑结构。然而,此前自动化设计新型假结仅在一类特殊的 RNA 折纸分子中实现,而基于通用经典三级结构基元组装的方法尚未达到这一目标。
2024 年,Eterna 平台 OpenKnot 挑战中的人类参与者开始实现新型假结的高精度设计。相关设计通过数百万个 RNA 分子的实验进行评估和优化,其二级结构利用选择性
与此同时,基于深度学习的 RNA 从头设计算法也相继提出,但其在此前未见过的二级和经典三级结构上的设计能力尚未得到实验验证。这些进展促使 OpenKnot 挑战进一步扩展,以直接比较这些新型 AI 算法与经验丰富的 Eterna 人类参与者之间的设计性能。
2 AI 设计与资深人类设计者的基准比较
扩展后的 OpenKnot 挑战第一轮邀请了 6 种 AI 方法提交设计,并通过 SHAPE 实验进行评估。在 SHAPE 实验中,单链及构象较为灵活的核苷酸,其
第一轮包含 17 个目标二级结构,其中 11 个来自实验三维结构已收录于蛋白质数据库(Protein Data Bank,PDB)的 RNA,另外 6 个则是 Eterna 参与者基于此前部分成功的设计尝试提出的合成假结(表 S3–S4 和图 S1A)。对于部分源自 PDB 的目标,其天然序列已知能够形成不同的构象状态。例如,在第一轮目标 W03 中,来源于丙酮丁醇梭菌(Clostridium acetobutylicum)的一种环二鸟苷酸单磷酸感应 RNA,即 c-di-GMP-II 核糖开关,其长茎结构在缺少小分子配体时,根据 SHAPE 测定结果,大部分并未形成(图 1D)。因此,即使对于已有天然序列的目标,挑战的核心仍然是寻找能够在缺乏稳定化结合伴侣的溶液环境中稳定目标假结的全新序列。
每种 AI 方法和每位 Eterna 参与者最多可提交 20 个设计。部分需要输入三维主链结构的方法(表 S2)无法为缺乏 PDB 结构的 6 个目标生成设计。整个 OpenKnot 挑战中的设计均在不加入小分子配体的条件下进行实验检测,以确保假结的形成主要源于序列设计本身,而非配体的稳定作用;随后开展的加配体 SHAPE 测量也支持这一实验设置(图 S2 和补充文本)。
不同方法的表现差异较大。许多 Eterna 设计获得了与目标二级结构高度一致的实验 SHAPE 图谱,即高、低反应性区域分别对应预期的非配对和配对核苷酸(图 1,B 和 E)。每个设计的实验 SHAPE 图谱与目标二级结构之间的一致性通过 OpenKnot score 进行量化。该指标计算 SHAPE 反应性符合结构预期的核苷酸比例,取值范围为 0–100。部分 Eterna 设计超过了设定为 90% 的成功阈值(图 1,F 和 G;图 S3A;数据 S1)。该阈值依据实验测量本身的不确定性,以及 SHAPE 方法在已知结构 RNA 二级结构判定中约 10% 的误差率确定。获得高分的 Eterna 参与者综合使用了平台内置工具、经验直觉及多种不同的设计策略。
第一轮中,大多数 AI 方法,包括 Rosetta、Rosetta-LoRes、3DRNA、gRNAde 和 MPNN-RFdiff,均未能跨越成功阈值,整体表现低于 Eterna 人类参与者(图 1,E–H 和补充文本)。其中一个例外是 MPNN-fixbb,这是一种针对固定输入主链设计序列的消息传递神经网络,其工作方式类似于 ProteinMPNN。对于 W03 目标,MPNN-fixbb 生成的序列平均表现优于初始天然序列(图 1,C 和 G)。
值得注意的是,许多表现最佳的 MPNN-fixbb 设计以及部分高分 Eterna 设计,与初始序列之间存在明显差异,序列一致性低于 50%(图 1F)。此外,所有与初始序列一致性超过 90% 的设计得分均低于 80%,表明偏离天然序列对于稳定目标假结可能至关重要。
第一轮结束后,研究人员发现,一个基于此前约 100 万条 RNA 化学图谱数据训练的神经网络 RNet,能够预测 SHAPE 图谱,并据此得到与实验得分大体一致的模拟分数,尤其能够较好重现表现较差设计的实验结果(图 S4)。这一结果提示,RNet 建模可以用于在实验前对候选设计进行前瞻性筛选。
随后,第一轮的 17 个目标在第二轮中再次提供给所有设计者。Eterna 设计者可通过交互式界面使用 RNet,而部分 AI 方法也被更新以纳入 RNet 信息,包括 gRNAde、MPNN-RFdiff、MPNN-fixbb,以及新加入的 codesign-RFdiff。第二轮中,人类设计者和 AI 方法的表现均得到明显提升,例如在 W03 c-di-GMP-II 核糖开关目标上尤为显著(图 1I 和图 S3B)。
综合全部 17 个目标,所有接受测试的 AI 方法以及 Eterna 人类参与者,都能够在其所设计的目标中至少有 80% 获得高于 90 的得分(图 1J 中浅色柱),不同方法之间未观察到显著差异。对于第一轮和第二轮,研究还采用了参考结构预测关键评估(Critical Assessment of Structure Prediction)流程构建的另一套基于 Z-score 的评价方法,得到的排序结果与 OpenKnot score 基本一致(图 S5,A 和 B)。
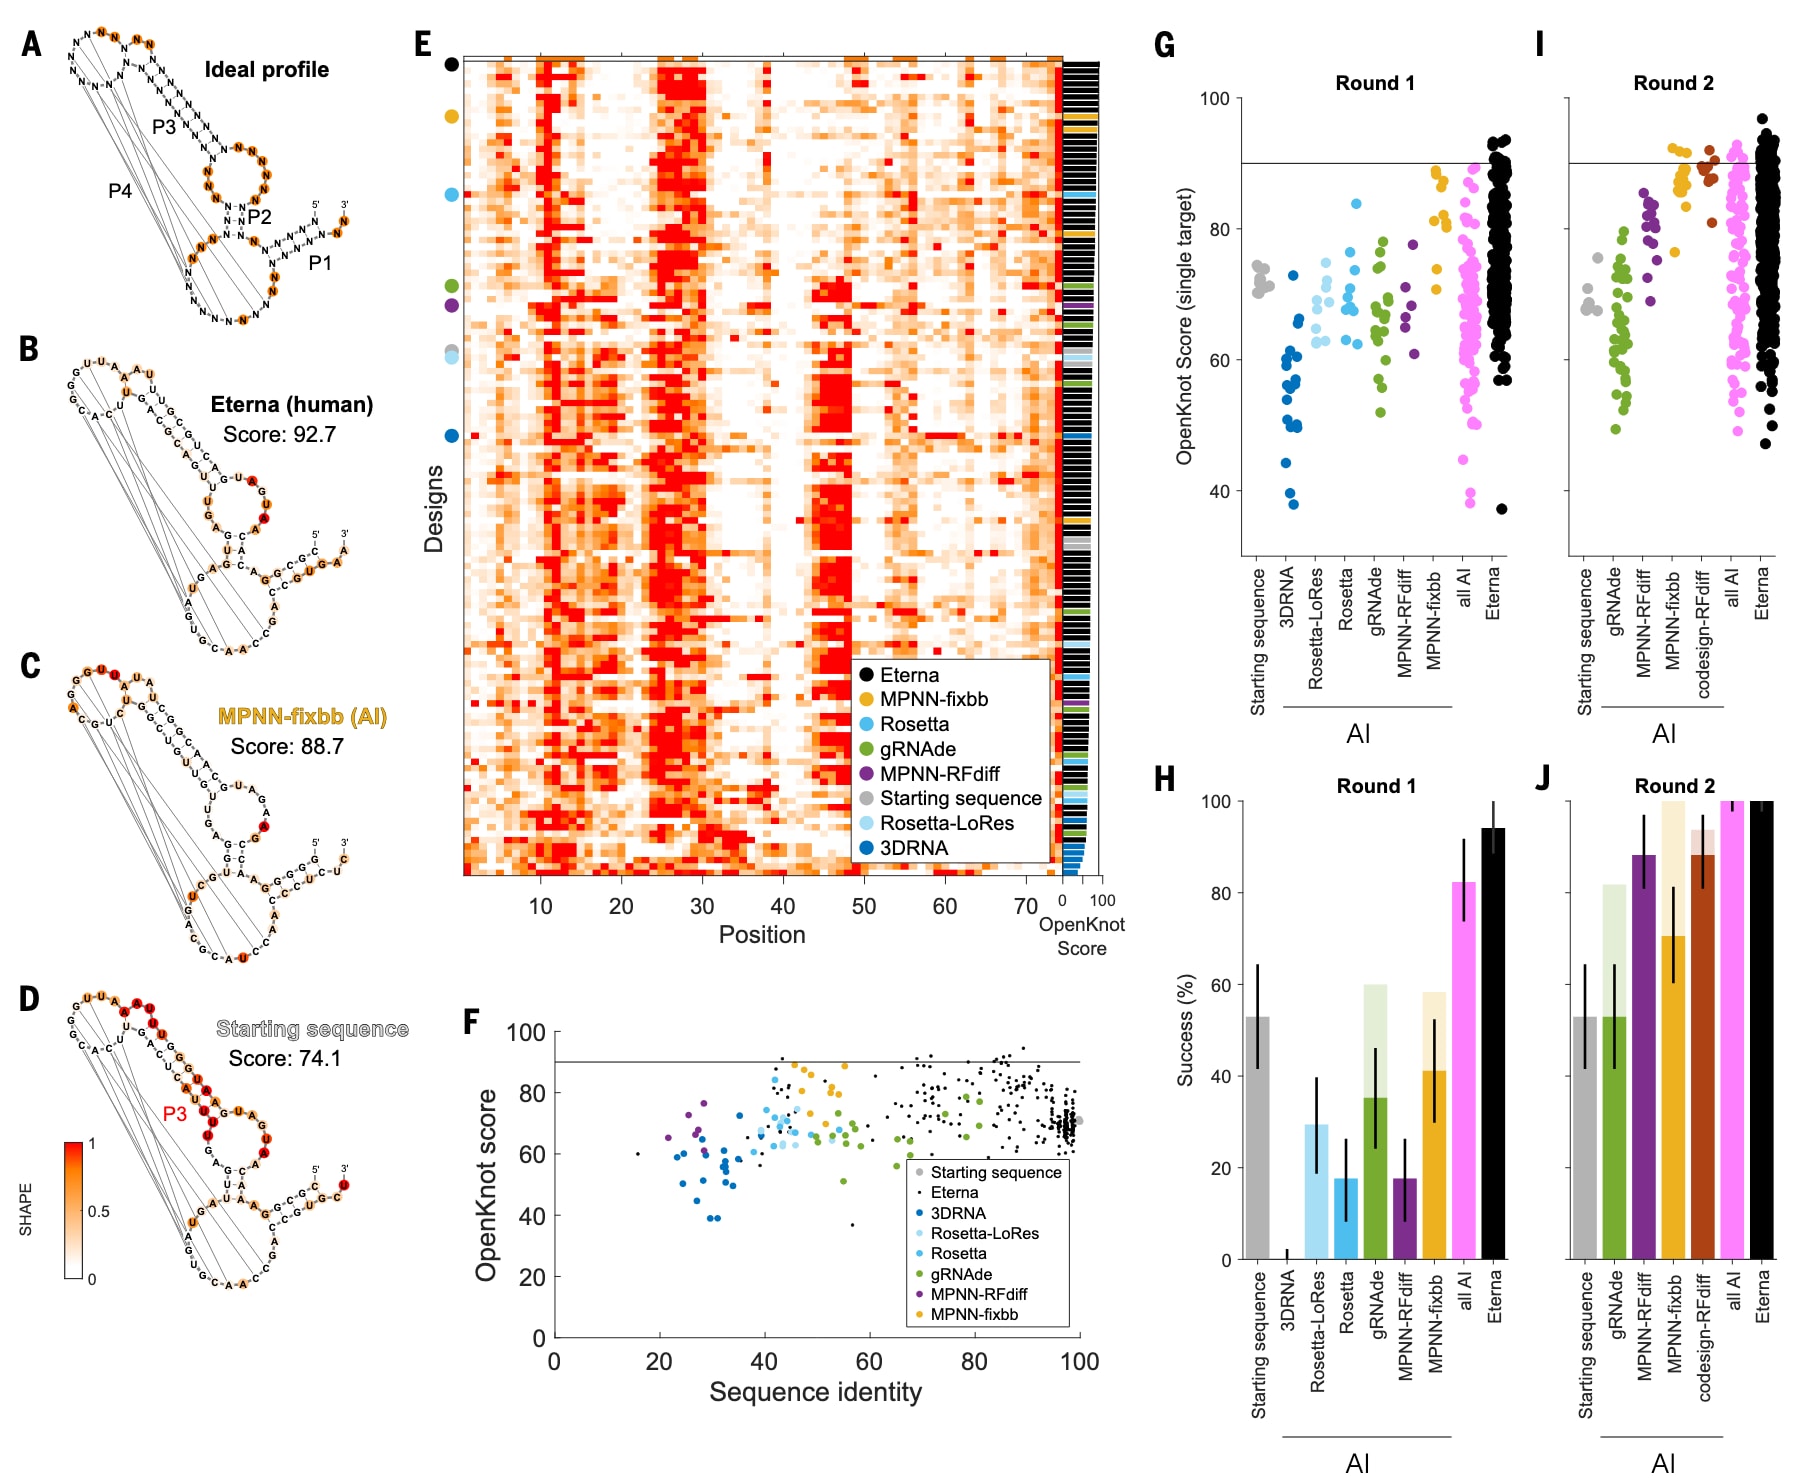
图1|17 个初始目标上的设计性能。 A–D,目标 W03(c-di-GMP-II 核糖开关)的二级结构,其中分别根据理想 SHAPE 数据(A),以及不同设计的实验 SHAPE 数据进行着色,包括 Eterna 人类参与者的最佳设计(B)、MPNN-fixbb 的最佳设计(C)和野生型 RNA,即天然 c-di-GMP-II 核糖开关适配体(D)。D 中红色标记表示 P3 茎区,该区域的 SHAPE 反应性表明 RNA 骨架具有较高柔性,与目标结构不一致。E,第一轮中针对 W03 目标测试序列的 SHAPE 反应性,显示不同设计与理想目标图谱(顶部)之间存在较大差异;这种一致性通过基于 SHAPE 的 OpenKnot score 进行量化(最右侧柱状图)。F,与初始序列具有较低序列一致性(<50%)的设计同样能够与目标 SHAPE 图谱实现良好一致(OpenKnot score >90)。G–J,不同设计方法的性能汇总,其中 G 和 I 为 W03 的 OpenKnot score,H 和 J 为 W01–W17 各目标中成功设计所占比例,这里的成功定义为 OpenKnot score >90。H 和 J 中,误差线表示标准误;实色柱表示在全部 17 个目标上的成功率,浅色柱表示仅在实际提交设计的目标上的成功率。从第一轮(G、H)到第二轮(I、J),各方法的设计性能均呈现明显提升。
3 对此前未见假结目标的泛化能力
上述结果表明,在相同的 17 个目标上,AI 设计方法和 Eterna 参与者都能够从此前的设计探索中学习,从而使第二轮的表现较第一轮得到提升。为了检验这些方法的泛化能力,第三轮进一步引入了 20 个全新的假结作为目标二级结构(图 2,A–C;图 S1C;表 S5)。
与第一轮和第二轮相比,第三轮中来自 PDB 已有实验三维结构 RNA 的目标数量由 11 个减少至 5 个,以尽量降低 AI 方法因记忆训练集而获得优势的可能性。另外 5 个目标二级结构来自 Pseudobase,这是一个由专家整理的天然假结数据库。其余 10 个目标则从 Eterna 参与者提出的二级结构中筛选获得。
为了进一步检验方法的通用性,研究同步开展了第四轮挑战,引入另外 20 个长度更长的目标,最长达到 240 个核苷酸(nt),这些目标同样来源于多种不同的数据来源(图 2,D–F;图 S1C;表 S5)。为了使所有方法都能够针对缺少 PDB 实验结构的目标进行设计,研究为这些目标提供了计算建模得到的三维结构。
SHAPE 表征结果有力支持了 AI 方法和 Eterna 参与者的设计性能。每一种深度学习设计方法均优于对应的初始序列,而第四轮中较长目标的初始序列 OpenKnot score 尤其偏低。将不同方法汇总后,AI 方法和 Eterna 方法在第三轮的 20 个目标中均有 19 个目标实现了 OpenKnot score
只有一个目标无法被任何方法或 Eterna 参与者设计至 OpenKnot score >90,即 P16(AK_PK100-3;图 2B 和补充文本)。除 P16 外,成功案例涵盖了多种由 Eterna 参与者提出的复杂假结,例如 Kissing Multiloops(图 2A)和 SV_i(图 2E),还包括一种来自天然 RNA、但三维结构尚未知的假结——劳斯肉瘤病毒(Rous Sarcoma Virus)移码信号(图 2D)。
对于第四轮中的长 RNA 目标,这些设计方法取得的成功尤其突出,因为对应的初始序列在 20 个目标中仅有 4 个达到成功标准(图 2F 中的 starting sequence)。
表现领先的 AI 方法包括一种不需要三维结构输入的新型图神经网络 gRNAde 变体,以及首次加入该挑战的 Struct2SeQ。Struct2SeQ 是一种基于深度 Q 学习的强化学习方法,其训练和设计引导完全依赖 RNet 模型(表 S2 和材料与方法)。
在第三轮和第四轮中,MPNN、gRNAde 和 Struct2Seq 各自最佳方法之间的性能差异总体上均无统计学显著性(
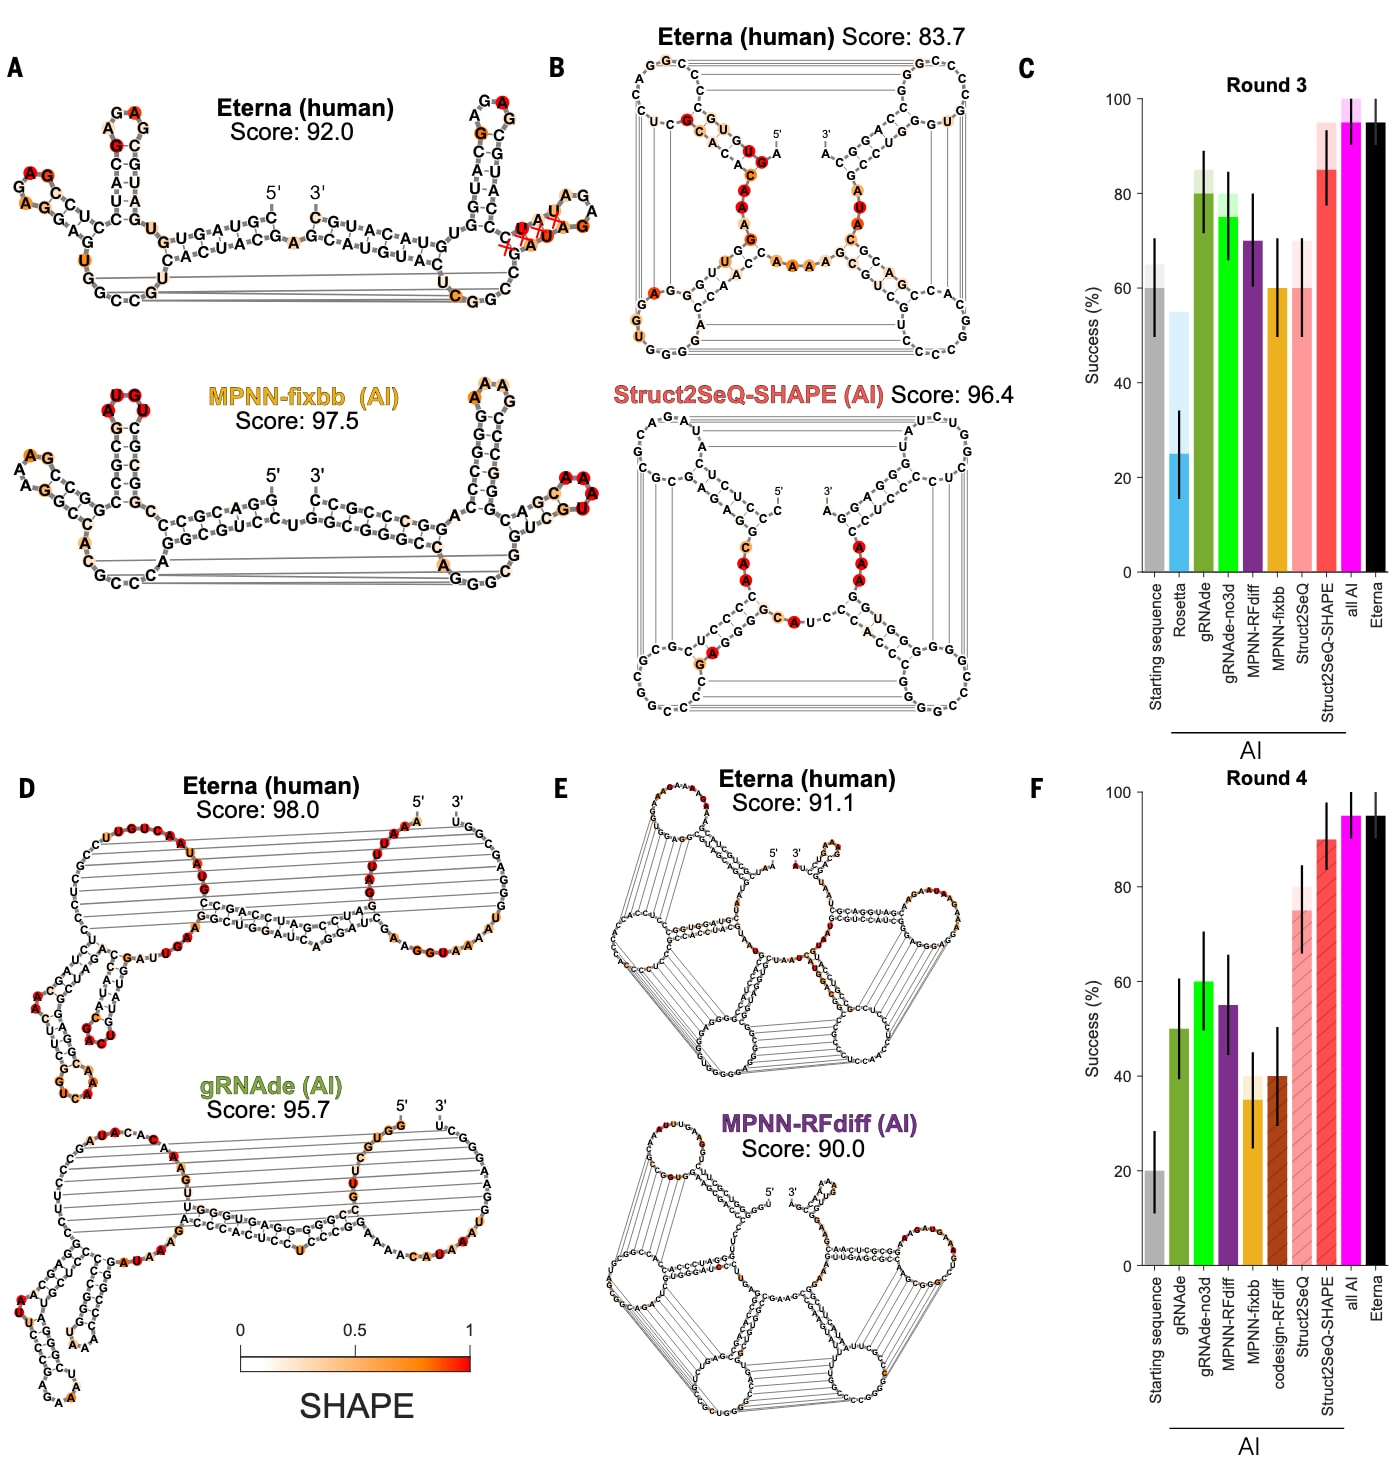
图2|40 个全新假结目标上的设计性能。 A、B,Eterna 和 AI 设计方法在目标 P20(Kissing Multiloops,A)和 P16(AK_PK100-3,B)上的最高 OpenKnot score 设计,其中对应的 AI 方法分别为 MPNN-fixbb 和 Struct2SeQ-SHAPE。B 中的 Struct2SeQ-SHAPE 设计与另一种替代二级结构更加一致(另见图 S6 和 S7)。C,第三轮 20 个目标的整体性能汇总,目标长度最长为 100 nt。D、E,Eterna 和 AI 设计方法在第四轮较长目标 Q08(Rous Sarcoma Virus,D)和 Q20(SV_i,E)上的最高 OpenKnot score 设计,其中对应的 AI 方法分别为 gRNAde 和 MPNN-RFdiff。F,第四轮 20 个目标的整体性能汇总,目标长度为 117–240 nt;带斜线填充的柱表示其设计是在第四轮初步结果公布后的后续实验中进行表征的方法。A、B、D 和 E 中,二级结构对应目标设计,着色则表示实验 SHAPE 图谱。C 和 F 中,实色柱表示在利用 RNet 预测二级结构准确性进行筛选后,OpenKnot score >90 的成功率;浅色柱表示不进行二级结构筛选时的成功率;误差线表示标准误。
4 补偿性突变验证设计的碱基配对
第三轮和第四轮的结果表明,无论是经验丰富的人类设计者还是 AI 方法,其设计能力均已提升至无需逐步迭代优化,即可设计天然和非天然假结的水平。然而,此前对这些设计的评价依赖于人为设定的 OpenKnot score 90 分阈值,同时假定 SHAPE 测量能够准确反映碱基配对状态。已有研究指出 SHAPE 数据的解释存在一定局限,因此,一些因 SHAPE 反应性降低而被认为符合目标二级结构的核苷酸,实际上也可能参与了其他替代性碱基配对。
为检验这一可能性,研究采用了一种基于比较突变分析的独立验证方法,即通过高通量测序进行突变-图谱-补偿恢复分析(mutate-map-rescue readout by high-throughput sequencing,M2R-seq)。图 3A–F 以第三轮中 gRNAde 针对 P20(Kissing Multiloops)的设计为例展示了该方法。
如果两个核苷酸在假定的 RNA 结构中形成碱基对,那么突变其中任意一个核苷酸都应破坏该碱基配对,并在突变位点附近引起 SHAPE 反应性的变化(图 3,A–C;代表性设计的详细数据见图 S6)。未发生突变的配对核苷酸也可能出现反应性变化,但这一现象并不总是明显,因为该核苷酸可能仍保持碱基堆积状态,或者形成其他替代相互作用。
然而,如果同时突变这两个核苷酸,使原始碱基对发生互换,例如由 C-G 变为 G-C,则 RNA 结构理论上应得到“补偿恢复”,其 SHAPE 图谱也应恢复至未突变 RNA 的状态(比较图 3D 与图 3A,以及图 3E 的底行与顶行)。图 3F 汇总了该 P20 设计中所有目标碱基对的“恢复因子”(rescue factor)。结果为各个茎区的实际形成提供了有力证据;相反,图 S7 展示了目标 P16 的一个阴性示例。
研究进一步针对第三轮全部 20 个目标,对 Eterna 以及每种 AI 方法的最佳设计进行了 M2R-seq 测量,共分析超过 10,000 条单突变和双突变序列,并以茎区为单位评估目标结构的恢复程度。20 个目标中有 17 个至少存在一个设计,按照 M2R-seq 恢复因子判据能够实现全部目标茎区的 100% 恢复。在 20 个目标中的 19 个上,至少存在一种 AI 或 Eterna 设计,其 M2R-seq 茎区恢复率达到 80% 以上(数据 S1)。
按照这一评价标准,AI 方法的表现再次与 Eterna 人类设计者相当(图 3G),两者成功设计比例分别为 90% 和 75%,差异无统计学显著性。不同 AI 方法之间的性能差异总体也不显著,唯一例外是所有深度学习方法均显著优于 Rosetta(
总体而言,补偿性突变分析结果与基于 SHAPE 数据和 OpenKnot score 得到的结论一致:与经验丰富的人类 RNA 设计者类似,AI 方法也能够以稳定且较高的准确率设计复杂的假结二级结构,其中包括此前未见过的全新目标。
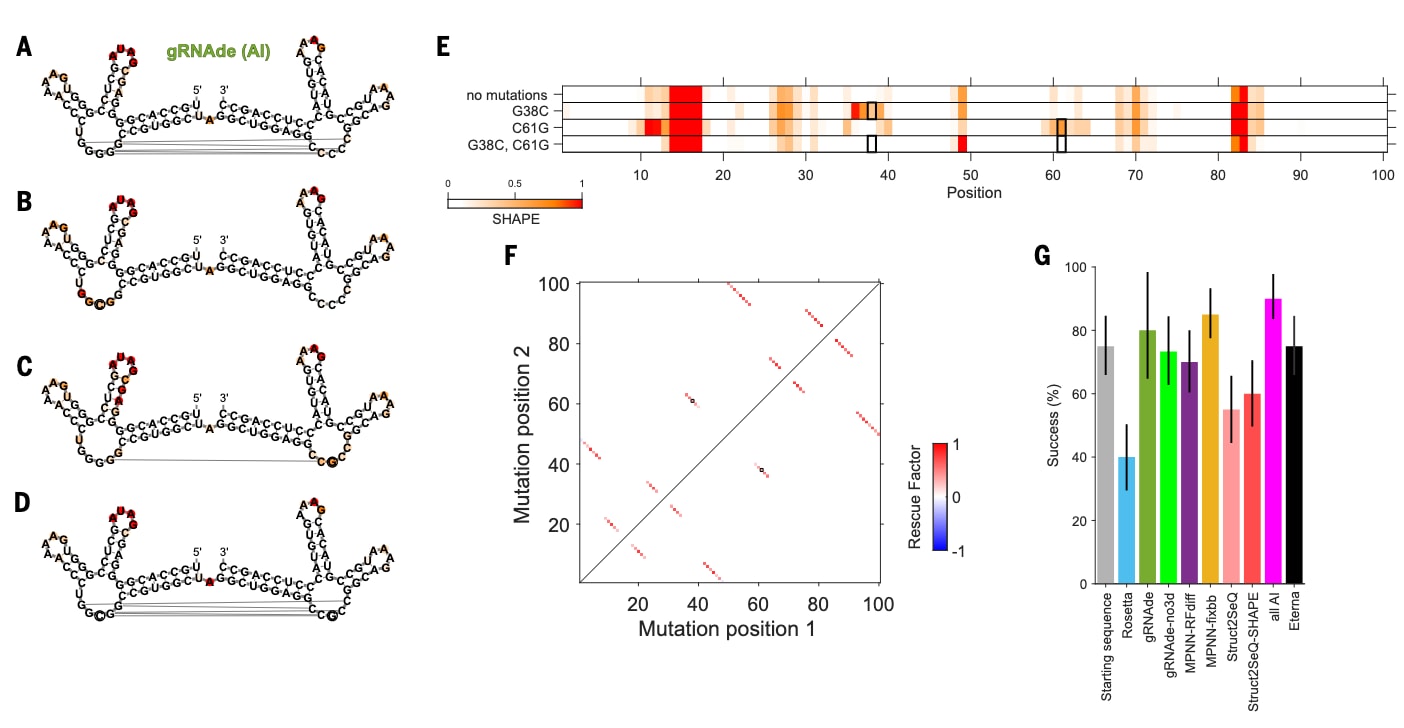
图3|补偿性突变(mutate-map-rescue,M2R-seq)验证单个碱基对的准确性。 A,gRNAde 针对第三轮目标 P20(Kissing Multiloops)生成的最高 OpenKnot score 设计,其 SHAPE 数据映射并着色于目标假结二级结构上。B–D,单突变体 G38C(B)和 C61G(C)的 SHAPE 图谱显示,突变位点附近出现结构扰动(圆圈标示);在补偿性双突变体中,这些扰动得到恢复(D),原始 G38-C61 碱基对被恢复为 C38-G61 碱基对。A–D 中,为便于可视化,所示二级结构均为 RNet-SS 根据相应序列建模得到的结构。E,将 A–D 中的 SHAPE 图谱叠加展示,以便直观比较补偿性突变后图谱的恢复情况。F,A 中该设计所有目标碱基对的实验恢复因子(rescue factor)数值。E 和 F 中的黑色矩形标出了第 38 和 61 位碱基,以及 B–D 中发生突变的 38–61 碱基对。G,所有设计方法的性能汇总,以第三轮 20 个目标中 M2R-seq 验证至少 80% 目标茎区成功形成的目标比例作为评价指标。
5 冷冻电镜揭示新的三维折叠与非典型相互作用
为了确定这些此前未见的假结是否能够形成新的三维结构,研究对多个设计进行了冷冻电子显微镜(cryo-electron microscopy,cryo-EM)表征。在第三轮的非天然二级结构中,重点选择了 Eterna 参与者提出的目标 P20(Kissing Multiloops;图 2A、图 3A–F 和图 4A)。其单链连接区较短,预计能够充分限制 RNA 的三维构象,从而有利于通过 cryo-EM 进行结构解析。
AlphaFold 3、trRosettaRNA 及其他 RNA 三维结构预测算法的建模结果同样提示 P20 设计可能形成较为明确的折叠结构,但这些三维模型的预测置信度整体较低(图 4B)。为了提高设计 RNA 在 cryo-EM 显微图像中的可见度,同时打破可能妨碍高分辨率结构精修的伪对称性,研究将表现最佳的 P20 设计嵌入一种近期开发的环状置换 II 类内含子支架中。
在纯化过程中,起始序列以及 Rosetta、Eterna 和 Struct2SeQ 的 4 个设计通过尺寸排阻色谱表现出聚集或未折叠状态,因此未进一步进行 cryo-EM 表征。这些设计同时也是 M2R-seq 茎区恢复率低于 80% 的样本,提示碱基配对的稳定性对于维持 RNA 的折叠状态十分重要。
其余 4 个设计均成功获得 cryo-EM 图像(图 4C–E;图 S8–S11;表 S6;视频 S1 和 S2)。其中,MPNN-RFdiff 设计的 M2R-seq 茎区恢复率为 80%,在 cryo-EM 实验条件下形成二聚体。该结构中 7 个目标茎区均存在,但 P4 的碱基对形成于两个 RNA 分子之间,而非单个分子内部。
另外 3 个设计分别来自 Struct2SeQ-SHAPE、MPNN-fixbb 和 gRNAde,其 M2R-seq 茎区恢复率均达到 100%。这 3 个设计在 cryo-EM 中均以单体形式存在,初始密度图分辨率分别为 5.2、4.8 和 3.6 Å;经过密度图掩膜和锐化处理后,分辨率进一步提高至 4.8、4.0 和 2.9 Å。
在全部 3 张密度图中,锐化处理前即可清晰观察到 P1–P7 茎区及其连接区(图 4C–E)。这些密度图能够支持完整原子坐标建模,最初采用对分子序列未知的无偏手动追踪方式完成结构构建。坐标模型证实,3 个设计均以较高的碱基对水平准确率形成了目标二级结构中的全部 7 个茎区,其 F1 分数分别为 0.89、0.95 和 0.95。
此外,这 3 种 RNA 折叠均与此前已知 RNA 结构不存在同源关系,也与 AlphaFold 3 的预测模型不一致。对其中两个最高分辨率结构进行进一步分析发现,结构中还存在额外的非典型碱基对、碱基三联体以及经典三级相互作用(图 4D、E 插图),而这些相互作用并非 AI 方法显式设计的结果。
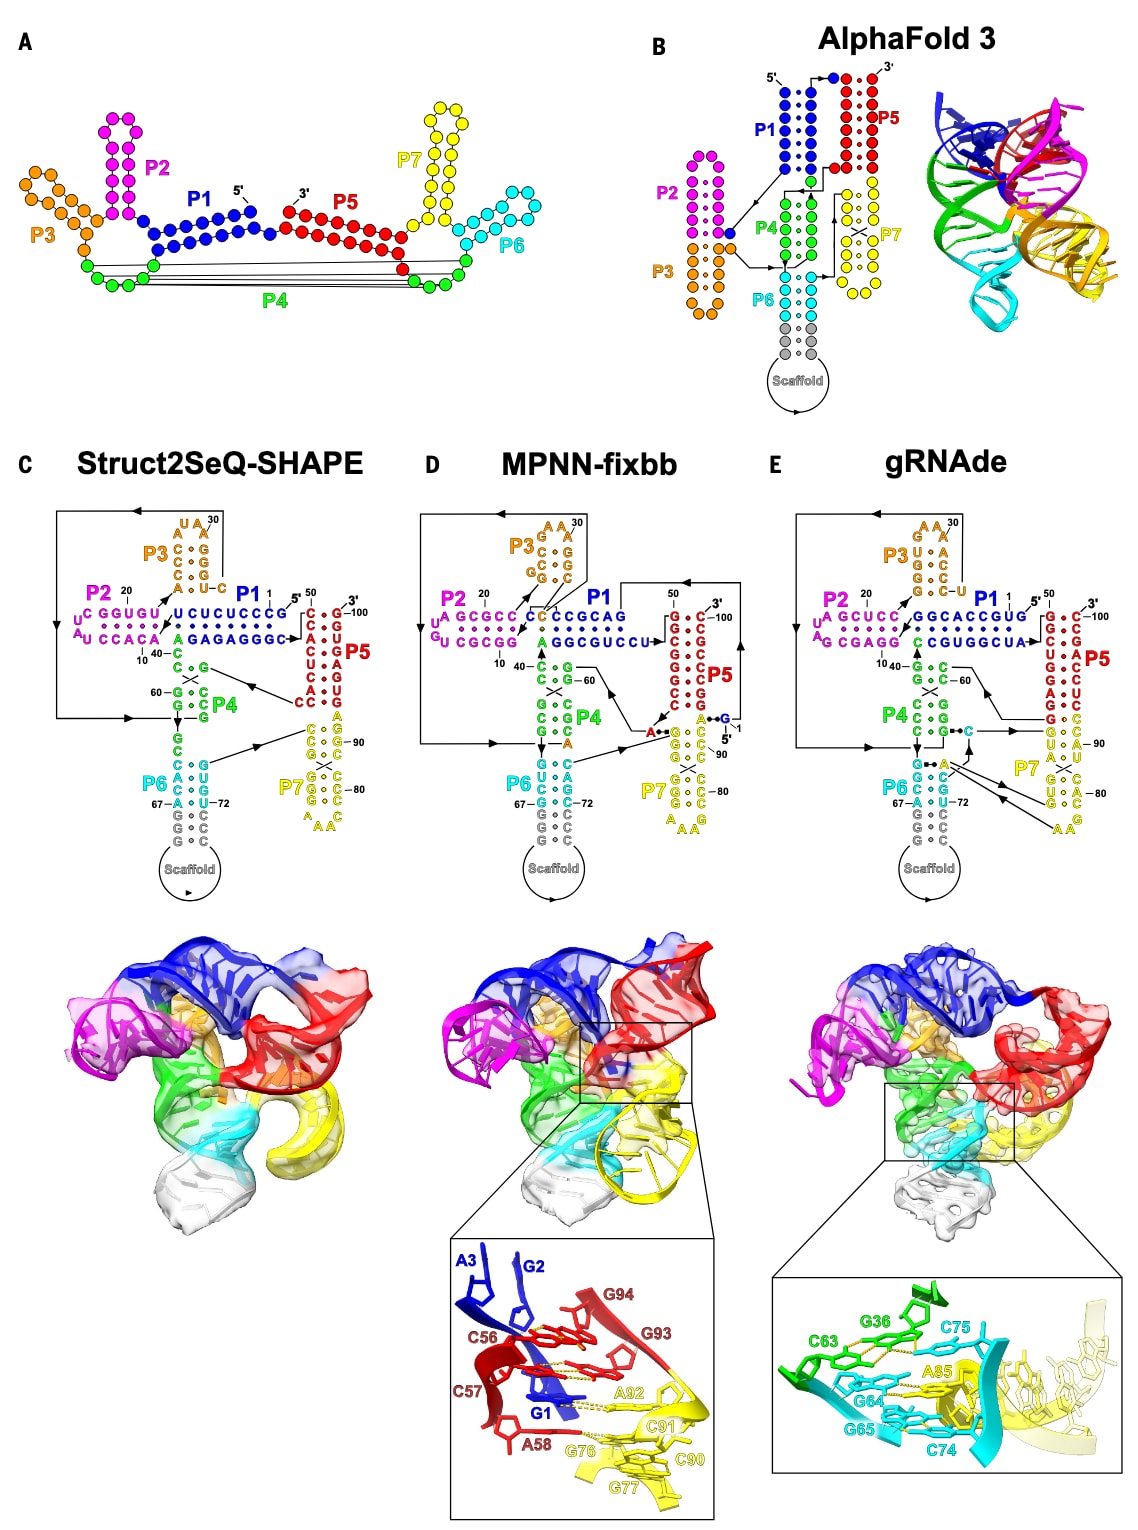
图4|AI 设计假结 RNA 的冷冻电镜结构表征。 A,Kissing Multiloops(第三轮目标 P20)的二级结构,不同茎区分别着色。B,AlphaFold 3 基于三维结构信息得到的二级结构及预测模型,并按茎区着色。C–E,分别展示 Struct2SeQ-SHAPE(C)、MPNN-fixbb(D)和 gRNAde(E)设计的实验结果。冷冻电镜解析得到的二级结构(上)均能高精度恢复目标假结二级结构(A);未锐化的冷冻电镜密度图及拟合后的原子坐标(下)同样按茎区着色,并显示这些设计形成了不同于 AlphaFold 3 预测的三维拓扑结构,同时包含非经典三级相互作用[D 和 E 下方插图]。
6 无需三维结构预测的 RNA 设计
借助深度学习,目前已经能够可靠地从头设计复杂 RNA 假结。在 OpenKnot AI 挑战中,自动化 AI 方法在不到 1 年时间内便达到与经验丰富的 Eterna 人类设计者相当的水平。通过 SHAPE 图谱和补偿性恢复实验对约 50,000 条序列进行验证后,两类方法均成功解决了 57 个假结设计目标中的 95% 以上。
相比之下,蛋白质从头设计领域的快速发展很大程度上依赖高精度蛋白质三维结构预测方法,而目前 RNA 领域仍缺乏具有相当精度的工具。该研究中的 MPNN、gRNAde 和 Struct2Seq 框架并未依赖高精度 RNA 三维结构预测,而是利用 RNet 模型进行设计指导。RNet 基于此前 Eterna 的化学图谱数据训练,这些数据主要反映 RNA 二级结构信息。
除共同使用 RNet 外,这 3 种 AI 框架采用了不同的深度学习策略(表 S2)。现有实验结果尚不足以在统计学上明确判断哪一种方法优于其他方法。相反,这些框架可能更适合组合使用,因为序列空间分析表明,不同 AI 方法分别集中采样相互分离的局部区域,因此能够对设计空间形成互补覆盖(图 S14)。未来仍需对这些方法及其他新兴方法开展更多实验验证,以明确不同框架最适用于哪些 RNA 设计任务。
cryo-EM 结果显示,AI 生成的 RNA 分子能够形成复杂的非典型经典三级相互作用。这类相互作用对于天然 RNA 分子的复杂功能十分关键,但在设计阶段并未被预先预测。未来若要设计 RNA 催化剂和适配体,对这些高分辨率结构细节进行准确预测和设计仍是一个重要挑战。
尽管如此,在没有显式设计的情况下仍能自发形成非典型相互作用,表明一些更具挑战性的 RNA 工程任务可能已经能够立即受益于计算设计。例如,可尝试重新设计核糖体、RNA 聚合酶核酶等复杂分子机器,或发现彼此不冗余的新型 RNA 折叠以扩充 RNA 结构数据库。这些任务可能仅依靠高精度二级结构预测进行计算设计,而无需同时具备能够在设计前以原子级精度预测三维相互作用的能力。