NC 2025 | 机器学习引导的无细胞表达加速酶工程
今天介绍的是发表在 Nature Communications 上的一项研究工作。酶工程长期受限于序列—功能数据获取缓慢、传统定向进化搜索范围有限,难以并行优化多类催化反应。研究团队将无细胞 DNA 组装、无细胞表达、功能筛选与机器学习整合为设计—构建—测试—学习闭环,并以酰胺合成酶 McbA 为对象,在 10,953 个独特反应中评估 1,217 个酶变体。模型预测的变体针对 9 种小分子药物实现 1.6 至 42 倍活性提升,其中吗氯贝胺转化率达到 96%。这套低算力、可并行的平台显著降低了筛选负担,为快速开发专一化生物催化剂提供了可推广路径。
获取详情及资源:
- 📄 论文: https://doi.org/10.1038/s41467-024-55399-0
- 💻 代码: https://github.com/grantlandwehr/accelerated-enzyme-engineering
0 摘要
酶工程面临的一项限制是,难以快速生成并利用大规模序列-功能关系数据开展预测性设计。为解决这一问题,开发了一种机器学习(ML)引导的平台,将无细胞DNA组装、无细胞基因表达和功能测定相结合,可在蛋白质序列空间中快速绘制适应度景观,并针对多种不同的化学反应优化酶。平台被用于改造酰胺合成酶,通过10,953种独特反应评估1,217种酶变体的底物偏好。利用这些数据构建了增强型岭回归ML模型,以预测能够合成9种小分子药物的酰胺合成酶变体。对于这9种化合物,ML预测的酶变体相对于亲本酶表现出1.6~42倍的活性提升。这一由ML引导的无细胞框架有望通过迭代探索蛋白质序列空间,并行构建专用生物催化剂,从而加速酶工程。
1 引言
工程酶有望在能源、材料和医药等应用领域产生变革性影响。为了创造此类酶,需要改变蛋白质的氨基酸序列,以增强其天然功能或促进新的化学反应。该过程通常先寻找对目标反应具有天然可塑性和混杂性的酶,再进行定向进化。然而,现有定向进化方法往往只能绘制序列空间狭窄区域内的序列—功能关系,因此受到限制。例如,筛选策略的通量通常较低,这会限制迭代位点饱和诱变过程中对突变的重复采样,还可能遗漏上位性相互作用,即当单个突变呈中性甚至有害时,两个或更多突变组合却产生有益协同效应。此外,定向进化的筛选方法侧重于为单一转化寻找“胜出”酶,限制了为相似反应的正向工程收集正、负序列—功能关系数据的能力。
计算技术已经被用于加速现有定向进化方法。从头蛋白质设计能够创造自然界中不存在的酶,但可实现的化学反应及应用仍然有限。ML模型已被用于发现酶:既可依据相关同源物和来自所有生物的蛋白质序列推断适应度,即所谓的零样本预测,也可依据实验测得的适应度数据在蛋白质—适应度景观中导航,例如采用位点特异性独热编码进行非线性回归。尽管ML辅助酶工程展现出良好前景,但快速构建用于探索广阔序列空间的数据集仍是一项挑战,尤其是因为多数基因型—表型关联会在高通量酶工程过程中丢失。
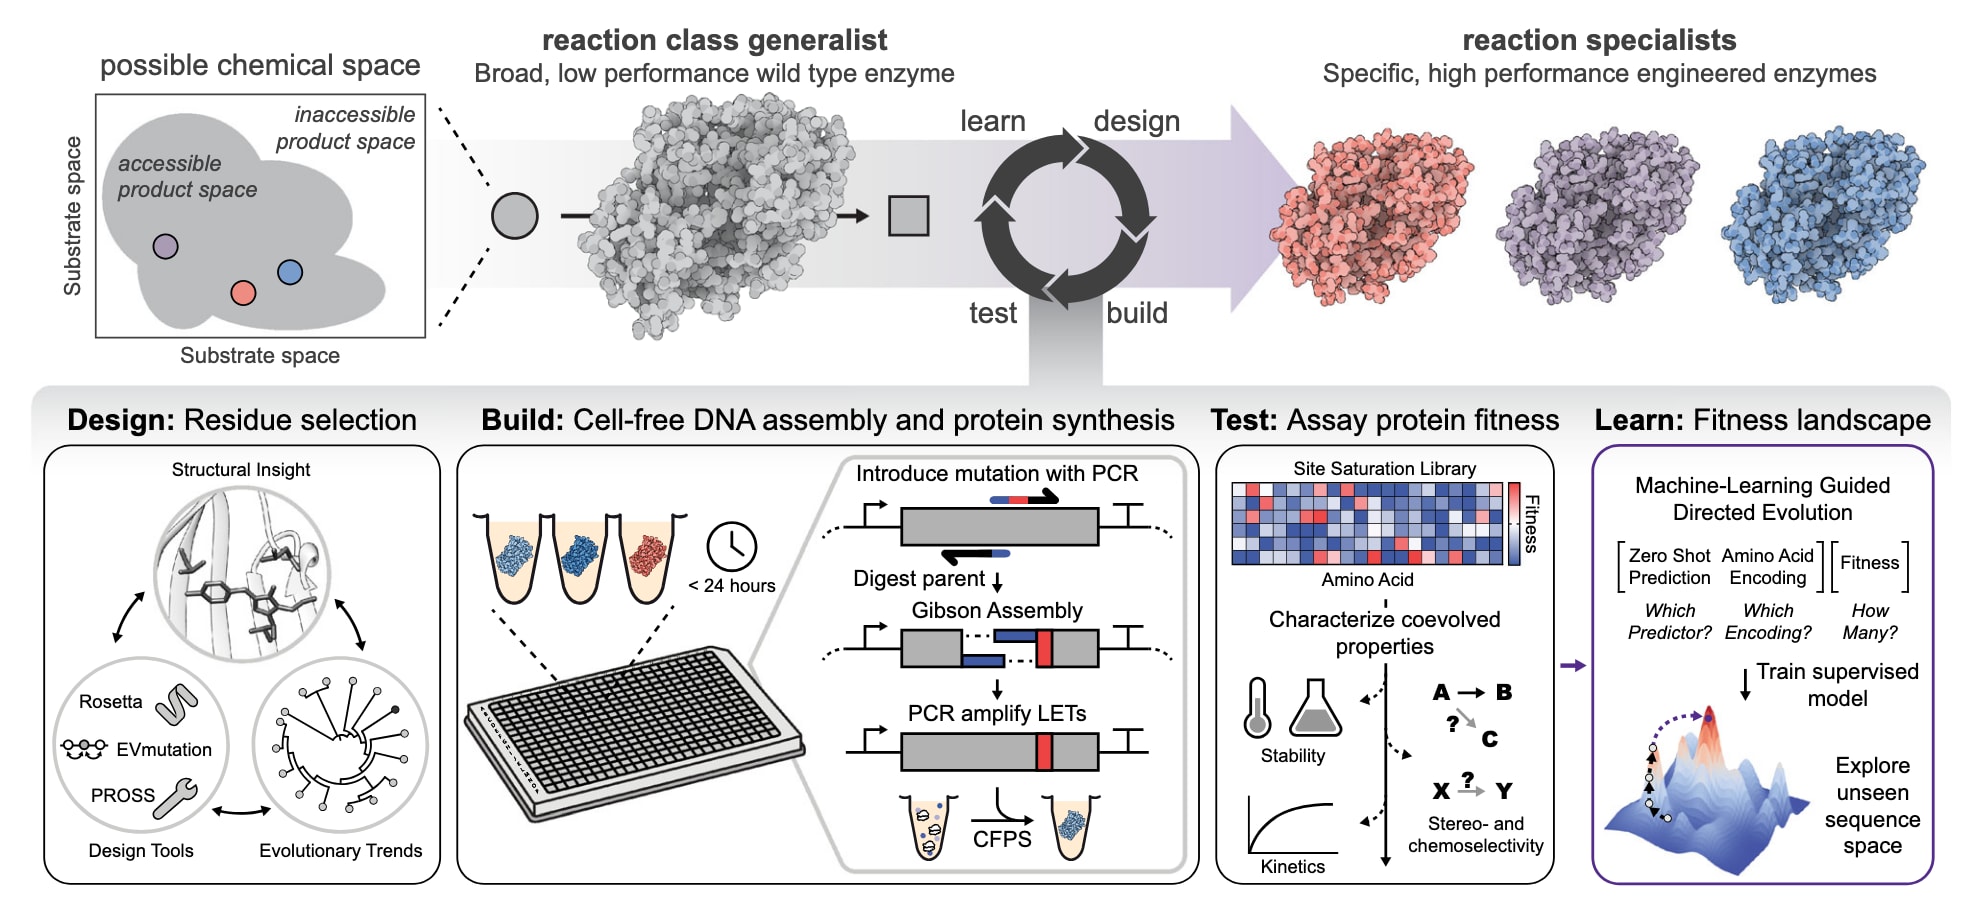
图1|机器学习引导的无细胞酶工程平台 示意图展示了如何应用“设计—构建—测试—学习”工作流程快速绘制序列—功能景观图。根据结构信息、进化趋势和计算工具,如ROSETTA、EVmutation和PROSS,合理选择可能决定酶催化功能的氨基酸残基(设计)。在不到24 h内完成位点饱和突变和无细胞基因表达,生成序列确定的突变体文库(构建)。随后筛选文库,以获得所需的蛋白质适应度指标(测试)。测试阶段获得的信息,包括失败结果,用于识别具有重要功能的氨基酸残基,并反馈至迭代设计及机器学习模型拟合(学习)。
为实现生物催化剂的正向设计,开发了一种由ML引导的高通量方法,可探索化学空间多个区域的适应度景观。方法的关键特征是采用无细胞基因表达(CFE)系统,在“设计—构建—测试—学习”(DBTL)流程中快速合成蛋白质并测试其功能。框架首先针对通过酶底物混杂性评估确定的特定化学转化,绘制带有单阶突变的酶变体序列—功能关系;随后利用这些数据拟合监督式岭回归ML模型,并以进化零样本适应度预测器增强模型,从而外推活性更高的高阶突变体。重要的是,这些ML模型可在普通计算机的中央处理器上运行,使整套方法易于使用且便于获取。方法补充了不断扩展的定向进化工具箱,包括预测酶催化特征的方法。
框架被用于开展分歧进化,将一种能够形成酰胺键的通用型酶转化为多种彼此不同的专用型酶。酰胺键广泛存在于药物、农用化学品、聚合物、香料、调味剂及其他高价值产品中,其生物催化合成与化学合成相比可能具有独特优势,例如反应条件温和,以及具有化学、立体和区域选择性,并可促进可持续生物制造。来源于嗜热海放线菌(Marinactinospora thermotolerans)的McbA是一种具有代表性的ATP依赖型酰胺键合成酶,参与海洋咔啉类次级代谢产物的生物合成。McbA及其近缘同源酶ShABS具有宽松的底物范围,可接受药物中常见的多种简单酸和胺。因此,McbA可作为灵活的起点,将通用型酶改造为多种反应专用型酶,使每种酶分别执行不同的化学反应。ML引导的方法使McbA合成9种化合物的活性较野生型提高了1.6~42倍。
2 结果
2.1 探索McbA的生物催化合成景观
目标是开发一种由ML引导的DBTL流程,通过减轻筛选负担,加快针对生物催化的多项同步定向进化。实现这一目标需要为独特的化学转化生成序列—适应度数据,并据此建立预测性ML模型。为确定目标反应,首先通过评估酶的底物混杂性,探索了野生型McbA(wt-McbA)可能参与的酰胺化反应空间。所研究的大量底物不同于wt-McbA偏好的杂环酸、伯胺或芳香胺,包括伯胺、仲胺、烷基类、芳香类、复杂药效团、缺电子或富电子物质,以及含其他杂原子、卤素和“未保护”亲核或亲电基团的底物。还纳入了更具挑战性的底物,如复杂杂环酸和胺、对映体,以及同时含有酸和胺或含有多个酸和胺的底物,用于确定wt-McbA的固有局限与偏好。实验采用较低酶浓度(约1 μM)和较高底物浓度(25 mM)开展了1,100种独特反应,涵盖药物、香料和聚合物等多种已知高价值分子。
值得注意的是,wt-McbA可耐受多种“未保护”官能团和几何构型。总体而言,脂肪酸的耐受性较差,而芳基酸、苯甲酸类和肉桂酸类底物易被接受。带电芳基酸是一个特殊例外,通常只能与极少数胺偶联。相反,wt-McbA易于偶联脂肪族伯胺和仲胺,但难以利用芳胺。McbA能够合成11种药物化合物及数十种杂合分子,转化率从仅能通过质谱(MS)检测到的痕量水平到约12%不等。这些反应既表现出立体选择性,例如合成S-舒必利的倾向远强于R-舒必利,也表现出严格的化学和区域选择性,例如同时含酸和胺的底物不会发生聚合。由于McbA的反应机制始于羧酸的腺苷酸化,还观察到若干仅生成酰基-AMP中间体的情形。野生型McbA无法合成若干重要分子,表明其可能无法与脂肪酸和长链脂肪酸反应,如壬酰胺和辣椒素,也可能无法处理某些大型底物,如伊马替尼和尼洛替尼。进一步了解底物范围可为后续酶工程提供指导。
2.2 利用无细胞蛋白质工程快速筛选序列明确的蛋白质文库
在通过酶底物混杂性评估确定具体化学转化后,需要快速生成大量McbA突变酶的序列—功能关系数据,用于训练ML模型预测高活性变体。为此,实施了一种不需要繁琐转化和克隆步骤的无细胞蛋白质合成方法。方法利用无细胞DNA组装和CFE构建位点饱和、序列明确的蛋白质文库,包含五个步骤:(i)含核苷酸错配的DNA引物通过PCR引入目标突变;(ii)DpnI消化亲本质粒;(iii)分子内Gibson组装形成突变质粒;(iv)第二次PCR扩增线性DNA表达模板(LET);(v)通过CFE表达突变蛋白。采用该流程可在一天内通过独立反应构建数百至数千个序列明确的蛋白质突变体,并能通过快速迭代累积突变。同时,方法避免了典型位点饱和文库因使用简并引物而产生的潜在偏差。
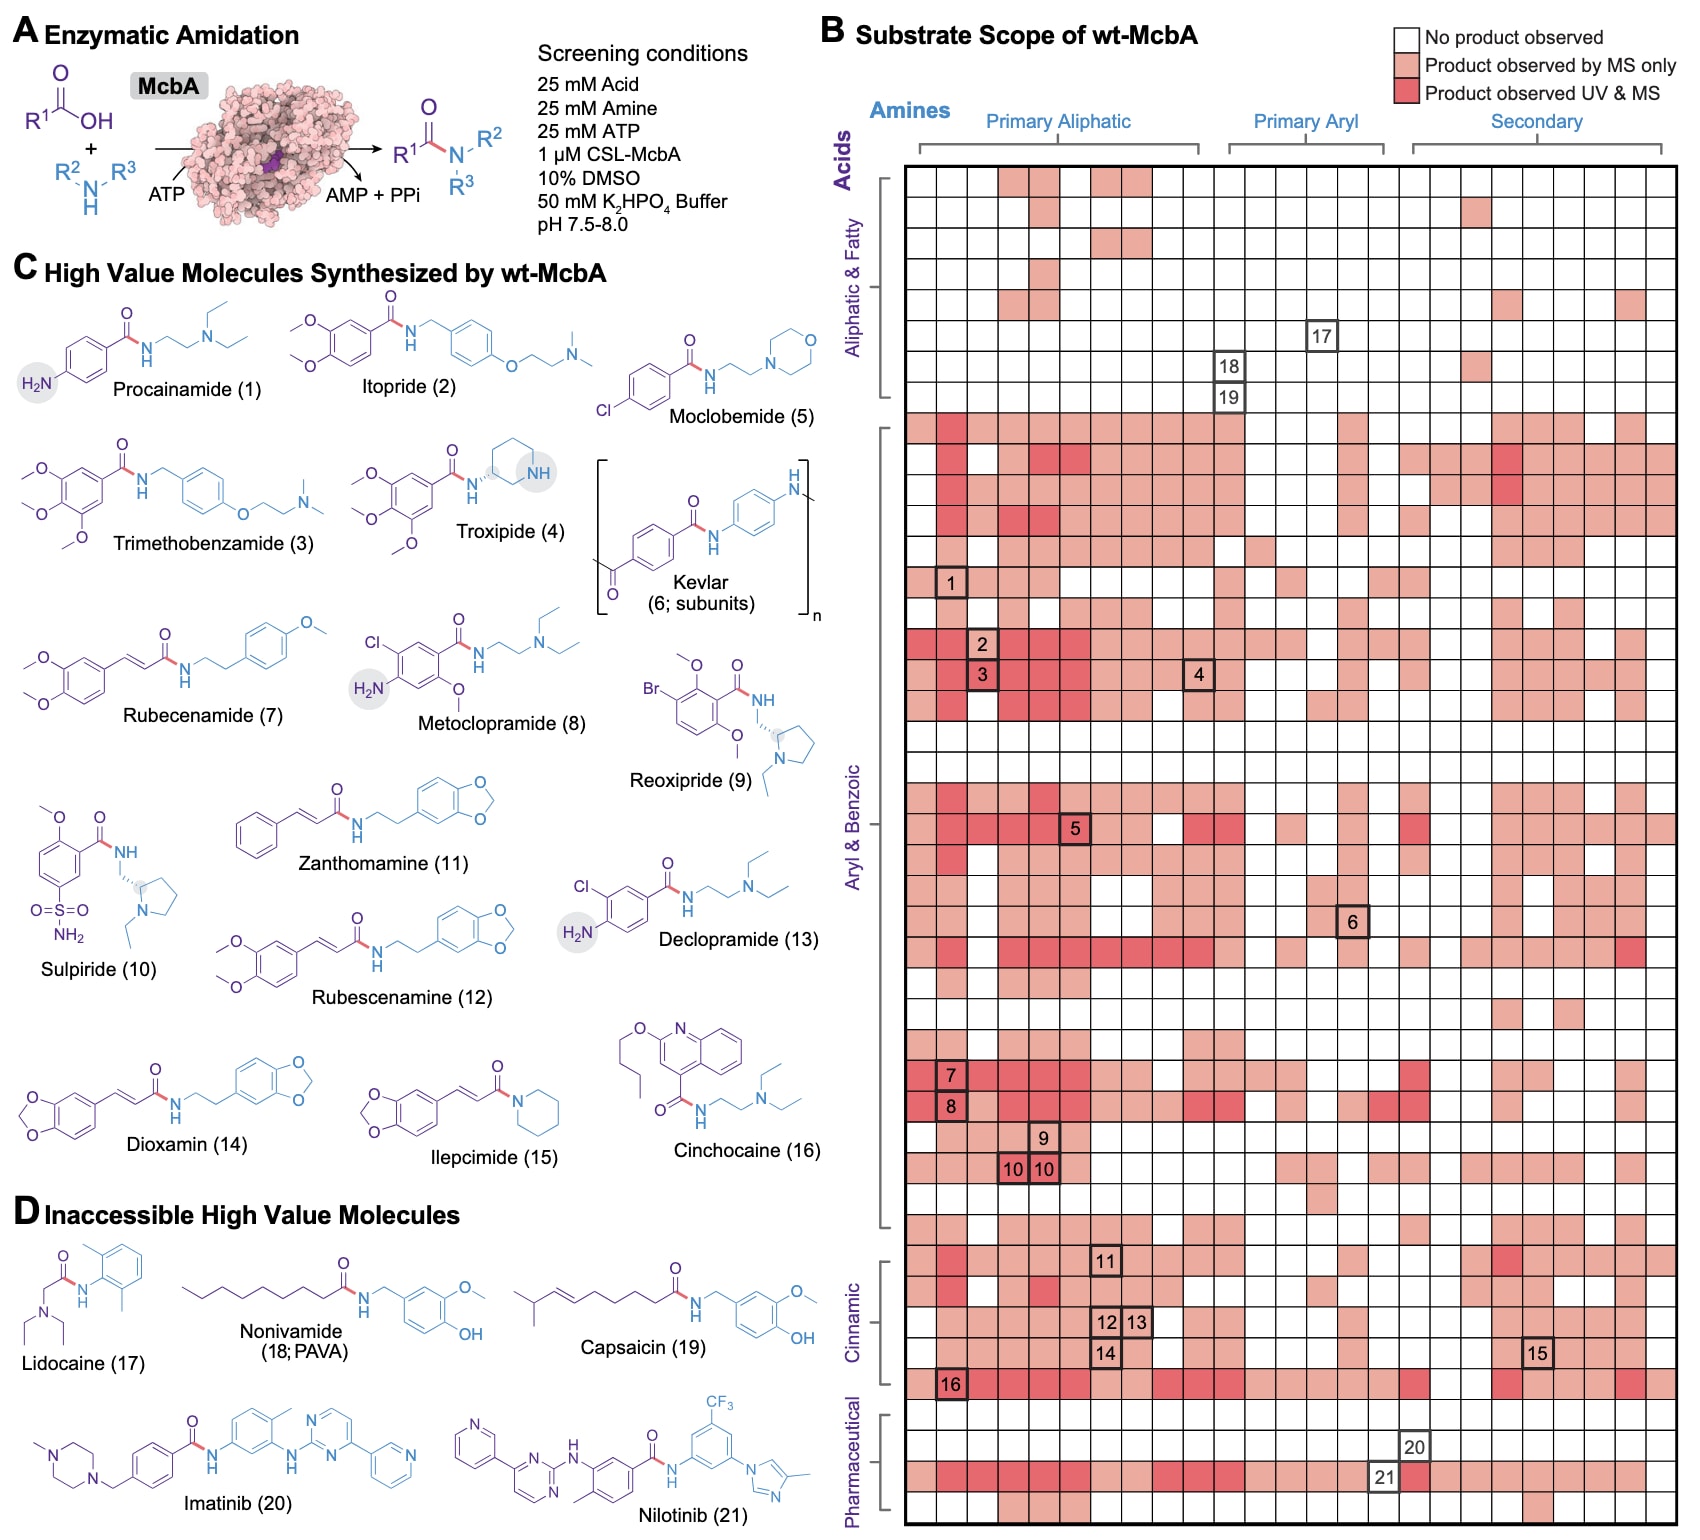
图2|McbA可及的多样化化学空间表明其是一种能够合成多种高价值分子的生物催化剂 a. 用于探索McbA酶促合成酰胺底物范围的反应方案和筛选条件。采用无细胞表达系统表达McbA,并通过加入不同组合的酸类和胺类底物启动反应。 b. 采用反相高效液相色谱分析McbA的全组合底物筛选结果(n = 1)。深红色表示可通过紫外吸收检测到的产物,浅红色表示仅能通过质谱检测到的痕量产物。 c. 在底物范围内可能合成的21种高价值分子中,McbA能够合成其中16种,其中11种为小分子药物。 d. 在所测试反应条件下,McbA无法合成的高价值分子示例。
流程采用表征充分的单体超稳定绿色荧光蛋白(muGFP)进行验证,靶向4个已知对稳定性和荧光十分重要的残基。在构建针对这4个残基的位点饱和文库(77个变体)时,流程对引物设计偏差具有较高耐受性,例如同源重叠区和熔解温度的变化;muGFP变体的LET均包含全部预期突变。全长可溶性蛋白的结果表明,荧光变化并非由表达量或溶解度变化所致。绘制蛋白质位点饱和景观不仅能突出对适应度至关重要的残基,例如构成荧光团和影响疏水核心堆积的残基不能耐受突变,还能揭示各位点总体上的可突变性。
流程验证后,被用于生成McbA的序列—功能关系数据,以训练ML模型并加快工程改造。最初选择了底物范围评估中确定的三种高价值分子:(i)单胺氧化酶A抑制剂吗氯贝胺,因为McbA对该反应具有较高混杂性,野生型转化率为12%;(ii)甲氧氯普胺,其酸组分含有一个可能与目标胺竞争的游离胺,因此带来独特挑战,野生型转化率为3%;(iii)辛可卡因,其酸组分独特,但胺片段与甲氧氯普胺相同,野生型转化率为2%。并行开展这些工程改造,有望推断影响胺底物特异性的突变,即共有突变,以及影响酸底物特异性的突变,即特有突变,并由此获得McbA的一般设计原则。为逐步接近更具工业相关性的反应条件,采用较高底物浓度和较低酶用量,针对每种分子开展热点筛选(HSS):在广阔序列空间中实施位点饱和诱变,识别突变后可正向影响适应度的残基位置。在McbA晶体结构(PDB:6SQ8)的指导下,选取了完全包围活性位点和推定底物通道的64个残基,例如距对接天然底物10 Å以内的残基。对这些残基开展HSS(64个残基×19种氨基酸,共1,216个单突变体)后,液相色谱—质谱(LC-MS)测定显示,与wt-McbA相比,多个残基发生突变后可促进吗氯贝胺、甲氧氯普胺和辛可卡因的合成。
2.3 ML引导的无细胞表达用于蛋白质工程
在获得多种不同McbA单突变体的大型数据集后,开始利用ML模型加速McbA工程,以在化学空间的不同区域合成小分子。核心思路是利用HSS中的单突变数据,外推活性更高的高阶突变体。为此,选择使用数据拟合增强型岭回归模型。这类模型结构简单,且此前在蛋白质工程中表现优于更复杂的模型,可用于预测活性更高的高阶突变体。
首先选择预测模型架构。McbA变体的特征表示由位点特异性氨基酸编码与零样本适应度预测结果拼接而成。评估的氨基酸编码包括简单的独热编码,以及试图纳入氨基酸理化性质的复杂描述符。还考察了基准蛋白质变体适应度预测器,以纳入通用、进化和结构层面的零样本预测。具体测试了三种适应度预测器:在UniRef50数据库上训练的Evolutionary Scale Modeling(ESM)-1b Transformer模型,用于通用预测;在进化相关序列的多序列比对上训练的EVmutation(EC)概率密度模型,用于进化预测;以及估算去折叠自由能结构变化的MAESTRO,用于结构预测。模型训练和超参数调优采用HSS中前4个热点的单突变数据(n=77)。
与此同时,针对每种酰胺产物,即吗氯贝胺、甲氧氯普胺和辛可卡因,采用迭代饱和诱变(ISM)开展较传统的定向进化。鉴于目标是从单突变外推到高阶突变,这些实验能够提供有价值的高阶突变,用于验证模型并比较其性能。
针对吗氯贝胺,从HSS中选择活性超过野生型1.5倍的6个残基,开展三轮ISM。首先固定HSS中的最佳突变V177S,再对另外5个残基进行位点饱和诱变。通过在后续轮次中重新引入此前固定的突变,可探索潜在上位性相互作用;例如,在A323F加入后,第二轮ISM再次对已固定为V177S的177位丝氨酸进行饱和诱变。此外,还完整探索了前两个残基的所有双突变组合,结果显示其对吗氯贝胺合成具有加和效应。三轮ISM均选取每轮活性最高的突变体作为下一轮起点,最终获得了四突变体qm-McbA
针对甲氧氯普胺,选择了活性均超过野生型1.25倍的10个残基开展ISM。三轮ISM得到一个四突变体,其活性较wt-McbA提高近30倍。辛可卡因的工程改造更难推进;尽管尝试了多条ISM路径,仍未观察到优于双突变体的有益突变。这种ISM陷入死胡同的结果支持在框架中纳入ML模型,以期捕捉上位性相互作用。吗氯贝胺和甲氧氯普胺的ISM数据包含双、三和四突变体,样本量分别为n=243和n=169,被用于评估各模型性能;辛可卡因则用于对所确定的最佳模型进行独特的压力测试。
模型预测性能首先采用归一化折损累积增益(NDCG)进行评估。指标衡量模型正确排序高适应度变体的能力,与用最小筛选负担发现高适应度变体的实验目标一致,其结果总体上与Spearman秩相关系数相符。按NDCG评估时,增强模型优于单独的岭回归模型。还尝试在变体特征中组合多个预测器,例如同时使用ESM-1b和EVmutation的预测,但模型性能并未提升。随后检验了模型实现高预测性能是否必须使用完整的位点饱和数据集(n=77),以及蛋白质工程中常用的较小数据集是否足够。训练集以不同方式留出变体,以模拟未穷尽搜索序列空间的常见策略,包括缩减密码子文库NDT和NRT、单氨基酸扫描(此处组合常用的甘氨酸、丙氨酸、脯氨酸和半胱氨酸扫描),以及依据理化性质对氨基酸自然分组的BLOSUM缩减字母表。使用Georgiev编码训练相同的增强型岭回归模型后,分析表明,使用位点饱和数据集收集的全部数据能够提供更强的预测能力。可能源于数据集信息丰富且大部分突变体具有非零活性,其中吗氯贝胺为64/77,甲氧氯普胺为62/77,从而避免训练集出现“空洞”。后续采用完整位点饱和数据集,以及带Georgiev编码的增强型EVmutation模型,因为模型对两种化合物均表现出较强预测性能,且预训练概率密度模型便于应用于其他化合物。EVmutation所需的计算资源和时间也少于ESM。
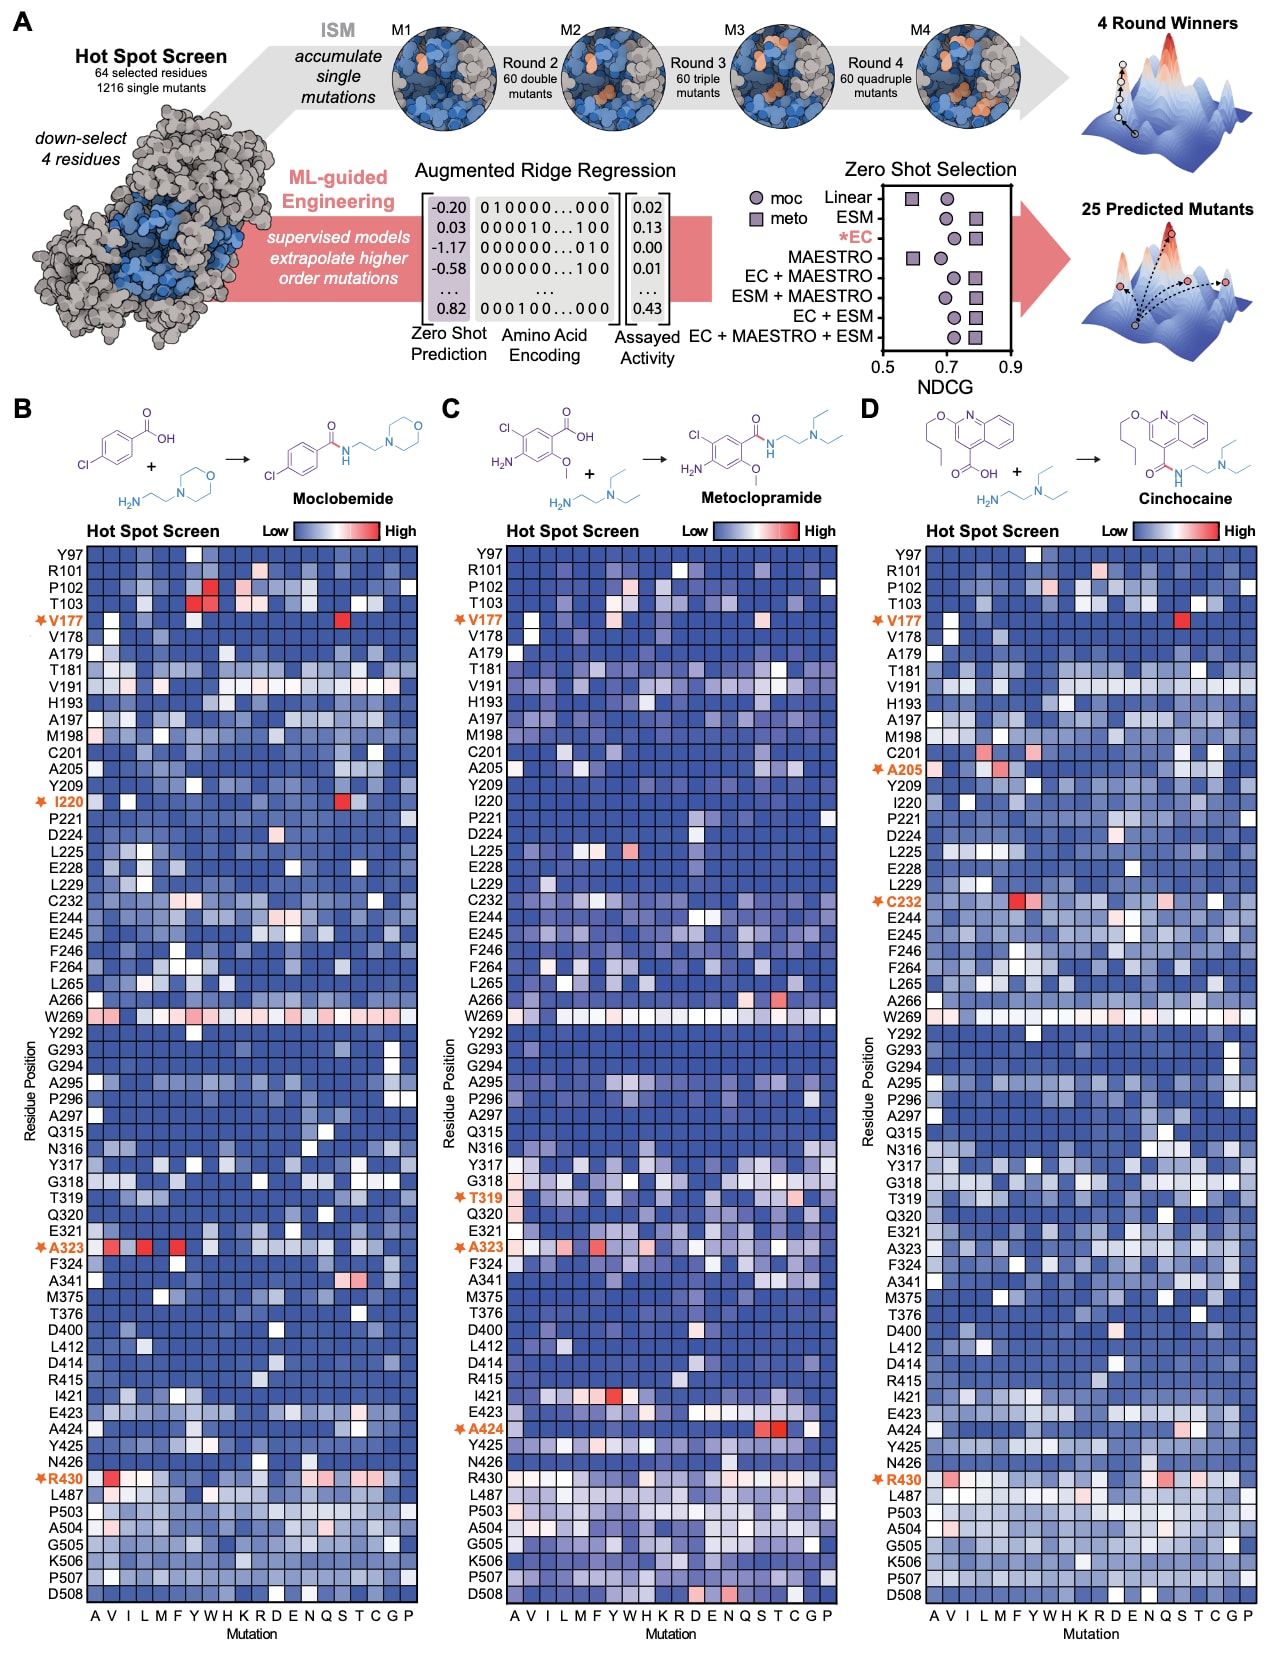
图3|用于机器学习引导McbA定向进化的序列—适应度景观数据快速生成 a. 工作流程示意图:采用热点筛选中选出的4个可变位点的转化率数据训练监督式岭回归模型,序列特征由氨基酸编码与酶适应度的零样本预测共同构成。基于约80个单点突变体组成的训练集,外推高阶突变体,并测试排名前25位的预测结果。将零样本选择与所有编码策略进行比较,并依据归一化折损累积增益进行排序,其中展示了Georgiev编码结果。 b. 对McbA中筛选出的64个残基进行热点筛选,显示吗氯贝胺转化率相对于野生型的倍数变化。 c. 对McbA中筛选出的64个残基进行热点筛选,显示甲氧氯普胺转化率相对于野生型的倍数变化。 d. 对McbA中筛选出的64个残基进行热点筛选,显示辛可卡因转化率相对于野生型的倍数变化(n = 1;蓝色表示低转化率,红色表示高转化率)。突变性最高的4个位点,即热点,以橙色和星号标出,并作为模型验证的训练集。
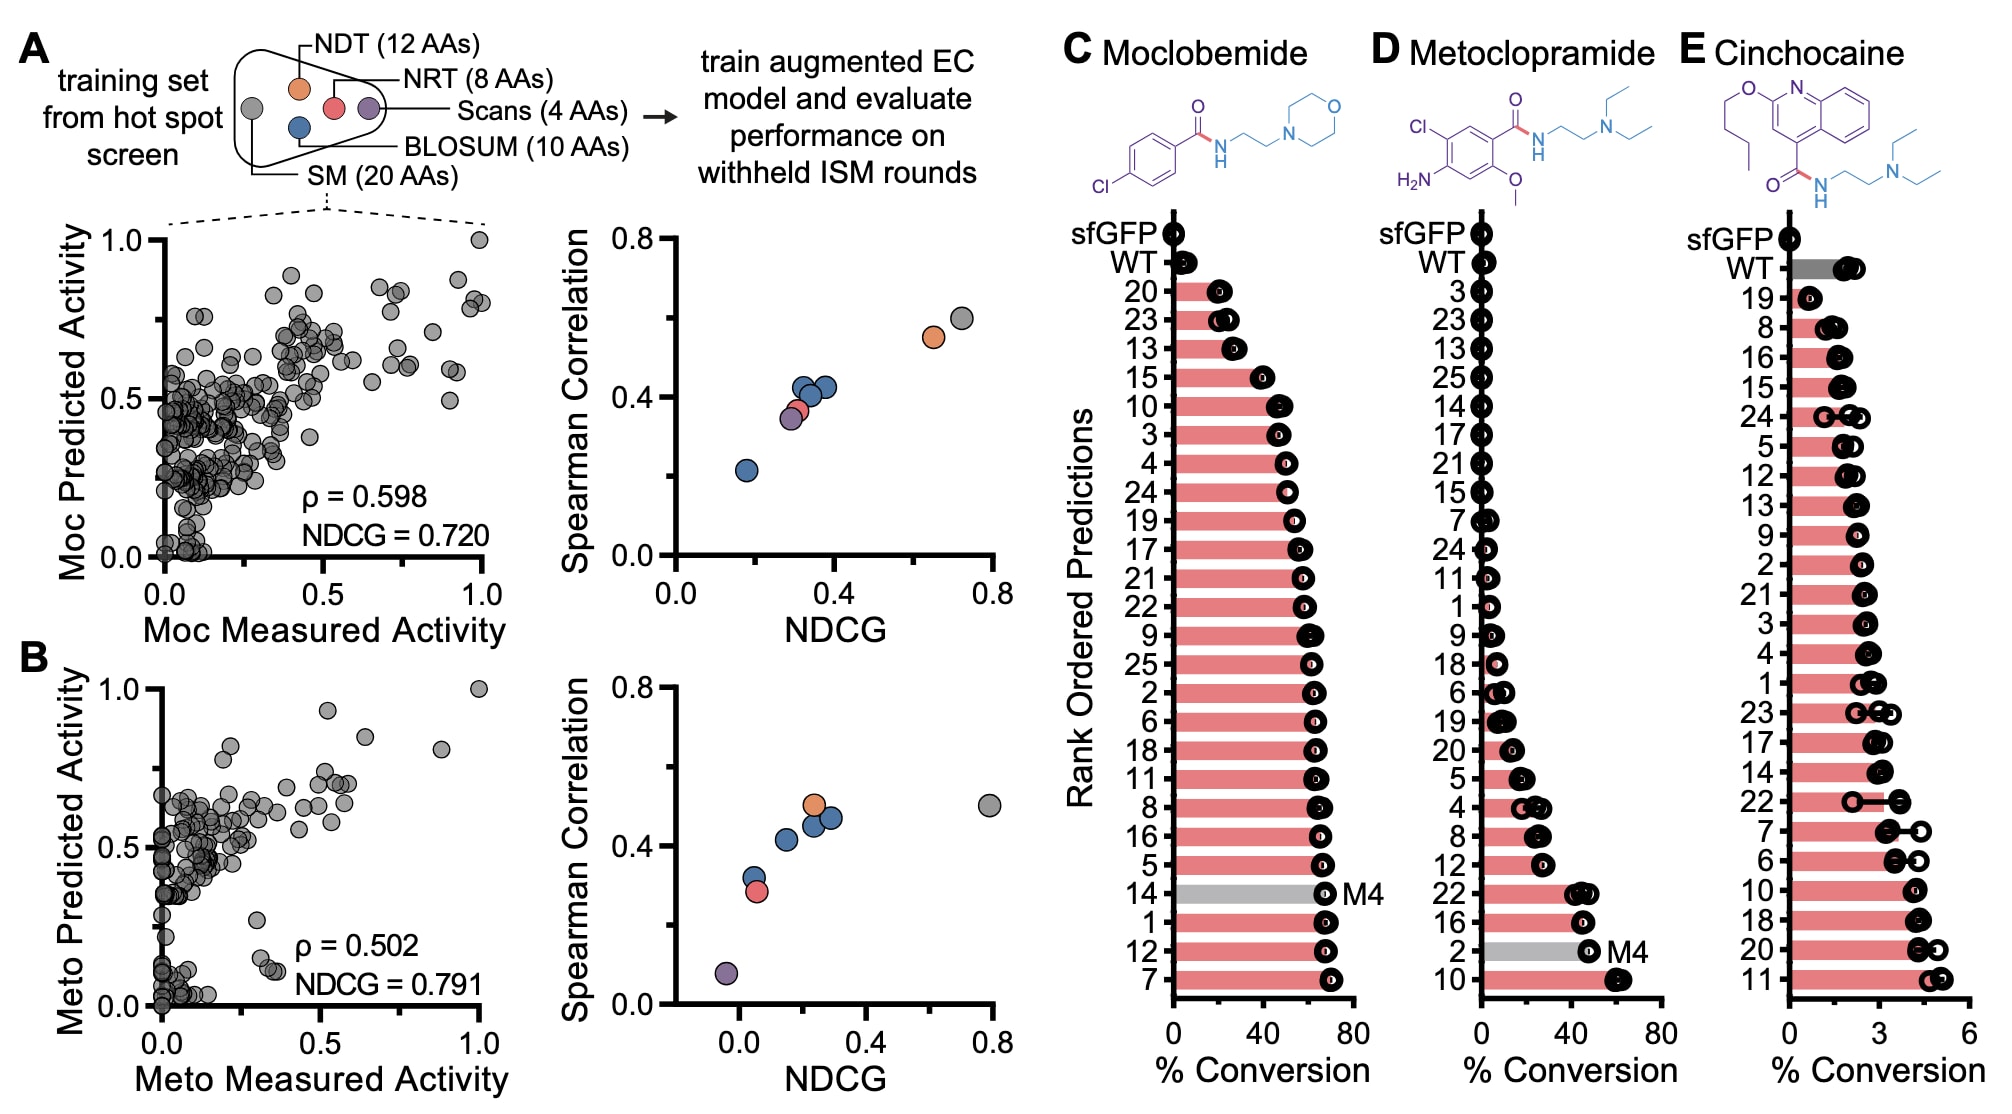
图4|机器学习引导的定向进化能够以较迭代位点饱和诱变更低的筛选负担预测高活性突变体 a–b. 分析采用小于饱和诱变文库的训练集时的模型保真度,包括简并密码子集合NDT和NRT,以及基于BLOSUM50构建的精简氨基酸字母表,并使用Spearman相关系数ρ和归一化折损累积增益进行量化。对于使用完整饱和诱变数据集训练的模型,分别比较其对未纳入训练的迭代饱和诱变轮次中吗氯贝胺和甲氧氯普胺活性的实测值与预测值. c–e. 机器学习预测变体对吗氯贝胺、甲氧氯普胺和辛可卡因的实验验证转化率,n = 3,误差线表示±标准差;迭代饱和诱变第4轮获得的四重突变体以灰色表示。对于辛可卡因,机器学习模型的预测结果不包含迭代饱和诱变获得的最高活性突变体。野生型McbA以深灰色表示。转化率采用反相高效液相色谱在独立实验中测定。
利用针对每种化合物分别训练的单目标ML模型,对用于合成吗氯贝胺、甲氧氯普胺和辛可卡因的204种组合酶变体进行计算机筛选,随后构建并测试排名前25的预测变体。实验结果表明,增强型ML模型预测的McbA变体中富集了对各酰胺产物具有高活性的变体,部分变体甚至超过了吗氯贝胺和甲氧氯普胺ISM所得的qm-McbA。值得注意的是,甲氧氯普胺的最佳预测突变体含有A424S突变;在HSS中,活性更高的A424T取代了该突变并被用于后续ISM。这说明模型发现了仅采用ISM会被忽略的更优突变体。辛可卡因的最佳预测变体活性显著高于最佳单突变体,而且出人意料地包含A205L;该突变在HSS中的活性低于wt-McbA。仅凭HSS结果进行理性选择和组合无法获得相同结果。这些结果表明,ML引导策略能够以同一种起始酶为多种分子发现高适应度变体。尽管尚不清楚模型能否直接推断非线性相互作用,但其能够规避路径依赖并减少筛选负担。然而,实验测试变体的排名与预测排名相关性较差,平均Spearman秩相关系数为0.21±0.15,说明模型可能无法准确捕捉完整的序列—适应度景观。
2.4 ML引导的生物催化多样化用于高价值药物
为评估方法的稳健性,进一步采用ML引导框架,预测用于合成另外6种药物化合物的不同McbA突变体。从底物范围筛选所确定的目标反应出发,使用同一套包含1,216个McbA单突变体的文库开展HSS,共计7,302种独特反应;随后选择4个热点并训练ML模型,预测活性更高的高阶突变体。每种反应均测试排名前24的预测结果,再对最佳变体进行表达和纯化,并与wt-McbA比较活性。所测试的6种化合物产率较wt-McbA提高1.6~34倍。对于每种化合物,最佳预测突变体始终优于最佳理性设计,即不使用ML模型、直接组合HSS中4个最佳突变所得的变体。部分突变体仅有中等程度改善,这可能是因为某些目标化合物只能通过MS检测,导致热点筛选的信噪比较低,并形成更难建模的平坦适应度景观。尽管如此,框架仍获得了活性提高的酶突变体,可合成多种起初只能痕量检出的产物。
还比较了部分酶变体执行各反应步骤的效率。例如,wt-McbA似乎能够高效催化曲昔匹特合成中的腺苷酸化步骤,即腺苷酸化3,4,5-三甲氧基苯甲酸,却无法催化酰胺键形成。工程化酶变体则能够进一步接受胺,使观察到的中间体大幅减少。意外的是,针对每种目标产物构建的McbA变体仍表现出严格的区域选择性,尽管实验并未施加维持这种选择性的压力。曲昔匹特四突变体就是一例,其活性提高34倍,同时没有牺牲特异性。对S-舒必利的立体选择性偏好也得到保持。综上,ML引导框架可利用单突变酶变体的功能数据,快速而有效地预测更优的高阶突变体。

图5|机器学习引导不同酰胺合成酶的工程化改造,用于生物合成多种小分子药物 a. McbA机器学习引导蛋白质工程策略。首先,鉴定野生型McbA能够催化的非天然反应,并优先选择可生成高价值小分子药物的反应。其次,对64个残基进行热点筛选,以筛选出能够提高活性的残基。随后,利用热点筛选数据训练增强型岭回归模型,并对机器学习预测结果进行实验验证。 b–g. 比较机器学习预测的最高活性变体、野生型McbA和标准品在一组小分子药物合成反应中的表现。酶浓度统一为0.5 mg/mL,约9 μM,并采用反相高效液相色谱分析产物。产率提高倍数表示机器学习预测McbA变体相对于野生型McbA的产率变化,n = 3。展示各反应中产物、酸底物和腺苷酸化酸的代表性高效液相色谱图,分别以红色、紫色和橙色表示。色谱图来自至少3次独立实验,n = 3。
3 讨论
建立了一种高通量、ML引导的蛋白质工程框架,用于无需专用计算资源的预测性设计。框架独特地整合了CFE与诱变方法、用于加快定向进化的ML,以及将通用型酶转化为多种专用型酶的分歧进化。通过快速推进酰胺合成酶McbA的9项蛋白质工程改造展示了该框架,其中6项同步开展。
在构建ML模型和开展全部ISM轮次的过程中,共评估了2,856种McbA变体,其中1,217种用于ML模型;还评估了1,100种可能的酰胺产物和12,584种底物对—突变体反应,从而探索McbA的序列—功能景观。共识别出McbA内19个显著影响生物催化的独特残基位置,每种反应对应一组独特的热点残基。最终获得的9种工程化McbA变体共包含21种不同突变,分布于14个残基。尽管许多底物对含有相同的酸或胺,但某些突变出现的原因难以进行合理解释,因为这些突变在多种酶之间并不保守。例如,甲氧氯普胺、辛可卡因、普鲁卡因胺和地氯普胺均含N,N-二乙基乙二胺,但酸不同。V177S可以被视为该反应的有益突变,但这一概括并非普遍适用,因为普鲁卡因胺对应的变体不含该突变。数据似乎表明,残基选择,即热点,与整体反应的关系强于与单独酸或胺片段的关系。所有新生成的酶变体均比wt-McbA活性更高,提升幅度为1.6~42倍。其中,用于合成吗氯贝胺的酶变体实现了96%的转化率,催化效率较wt-McbA提高42倍,并成功放大至毫克级制备。
工作的一个重要特征是利用单残基突变训练ML模型,预测适应度提高的高阶突变体。之所以选择增强型岭回归ML模型,是因为该模型此前已被证明相比更复杂的方法表现良好,并能从单突变外推至高阶突变,这与当前数据一致。例如,在9个测试案例中,ML预测的四突变酶变体活性均高于直接组合4个活性最高的单残基突变所得变体。无论数据生成质量较高,如吗氯贝胺,适应度景观平坦,即许多突变体活性为零且仅少数突变可提高活性,还是信噪比较高,如地氯普胺,这一结果均成立,突出了方法的稳健性。在某些情况下,可能需要随机森林、支持向量机或神经网络等能更好泛化至整个序列空间的复杂模型,才能探索复杂适应度景观。尽管如此,采用的ML引导框架仍可协助搜索假想ISM轨迹周边区域,在多项酶工程中减少工作量并提高成功率。
理论上,方法可应用于任何酶,但需要针对具体反应微调数据收集和ML模型构建。在数据收集方面,生物催化反应的实验筛选方法仍是瓶颈。由于McbA的产物化合物在CFE裂解液中稳定,且色谱方法效率较高,每个样品约需3分钟,因此LC-MS提供了可控的解决方案。作为筛选的补充,某些酶工程应用更适合采用选择策略,例如存在可操作的选择方法并需要在序列空间中实现更大跨度时。针对不同蛋白质的工程改造也可能需要探索不同ML模型和参数。尽管增强型EVmutation模型表现优异,其他适应度目标可能需要不同的适应度预测器。例如,若目标是提高稳定性,基于结构的适应度预测器可能更优。大量蛋白质变体效应预测器仍在不断推动技术发展,可能进一步改善预测结果。基于自然语言处理的复杂序列编码也可能优于增强编码。最后,使用更多残基、多突变体数据,包括来自多轮诱变的数据或在目标蛋白质全长范围内实现氨基酸多样化的随机突变组合,以及使用动力学测量结果训练ML模型,都可能有助于改造出更好的催化剂。
总之,易于使用的ML引导无细胞框架通过规避限制先进方法搜索序列空间的路径依赖,克服了传统定向进化面临的挑战。此外,利用线性表达模板开展无细胞表达可加快序列—功能景观探索,因为蛋白质表达与评估全过程均可脱离细胞完成,并省去繁琐的克隆步骤,使耗时由数天至数周缩短为数小时。与单独使用ISM相比,这些特征加快了工程改造;框架使6项酶工程能够同步开展,每种化合物仅用1周即可完成。CFE成本较低,每个10 μL反应仅需数美分,并具有高度可扩展性。除无细胞框架本身的优势外,结果还凸显了酰胺合成酶McbA的多功能性:它可被定向改造以催化多种目标反应,包括小分子药物生产中使用的反应。展望未来,方法与从头蛋白质设计相结合,有望加快酶工程进程,开发具有多样功能和性质的专用酶。